AI-nieuws8 min leestijdDoor JH Akash
Qwen4-Max Preview: 14 Dagen Live, 1M Context, Geen Prijs
Alibaba opende Qwen4-Max Preview op 11 november en stopt op 25 november. Het heeft een context van 1 miljoen tokens en een outputplafond van 393.216 tokens, maar geen benchmarks, geen modelkaart en geen prijs per token.
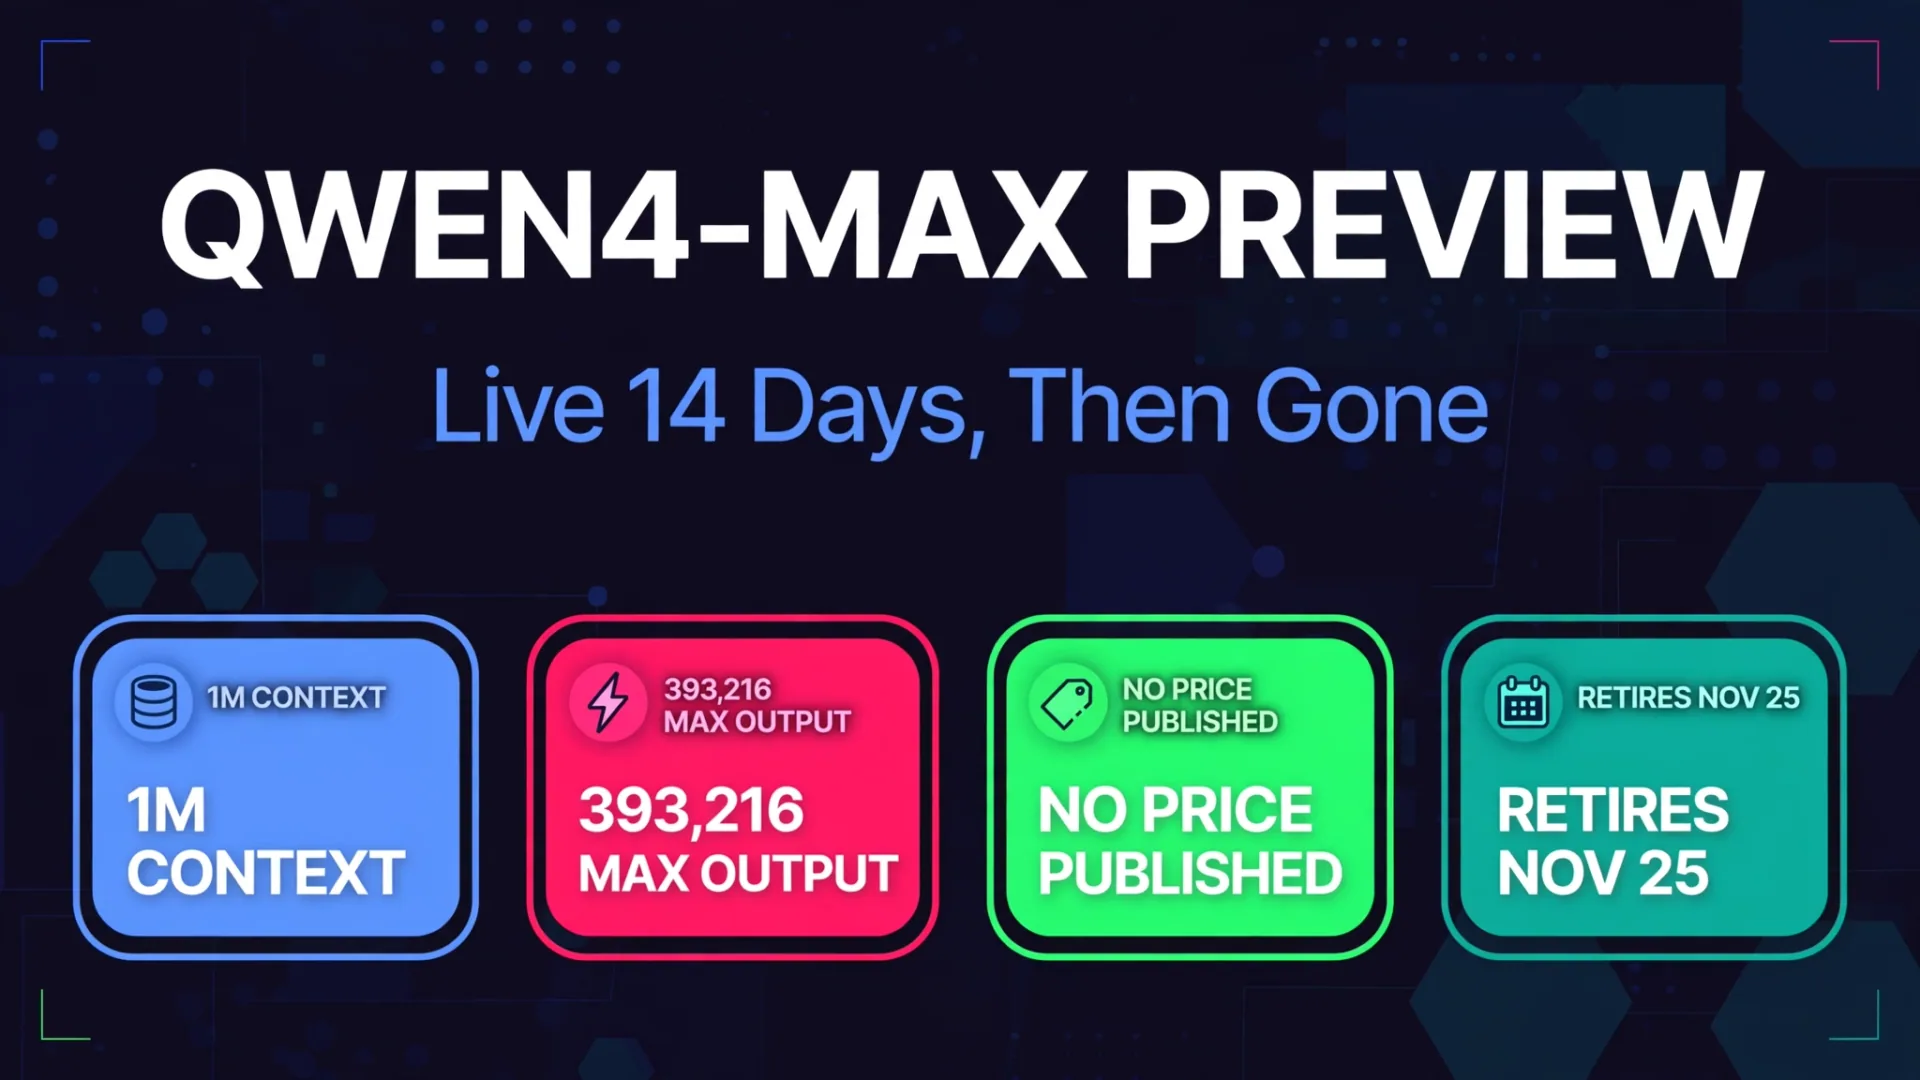
Op 11 november 2026 opende Alibaba Qwen4-Max Preview, het eerste model van zijn Qwen4-generatie. Het wordt geleverd met een zin die je bijna nooit ziet bij een vlaggenschiplancering: de preview loopt tot 25 november, er zullen geen wijzigingen worden doorgevoerd in deze periode, en het model wordt na afloop van de preview met pensioen gestuurd.
Veertien dagen. Toen weer weg. En Alibaba publiceerde geen benchmarkscores, geen modelkaart, geen parameteraantal, geen gewichten en geen prijs per token. Hier is wat het model eigenlijk is, wat de vroege tests laten zien, en of het de moeite waard is voor je twee weken.
Wat Qwen4-Max Preview is
Qwen4-Max Preview is de early access-versie van Qwen4, de volgende vlaggenschipgeneratie van Alibaba, die voor het eerst werd getoond op de Apsara-conferentie in september 2026. Het is het enige Qwen4-model dat tegenwoordig nog kan worden gebeld. De rest van de familie, Qwen4-Plus, Qwen4-Flash en een 27B-model bedoeld voor lokale implementatie, hebben nog geen aangekondigde datum.
| Specificatie | Qwen4-Max Voorbeschouwing |
|---|---|
| Model-ID | qwen4-max-preview (alias qwen4.0-max-preview) |
| Status | Vooruitblik, 11 november tot 25 november 2026 (Beijing-tijd) |
| Contextvenster | 1.000.000 tokens |
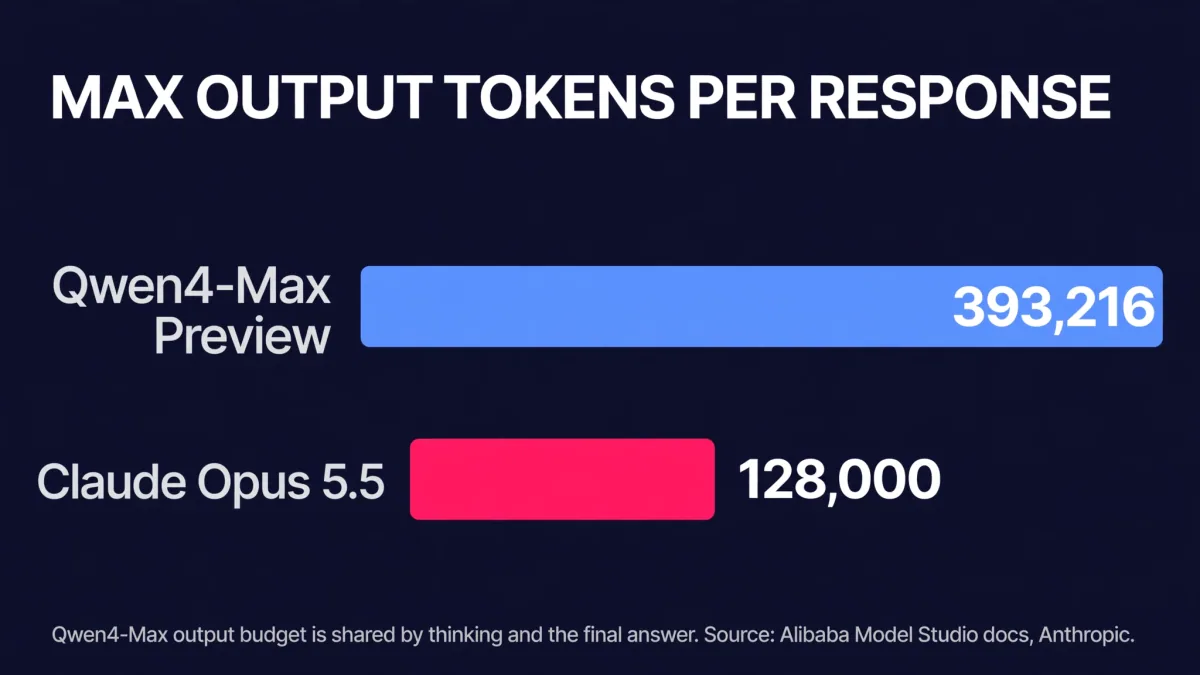
| Maximale output | 393.216 tokens, gedeeld door denken en het eindantwoord |
| Input | Tekst, afbeeldingen en video |
| Denken | Standaard aan reasoning_effort laag, medium of xhoog (standaard xhigh) |
| Toegang | Alleen Token Plan abonnement, Singapore-eindpunt |
| Pay-as-you-go | Niet ondersteund, een gewone Model Studio-sleutel opent dit model niet |
| Benchmarks | Geen gepubliceerd, door leveranciers gerapporteerd of onafhankelijk |
| Parametertelling | Niet gepubliceerd |
| Gewichten en licentie | Niet gepubliceerd |
| Prijs per token | Niet gepubliceerd |
De 1M-token context is niet nieuw voor de familie. Het vorige vlaggenschip, Qwen3.8-Max, werd op 3 augustus 2026 gelanceerd met een eigen context van een miljoen tokens. Wat nieuw is, is het outputplafond: 393.216 tokens in één enkele respons, waarbij de redenering en het eindantwoord dat budget delen. Dat is ongeveer drie keer het standaard output ceiling van 128.000 tokens van Claude Opus 5.5.
Het snelle oordeel
Qwen4-Max Preview is een twee weken durende testrit, geen model waarop je kunt bouwen. De 1M-context en het enorme outputplafond zijn echt en gedocumenteerd, en de eerste hands-on tests zijn snel. Maar zonder benchmarks, zonder prijs per token en een harde pensioendatum, overleeft niets wat je meet of bouwt op dit exacte model 25 november. Probeer het als je nieuwsgierig bent of als je op Alibaba's stack verzendt. Migrer geen productiewerk ernaartoe.
| Vraag | Kort antwoord |
|---|---|
| Is het snel? | Vroege tests geven aan van wel, veel sneller dan Qwen3.8-Max op dezelfde taken |
| Is het goed? | Onbekend, er bestaat nog geen benchmark |
| Is het goedkoop? | Er bestaat geen prijs per token, alleen een Token Plan abonnement |
| Kan ik daarop voortbouwen? | Nee, het gaat met pensioen op 25 november 2026 |
| Is het open gewicht? | Geen gewichten gepubliceerd |
Qwen4-Max Preview vs Claude Opus 5.5 vs Qwen3.8-Max
Dit is de eerlijke vergelijking: de nummers die bestaan, en de blanco plekken waar ze dat niet doen.
| Qwen4-Max Voorbeschouwing | Claude Opus 5.5 | Qwen3.8-Max | |
|---|---|---|---|
| Contextvenster | 1.000.000 tokens | 1.000.000 tokens | 1.000.000 tokens |
| Maximale output per respons | 393.216 tokens | 128.000 tokens (300.000 op Batches API) | Niet gepubliceerd |
| Invoertypen | Tekst, afbeelding, video | Tekst, afbeelding | Tekst, afbeelding |
| Kunstmatige Analyse Intelligentie Index | Geen partituur gepubliceerd | 59, 5e van 74 | 34 |
| Prijs per 1 miljoen tokens | Niet gepubliceerd, alleen Token Plan | $4 invoer, $20 uitgang | Niet hier behandeld |
| Beschikbaarheid | 11-25 november 2026, daarna met pensioen gegaan | Actief, met pensioen niet vóór 22 september 2027 | Actief |
Het contextvenster is een echte drievoudige gelijkspel bij 1 miljoen tokens. Het outputplafond is waar Qwen4-Max Preview opvalt, en het beschikbaarheidsvenster is waar het uit elkaar valt: 14 dagen tegenover meer dan 300 dagen gegarandeerde beschikbaarheid voor Opus 5.5.
Prijs: een abonnement, geen tariefkaart
Alibaba heeft geen prijs per token gepubliceerd voor Qwen4-Max Preview. De enige manier om binnen te komen is het Token Plan, een maandabonnement voor codeer- en agenttools, en het gebruik trekt maandelijkse credits af. Onafhankelijke dekking van de prijspagina vermeldt individuele abonnementen voor $6 (Lite), $10 (Essential), $18 (Standard) en $43 (Pro) per maand, met een launch-aanbod van $3 per maand voor nieuwe gebruikers. Alibaba publiceert geen credits-per-token-tarief voor dit model, dus er is geen manier om een prijs per taak te berekenen totdat je credits hebt verbruikt en kijkt.
| Plan | Prijs per maand |
|---|---|
| Lanceringsaanbod voor nieuwe gebruikers | $3 |
| Lite | $6 |
| Essentieel | $10 |
| Standaard | $18 |
| Voordeel | $43 |
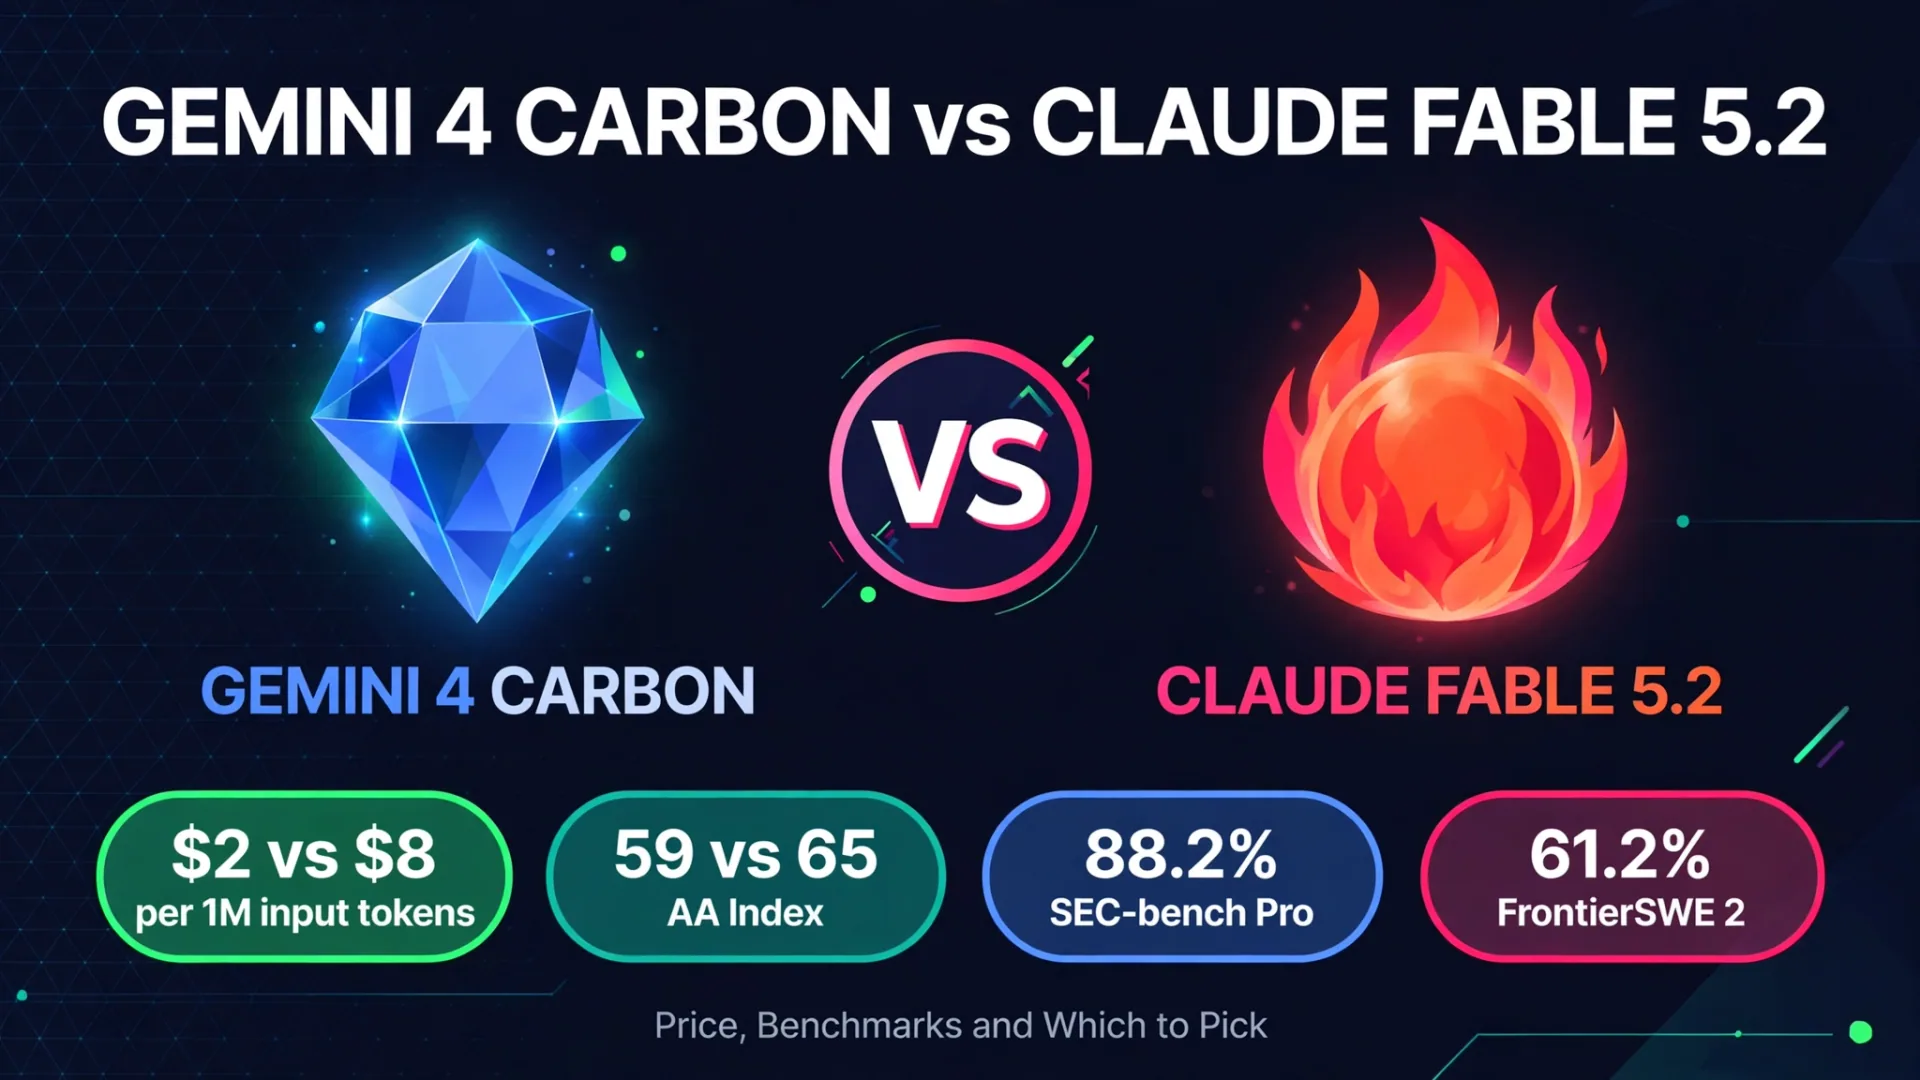
Vergelijk dat met de tariefkaarten waar je daadwerkelijk omheen kunt plannen: Claude Opus 5.5 met $4 input en $20 output per 1M tokens, en Gemini 4 Carbon vs Claude Fable 5.2: $2 vs $8 voor de huidige prijsstrijd aan de topkant. Een abonnement zonder gepubliceerde tarief per token is het tegenovergestelde van transparante prijsstelling, en het is het zwakste deel van deze lancering.
Benchmarks: er zijn er geen
Alibaba's lanceringspost en modeldocumentatie bevatten helemaal geen benchmarkcijfers. Op 12 november had ook geen onafhankelijk laboratorium een score gepubliceerd. Artificial Analysis heeft geen pagina voor Qwen4-Max Preview, en LMArena had geen score. Een grafiek waarop Qwen4-Max op 53 staat op de Artificial Analysis-index circuleert op sociale media, maar Artificial Analysis vermeldt geen Qwen4-invoer, dus beschouw dat getal als niet-geverifieerd.
Wat er in plaats daarvan is, zijn een handvol praktische tests:
| Vroege test | Resultaat |
|---|---|
| 20 codeertests, Qwen4-Max versus Qwen3.8-Max | Qwen4-Max haalde 20 van de 20 in ongeveer 2,5 minuten, Qwen3.8-Max duurde 17 minuten |
| T-Rex game build test | Sneller gefinisht dan Claude Fable 5.2 en Gemini 4 Carbon, maar de tester gaf Fable 5.2 nog steeds de beste overall |
| Snelheid versus GPT-6.1 Terra | Een gebruiker van Hacker News vond Qwen4-Max iets trager |
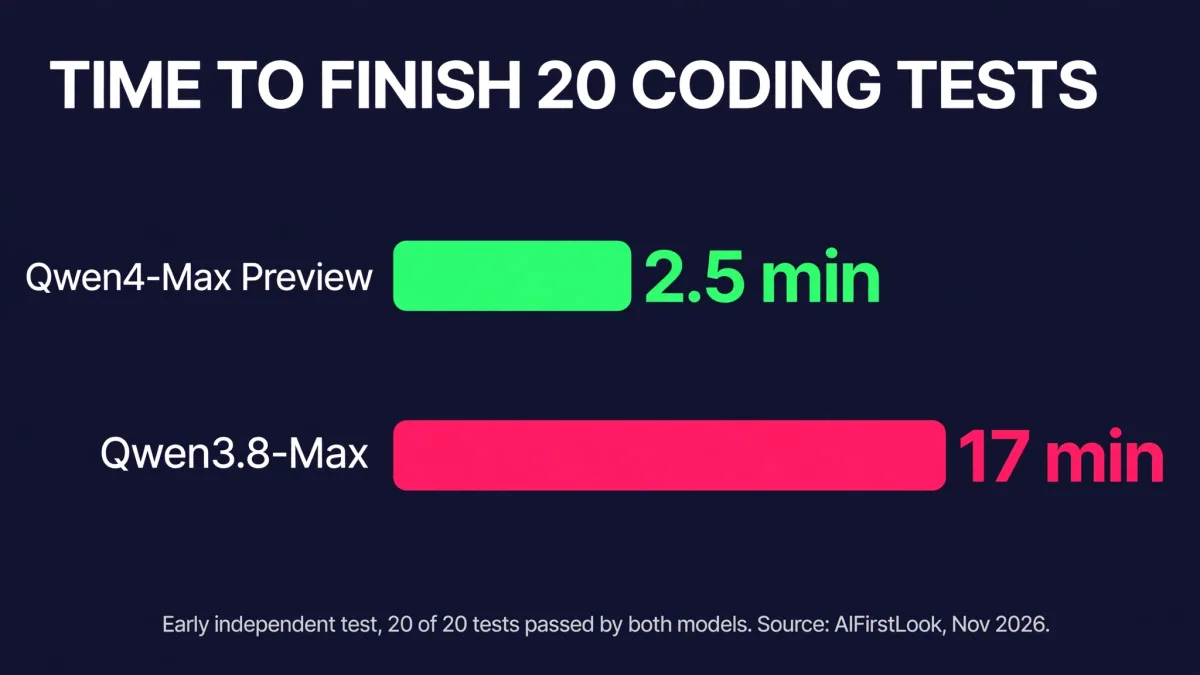
Het resultaat van 2,5 minuten versus 17 minuten is het meest opvallende vroege signaal, ongeveer 6,8 keer sneller dan het vorige vlaggenschip op dezelfde 20 tests, waarbij beide modellen alle 20 tests haalden. Maar het is één kleine testset van één tester, geen benchmark. Totdat een laboratorium een echte suite uitvoert, is elke kwaliteitsclaim over Qwen4-Max Alibaba's woord of een anekdote.
Voor context over hoe echte benchmarktabellen eruitzien als ze bestaan, zie Claude Fable 5.2: #1 op 65, 20% Goedkoper, 30% Sneller en Gemini 4 Waterstof: 2,5x Sneller, $1,50 per 1M.
Wat ontbreekt en waarom het belangrijk is
De ontbrekende helft van deze lancering is langer dan de verscheepte helft:
- Geen benchmarks. Er is niets te vergelijken met Claude Fable 5.2, GPT-6 of Gemini 4 Carbon. Elke pagina die vandaag de dag Qwen4-Max op kwaliteit rangschikt, is gokken.
- Geen parametertelling. Noch totale noch actieve parameters worden gepubliceerd, dus geheugen en snelheid kunnen niet uit de architectuur worden geschat.
- Geen prijs per token. Kosten per taak kunnen niet worden berekend, alleen worden gevoeld nadat de credits zijn uitgegeven.
- Geen gewichten. Er bestaat niets met de naam Qwen4 in de Qwen-organisatie op Hugging Face, dus er is niets om zelf te hosten of te verfijnen.
- Geen modelkaart. Geen gepubliceerde veiligheids-, trainings- of evaluatiedocumentatie.
- Geen volledige releasedatum. De rest van de Qwen4-familie heeft geen aangekondigde datum, en de Token Plan-pagina noemt geen vervanger voor de preview wanneer deze met pensioen gaat.
Alibaba bevriest het model voor het raam en stopt het daarna, zodat elke benchmark, kostenraming of veiligheidstest van dit exacte model slechts tot 25 november bruikbaar blijft. Dat is het echte verhaal van deze lancering: een vlaggenschip dat je twee weken kunt testen en daarna kunt verliezen.
Welke kies je
Probeer Qwen4-Max Preview als: je Alibaba's Token Plan al gebruikt, de 1M-context en het 393.216-token outputplafond wilt testen op lange agentic-jobs, of je Qwen4 evalueert voorafgaand aan de volledige release. Behandel het als een demo met een deadline.
Sla het over en gebruik Claude Opus 5.5 als: je een gedocumenteerd model nodig hebt met een gepubliceerde prijs, echte benchmarkscores en een pensioenverplichting. Opus 5.5 scoort 59 op de Artificial Analysis Intelligence Index, kost $4 input en $20 output per 1 miljoen tokens, en is gegarandeerd beschikbaar tot ten minste 22 september 2027.
Sla het over en gebruik Qwen3.8-Max als: je de Qwen-familie vandaag op een normale API wilt hebben. Het is het vorige vlaggenschip, het heeft open gewichten en verdwijnt niet binnen twee weken.
Wacht op de volledige Qwen4-release als: je benchmarks, gewichten of een prijs per token wilt voordat je je verbindt. De preview beantwoordt geen van die vragen.
Als je team moet beslissen op welk model je een AI-product bouwt, is die keuze veel belangrijker dan welke enkele lancering dan ook. Onze gids over hoe je een AI-agent bouwt , behandelt hoe je een model kiest, evaluaties opstelt en een agent oplevert die na de lancering blijft werken.
FAQ
Wanneer gaat Qwen4-Max Preview met pensioen?
25 november 2026 om 24:00 Beijing-tijd, wat 11:00 uur ET is op 25 november. In de documentatie van Alibaba staat dat er tijdens de previewperiode geen wijzigingen zullen worden aangebracht en dat het model na afloop met pensioen zal gaan.
Hoeveel kost Qwen4-Max Preview?
Er is geen prijs per token. Toegang loopt via het Token Plan-abonnement van Alibaba, met individuele abonnementen die $6, $10, $18 en $43 per maand kosten, en een lanceringsaanbod van $3 per maand voor nieuwe gebruikers. Het gebruik haalt maandelijkse credits af, en Alibaba publiceert geen credits per token-tarief voor dit model.
Heeft Qwen4-Max Preview benchmarks?
Nee. Alibaba publiceerde geen benchmarktabel met de preview, en geen onafhankelijk lab had per 12 november 2026 een score gepubliceerd. Een circulerende grafiek die 53 claimt op de Artificial Analysis-index is niet geverifieerd, omdat Artificial Analysis geen Qwen4-vermelding vermeldt.
Wat is het contextvenster van Qwen4-Max Preview?
1.000.000 tokens, hetzelfde als Claude Opus 5.5 en het vorige vlaggenschip Qwen3.8-Max. De maximale output per respons is 393.216 tokens, gedeeld door het denken van het model en het uiteindelijke antwoord.
Is Qwen4-Max Preview open gewicht?
Nee. Er zijn geen gewichten, licentie- of parameteraantallen gepubliceerd, en er bestaat niets met de naam Qwen4 in de Qwen-organisatie op Hugging Face. De rest van de Qwen4-familie, inclusief een 27B-model bedoeld voor lokale inzet, heeft geen aangekondigde datum.
Hoe krijg ik toegang tot de Qwen4-Max Preview?
Alleen via het Token Plan van Alibaba, op het Singapore-eindpunt token-plan.ap-southeast-1.maas.aliyuncs.com. Pay-as-you-go wordt niet ondersteund en een gewone Model Studio-sleutel opent dit model niet. Het is ook beschikbaar in de Qwen-app.
De kern van de zaak
Qwen4-Max Preview is Alibaba's meest bijzondere vlaggenschiplancering: een groot model met een groot contextvenster en een enorme outputplafond, geleverd zonder benchmarks, zonder prijs en met een houdbaarheidsdatum van 14 dagen. Het vroege snelheidssignaal is echt en indrukwekkend, maar snelheid op één kleine testset is geen kwaliteit, en een model dat op 25 november met pensioen gaat, kan niet de basis zijn van iets wat je verzendt. Test het deze week als je nieuwsgierig bent. Bouw er nooit op voort.
- Qwen4-Max Preview
- Alibaba Qwen
- Qwen4
- AI benchmarks
- AI pricing