AI-nieuws5 min leestijdDoor JH Akash
Edge0-145B: 145B AI draait op één RTX 5090
Edge0-145B biedt 145B parameters op een enkele RTX 5090 en scoort 86,5 op Terminal-Bench 2.1. Hier zijn de benchmarks, snelheid, prijs en de addertjes.
Edge0-145B: 145B AI draait op één RTX 5090
Op 12 november 2026 bracht Edge00 Edge0-145B uit, een AI-model met 145 miljard parameters dat draait op één consumenten grafische kaart. De gewichten kwamen op 11 november op Hugging Face, de officiële blogpost volgde op 12 november, en op 14 november had het model al meer dan 61.000 downloads, met 11.379 sterren op GitHub.
De kopclaim is simpel: frontier-klasse AI, op je eigen computer, zonder cloudrekening. Hier is wat het model eigenlijk is, wat de cijfers aangeven en waar de kleine lettertjes verstopt zijn.
Wat Edge0-145B is
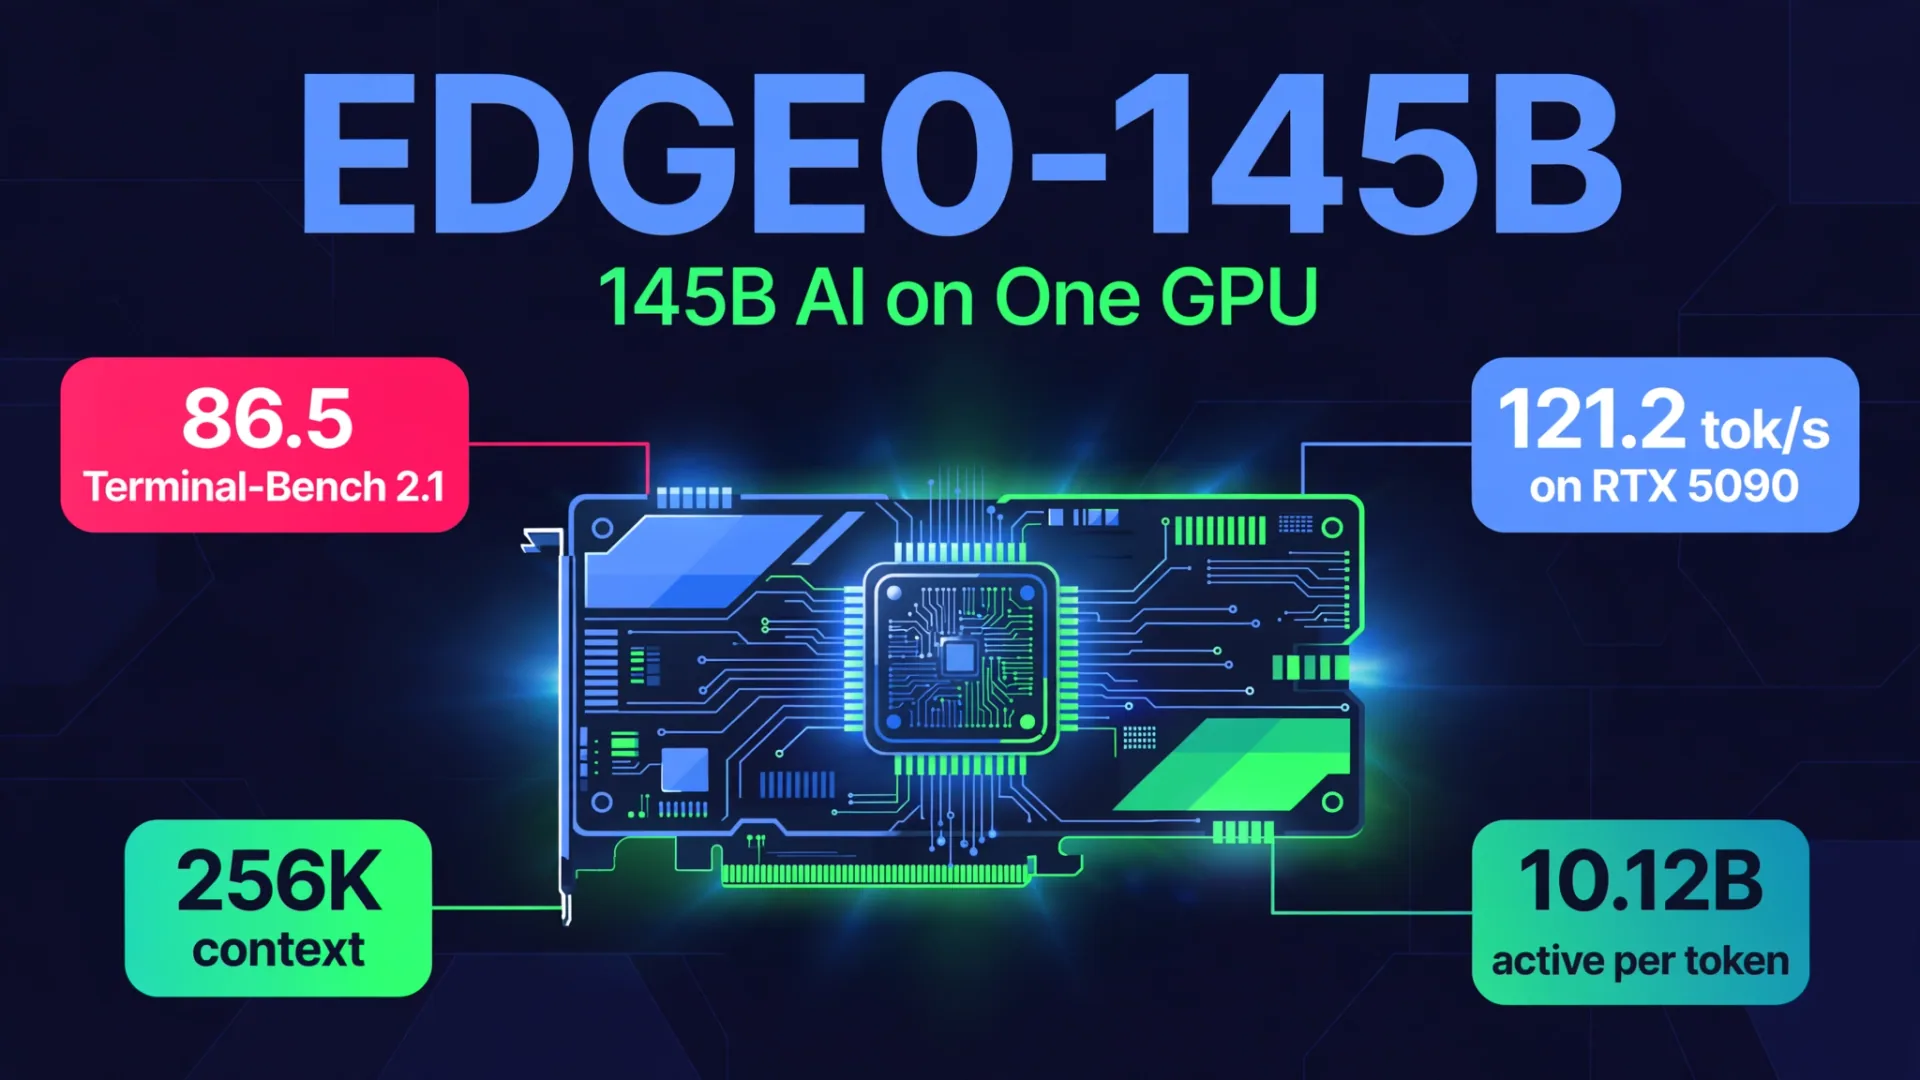
Edge0-145B is een latent spaarzame mix van experts. Het heeft 145 miljard parameters in totaal, maar er zijn er slechts 10,12 miljard actief per token, daarom past het überhaupt op één GPU. De architectuur gebruikt 48 lagen en 512 experts per laag, met 10 geroutede experts plus 1 gedeelde expert actief per token. Het werd native getraind met 4-bit precisie en wordt geleverd met een contextvenster van 256K-token.
| Specificatie | Edge0-145B |
|---|---|
| Totale parameters | 145B |
| Actief per token | 10.12B |
| Architectuur | Latent spaarzame MoE, 48 lagen, 512 experts |
| Contextvenster | 256K-tokens |
| Trainingsprecisie | Native 4-bit |
| Gewichten | Q3_K 40,81 GiB, NVFP4 47,79 GiB |
| Basismodel | Qwen3.8-Flash-Next (volgens Hugging Face metadata) |
| Licentie | Edge0 Community Model Licentie 1.0 |
| Uitgebracht | 12 november 2026 |
Een kleinere broer, Edge0-120B, lanceerde diezelfde dag met 120 miljard parameters en 8,64 miljard actief per token.
De snelheidscijfers
Edge0 rapporteert deze decodeersnelheden uit zijn eigen tests, dus behandel ze als door leveranciers gerapporteerd totdat er onafhankelijke runs zijn.
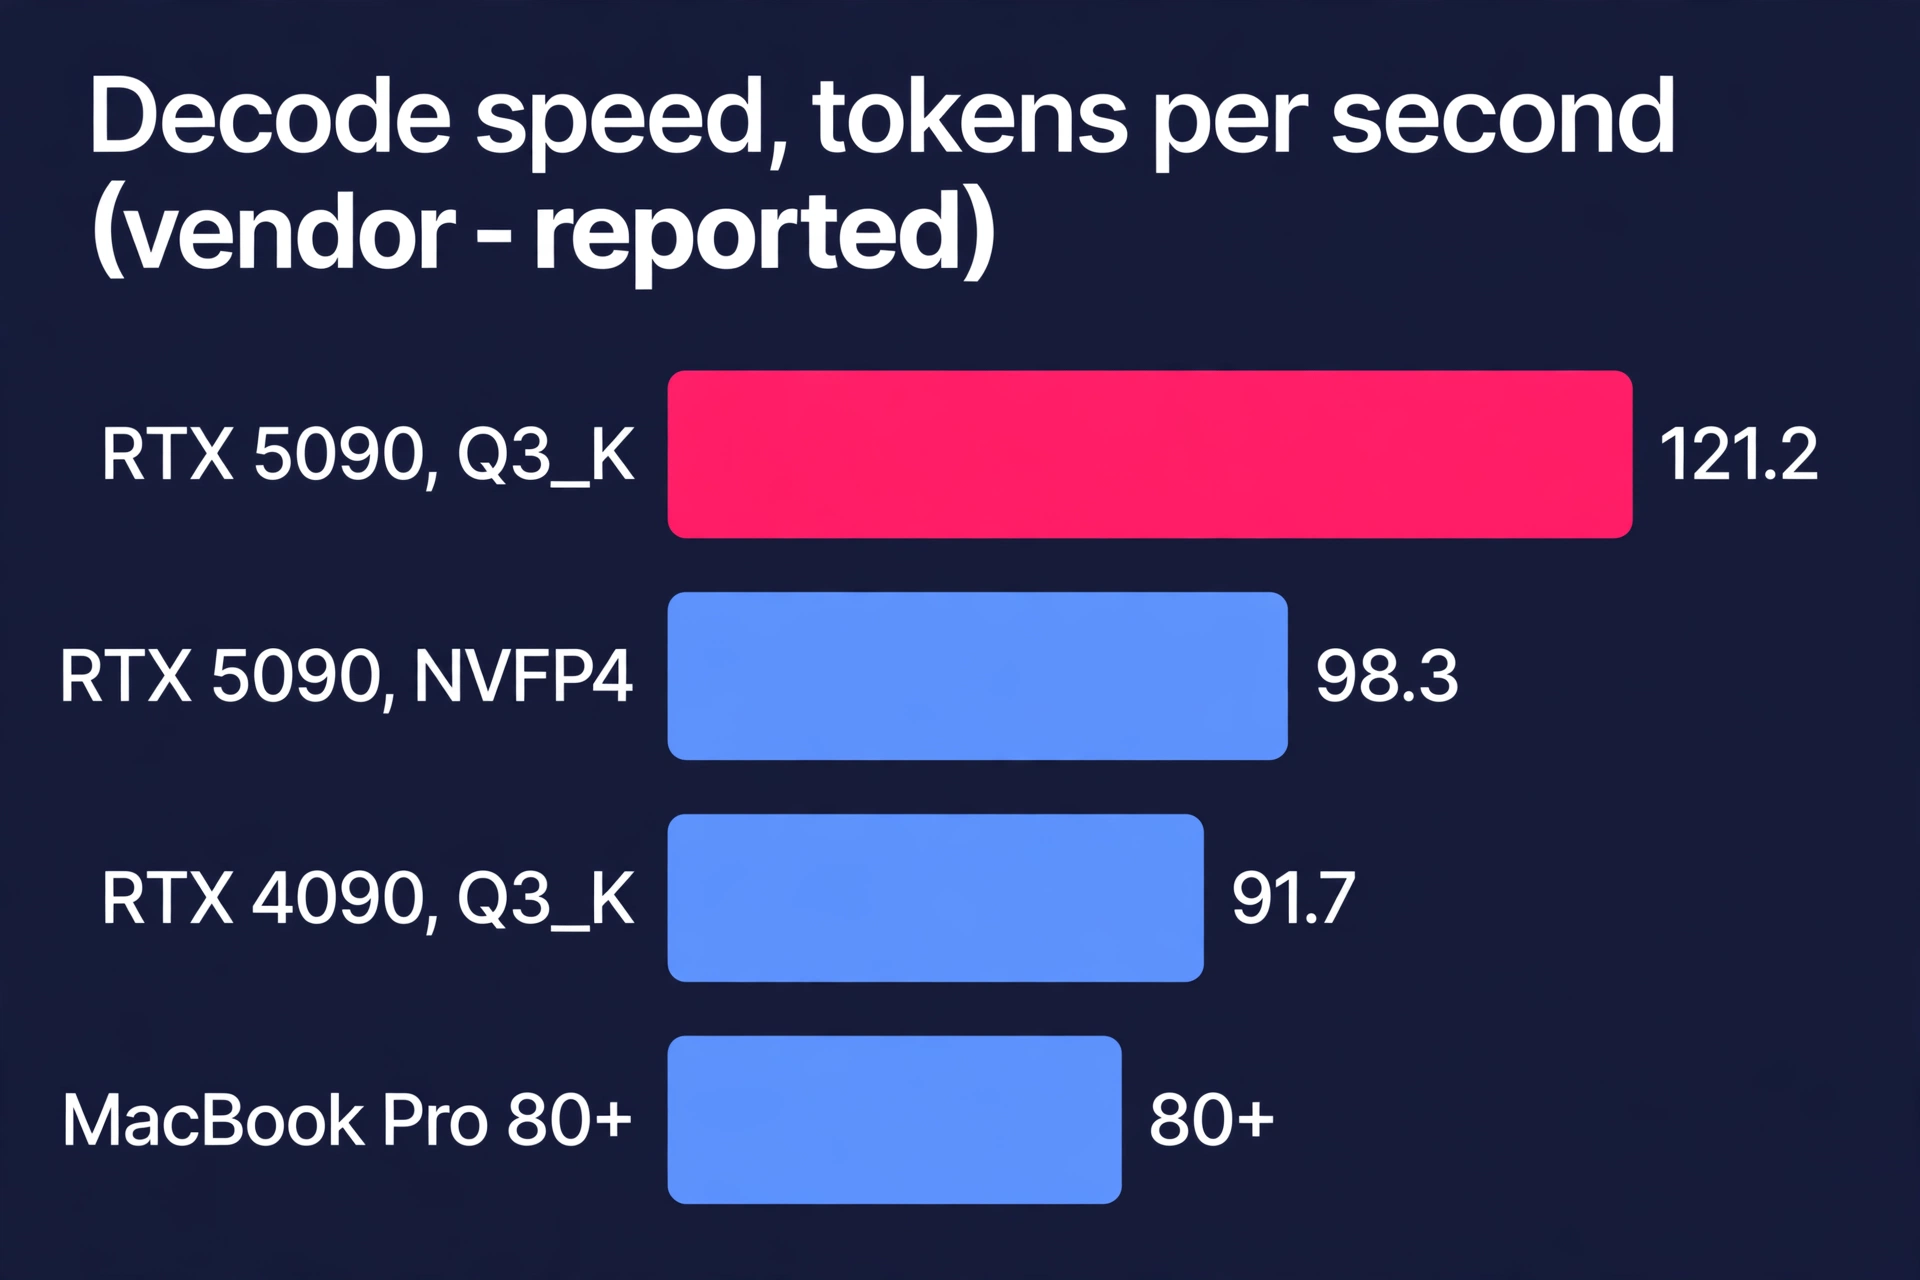
Op een RTX 5090 D met 24 GB geheugendecodeert de Q3 K-build met 121,2 tokens per seconde en 3.554,9 tokens per seconde op 16K-token prefill. De NVFP4-build draait op 98,3 tokens per seconde decode en 3.165,7 tokens per seconde prefill. Dezelfde Q3K-build haalt 91,7 tokens per seconde op een RTX 4090. Op een MacBook Pro rapporteert Edge0 meer dan 1.100 tokens per seconde prefill en meer dan 80 tokens per seconde decodering, met ongeveer 120W typisch vermogen, met 128K tot 256K context en bijna dezelfde snelheid.
Day-one ondersteuning omvat macOS, Windows en Linux op Apple M-series laptops en RTX Spark, RTX 4090 en RTX 5090 GPU's.
De referentiecijfers
Elke score hieronder komt uit Edge0's eigen interne evaluaties. Het bedrijf zegt dat er nog een technisch rapport met volledige instructies voor installatie en reproductie komt, dus lees deze als claims, niet als afgemaakte metingen.
| Benchmark | Edge0-145B | Dichtstbijzijnde vergelijking |
|---|---|---|
| DeepSWE 1.1 | 64.6 | Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4 |
| Terminal-Bench 2.1 | 86.52 | Qwen3.8-Flash-Next 83.3, DeepSeek-V4-Flash 82.7, Claude Opus 4.6 Max 78.2 |
| GPQA-Diamond | 90.4 | DeepSeek-V4-Flash 90.8, Claude Opus 4.6 Max 91.3 |
| IFBench | 80.6 | - |
| HLE | 35.4 | - |
| AA-LCR | 79.3 | - |
| Zes-benchmark gemiddelde | 72.8 | Qwen3.8-Flash-Next 71.7 |
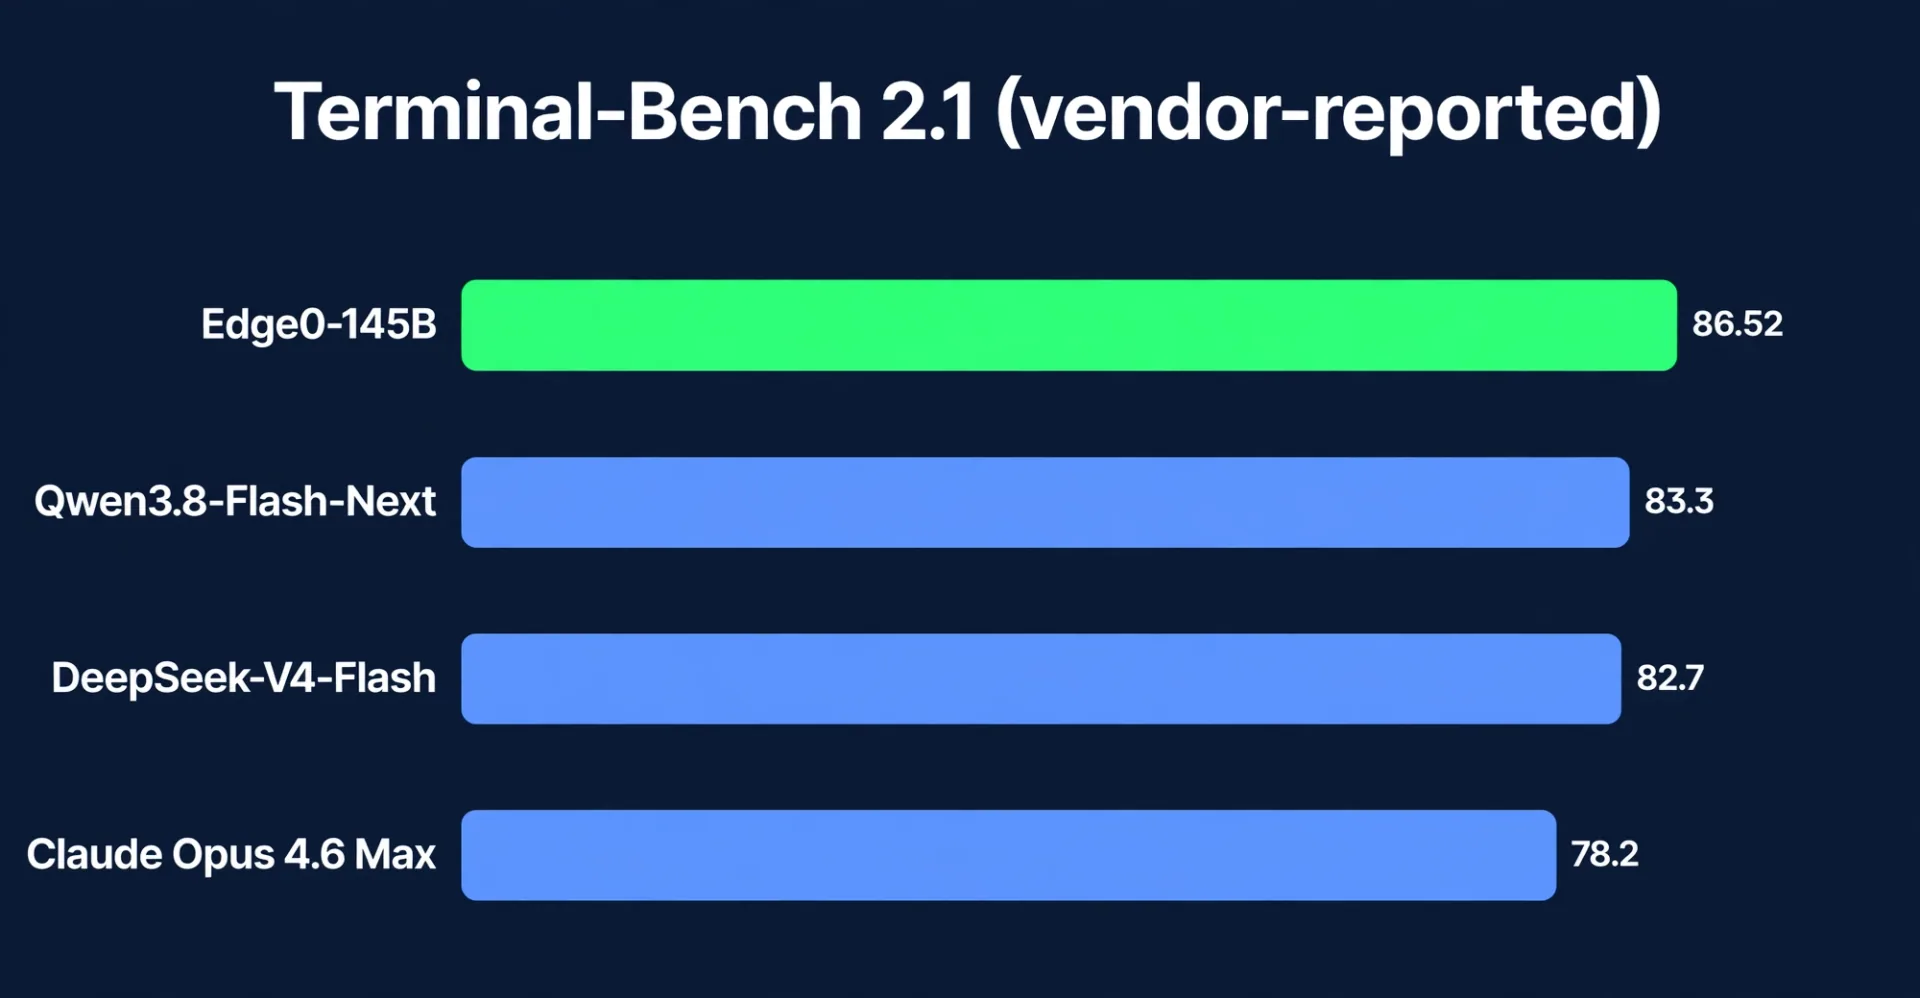
Het resultaat van Terminal-Bench 2.1 is de blikvanger: 86,52 tegenover 78,2 voor Claude Opus 4.6 in de Max-configuratie. Maar let op de GPQA-Diamond-kolom, waar Edge0 achter zowel DeepSeek-V4-Flash als Claude Opus 4.6 zit. Geen enkele benchmark bepaalt een model, en cross-benchmark "winnaars" bestaan niet. Test het op je eigen taken.
Wat het kost
| Optie | Prijs |
|---|---|
| Edge0-145B gewichten | Gratis te downloaden |
| Edge0 inferentieraamwerk | Apache 2.0, gratis |
| Jouw kosten | Eén GPU, elektriciteit en jouw tijd |
| Gemini 4 Waterstof API | $1,50 per 1 miljoen invoertokens |
| Claude Fable 5.2 API | $8 per 1 miljoen input, $40 per 1 miljoen outputtokens |
Er is geen rekening per token bij Edge0-145B. De handel is anders: je betaalt in hardware en installatietijd in plaats van API-kosten, en je data blijft op je eigen machine. Voor teams die automatisering op hun eigen hardware bouwen, is die ruil juist het punt. Als je wilt zien hoe cloudprijzen zich verhouden, behandelt onze Gemini 4 Hydrogen-uitsplitsing het $1,50 per 1 miljoen tokenmodel van Google, en het Anthropic IPO-verhaal laat zien hoeveel investeerders het bedrijf achter Claude nu waarderen.
De vangsten
Drie dingen om te weten voordat je downloadt.
De kop van 29 GB heeft context nodig. Edge0 zegt dat het model 29 GB peak memory heeft op een laptop, maar de Hugging Face modelkaart meet ongeveer 61,5 GiB in totaal voor de NVFP4-build: 23,25 GiB videogeheugen plus 38,27 GiB systeemgeheugen. Het cijfer van 29 GB is alleen GPU-geheugen. Zorg dat je machine het RAM heeft dat het bijhoudt.
Het is open-weight, niet open-source. De gewichten vallen onder de Edge0 Community Model License 1.0, die sommige toepassingen, zoals het verkopen, huren of licentiëren van de gewichten en het runnen van een modelservice, voorbehoudt voor een aparte schriftelijke licentie. De inferentie-framework code is Apache 2.0, maar de gewichten niet. Lees de licentie voordat je er een commercieel product op bouwt.
Het is gebaseerd op Qwen. De metadata van Hugging Face noemt Alibaba's Qwen3.8-Flash-Next als basismodel, en de release is een afgeleide van dat model. Edge0's eigen blog noemt Qwen niet. Dat is belangrijk als je compliance-regels rekening houden met modelafstamming.
Welke kies je
Kies Edge0-145B als je een 24 GB GPU of een sterke Apple Silicon laptop hebt, je wilt dat je data lokaal blijft, en je gebruikt agents of codeerworkloads waar een per-token cloudrekening zou schaden. Haal de NVFP4 of Q3_K build eruit, voer je daadwerkelijke workflows uit en vergelijk het met je huidige stack op kwaliteit, latentie en elektriciteitskosten.
Blijf bij een cloudmodel als je een beheerde API, gegarandeerde uptime of een model met onafhankelijke benchmarkverificatie nodig hebt. Het technische rapport voor Edge0-145B is nog in behandeling, en geen onafhankelijk lab heeft de hoofdscores nog gereconstrueerd.
Wacht af of je twijfelt tussen Edge0-145B en zijn zuster. Edge0-120B is kleiner en goedkoper in gebruik, en de eerste golf van onafhankelijke tests zal ons vertellen welke het goed doet. Voor een bredere blik op de keuze tussen bouwen versus kopen, zie Custom AI vs Off-the-Shelf AI: 76% Buy First.
FAQ
Is Edge0-145B echt gratis?
De gewichten zijn gratis te downloaden van Hugging Face, en het inferentieframework is Apache 2.0. Je betaalt nog steeds voor de GPU, elektriciteit en de installatietijd, en sommige commerciële toepassingen vereisen een aparte licentie onder de Edge0 Community Model License 1.0.
Kan Edge0-145B op een laptop draaien?
Edge0 zegt ja: op een MacBook Pro wordt meer dan 80 tokens per seconde decoderd met 29 GB piekgeheugen voor de GPU. De volledige gemeten footprint is ongeveer 61,5 GiB inclusief systeemgeheugen, dus een goed uitgeruste laptop is nodig.
Hoe snel is Edge0-145B op een RTX 5090?
Edge0 rapporteert 121,2 tokens per seconde decode met de Q3_K build en 98,3 tokens per seconde met de NVFP4 build, beide door de leverancier gerapporteerde cijfers uit de eigen tests van het bedrijf.
Is Edge0-145B beter dan Claude Opus 4.6?
Op Terminal-Bench 2.1 rapporteert Edge0 86,52 tegenover 78,2 voor Claude Opus 4.6 Max. Op GPQA-Diamond leidt Claude met 91,3 tegen 90,4. De scores worden door leveranciers gerapporteerd en er bestaat nog geen onafhankelijke verificatie, dus er is geen vaste winnaar.
Waar kan ik Edge0-145B downloaden?
De gewichten staan op Hugging Face onder Edge0/Edge0-145B-q3k en Edge0-145B-NVFP4, en het inferentieframework en de deploymenttools staan op GitHub onder Edge0-AI/Edge0.
Wat is het verschil tussen Edge0-145B en Edge0-120B?
Edge0-145B heeft in totaal 145B parameters met 10,12B actief per token; Edge0-120B heeft in totaal 120B met 8,64B actief. Beide werden gelanceerd op 12 november 2026, en het 120B-model is de lichtere, goedkopere optie.
- Edge0-145B
- open source AI
- local AI
- RTX 5090
- AI benchmarks