AI-nieuws7 min leestijdDoor JH Akash
Gemini 4 Carbon vs Claude Fable 5.2: $2 vs $8
Gemini 4 Carbon werd op 10 november algemeen beschikbaar voor $2 per 1 miljoen invoertokens, een kwart van de $8 van Claude Fable 5.2. Hier is hoe de twee vlaggenschepen zich verhouden qua benchmarks, prijs en echt werk.
Gemini 4 Carbon vs Claude Fable 5.2: $2 vs $8
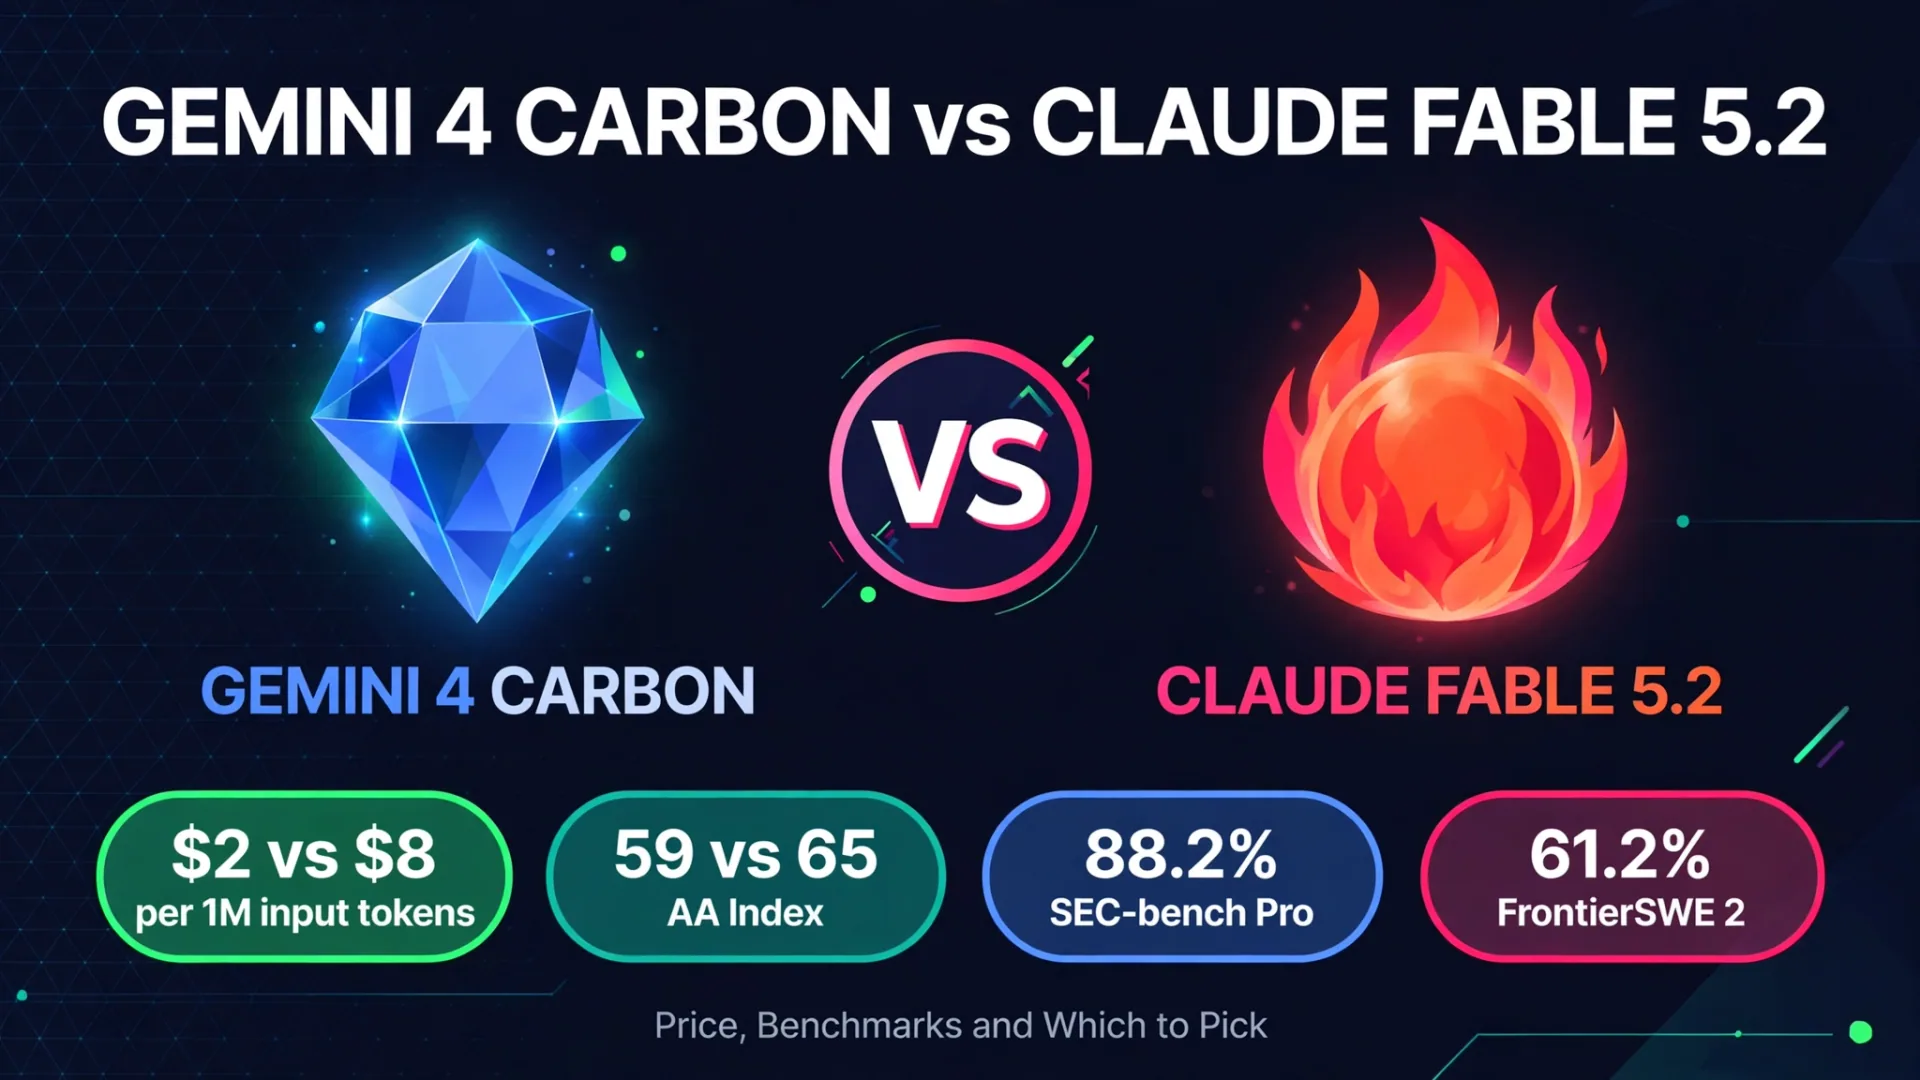
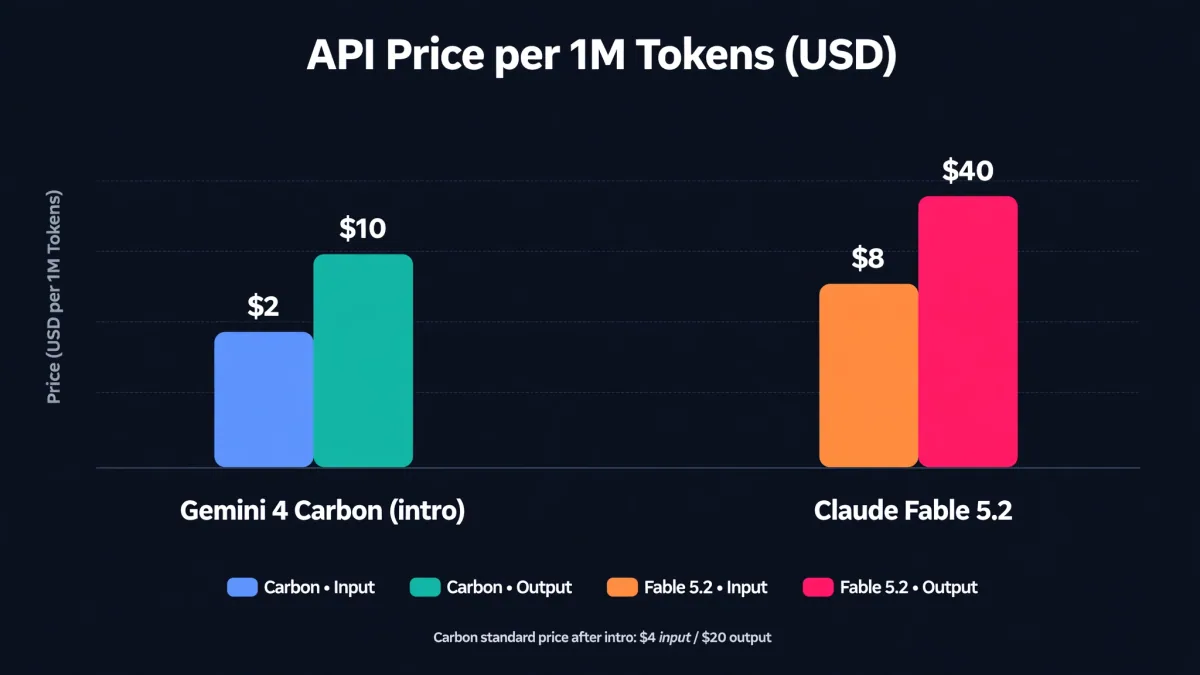
Google opende Gemini 4 Carbon voor iedereen op 10 november 2026, slechts één dag nadat Anthropic Claude Fable 5.2 had gelanceerd. Twee vlaggenschipmodellen, één week, en een prijskloof dat moeilijk te negeren is: Carbon kost $2 per miljoen inputtokens op de introductieprijs, precies een kwart van Fable 5.2 tegen $8.
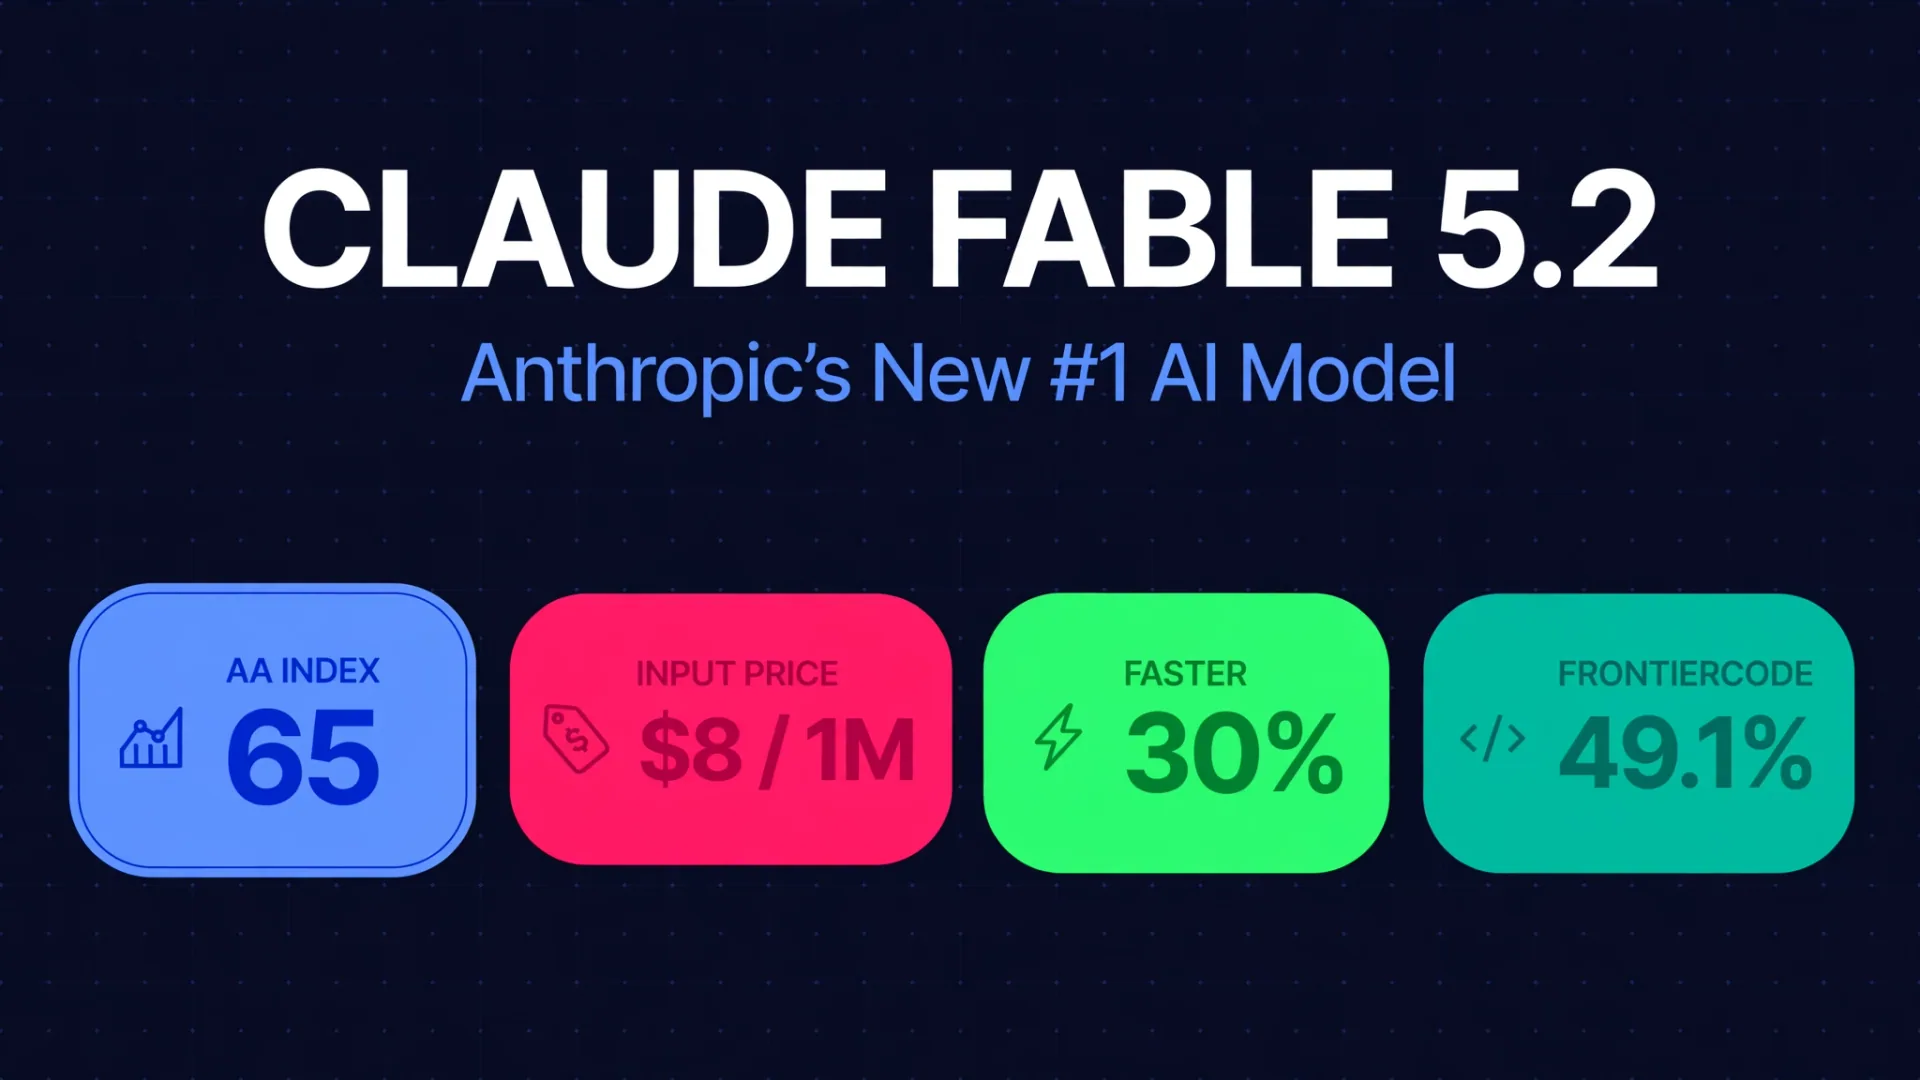
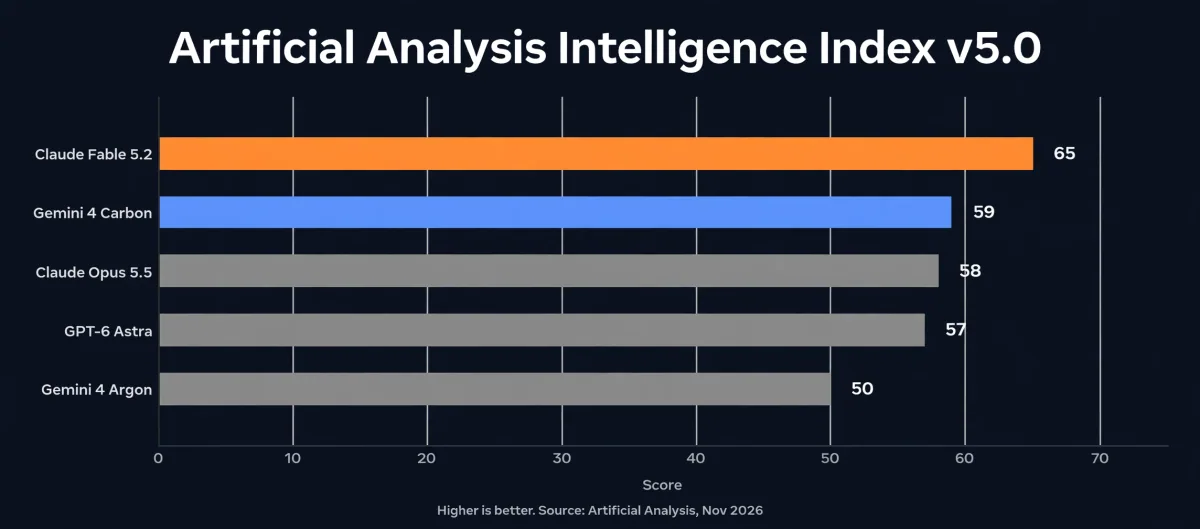
Carbon is het sterkste model van Google DeepMind, gebouwd voor cybersecurity en werk op lange termijn. Fable 5.2 is Anthropic's nieuwe vlaggenschip en de huidige leider op de onafhankelijke Artificial Analysis Intelligence Index op 65, voor Carbon met 59. De echte vraag is dus niet welk model abstract "het beste" is. Het is welk model je geld waard is voor het werk dat je daadwerkelijk doet.
Snel oordeel
| Gemini 4 Carbon | Claude Fable 5.2 | |
|---|---|---|
| Gelanceerd | Aangekondigd op 28 oktober, algemeen beschikbaar op 10 november 2026 | 9 nov 2026 |
| Kunstmatige Analyse Index v5.0 | 59 | 65 |
| Invoerprijs per 1M tokens | $2 intro, $4 standaard | $8 |
| Outputprijs per 1M tokens | $10 intro, $20 standaard | $40 |
| Contextvenster | 1M tokens | Niet vermeld in lanceermaterialen |
| Gebouwd voor | Cybersecurity, lange programmeerbanen, meerdaagse agentenwerk | Algemeen vlaggenschipwerk, freelance taken |
Kort gezegd: als je grootschalig codeer- of beveiligingswerk via een API uitvoert, is de prijs van Carbon het verhaal. Als je nu het hoogst scorende algemene model wilt, heeft Fable 5.2 de hoogste indexscore. Lees verder voor de cijfers achter dat gesprek.
Wat is er deze week veranderd
Carbon werd aangekondigd op 28 oktober 2026, maar in de eerste twee weken konden alleen cyberverdedigers en gescreende partners ermee in contact komen via het Fairwind-programma van Google. Op 10 november werd het algemeen beschikbaar: betaalde API-toegang in Google AI Studio en Android Studio, toegang voor bedrijven via Gemini for Business, en beschikbaarheid in de Gemini-app en AI-modus in Google Search voor Google AI Ultra-abonnees. Het verschijnt ook in Google Antigravity, waar Google een nieuwe /swarm-functie toevoegde die meerdere AI-agenten parallel op één taak activeert.
Fable 5.2 werd gelanceerd op 9 november 2026, samen met Claude Mythos 5.2. Anthropic zegt dat het bovenaan de Artificial Analysis Intelligence Index staat met 65, 20% minder kost dan Fable 5.1, en tot 30% sneller loopt. We hebben die lancering uitgebreid behandeld in onze Claude Fable 5.2-uitsplitsing.
Prijs: koolstof kost een kwart van de prijs, daarna de helft
| Model | Invoer per 1M tokens | Output per 1M tokens |
|---|---|---|
| Gemini 4 Carbon (inleidend) | $2 | $10 |
| Gemini 4 Carbon (standaard) | $4 | $20 |
| Claude Fable 5.2 | $8 | $40 |
Google prijst ook gecachede inputtokens tegen 95% van de inputrate, wat belangrijk is voor lange agentsessies waarin dezelfde context opnieuw wordt gelezen. Zelfs nadat de introductieperiode van Carbon is afgelopen en de prijs verdubbeld is naar $4 en $20, blijft het de prijs halverwege van Fable 5.2. Google heeft geen einddatum bevestigd voor de introductieperiode van Carbon, terwijl die van Argon eindigt op 30 november 2026.
Voor een globaal beeld van schaal: 10 miljoen niet-gecachete inputtokens plus 1 miljoen outputtokens kost $30 op Carbon's introductietarief, en $120 op Fable 5.2. Die kloof wordt snel groter in agentische workflows die tokens bij elke stap verbranden.
Benchmarks: Fable leidt de index, Carbon leidt beveiliging
De onafhankelijke Artificial Analysis Intelligence Index v5.0 plaatst Fable 5.2 op de eerste plaats op 65, Carbon op 59, Claude Opus 5.5 op 58, GPT-6 Astra op 57 en Gemini 4 Argon op 50. Bij de aankondiging van Carbon stond het bovenaan die index met 59. Fable 5.2, gelanceerd een dag voordat Carbon algemeen beschikbaar werd, heeft sindsdien de leiding genomen.
Google's eigen 17-benchmark tabel, die door leveranciers wordt gerapporteerd en zo gelezen moet worden, geeft Carbon de hoogste score op 15 van de 17 rijen:
| Benchmark | Gemini 4 Carbon | Claude Fable 5.2 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Kunstmatige Analyse Index v5.0 | 59 | 65 | 57 | 58 |
| FrontierSWE 2 | 61.2% | Niet gepubliceerd | 65.5% | 62.3% |
| SWE-sweep | 9.6% | Niet gepubliceerd | 9.5% | 3.6% |
| SEC-bench Pro (kwetsbaarheidsdetectie) | 88.2% | Niet gepubliceerd | 85.4% | Niet gepubliceerd |
| Vending-Bench 2 (gesimuleerde balans) | $16,484 | Niet gepubliceerd | $15,515 | $9,235 |
| GraphWalks (1M-token redenering) | 96,2% F1 | Niet gepubliceerd | Niet gepubliceerd | Niet gepubliceerd |
| Echte freelance taken | Niet gepubliceerd | 41.3% | Niet gepubliceerd | Niet gepubliceerd |
Drie dingen springen eruit. Ten eerste is de voorsprong van Carbon op SWE-sweep echt maar klein: 9,6% tegenover Astra's 9,5%, en elk model ligt nog steeds in de enkele cijfers. Ten tweede verslaat Astra Carbon nog steeds op FrontierSWE 2, met 65,5% tegen 61,2%. Ten derde zijn de beveiligingscijfers van Carbon het duidelijkst: 88,2% op SEC-bench Pro en de toppositie op CursorBench 4.0, Perplexity WANDR en Zapier AutomationBench, allemaal gerapporteerd door Google. Google beweert ook dat de kosten om één taak op Carbon te voltooien meer dan twee keer zo laag zijn als bij het dichtstbijzijnde concurrerende model.
Het beveiligingsverhaal van Carbon is het deel dat het waard is om te volgen
De meest concrete resultaten van Carbon liggen op het gebied van cyberbeveiliging en gaan verder dan benchmarktabellen. Tijdens tests in het Wiz Scan for Good-programma vond Carbon binnen twee uur onbekende zero-day kwetsbaarheden in twee grote cloudsoftwareleveranciers. Het Vulnerability Research-team van Google Cloud gebruikte dit om te bevestigen dat twee bugs in populaire open-source software daadwerkelijk konden worden misbruikt. In een interne test van het Project Fortify-systeem bereikte Carbon 100% recall en 95% nauwkeurigheid bij het valideren van ontdekte problemen, hoewel die cijfers gelden voor Google's specifieke testset en niet voor alle kwetsbaarheden.
Google geeft de gespecialiseerde cybersecuritymogelijkheden van Carbon aan gescreende professionals via het Fairwind-programma. Voor iedereen anders zit het model nu in de reguliere API, zodat beveiligingsteams het op hun eigen codebases kunnen testen.
Koolstof kwam ook voor in wetenschappelijk onderzoek: in een experiment met zeven eiwitfamilies vond het gemiddeld 40 keer meer verwante eiwitsequenties dan eerdere benaderingen, wat andere modellen kan helpen eiwitstructuur nauwkeuriger te voorspellen.
Welke kies je
Kies Gemini 4 Carbon als: je agents of coding pipelines op grote schaal draait en de tokenrekening belangrijk is, je werkt in security of code auditing, of je langlopende taken nodig hebt in een context van 1 miljoen tokens. Met $2 input is het het goedkoopste frontier-class model per token in deze vergelijking, en zijn de beveiligingsscores zijn echt sterk.
Kies Claude Fable 5.2 als: je het hoogst scorende algemene model op de onafhankelijke index wilt, freelance kenniswerk doet waarbij Anthropic een 41,3% expertniveau taak voltooiingspercentage rapporteert, of je bouwt al op Claude en waardeert de 20% prijsverlaging en tot 30% snelheidswinst ten opzichte van Fable 5.1.
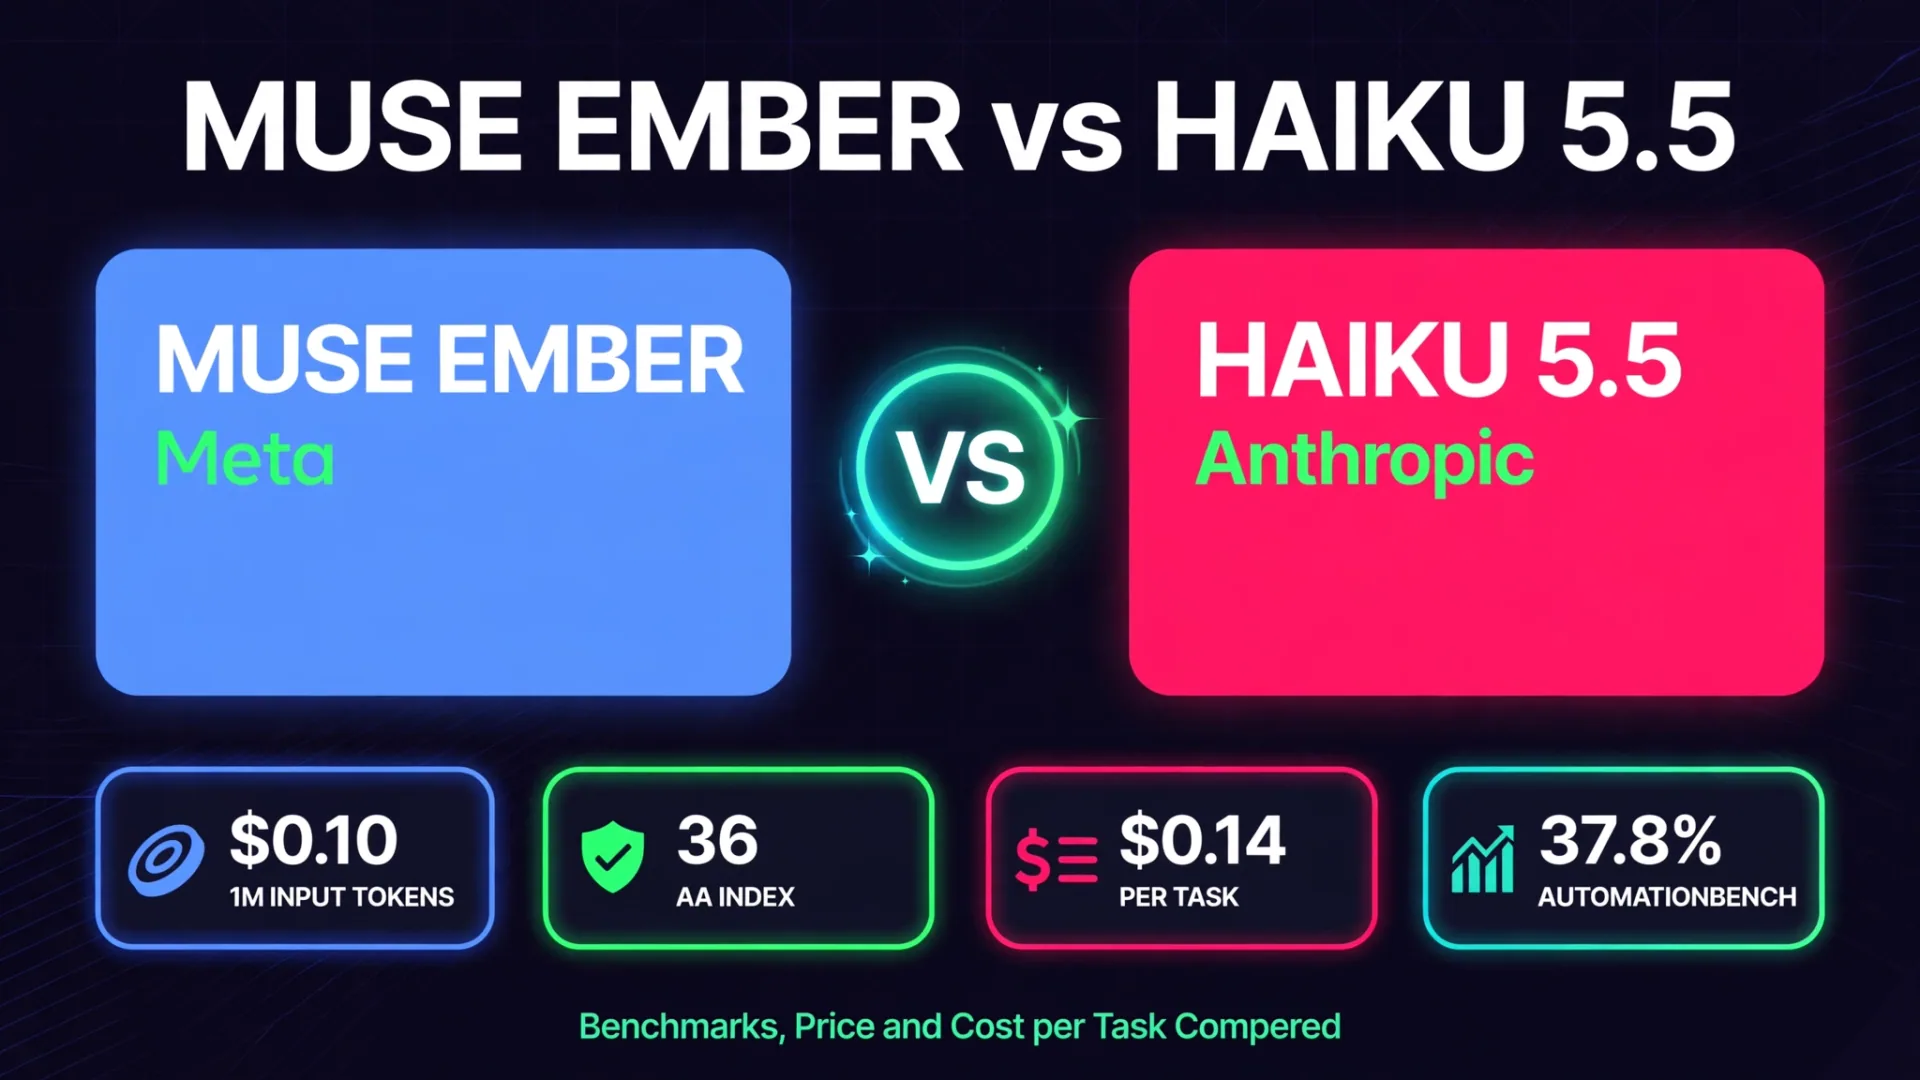
Kies geen van beide als: je een klein, goedkoop model nodig hebt voor eenvoudig werk met een groot volume. Meta's Muse Ember, die we behandelden in onze Muse Ember-uitsplitsing, komt overeen met Claude Haiku 5.5 op 36 op dezelfde index voor ongeveer een derde van de kosten per taak. En als je moet kiezen tussen de andere vlaggenschepen, behandelt ons GPT-6 Astra-overzicht het model dat nog steeds aan de leiding staat bij FrontierSWE 2.
De eerlijke samenvatting: Fable 5.2 wint de belangrijkste intelligentiescore, Carbon wint de prijs en de beveiligingsbenchmarks. Voor de meeste teams die AI-agenten bouwen, beslist het wetsvoorstel, en op dit moment is Carbons wetsvoorstel een kwart van dat van Fable.
Als je hulp wilt bij het implementeren van een van beide modellen in een echte workflow, dan dekken onze AI-agentontwikkelingsdiensten precies dat, van het kiezen van het model tot het verzenden van de agent.
FAQ
Is Gemini 4 koolstofvrij?
Nee. Carbon is een betaald API-model met $2 per miljoen inputtokens en $10 per miljoen outputtokens op het introductietarief, stijgend naar $4 en $20 na de introductieperiode. In de Gemini-app wordt het uitgerold naar Google AI Ultra-abonnees, niet naar gratis gebruikers.
Hoeveel goedkoper is Gemini 4 Carbon dan Claude Fable 5.2?
Op inputtokens is het introductietarief van $2 van Carbon 75% goedkoper dan het $8 van Fable 5.2. Op outputtokens is $10 tegenover $40 ook 75% goedkoper. Zelfs bij de standaard $4 en $20 van Carbon blijft het 50% goedkoper dan Fable 5.2.
Welk model scoort hoger, Gemini 4 Carbon of Claude Fable 5.2?
Claude Fable 5.2 leidt op de onafhankelijke Artificial Analysis Intelligence Index v5.0 met 65, tegenover Carbon met 59. Carbon leidt op Google's eigen beveiligingsbenchmarks, waaronder 88,2% op SEC-bench Pro en op SWE-sweep met 9,6%.
Waar is Gemini 4 Carbon het beste in?
Cybersecurity en langetermijnwerk: het vinden van kwetsbaarheden, het auditen van grote codebases, meerstaps-codeertaken en redeneren over een context van 1 miljoen tokens. Google meldt dat het onbekende zero-day kwetsbaarheden vond in twee grote cloudleveranciers binnen minder dan twee uur tijdens testen.
Wanneer werd Gemini 4 Carbon algemeen verkrijgbaar?
Google kondigde Carbon aan op 28 oktober 2026, beperkte het tot cyberverdedigers en gescreende partners voor twee weken, en opende algemene toegang op 10 november 2026 via de betaalde API, Google AI Studio, Gemini for Business en Google AI Ultra.
Moet ik overstappen van Claude Fable 5.2 naar Gemini 4 Carbon?
Stap over als je workload API-zwaar en prijsgevoelig is, of als je op beveiliging gericht is. Blijf op Fable 5.2 als je de hoogste algemene intelligentiescore nodig hebt of als je al diep in het Claude-ecosysteem zit. Veel teams zullen uiteindelijk beide gebruiken: Carbon voor bulk-agentenwerk, Fable 5.2 voor de moeilijkste redeneeropdrachten.
- Gemini 4 Carbon
- Claude Fable 5.2
- Gemini vs Claude
- AI benchmarks
- AI pricing