AI8 min leestijdDoor JH Akash
Drex Max v1 uitgelegd: 27B beslissingsmodel op Apple Silicon
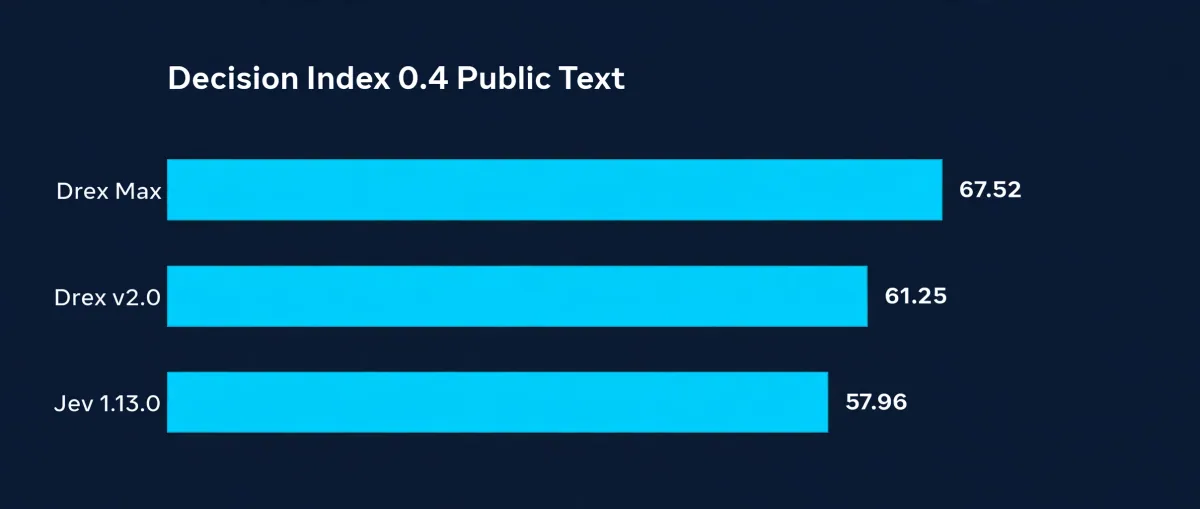
Nace AI maakte Drex Max v1 open source op 1 november 2026: een besluitvormingsmodel van 27B met 67,52 op Decision Index 0,4, 262K context en lokale Mac, draait vanaf 24 GB.
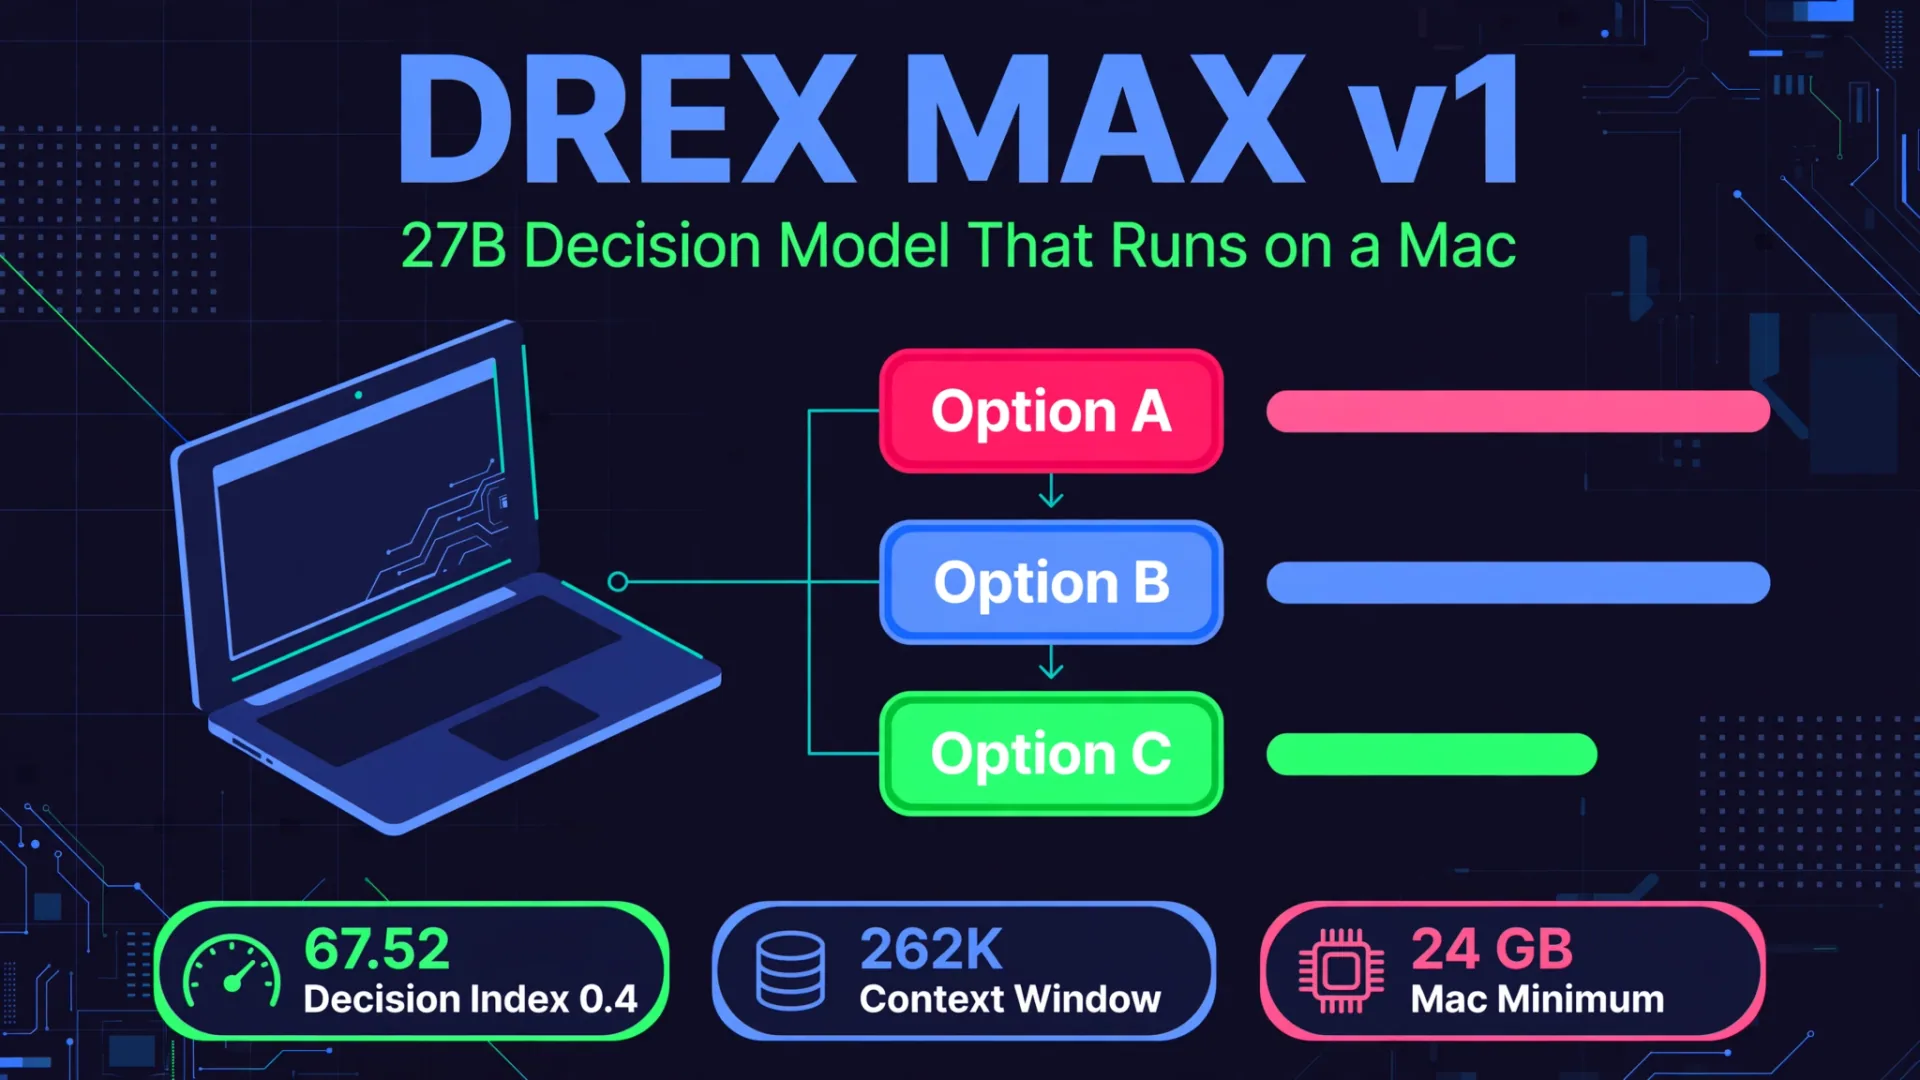
De meeste AI-modellen geven je antwoord met alinea's. Nace AI's Drex Max v1 doet iets anders, en dat verschil is juist het hele punt. Als open source gerapporteerd op 1 november 2026, is Drex Max v1 een beslissingsmodel met 27 miljard parameters. Je geeft het een context en een getypte vraag, en het geeft een kans terug voor elke optie in één vooroverpass. Het genereert helemaal geen tekst.
Dat maakt het een hulpmiddel voor de herhaalde beslissingen binnen software: welk team moet een ticket afhandelen, of een verzoek urgent is, welke route een agent daarna moet nemen. In plaats van een chatbotantwoord te analyseren en te hopen dat het formaat klopt, krijg je cijfers die je kunt dribbelen, loggen en testen.
Het snelle oordeel
| Vraag | Antwoord |
|---|---|
| Wat is er? | Drex Max v1, een 27B open-weight beslissingsmodel van Nace AI |
| Open gewichten gerapporteerd | 1 november 2026 |
| Wat het doet | Beantwoordt getypte vragen met waarschijnlijkheden, in één voorwaartse pass, zonder tekstgeneratie |
| Modelgrootte | 27 miljard parameters, dicht, met een 255-weg uitleeskop |
| Contextvenster | Tot 262.144 tokens, met 16.384 tokens als standaard per verzoek |
| Hoofdscore | 67,52 op Decision Index 0,4 voor publieke tekst, door leveranciers gerapporteerd |
| Lokale Mac-minimum | 24 GB geheugen voor het affiene Q4-checkpoint, alleen tekst |
| Licentie | Nace.AI Open RAIL-M, wat open gewichten zijn, niet open source in strikte zin |
| Wie moet het eerst proberen? | Ontwikkelaars bouwen routing-, triage-, classificatie- of vangrailcontroles |
Wat een beslissingsmodel eigenlijk is
Een normaal taalmodel neemt een prompt en genereert de volgende tokens. Drex Max neemt een andere invoervorm aan. Een verzoek bevat een state, die tekst, JSON of afbeeldingen kan zijn, plus één of meer benoemde vragen. Elke vraag heeft een vast type:
- Keuze. Kies uit benoemde opties, zoals facturering, technisch of iets anders.
- Ja of nee. Een binaire vraag, genaamd
noulin de modelkaart. - Score. Een ordinale score, bijvoorbeeld routine, binnenkort of dringend.
Het model geeft dan een kans terug voor elke optie. In Nace's eigen voorbeeld geeft een dubbel-charge ticket de facturering terug op 0,9988, technisch op 0,0003 en een andere op 0,0009. Dat is een beslissing waarop je direct kunt handelen: route naar facturering, en stuur alleen gevallen met lage betrouwbaarheid naar een mens.
Omdat er niets wordt gegenereerd, is er geen proza om te ontleden, geen opmaakafwijking en geen verzonnen uitleg vermomd als reden. De afweging is net zo duidelijk. Drex Max kan je antwoord niet schrijven, een document in proza samenvatten of een gesprek voeren. Het oordeelt. Een generatief model moet nog steeds het woord doen.
Architectuur in gewone termen
Drex Max is een dichte 27B ruggengraat met 64 lagen. Achtenveertig zijn Gated DeltaNet lineair-aandacht lagen die van links naar rechts lopen, en 16 zijn full-attention lagen die elke vierde laag worden geplaatst. Die full-attention lagen zijn niet-causaal, dus elk token kan zich richten op de hele sequentie. Dat detail is belangrijk voor het uitvoeren ervan: de gebundelde loader past de niet-causale aandacht toe, en Nace waarschuwt dat een gewone causale chatrun de gepubliceerde scores niet zal reproduceren.
Beelden passeren een native vision tower en blijven zichtbaar voor elke vraag in een verzoek. Een 255-weg uitleeskop zet de laatst verborgen toestand om in waarschijnlijkheden over maximaal 255 opties per vraag. De standaard verzoeklimiet is 16.384 tokens, en deze kan worden verhoogd tot het volledige venster van 262.144 tokens.
Benchmarks: wat de cijfers aangeven, en wat niet zeggen
Alle onderstaande scores zijn door de leverancier gerapporteerd door Nace AI op de Hugging Face modelkaart, gedateerd 19 oktober 2026. Behandel ze als Nace's eigen resultaten op publieke suites, niet als onafhankelijke verificatie. Verschillende benchmarks zijn niet direct vergelijkbaar, dus de onderstaande tabellen houden elke index gescheiden.
Decision Index 0.4, publieke tekst
| Model | Publieke index | Raw | Gereedschappen | Taal | Ophalen | Kennis en redenering | Kunst |
|---|---|---|---|---|---|---|---|
| Drex Max (27B) | 67.52 | 75.4 | 81.9 | 72.2 | 68.8 | 57.1 | 53.4 |
| Drex v2.0 (35B) | 61.25 | 70.55 | 76.5 | 65.3 | 63.0 | 47.9 | 53.9 |
| Jev 1.13.0 | 57.96 | 68.55 | 75.1 | 59.2 | 55.4 | 53.9 | 39.1 |
Drex Max leidt Drex v2.0 met 6,27 punten op deze publieke index, en Jev 1.13.0 met 9,56 punten. De publieke index bedraagt gemiddeld 37 benchmarks in vijf gebieden. De run omvatte 140.620 verzoeken, waarvan 140.178 scorebaar waren en allemaal werden beantwoord. Onbeantwoorde verzoeken tellen als fout, wat de juiste regel is om te noteren voordat je scores tussen modellen vergelijkt.
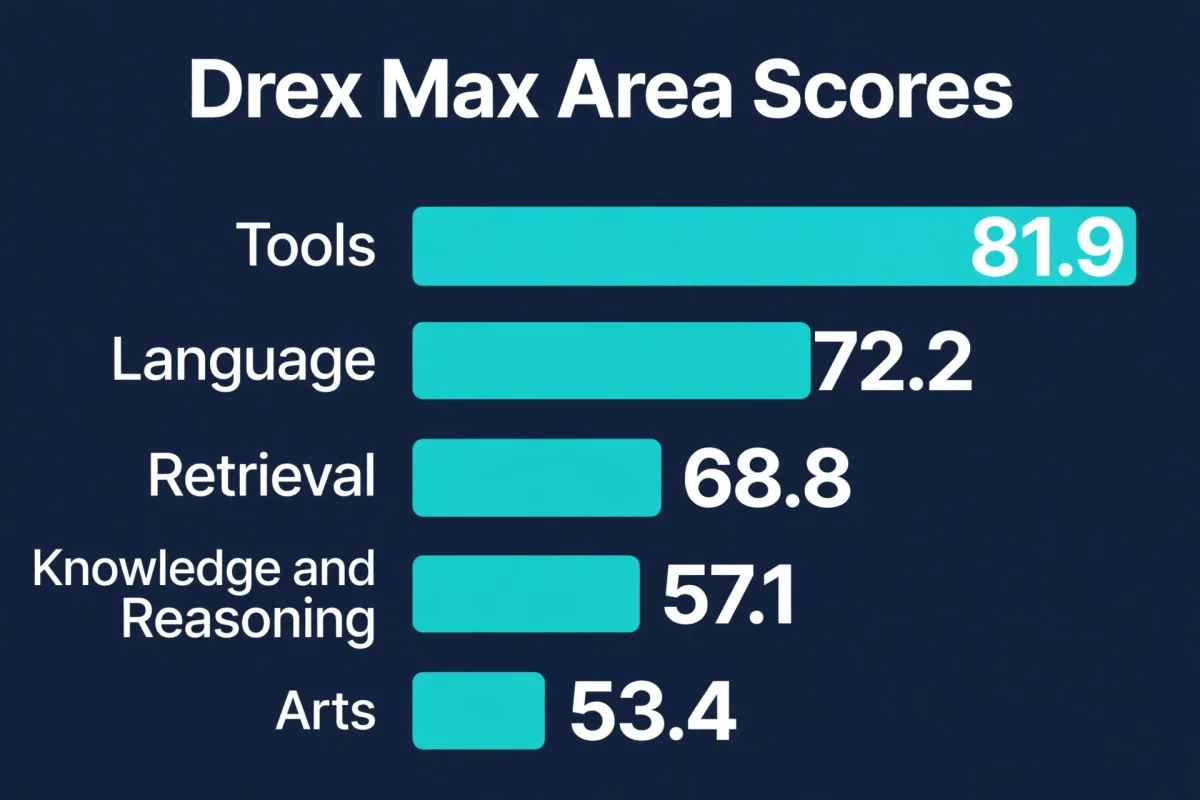
De gebiedsverdeling is nuttiger dan de kop. Tools op 81,9 is het sterkste gebied, gevolgd door Taal op 72,2 en Retrieval op 68,8. Kennis en Redeneren op 57,1 en Kunst op 53,4 zijn zwakker, wat past bij een model dat is gebouwd voor gestructureerde beslissingen in plaats van brede kennis of creatief oordeel.
Andere gerapporteerde scores, gescheiden gehouden
| Index | Drex Max-score | Noten |
|---|---|---|
| Publieke visie-index, Decision Index 0.4 | 73.92 | Verspreid over 12.210 rijen, inclusief InfographicVQA op 97,3 |
| Kunstmatige Analyse Beslissingsindex | 64 | Vierde van 18, één punt achter de koplopers met 65 |
| JevBench | 92,2 procent | 213 van 231 |
| Beslissingskamer v4 | 94,30 procent | 1010 van 1071 |
Meng deze niet tot één ranglijst. De Artificial Analysis-index, bijvoorbeeld, is een gewogen gemiddelde van zijn eigen vier tests, en plaatst Drex Max achter drie modellen op 65 en voor Claude Haiku 5.5 (Laag) op 61. De eerlijke lezing is beperkter: bij beslissingstaken is Drex Max concurrerend met de top van zijn eigen categorie, en het sterkst waar de taak lijkt op het gebruik van gereedschap of het ophalen.
Wat het kost om te draaien: hardware, geen tokens
Er staat geen prijs per token API op de modelkaart, dus begroet dit niet zoals een gehoste chatbot. De kosten zijn de downloadgrootte en hardware. Nace publiceert verschillende checkpoints voor verschillende machines.
| Controlepunt | Grootte | Geheugen nodig | Het beste voor |
|---|---|---|---|
| BF16 Gewichten | Ongeveer 49 GB | NVIDIA H100 80 GB, 48,6 GiB geladen | Full-quality Python draait op NVIDIA GPU's, inclusief images |
| 8-bits ruggengraat | Ongeveer 26 GB | NVIDIA L40S 48 GB, 25,9 GiB geladen | Kleinere NVIDIA draait, inclusief afbeeldingen |
| Q8_0 GGUF | 27,25 GB | 48 GB Apple Silicon Mac | Lokale Mac-tekst loopt via llama.cpp, Ollama of Kapitsa |
| Affiene Q4 | 14,45 GB | 24 GB of meer Apple Silicon Mac | Lokale Mac-tekst draait via Kapitsa of MLX |
Twee limieten bepalen de keuze. Ten eerste zijn lokale Mac- en CPU-paden voorlopig alleen tekst. Als je keuze images nodig hebt, heb je het Python-pad nodig op een NVIDIA GPU. Ten tweede hield kwantisatie het goed stand in Nace's tests: op een 48 GB Apple M5 Pro kwam de Q80 GGUF binnen 0,02 % van H100 bf16 aan binnen 0,02 per waarschijnlijkheid, en bleef de affiene Q4 binnen 0,0329 van Q80 zonder keuzeflips. Smaller veranderde het geselecteerde antwoord in die tests niet.
Voor een eerste test is het praktische pad het kleinste dat bij je machine past. Download het affine Q4 checkpoint als je een 24 GB Mac hebt, of de Q8_0 GGUF als je 48 GB hebt, en test het op je eigen tickets, routes of beleidscontroles voordat je een publieke score vertrouwt. Een benchmark suite is niet jouw werklast.
Welke opstelling ik moet kiezen
Als je een Mac van 24 GB hebt en alleen tekstkeuzes gebruiken: gebruik dan het affine Q4-checkpoint via Kapitsa of MLX, en test eerst met je echte categorieën.
Als je een Mac van 48 GB hebt en alleen tekstkeuzes hebt: gebruik dan de Q8_0 GGUF via llama.cpp, Ollama of Kapitsa. Het is dichter bij volledige bf16-uitgang en draait nog steeds lokaal.
Als je images-beslissingen nodig hebt: gebruik dan het Python-pad op een NVIDIA GPU met bf16- of 8-bits gewichten. Verwacht niet dat de Mac-builds nog met images omgaan.
Als je helemaal geen model wilt draaien: gebruik dan de gehoste versie van Nace voor routing-, classificatie- en beleidscontroles, en controleer de huidige prijs op de Nace-console voordat je daarop bouwt. De modelkaart publiceert geen gehoste prijs, dus deze post verzint er geen uit.
De licentievanger om te lezen vóór commercieel gebruik
Open gewichten zijn niet hetzelfde als open source. Je krijgt de gewichten, maar niet per se de trainingsdata of een permissieve open-source licentie. Drex Max wordt uitgebracht onder de Nace.AI Open RAIL-M-licentie. Een onafhankelijke vermelding die de licentievlaggen las, is het waard om met je eigen juridische beoordeling te controleren, inclusief gratis commercieel gebruik alleen onder inkomsten- en financieringsdrempels, en een verbod op concurrerende beslissingsproducten. Lees de daadwerkelijke licentie in de modelrepository voordat je er een commercieel product op verzendt. Voor persoonlijke, onderzoeks- of interne tests is de lokale release de gemakkelijke manier om het te evalueren.
Waarom deze release belangrijk is voor AI-agenten
Agenten falen meestal niet bij het genereren, maar bij de kleine beslissingen tussen stappen: routeer dit, escaleren dat, laat deze tool aanroepen, blokkeer dat. Een generatief model kan die vragen beantwoorden, maar het beantwoordt in proza, en proza moet worden ontleed. Een beslissingsmodel geeft een kansverdeling terug over een vaste set opties, precies wat een agentrouter, een triagewachtrij of een vangrail wil.
Daarom is de lokale invalshoek ook belangrijk. Routing- en beleidscontroles raken vaak gevoelige tickets, documenten of screenshots. Het lokaal uitvoeren van de beslissing houdt die context op je eigen hardware in plaats van het naar een gehoste dienst te sturen voor elke beoordeling. Drex Max is geen vervanging voor een frontier-chatbot. Het is een gespecialiseerde judge die je naast een chatbot kunt gebruiken, en de open-weights release van 1 november maakt dat praktisch voor ontwikkelaars met een capabele Mac of GPU.
Wil je agenten bouwen die dit soort routing in productie gebruiken? Lees onze gidsen over AI-agentontwikkelingsdiensten en hoe je een AI-automatiseringsbureau kunt inhuren. Voor meer open-weight lanceringen, zie Mistral Large 4 open-weights uitgelegd, Liquid AI LFM3 uitgelegd, Kimi K3.1 Pro uitgelegd en Apple Intelligence in China op Alibaba Qwen.
Bronnen: Nace AI-modelkaart op Hugging Face (https://huggingface.co/nace-ai/drex-max-v1), MarkTechPost-berichtgeving gerapporteerd op 1 november 2026 (https://wisevoter.com/world/2026/11/01/nace-ai-open-sources-drex-max-v1), en Artiverse-verslaggeving, waarin wordt vermeld dat het wordt gesponsord door Nace AI (https://www.artiverse.ca/drex-max-puts-a-27b-decision-model-on-apple-silicon/).
Wat is Drex Max v1?
Drex Max v1 is een beslissingsmodel met 27 miljard parameters van Nace AI. Het beantwoordt getypte vragen over een bepaalde context met een kans voor elke optie, in één voorwaartse pass, en genereert geen tekst.
Is Drex Max een chatbot?
Nee. Het chat niet, schrijft geen proza en genereert geen antwoorden. Het beoordeelt opties die je definieert, wat het nuttig maakt voor routering, triage, classificatie en vangrailcontroles binnen software en AI-agenten.
Kan Drex Max draaien op een Mac?
Ja, voor tekstkeuzes. Het affine Q4-checkpoint draait op Apple Silicon Macs met 24 GB of meer geheugen via Kapitsa of MLX, en de Q8_0 GGUF heeft 48 GB nodig. Image-beslissingen hebben nog steeds het Python-pad nodig op een NVIDIA GPU.
Wat is de belangrijkste benchmarkscore van Drex Max?
Nace rapporteert 67,52 op Decision Index 0,4 voor publieke tekst, voor Drex v2.0 met 61,25 en Jev 1.13.0 met 57,96. Dit zijn door leveranciers gerapporteerde scores, dus test het model op je eigen workload voordat je erop vertrouwt.
Is Drex Max gratis en open source?
De gewichten zijn openbaar onder de Nace.AI Open RAIL-M-licentie, maar dat zijn open gewichten, niet open source in strikte zin. Controleer de licentie voor commerciële limieten voordat je een product daarop verzendt.
Hoeveel context kan Drex Max aan?
Tot 262.144 tokens, met 16.384 tokens als standaard per verzoek. Verhoog de limiet alleen als je verzoeken daadwerkelijk het langere venster nodig hebben.
- drex max
- nace ai
- decision model
- open weight models
- apple silicon
- ai agents