AI10 min leestijdDoor JH Akash
Liquid AI LFM3 Uitgelegd: 6 Open-Weight 2B-modellen
Liquid AI lanceerde LFM3 op 27 oktober 2026: zes open-weight 2B-klasse modellen uit één 1,7B backbone, 256K context, 1 GB op 4-bit, API vanaf $0,08 per 1M tokens.
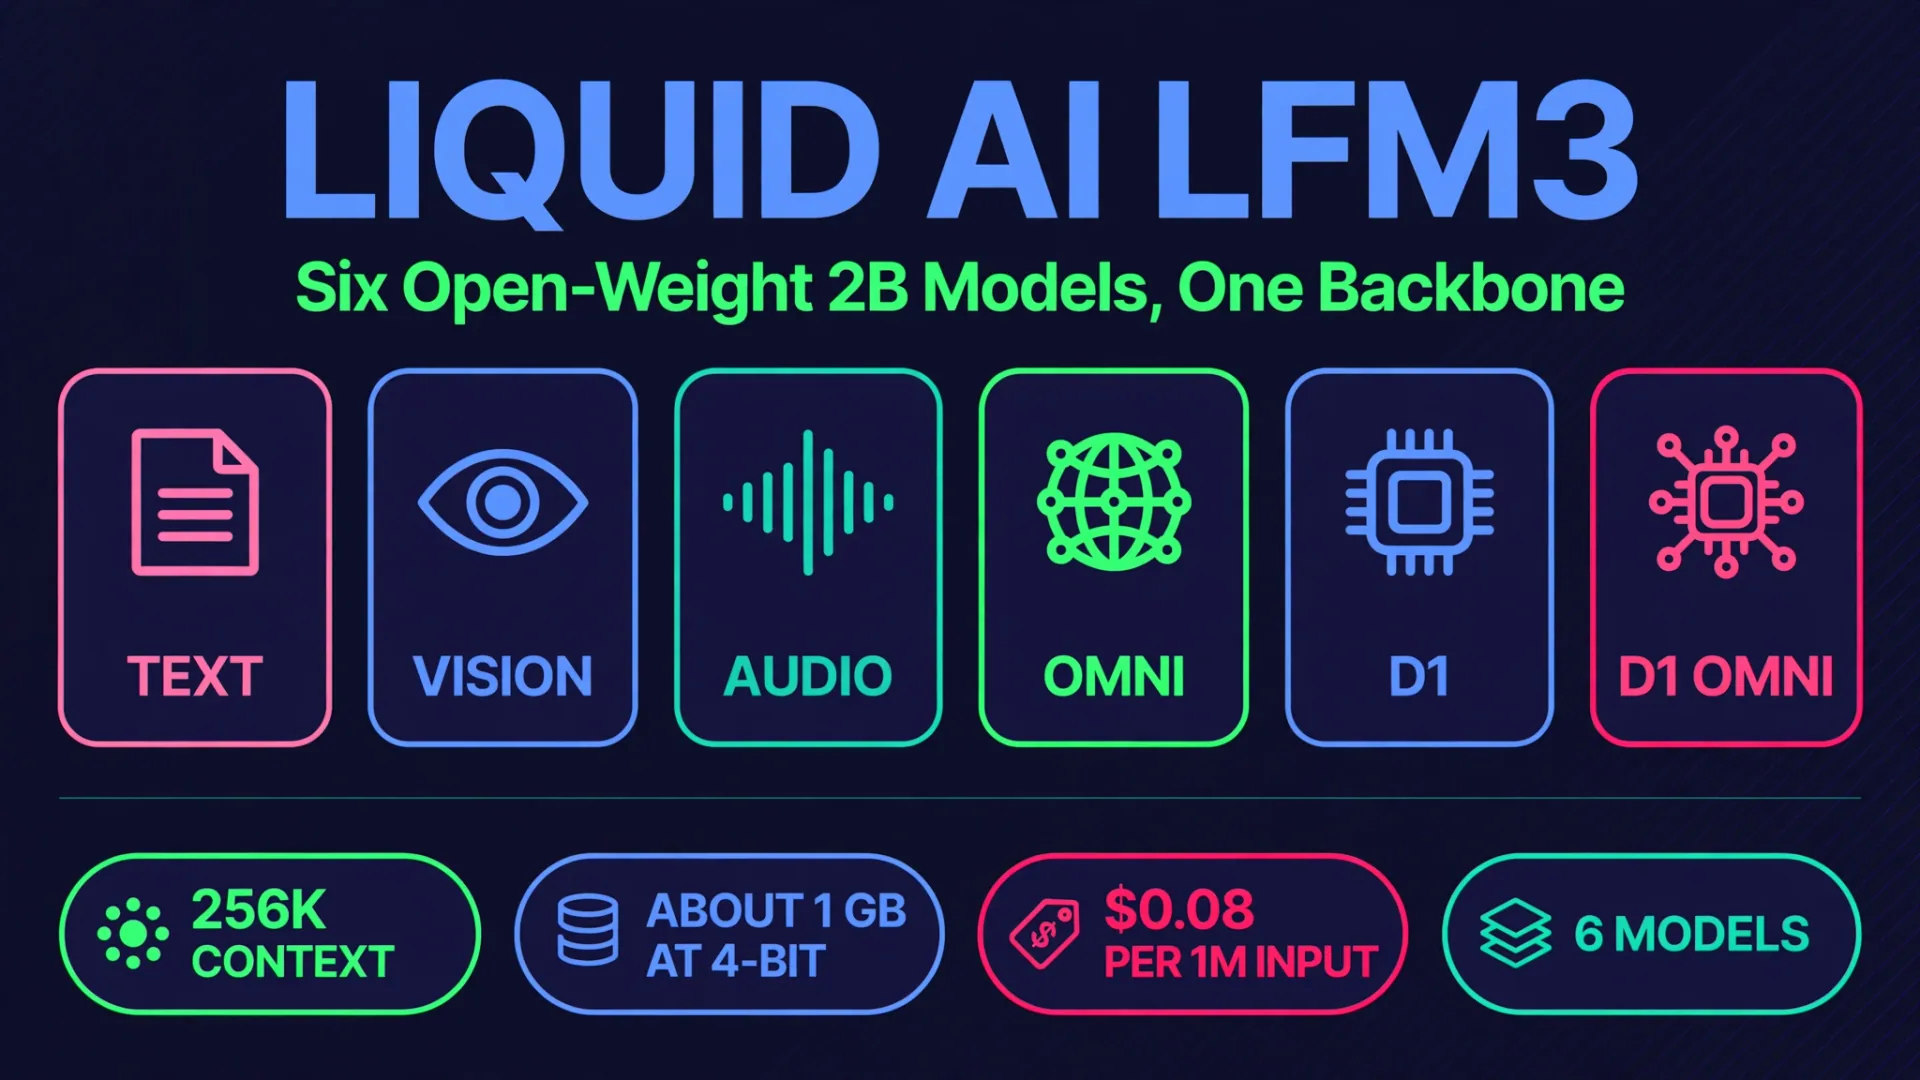
Liquid AI lanceerde LFM3 op 27 oktober 2026, en het is een ander soort modelrelease. In plaats van één gigantisch vlaggenschip is LFM3 een familie van zes open-weight modellen in de 2B-parameterklasse, allemaal vertakkend uit dezelfde 1,7B-backbone. Text-, vision-, audio-, omni- en twee-beslissingsmodellen delen één architectuur, zodat een team de modaliteit kan kiezen die het nodig heeft zonder voor elk een nieuwe stack te leren. De pitch is geen pure kracht. Het is footprint: een capabel klein model dat draait op telefoons, laptops, een Raspberry Pi 5 en edge-hardware, en dat kan worden afgesteld op één enkele GPU.
De timing is belangrijk. Frontier-modellen worden steeds groter en duurder om te draaien, terwijl de meeste echte zakelijke taken, zoals het lezen van een document, het controleren van een foto, het beantwoorden van een spraakcommando, het scoren van een lijst met opties, geen gigantisch model nodig hebben. Ze hebben een klein, snel, privé model nodig dat draait waar de data al staat. LFM3 is de gok van Liquid AI dat hier de volgende golf van AI-implementatie plaatsvindt: op het apparaat, op locatie en binnen door bedrijven gecontroleerde systemen.
Het snelle oordeel
| Vraag | Antwoord |
|---|---|
| Wat is er? | LFM3, een familie van zes opengewicht 2B-klasse modellen van Liquid AI |
| Gelanceerd | 27 oktober 2026 |
| Gedeelde ruggengraat | LFM3-1.7B-Base, 1.73B parameters |
| Context | 256K-tokens op de modelkaart (gehoste API vermeldt 128K, zie prijsnotaat hieronder) |
| Trainingsgegevens | 22T-tokens van vooropleiding |
| Voetafdruk | Ongeveer 1 GB geheugen bij 4-bits precisie voor het tekstmodel |
| Licentie | LFM Open License v1.0, open-gewicht |
| Beschikbaar op | Hugging Face, Liquid AI Playground, Liquid AI API, OpenRouter, Qualcomm AI Hub, Vercel |
| Het beste voor | On-device agenten, zichtinspectie, stem en gekalibreerde beslissingen |
| Niet voor | Zware agentische codering of complexe meerstapsredenering (Liquid AI zegt dat zelf) |
De zes modellen, één ruggengraat
Elk LFM3-model vertakkt van LFM3-1.7B-Base. Die gedeelde ruggengraat maakt de familie bijzonder: één architectuur, zes specialisaties.
| Model | Ingangen | Uitgangen | Waar het voor is |
|---|---|---|---|
| LFM3-1.7B | Tekst | Tekst | Algemene tekst, agenten, gebruik van tools |
| LFM3-VL-2B | Tekst, afbeeldingen, video | Tekst | Visie en videobegrip, inspectie |
| LFM3-Audio-2B | Tekst of audio | Tekst of spraak | Spraakcommando's, transcriptie, spraak |
| LFM3-Omni-2B | Tekst, afbeeldingen, video, audio | Tekst en spraak | Volledige multimodale assistenten |
| d1-2B | Vragen (lijst) | Gekalibreerde antwoorden | Beslissingen met waarschijnlijkheden, niet met gegenereerde tekst |
| d1-omni-2B | Multimodale vragen | Gekalibreerde antwoorden | Beslissingen gebaseerd op beelden, audio en documenten |
De beslissingsmodellen verdienen een speciale opmerking omdat ze anders werken dan een normale chatbot. In plaats van een alinea te genereren, beantwoordt d1 een hele lijst vragen in één voorwaartse doorgang, elk met een gekalibreerde waarschijnlijkheid. Het kan ook getypte antwoorden teruggeven: wijzen op een object, een waarde uit een document lezen, een getal schatten met een bereik, of elke optie kiezen die van toepassing is. Voor zakelijke workflows zoals triage, scoring en routing is die gestructureerde output vaak nuttiger dan vloeiend proza.
Binnen de ruggengraat: een tri-hybride architectuur
LFM3-1.7B-Base heeft 24 lagen: 13 gated short convoluties, vijf sliding-window aandachtslagen met een venster van 256 tokens, en zes globale aandachtslagen. De convoluties gebruiken een kernelgrootte van 7, tegenover 3 in LFM2. Drie wijzigingen definiëren het ontwerp: headwise gated attention, die activatie-uitschieters kan onderdrukken die de kwantisatie schaden; partiële RoPE, waarbij globale aandachtslagen alleen de helft van elke kop met de hoogste frequentie roteren; en een sandwichnorm die de input en output van elk blok normaliseert.
Liquid AI zegt dat deze architectuur is voortgekomen uit een hardware-in-the-loop zoektocht over 14 apparaat- en backendcombinaties, waaronder de Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI, Arm en x86 cloud-CPU's, GPU's en de Qualcomm Hexagon NPU. De praktische resultaten, allemaal door leveranciers gerapporteerd: LFM3-1.7B verslaat zijn voorganger LFM2.5-2.6B met 35 procent minder parameters, draait ongeveer 25 procent sneller met 8K-tokens in context, en decodeert 1,8 tot 2,8 keer sneller dan het volgende model op de drie on-device setups die Liquid AI testte. Op één NVIDIA B300 zegt Liquid AI dat LFM3-1.7B 3,6 miljard tokens per dag kan produceren bij 1.024 gelijktijdige verzoeken.
Pre-training verliep op 22T-tokens, waarbij de laatste 3,5T-tokens een midden-trainingsfase vormden op gecureerde data met een groter aandeel agentische traces en tool-aanroepen, wat ook het contextvenster uitbreidde tot 256K-tokens. Post-training verliep in vier fasen: supervised fine-tuning op 1,75T-tokens, gemengd reinforcement learning, multi-domein on-policy distillatie door zes specialistische reinforcement-learning-docenten, en agentisch reinforcement learning binnen echte agenten-harnesses.
Benchmarks: sterk op agenten en tools, eerlijk over limieten
Alle onderstaande benchmarkcijfers zijn door de leverancier gerapporteerd door Liquid AI, vanaf de lanceringspost en modelkaart. Behandel ze als de eigen metingen van Liquid AI, niet als onafhankelijke resultaten.
| Benchmark | LFM3-1.7B | Wat het test |
|---|---|---|
| LiveClaw | 45.60 | Agentische taken |
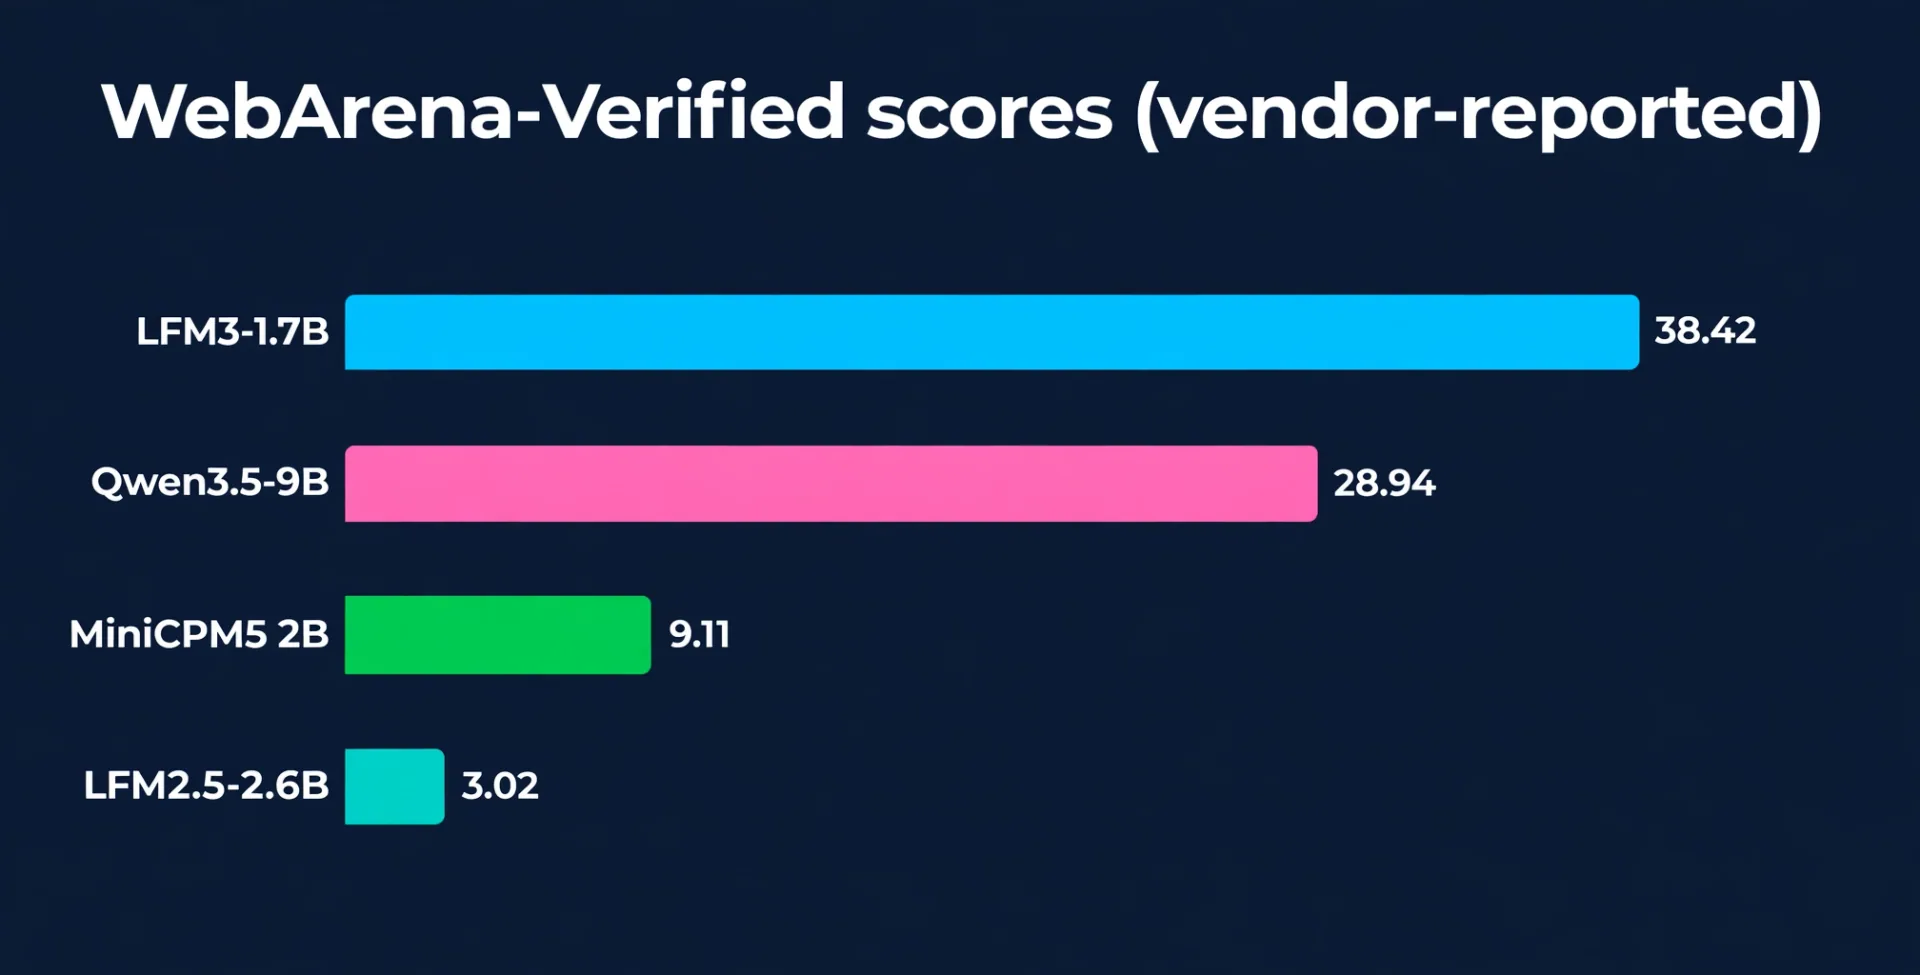
| WebArena-Verified | 38.42 | Webagenttaken |
| BFCL V4 | 71.39 | Gereedschapsoproep |
| ToolSandbox | 80.36 | Gereedschapsgebruik |
| IFEval | 96.66 | Instructieopvolgen |
| SWE-bank Geverifieerd | 43.40 | Agentische codering |
| GPQA Diamant | 63.37 | Expertise |
| Humanity's Last Exam (geen gereedschap) | 7.17 | Harde kennis |
De sprong op WebArena-Verified is de kop: 38,42 voor LFM3-1,7B tegenover 3,02 voor zijn voorganger LFM2.5-2.6B. Dat is een echte verandering in aard voor een 1.7B-model, en het sluit aan bij de nadruk op agentische training. Maar dezelfde tabel toont de grenzen: een 7.17 op Humanity's Last Exam zonder tools is zwak, en de eigen modelkaart van Liquid AI geeft aan dat het model niet wordt aanbevolen voor agentische codering of complexe meerstapsredenering vanwege de kleine omvang. Kleine modellen zijn een ruil, geen gratis lunch.
De andere modaliteiten hebben hun eigen nummers. LFM3-VL-2B is het eerste LFM-visiemodel dat video-input accepteert, en Liquid AI meldt dat het het gemiddelde over 62 visuele benchmarks verhoogt van 57,6 naar 71,4 tegenover LFM2.5-VL-3B, terwijl 1,9B-parameters worden gebruikt tegenover 3,1B. LFM3-Audio-2B ondersteunt 18 talen, met spraakkwaliteit van 3,83 op UTMOSv2 tegenover 3,22 voor zijn voorganger, tijd tot eerste token zo laag als 50 ms, en spraakgeneratie van ongeveer 87x realtime op één CPU-thread op een Apple M4 Max. LFM3-Omni-2B, met 2,2B parameters, zou modellen tot 10,7B parameters versloegen op de Daily-Omni, WorldSense en AV-SpeakerBench audio-visuele begripsbenchmarks. Het d1-2B beslissingsmodel vervangt d1-3B met een derde minder parameters en scoort 75,5 tegenover 64,0 op ImajevBench.
Prijzen: enkele van de goedkoopste hosted tokens die er zijn
De prijzen van gehoste API's komen uit de modelcatalogus van Liquid AI, zoals gerapporteerd door VentureBeat. De prijzen zijn in USD per miljoen tokens.
| Model | Input | Gecachte invoer | Output | 1M invoer + 1M uitgang |
|---|---|---|---|---|
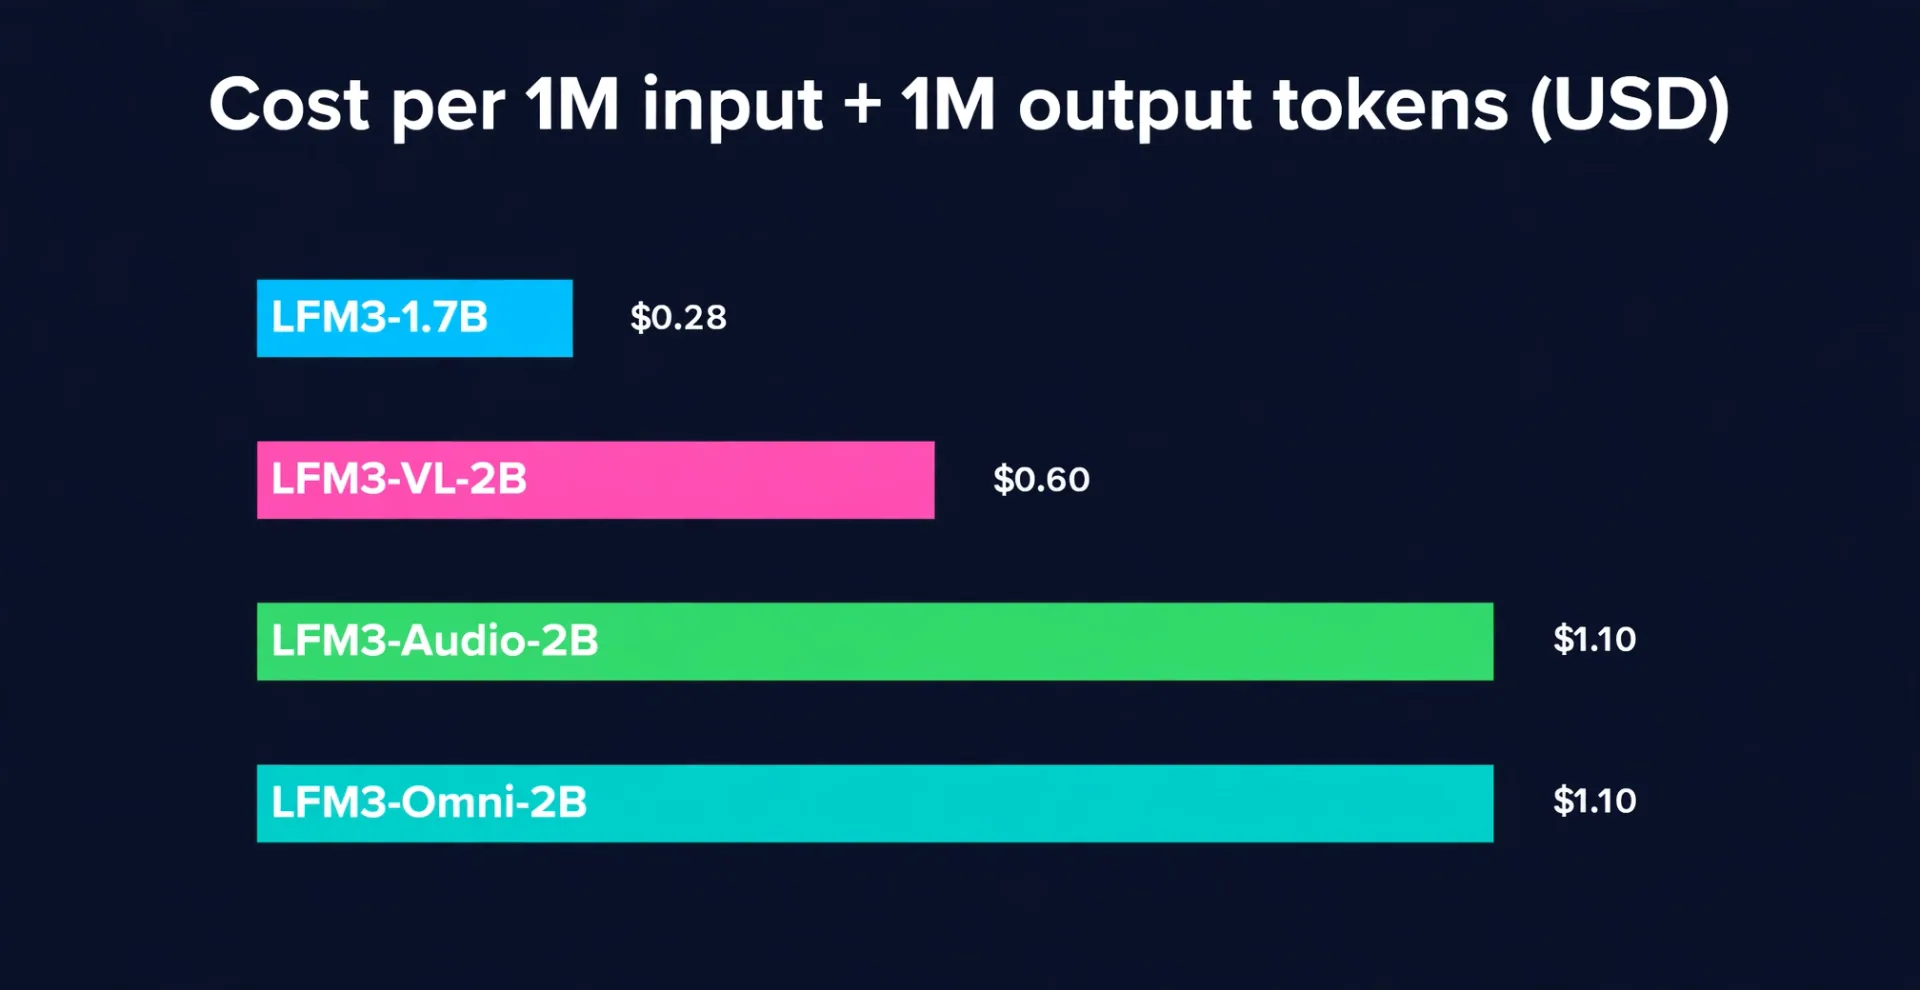
| LFM3-1.7B | $0.08 | $0.02 | $0.20 | $0.28 |
| LFM3-VL-2B | $0.10 | $0.02 | $0.50 | $0.60 |
| LFM3-Audio-2B | $0.10 | $0.02 | $1.00 | $1.10 |
| LFM3-Omni-2B | $0.10 | $0.02 | $1.00 | $1.10 |
Audiotokens kosten extra op de Audio- en Omni-modellen: $2,00 per miljoen audio-invoertokens en $10,00 per miljoen audio-uitvoertokens. Twee dingen om te controleren voordat je budgettert: de hosted API vermeldt een contextlimiet van 128.000 tokens, terwijl de modelkaart 256K aankondigt, dus bevestig welke limiet geldt voor jouw deploymentroute. En voor privacygevoelige kopers stelt Liquid AI nul gegevensopslag op zijn gehoste modellen: ingediend materiaal wordt gebruikt om verzoeken te vervullen en wordt niet behouden, geregistreerd of gebruikt voor training.
Ter vergelijking: het tekstmodel met $0,28 per miljoen input plus een miljoen outputtokens ligt ver onder het vlaggenschipniveau. Dat is het doel van deze klasse: als je miljoenen kleine taken uitvoert, bepaalt de prijs per token of het product überhaupt levensvatbaar is. Als je de prijzen van gehoste kleine modellen breder vergelijkt, laat onze recente analyse van GPT-6.1 Terra zien hoe OpenAI zijn eigen snelle mid-tier model prijst, en onze Kimi K3.1 Pro-post behandelt een andere open-weight lancering uit dezelfde maand.
Welk model moet je kiezen?
Kies LFM3-1.7B voor tekstagenten, documentwerk en tool-calling workflows, waarbij kosten en snelheid belangrijker zijn dan frontier reasoning. Het is de standaardkeuze en degene met de meeste benchmarkdekking.
Kies LFM3-VL-2B voor alles wat naar beelden of video kijkt: kwaliteitsinspectie, documentlezen, schadebeoordeling, plankcontroles. Het eigen voorbeeld van Liquid AI is veelzeggend: het fijn afstellen van VL-2B op ongeveer 3.000 openbare foto's van windturbinebladen gedurende een paar uur op één A100 verhoogde de nauwkeurigheid van defectclassificatie tot 67 procent. Dat is het handboek voor kleine modellen: begin met een degelijk algemeen model, verfijn je eigen beelden, zet het uit op je eigen hardware.
Kies LFM3-Audio-2B voor spraakinterfaces, oproepafhandeling en transcriptie waar lage latentie belangrijk is. Een tijd van 50 ms tot eerste token en spraakgeneratie op het apparaat maken het een kandidaat voor kiosken, auto's en fabrieksvloeren zonder een retour naar de cloud.
Kies LFM3-Omni-2B wanneer één assistent tekst, beeld, video en audio samen moet afhandelen, bijvoorbeeld een hulpverlener in het veld die de machine ziet, de technicus hoort en terugpraat.
Kies d1-2B of d1-omni-2B als je beslissingen nodig hebt, niet proza: triage-wachtrijen, leadscore, content routing, of elke workflow waarbij een gekalibreerde waarschijnlijkheid en een gestructureerd antwoord een alinea verslaan. Dit is het meest enterprise-achtige idee in de familie, en het minst als een chatbot.
Elk LFM3-model kan worden fine-tuned op één enkele GPU, met gepubliceerde notebooks voor supervised fine-tuning, DPO, GRPO en voortdurende pre-training. De runtimes omvatten llama.cpp, MLX, vLLM, SGLang en Ollama, met checkpoint-varianten in BF16, FP8, NVFP4, GGUF, MLX en ONNX. Day-0 lanceringspartners zijn onder andere Ambarella, AMD, Arm, Intel via OpenVINO, NVIDIA, OpenRouter, Qualcomm en Vercel, en Liquid AI zegt dat Mercedes-Benz en Shopify samenwerkten voor pre-release testen en evaluatie.
Liquid AI paste VL-2B ook aan tot drie roboticamodellen voor orkestratie, navigatie en manipulatie, met een gemiddeld succes van 96,2 procent over de vier LIBERO-suites en 45,7 procent op RoboCasa-GR1 tabletoptaken, met actiechunks die in minder dan 50 ms worden gegenereerd op een Jetson AGX Orin. Robotica is nog te vroeg voor een 2B-model, maar het latentiegetal is het interessante onderdeel: kleine modellen kunnen de lus snel genoeg sluiten voor echte controle.
De eerlijke grenzen
Geen enkel 1.7B-model vervangt een frontiermodel, en LFM3 doet ook niet alsof dat zo is. Kennisrijke vragen, harde wiskunde en lange redeneermethoden met meerdere stappen zijn zwakke plekken, en de eigen richtlijnen van Liquid AI leiden gebruikers weg van agentic coding met deze grootteklasse. Als je taak diepgaand onderzoek of complexe planning vereist, wil je nog steeds een groter model, mogelijk met LFM3 die de goedkope, snelle, hoogvolumelaag eromheen afhandelt. Die gelaagde opzet, kleine modellen aan de rand en frontiermodellen voor de moeilijke gevallen, is ook hoe de meeste serieuze AI-agentontwikkelingsprojecten daadwerkelijk worden opgebouwd. Als je zo'n systeem plant, bouwt ons team agenten op deze manier; kijk hoe je een AI-automatiseringsbureau kunt inhuren om te bepalen wat je moet controleren voordat je je committeert.
Het andere om te controleren is de licentie. LFM3 wordt geleverd onder de LFM Open License v1.0 als open-weight, maar "open" licenties verschillen in hun commerciële voorwaarden, dus lees de daadwerkelijke licentietekst van je revenue tier en use case voordat je er een commercieel product op levert.
FAQ
Wat is Liquid AI LFM3?
LFM3 is een familie van zes opengewicht AI-modellen die op 27 oktober 2026 door Liquid AI zijn gelanceerd. Alle zes verankeren zich in dezelfde LFM3-1.7B-Base backbone en bestrijken tekst, beeld, audio, omni en besluitvorming, in de 2B-parameterklasse.
Hoe groot is de LFM3-1.7B eigenlijk?
Het tekstmodel heeft 1,73 miljard parameters, een contextvenster met 256 000 tokens op de modelkaart en een vocabulaire van 128.000 tokens, met ondersteuning voor 16 talen. Bij 4-bits precisie kost het ongeveer 1 GB geheugen, waardoor het op telefoons en kleine edge-apparaten kan draaien.
Kan LFM3 op een telefoon draaien?
Ja, dat is het ontwerpdoel. Liquid AI testte het op de Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI en de Qualcomm Hexagon NPU, en meldt dat het 1,8 tot 2,8 keer sneller decodeert dan het volgende model op de geteste on-device setups.
Hoeveel kost de LFM3 API?
Het tekstmodel kost $0,08 per miljoen inputtokens, $0,02 gecachet en $0,20 per miljoen outputtokens, wat neerkomt op $0,28 voor een miljoen input plus een miljoen outputtokens. Vision kost $0,60 op dezelfde basis, en Audio en Omni kosten $1,10 vóór audio-token kosten.
Is LFM3 echt open?
De gewichten zijn open-weight onder de LFM Open License v1.0 en beschikbaar op Hugging Face, de Liquid AI Playground en de Liquid AI API. Controleer de licentievoorwaarden voor jouw commerciële gebruikssituatie, want open-weight licenties verschillen.
Welk LFM3-model moet ik kiezen?
Kies 1,7B voor tekstagenten, VL-2B voor afbeeldingen en video, Audio-2B voor spraak, Omni-2B voor gecombineerde multimodale assistenten, en d1-2B of d1-omni-2B wanneer je gekalibreerde beslissingen met kansen nodig hebt in plaats van gegenereerde tekst.
Hoe verhoudt LFM3 zich tot de Kimi K3.1 Pro of GPT-6.1 Terra?
Ze richten zich op verschillende niveaus. Kimi K3.1 Pro is een veel groter open model dat zich richt op de grens, en GPT-6.1 Terra is OpenAI's gehoste mid-tier computermodel. LFM3 is kleiner, goedkoper en gebouwd om op het apparaat te draaien. Vergelijk ze op basis van je eigen taak en hardware, niet op één enkele benchmark, omdat verschillende benchmarks verschillende vaardigheden meten.
Waar kan ik LFM3 proberen?
Op Hugging Face, de Liquid AI Playground, de Liquid AI API, en via partners zoals OpenRouter, Qualcomm AI Hub en Vercel.
Bronnen: Liquid AI lanceringsbericht, Unite.AI lanceringsberichtgeving, VentureBeat-prijsdekking en de LFM3-1.7B modelkaart op Hugging Face.
- liquid ai lfm3
- lfm3
- open weight models
- on-device ai
- liquid ai
- ai agents
- small language models