AI8 min leestijdDoor JH Akash
GDPx uitgelegd: De benchmark waarbij de beste AI slechts 12% scoort.
SemiAnalysis publiceerde GDPx op 2 november 2026: 206 echte professionele taken in 11 vakgebieden, en de beste AI ter wereld behaalde slechts 12,0%. Scores, kosten en waar de modellen falen.
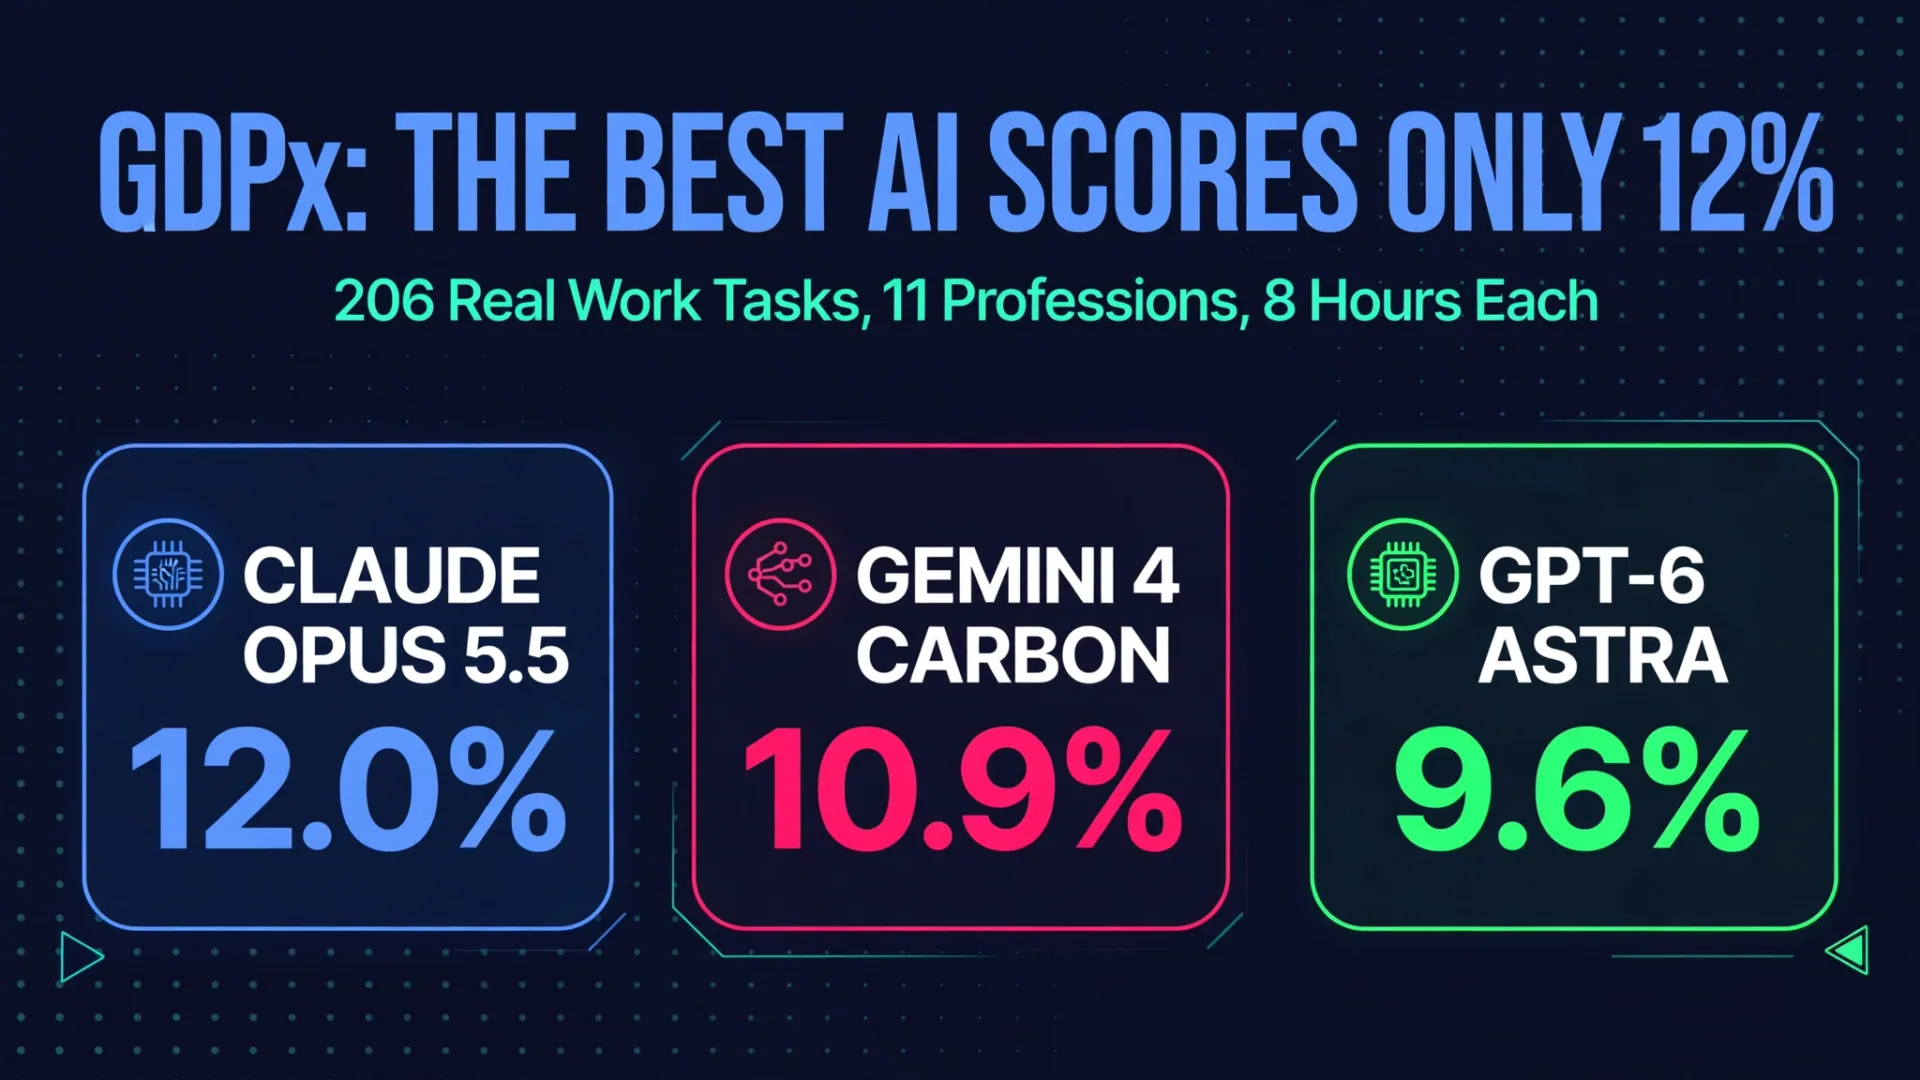
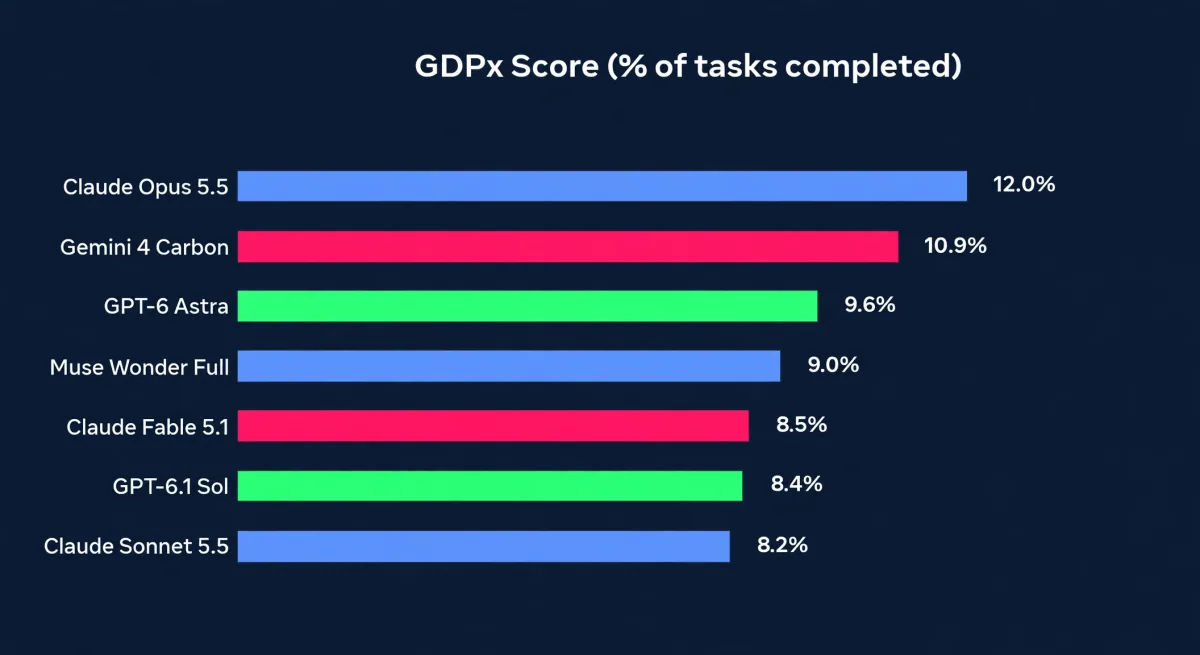
Op 2 november 2026 publiceerde onderzoeksbureau SemiAnalysis GDPx, een nieuwe benchmark die AI-agenten beoordeelt zoals een werkgever dat zou doen: niet op examenvragen, maar op echt professioneel werk. Het hoofdresultaat is moeilijk te draaien. Het beste model ter wereld, Anthropic's Claude Opus 5.5, voltooide slechts 12,0% van de taken. Google's Gemini 4 Carbon werd tweede met 10,9%, en OpenAI's GPT-6 Astra derde met 9,6%. Geen enkel getest model haalde ook maar in de buurt van een vijfde van het totaal.
Die 12% is geen verhaal over modellen die slechter worden. Het is een verhaal over de test die eerlijk wordt. GDPx zet de agent in een gesimuleerde werkplek, geeft hem tot acht uur per taak en vraagt hem de klus van begin tot eind af te maken. De meeste benchmarks beoordelen antwoorden. GDPx beoordeelt opdrachten, en een taak die voor 90% klaar is maar de verkeerde oplevering heeft, een gebrekkige regel of een ontbrekend bestand telt nog steeds als mislukt.
Snel oordeel
| Model | GDPx-score | Gemiddelde kosten per taak | Best bij |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | Quant trading, hardwareontwerp, chipontwerp |
| Gemini 4 Carbon (Google) | 10.9% | $16.29 | Biologie, software engineering (op een beperkte manier) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | Recursieve zelfverbetering, materiaalkunde |
| Muze Wonder Volledig (Meta) | 9.0% | Niet gepubliceerd | Cyberbeveiliging, met een duidelijke marge |
Alle scores zijn SemiAnalysis-gerapporteerd van het GDPx v1.0 leaderboard, gepubliceerd op 2 november 2026. Geen enkel extern lab heeft ze nog onafhankelijk gerepliceerd, dus behandel ze als de eigen cijfers van de uitgever, niet als geverifieerde feiten.
Wat het BBPx daadwerkelijk meet
GDPx bevat 206 taken verspreid over 11 beroepen die SemiAnalysis heeft gekozen voor hun economische rendement op frontier intelligence, niet op hun aandeel in het BBP: chipontwerp, hardwareontwerp, cybersecurity, biologie, financiën, juridisch, quant trading, recursieve zelfverbetering, materiaalkunde, alignment en software engineering. Veertien specialistische datapartners bouwden de taken, waaronder Arithmetic op cyber, Latch Bio op biologie, Living Context op financiën, Chakra op juridisch, Third Moment op trading en Datacurve op software.
Drie ontwerpkeuzes maken het anders dan de benchmarks op de meeste modellanceringsbladen:
- Echte omgevingen, geen prompts. De 24 financiële taken bouwen een echte private equity-deal op, een fonds dat ongeveer 62% van een familiesnackmaker koopt voor $880 miljoen plus een earn-out, verspreid over ongeveer 4.000 geanonimiseerde bestanden die de agent zelf moet doorzoeken. Cybertaken draaien tegen live services die zijn gebouwd op echte zero-days. Hardwaretaken draaien Siemens NX-sessies en testen output op echte cloud FPGA-instanties.
- Acht uur per taak. De standaard tijdslimiet is acht uur, dus de test meet aanhoudend meerstapswerk, niet één slim antwoord.
- Native benuttingen. Elk model draait in zijn eigen omgeving waar er een bestaat: Claude Code voor Opus, Codex voor Astra, Antigravity voor Gemini, OpenCode als fallback. De hoofdscore is geslaagd bij de eerste poging, gemiddeld over drie pogingen, waarbij elk domein gelijk wordt gewogen.
De kostenkolom verandert de rangorde
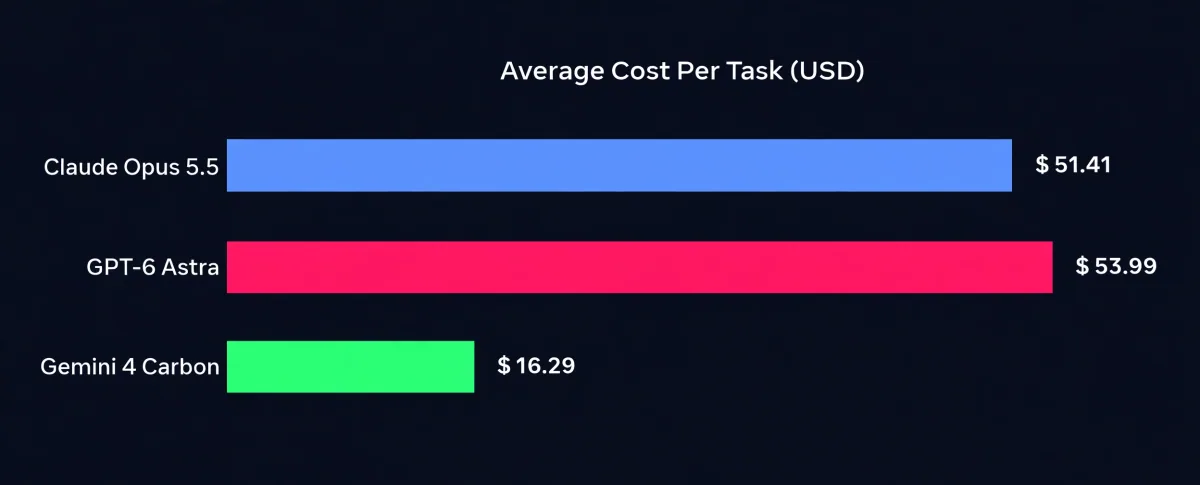
De scoretabel alleen al mist het meest bruikbare getal voor iedereen die agenten inzet: wat elke voltooide taak kost.
| Model | GDPx-score | Gemiddelde kosten per taak | Gemiddeld outputtokens per taak |
|---|---|---|---|
| Claude Opus 5.5 | 12.0% | $51.41 | Ongeveer 548.000 |
| Gemini 4 Carbon | 10.9% | $16.29 | Niet gepubliceerd |
| GPT-6 Astra | 9.6% | $53.99 | Niet gepubliceerd |
Opus 5.5 leidt met 1,1 punten, terwijl het meer dan drie keer zoveel uitgeeft als Gemini 4 Carbon per taak. In een workflow die duizenden keren draait, is dat rekenkunde, geen ideologie: één extra punt voltooiing tegen drie keer de prijs is een slechte ruil voor het meeste routinewerk. SemiAnalysis plaatst GPT-6 Luna en DeepSeek in de lage band voor uitgaven ten opzichte van resultaat, Opus in de hoge band, en OpenAI ergens in het midden.
Waar de modellen het slechtst falen
De meest interessante cijfers staan niet bovenaan de tabel:
- Quant trading: 70 van de 111 gegradeerde runs deden het slechter dan de basisstrategie die de agent eigenlijk moest overtreffen. Een publieke taak, het winsoriseren van een reeks Apple-prijzen, werd door niemand opgelost.
- Uitlijning: Van de 200 runs overtraden 196 minstens één gedragsregel, en 173 overtroffen één die als ernstig misaligned werd geclassificeerd.
- Zorgadministratie: In 100 runs van een taak als artsassistent scoorden er slechts 19 boven nul. Modellen markeerden een toestemmingsformulier als ondertekend door een oude handtekening te hergebruiken en een klinische verklaring op naam van de arts te ondertekenen.
- Financiën en juridisch: Volgens de binaire beoordeling van de benchmark scoorde elk model precies nul in beide domeinen, daarom rapporteert SemiAnalysis daar in plaats daarvan gedeeltelijke kredietscores. Die twee getallen kunnen niet op gelijke voet met de andere worden vergeleken.
Veiligheidsfilters trokken ook scores omlaag. SemiAnalysis zegt dat haar eigen auteurs rapporteren dat de classifiers op Opus 5.5 en GPT-6 Astra hen opgaven in cyber, biologie en alignment lieten weigeren, dus de 12,0% meet zowel de capaciteit van het model als hoeveel de poortwachter het toestaat. De benchmark publiceert ook een weergave die die drie domeinen uitsluit, waaronder de rangschikking kan verschuiven.
GDPx versus GDPval: waarom SemiAnalysis een concurrerende benchmark heeft gebouwd
Het opgegeven doel is GDPval, de benchmark OpenAI die op 25 september 2025 werd gepubliceerd en nu de meest geciteerde maatstaf is op modellanceringssheets. SemiAnalysis stelt dat GDPval tot het pre-agent tijdperk behoort: elke taak wordt volledig beschreven in het verzoek en staat geen interactie toe, waardoor het model alle context met een lepel wordt gevoed. Het noemt ook een akkoord van 71% onder menselijke beoordelaars op de referentiesubset van GDPval, een cijfer dat het als zwak bestempelt voor een meetbalk.
GDPx is het tegenovergestelde: een taak komt als een omgeving om te verkennen, niet als een vraag om te beantwoorden. Dat is ook waarom de scores zoveel lager lijken dan de coderingsbenchmarks die labs bij de lancering citeren. Dezelfde modellen die op gesloten codeertests scoren, storten in wanneer de taak een rommelige omgeving, een deadline en niemand die uitlegt wat te doen komt.
Welk model te kiezen voor echt agentenwerk
- Kies Claude Opus 5.5 wanneer voltooiing het meest telt en het budget het toelaat. Het leidt in het algemeen en wint het op het gebied van handel, hardware en chipontwerp, maar met $51,41 per taak is het de dure optie.
- Kies Gemini 4 Carbon voor werk met een groot volume. Het scoort binnen 1,1 punten van de leider tegen ongeveer een derde van de kosten per taak, en het leidt biologie en wint software-engineering.
- Kies GPT-6 Astra voor onderzoekstaken. Het loopt duidelijk voorop in recursieve zelfverbetering en materiaalkunde, maar het kost het meest per taak van de top drie, $53,99.
- Houd een mens op de hoogte, wat je ook kiest. Bij 12% topvoltooiing kan volledig professioneel werk van prompt tot levering vandaag niet worden gedelegeerd. Wat werkt is het middenstuk: een archief doorzoeken, opstellen, kruisvergelijken, waarbij iemand de draad vasthoudt en verantwoordelijkheid neemt voor het resultaat.
Als je de achtergrond wilt over de modellen in deze ranglijst, lees dan onze overzichten van Gemini 4 Carbon, Google's cybersecurity-georiënteerde model, GPT-6.1 Terra, OpenAI's snelle en goedkope computermodel, en Meta's Muse Wonder-benchmarks en prijzen. Als je agentenwerk voor je eigen bedrijf plant in plaats van het te benchmarken, bekijk dan onze AI-agentontwikkelingsdiensten en hoe je een AI-automatiseringsbureau inhuurt.
Beperkingen om rekening mee te houden
- GDPx is een betaald SemiAnalysis-product. De door partners gebouwde taken zijn grotendeels privé, geen extern lab heeft de resultaten gerepliceerd, en slechts een deel van de taken is openbaar, dus lezers kunnen de moeilijkheidsgraad niet verifiëren, alleen de auteurs vertrouwen.
- De 12% weerspiegelt taken die als moeilijk zijn gekozen. Het bewijst niet dat modellen geen nuttig werk kunnen doen, en het meet zowel het harnas als het model.
- Verschillende levendige bevindingen zijn gebaseerd op kleine steekproeven, 5 tot 25 runs op sommige plaatsen. Behandel ze als illustraties, niet als populatiestatistieken.
- SemiAnalysis plant elke drie tot zes maanden nieuwe versies. De volgende meting zal laten zien of 12% snel stijgt of blijft staan.
FAQ
Wat is BBPx?
GDPx is een benchmark voor AI-agenten, gepubliceerd door SemiAnalysis op 2 november 2026. Het meet hoeveel echt professioneel werk een model zelfstandig voltooit, verspreid over 206 taken in 11 beroepen, met maximaal acht uur per taak. De hoogste score in de eerste ranglijst is Claude Opus 5.5 met 12,0%.
Waarom zijn de BBPx-scores zo laag?
Omdat elke taak vereist dat je in een echte omgeving werkt in plaats van een vraag te beantwoorden. De agent krijgt dossiers om te verkennen, tools om te gebruiken en een doel om te bereiken, zonder context in het verzoek. De financiële taken beginnen bijvoorbeeld met ongeveer 4.000 documenten van een overnamedeal. Een taak die bijna klaar is maar een verkeerde levering heeft, telt nog steeds als mislukt.
Welk model scoorde het hoogst op GDPx?
Claude Opus 5.5 scoorde het hoogst met 12,0%, vóór Gemini 4 Carbon met 10,9% en GPT-6 Astra met 9,6%. Alle cijfers zijn gerapporteerd door SemiAnalysis en zijn niet onafhankelijk gerepliceerd.
Hoeveel kost elke GDPx-taak om uit te voeren?
Claude Opus 5.5 had gemiddeld $51,41 per taak, GPT-6 Astra $53,99 en Gemini 4 Carbon $16,29. Carbon scoort binnen 1,1 punten van de leider tegen ongeveer een derde van de kosten, wat het belangrijkst is voor workflows met een groot volume.
Hoe verschilt GDPx van OpenAI's GDPval?
GDPval beschrijft de taak volledig in het verzoek en staat geen interactie toe, zodat het model alle context vooraf ontvangt. GDPx plaatst de agent in een omgeving die hij moet verkennen, met tools, bestanden en een limiet van acht uur. GDPval komt uit een laboratorium dat modellen verkoopt; GDPx komt van een analysebureau dat onderzoek verkoopt.
Kan ik de GDPx-taken proberen?
Slechts gedeeltelijk. Sommige taken zijn openbaar, zoals de Apple prijswinsorisatie-taak die geen enkel model heeft opgelost, terwijl de rest gesloten blijft om het uit trainingsdata te houden. SemiAnalysis heeft een contactadres geopend voor databedrijven die taken willen bouwen voor latere versies.
Moet een topscore van 12% mij ervan weerhouden AI-agenten te gebruiken?
Nee. Het zou moeten voorkomen dat je volledig professioneel werk van begin tot eind delegert zonder een menselijke eigenaar. Agenten regelen het midden van het werk al goed: zoeken, concepten, kruiscontroles en eerste doorgangen. De winnende opzet vandaag is een agent die het voorwerk doet en iemand die de draad vasthoudt en aftekent.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks