AI-nieuws5 min leestijdDoor JH Akash
Claude Fable 5.2: #1 op 65, 20% goedkoper, 30% sneller
Anthropic lanceerde Claude Fable 5.2 op 9 november 2026. Het staat bovenaan de Artificial Analysis Intelligence Index met 65, kost 20% minder dan Fable 5.1 met $8/$40 per 1 miljoen tokens, en loopt tot 30% sneller. Hier zijn de benchmarks, de prijs en de addertje onder het gras.
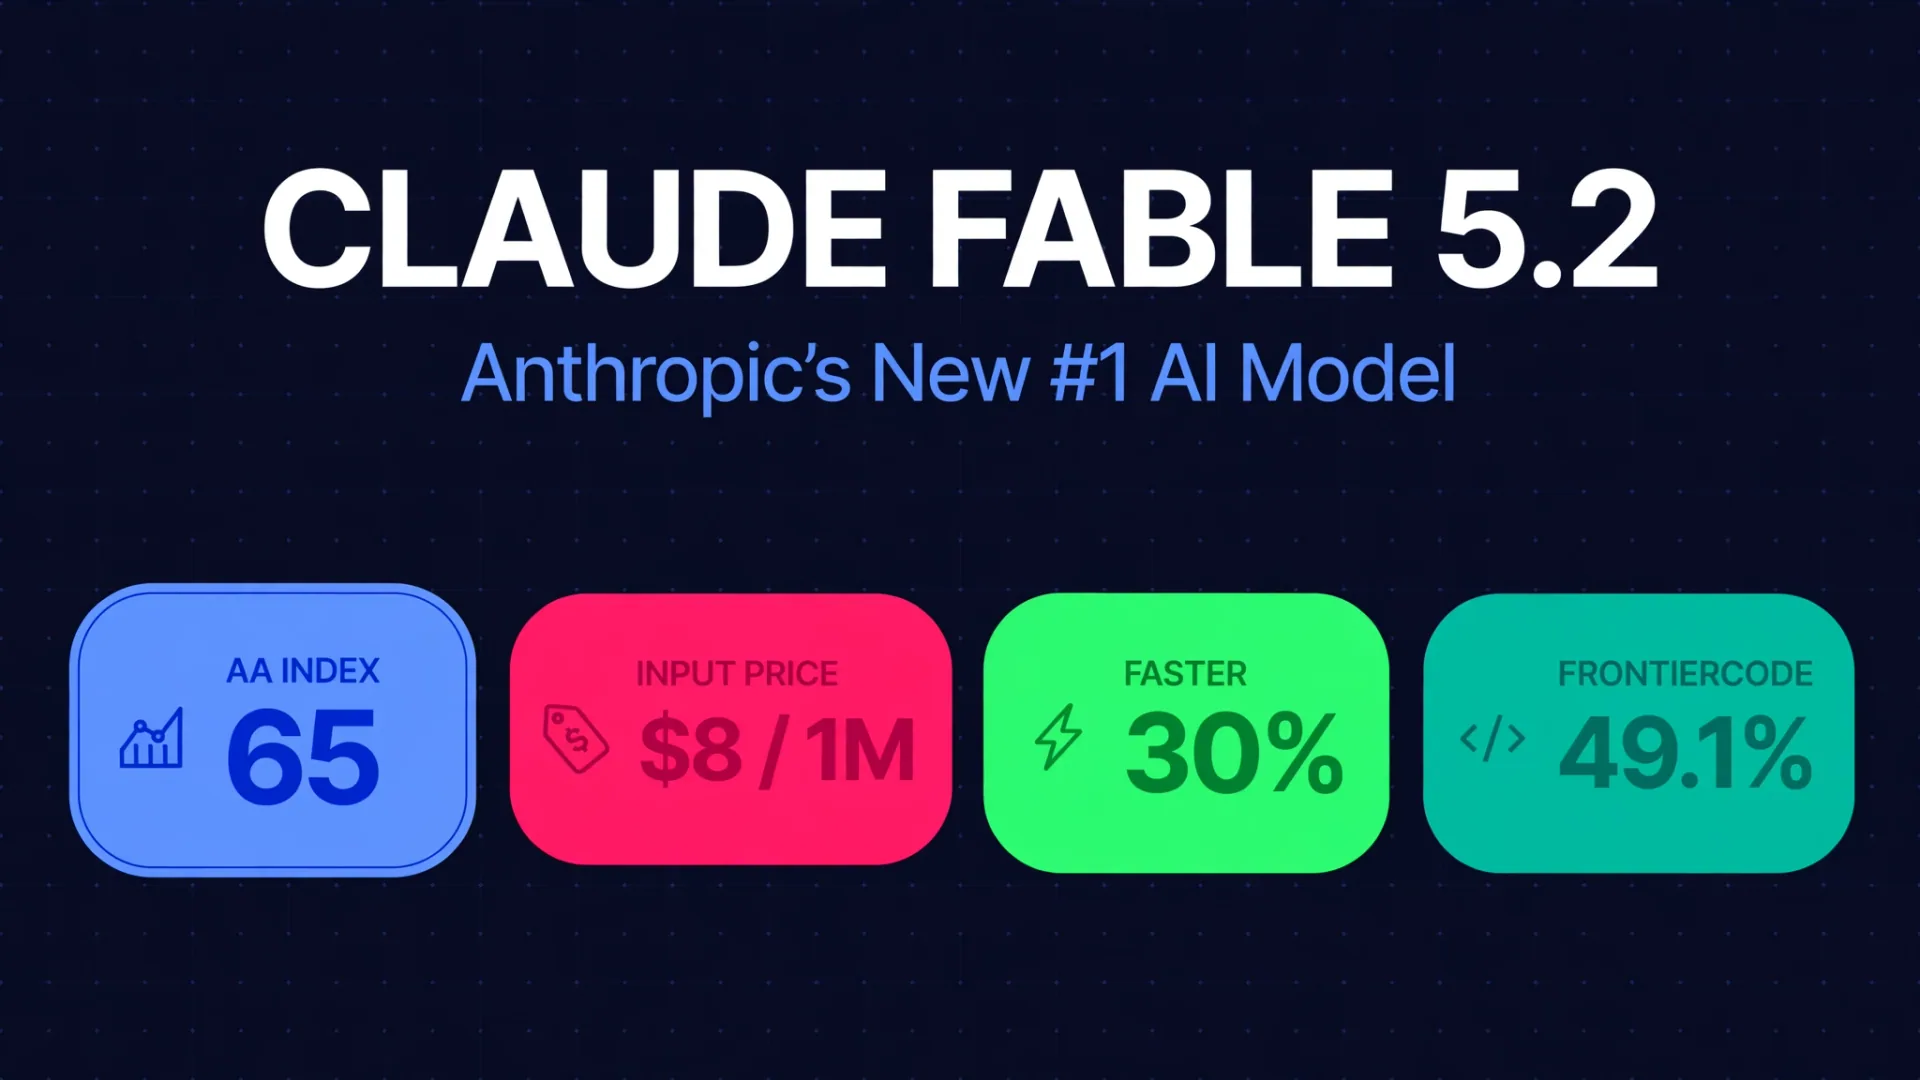
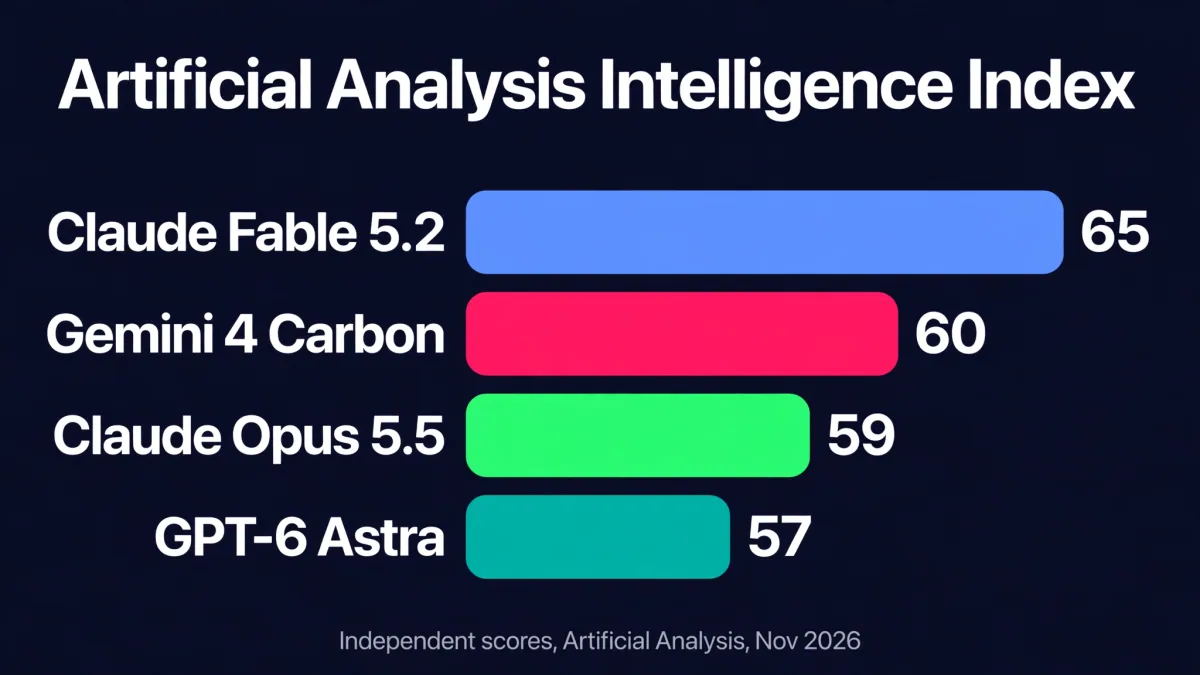
Anthropic bracht Claude Fable 5.2 uit op 9 november 2026, en het deed iets wat geen enkel Claude-model eerder heeft gedaan: het behaalde de eerste plaats in de Artificial Analysis Intelligence Index. Het nieuwe model scoort 65, voor Gemini 4 Carbon met 60, Claude Opus 5.5 met 59, en GPT-6 Astra met 57. Het kost ook 20% minder dan het vervangende model en loopt tot 30% sneller.
Die combinatie, betere scores en een lagere prijs, is zeldzaam bij AI-lanceringen. Maar de hoofdcijfers verbergen een addertje onder het gras: bij maximale inspanning is Fable 5.2 een van de langzaamste en duurste modellen per taak. Dit is wat er veranderd is, wat het kost en wie het daadwerkelijk zou moeten gebruiken.
Fable 5.2 in één oogopslag
| Claude Fable 5.2 | |
|---|---|
| Gelanceerd | 9 november 2026 |
| Artificial Analysis Intelligence Index (onafhankelijk) | 65, 1e gerangschikt |
| Invoerprijs | $8 per 1M tokens |
| Outputprijs | $40 per 1M tokens |
| Snelheid | Tot 30% sneller dan Fable 5.1 |
| Contextvenster | 1M tokens |
| Kennisafkap | Juni 2026 |
| Model-ID | claude-fabel-5-2 |
| Beschikbaar op | Claude betaalde abonnementen, Claude Code, Claude Platform, AWS, Google Cloud, Azure |
Wat is er veranderd ten opzichte van Fable 5.1
De upgrade bestaat uit drie dingen tegelijk: goedkoper, sneller en sterker. De invoerprijs daalde van $10 naar $8 per miljoen tokens en de output van $50 naar $40, een verlaging van 20% op beide. De outputgeneratie is tot 30% sneller, en testers ontdekten dat het model duidelijker communiceert dan de 5.1-versie.
Een nieuwe optionele snelle modus genereert tokens tot 2,5 keer sneller voor het dubbele prijs, $16 input en $80 output per miljoen tokens. Fable 5.1 is nu een legacy-model.
Anthropic lanceerde diezelfde dag ook een beperkte broer, Claude Mythos 5.2. Het is hetzelfde onderliggende model zonder enige cyber- en biologische waarborgen, en het geldt alleen voor gecontroleerde organisaties. Fable 5.2 is de versie die iedereen krijgt.
Prijs: wat Fable 5.2 kost
| Model | Invoer per 1M tokens | Output per 1M tokens | Cache-lezing per 1M tokens |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 |
| Claude Fable 5.2, snelle modus | $16 | $80 | - |
| Claude Fable 5.1 (nalatenschap) | $10 | $50 | $0.25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Astra | $10 | $50 | - |
Fable 5.2 onderbiedt nu GPT-6 Astra met 20% tegen de catalogusprijs. Maar het kost nog steeds twee keer zoveel als Claude Opus 5.5, daarom raadt Anthropic nog steeds Opus 5.5 aan voor dagelijks coderen en kenniswerk. Fable is voor het meest ambitieuze, open technische werk.
Op de Claude-abonnementen is er geen gratis tier voor Fable. Pro betaalt met gebruikscredits, en Max en Ultra bieden het tot de helft van de wekelijkse limiet tijdens de lanceringsweek.
Benchmarks: waar Fable 5.2 naartoe leidt
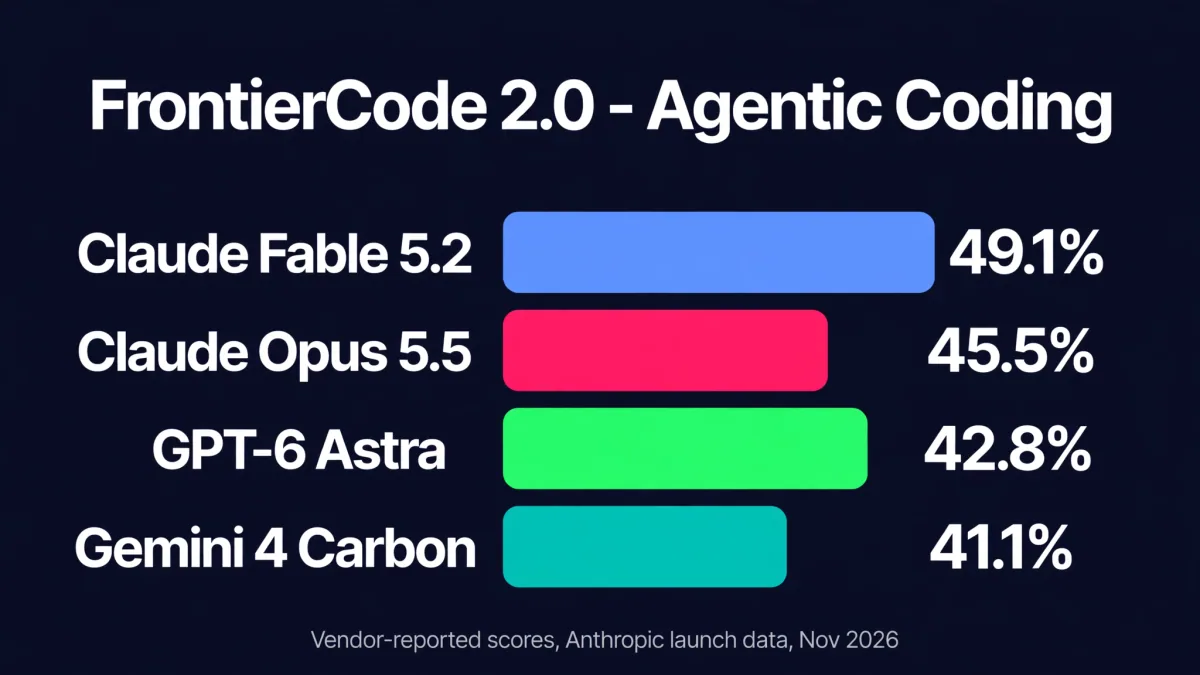
De onderstaande scores komen uit Anthropic's eigen lanceertafel, dus behandel ze als leveranciersgerapporteerd. Fable 5.2 leidt elke genoemde concurrent op agentic coding en leidt Fable 5.1 op elke benchmark die Anthropic publiceerde.
| Benchmark (door leveranciers gerapporteerd) | Fabel 5.2 | Fabel 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (agentische codering) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentische codering) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (bedrijfsworkflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| WANDR (agentisch zoeken) | 82.1% | - | 72.3% | - | - |
Fable 5.2 wint niet alles. Gemini 4 Carbon leidt op AutomationBench, 53,9% tegenover 51,4%, en Opus 5.5 behoudt de hogere AA-Briefcase Elo-rating, 1800 tegenover 1785. Op Terminal-Bench 4.0 scoorde Fable 5.2 60%, gelijk met Opus 5.5 en achter Kimi K3.1 Pro, Gemini 4 Carbon en Claude Sonnet 5.5.
Onafhankelijke resultaten ondersteunen de ranglijst
Twee externe testers publiceerden de resultaten op de lanceringsdag. Artificial Analysis, dat zijn evaluaties onafhankelijk uitvoert, plaatst Fable 5.2 op de eerste plaats op de Intelligence Index met 65 met maximale inspanning. Vals AI plaatst het als eerste van 36 modellen op de Vals Index met 71,31%.
Maar de onafhankelijke data tonen ook de kosten van de hoogste score. Bij maximale inspanning kostte het draaien van de Artificial Analysis-index gemiddeld $26,54 per taak, ongeveer 2,6 keer zoveel als Opus 5.5, en met ongeveer 45 minuten per taak beoordeelt Artificial Analysis Fable 5.2 als een van de langzaamste modellen die het test. Hetzelfde rapport vermeldt dat Fable 5.2 bij High effort ongeveer gelijk scoorde met Opus 5.5 bij maximale inspanning op FrontierCode 2.0, 45,3% tegenover 45,5%, ongeveer de helft van de kosten per taak. Het inspanningsniveau is net zo belangrijk als de modelnaam.
Het addertje onder het gras: 30 dagen databewaring
Tenzij Anthropic een uitzondering toestaat, vereist Fable 5.2 een bewaring van 30 dagen van prompts en voltooiingen. Het is niet beschikbaar bij nul dataretentie. Teams met strikte databeleid zouden dit moeten controleren voordat ze productieworkloads naar Fable verplaatsen, ook al lijken de benchmarks verleidelijk.
Welk model moet je kiezen?
Kies Claude Fable 5.2 voor het zwaarste werk: lange autonome codeertaken, meerstaps agentruns en onderzoeksproblemen waarbij nauwkeurigheid boven de kosten staat. Speel het eerst met hoge inspanning, want het komt ongeveer overeen met Opus 5.5 bij maximale inspanning voor ongeveer de helft van de kosten per taak.
Kies Claude Opus 5.5 voor dagelijks coderen en kenniswerk. Het kost de helft per token, is in de praktijk sneller en leidt nog steeds Fable 5.2 op de AA-Briefcase kenniswerk-Elo. Dit is de standaard die Anthropic zelf aanbeveelt.
Kies GPT-6 Astra als je stack al op OpenAI is gebouwd, en Gemini 4 Carbon als business workflow-automatisering je belangrijkste gebruikssituatie is, aangezien het AutomationBench aanvoert. Lees onze GPT-6 Astra-analyse en onze Gemini 4 Carbon-dekking voordat je een beslissing neemt.
Als je een team wilt dat het juiste model in je bedrijfsworkflows integreert in plaats van te gokken, bekijk dan onze AI-agentontwikkelingsdiensten.
Bronnen
De lanceringsaankondiging en prijspagina van Anthropic, Artificial Analysis Intelligence Index v5, Vals AI Vals Index v2.2 en Claude Platform-documentatie, allemaal gecontroleerd van 9 tot 10 november 2026. Door leveranciers gerapporteerde benchmarks zijn hierboven als zodanig gemarkeerd.
Hoeveel kost Claude Fable 5.2?
$8 per miljoen inputtokens en $40 per miljoen outputtokens op de API, een daling van $10 en $50 op Fable 5.1. Een optionele snelle modus verdubbelt dat tot $16 en $80 en genereert tokens tot 2,5 keer sneller. Cache-reads kosten $0,20 per miljoen tokens.
Is Claude Fable 5.2 beter dan GPT-6 Astra?
Op de gepubliceerde benchmarks geldt dat voor agentic coding ja: Fable 5.2 scoort 49,1% op FrontierCode 2.0 tegenover 42,8% op GPT-6 Astra, en 65% op 57 op de onafhankelijke Artificial Analysis Intelligence Index. Het kost ook 20% minder. Beide sets coderingsscores worden door leveranciers gerapporteerd door Anthropic.
Is Claude Fable 5.2 gratis beschikbaar?
Nee. Er is geen gratis laag voor Fable. Het is beschikbaar op Claude Pro (gebruikscredits), Max en Ultra, in Claude Code, op de Claude Platform API en via AWS, Google Cloud en Azure.
Wat is Claude Mythos 5.2?
Mythos 5.2 is hetzelfde onderliggende model als Fable 5.2, maar dan zonder enige cyber- en biologische waarborgen. Het is alleen beschikbaar voor gescreende organisaties, waaronder leden van Anthropic's Cyber and Life Sciences Verification Programs. Iedereen anders krijgt Fable 5.2.
Moet ik overstappen van Claude Opus 5.5 naar Fable 5.2?
Alleen voor je moeilijkste taken. Fable 5.2 verslaat Opus 5.5 op agentic coding benchmarks, maar kost twee keer zoveel per token en is trager bij maximale inspanning. Anthropic raadt nog steeds Opus 5.5 aan als het dagelijkse model. Gebruik Fable waar de extra capaciteit de prijs waard is, en Opus overal elders.
- Claude Fable 5.2
- Anthropic
- AI benchmarks
- GPT-6 Astra
- Gemini 4 Carbon