AI-nieuws6 min leestijdDoor JH Akash
Muse Ember: Haiku's 36 score tegen een derde van de prijs
Meta's Muse Ember komt overeen met Claude Haiku 5.5 op 36 op de Artificial Analysis Index, wat ongeveer een derde van de kosten per taak kost. Hier zijn de benchmarks, de prijs en de vangst.
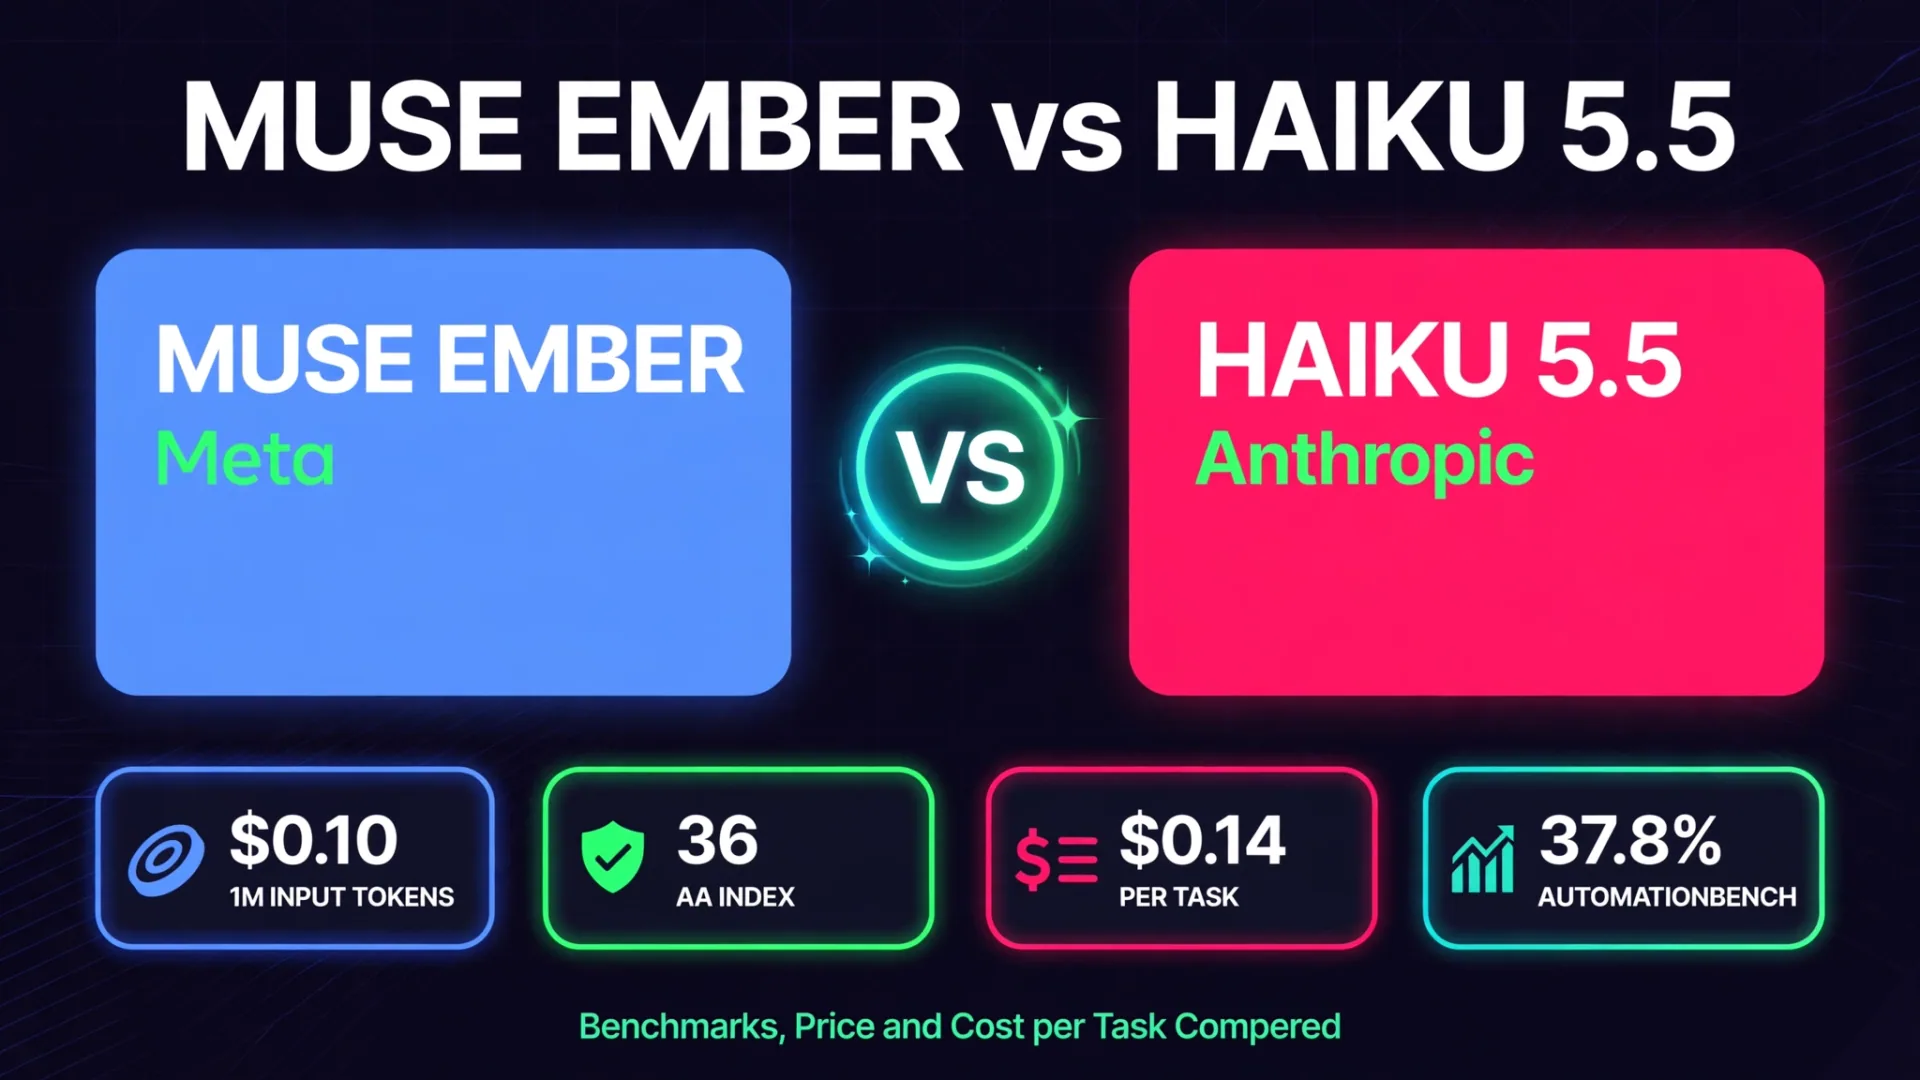
Meta lanceerde Muse Ember op 9 november 2026, en het hoofdnummer is moeilijk te negeren: het komt overeen met Claude Haiku 5.5 op 36 op de Artificial Analysis Intelligence Index, terwijl het ongeveer een derde per taak kost. Ember is Meta's kleinste en goedkoopste Muse-model, gebouwd voor het repetitieve werk dat AI-agenten de hele dag doen: tool-oproepen, codeer-subtaken, routering, extractie en lang-document parsing.
Het addertje onder het gras zit in de kleine lettertjes. De tokenprijzen zijn identiek aan die van Haiku 5.5 en GPT-6 Luna. Ember wint op kosten per taak omdat het veel minder outputtokens gebruikt om dezelfde score te bereiken. En op één benchmark, degene die het dichtst bij echte samenvoegbare code ligt, wint Haiku nog steeds duidelijk. Dit bericht vergelijkt alle drie de modellen op prijs, benchmarks en de werklasten waarvoor elk model daadwerkelijk is gebouwd.
Snel oordeel
| Model | AA Intelligentie-index | Kosten per taak | Het beste voor |
|---|---|---|---|
| Muze Ember | 36 | $0.136 | Werk met een hoog volume van agenten, zakelijke workflows |
| Claude Haiku 5.5 | 36 | $0.411 | Samenvoegbare code, kantoorwerk |
| GPT-6 Luna | 28 | $0.152 | Goedkope algemene taken, laagste kosten per taak na Ember |
Alle scores zijn op maximale redeneerinspanning, zoals gerapporteerd door Meta uit Artificial Analysis-gegevens van 9 november 2026. Benchmarks die door een leverancier worden gepubliceerd, worden door de leverancier gerapporteerd totdat ze onafhankelijk opnieuw worden getest.
Wat Muze Ember is
Ember is het vierde model in Meta's Muse-familie. Muse Spark verscheen in april 2026 als het middengewichtmodel, Glimmer volgde in augustus als opengewicht tweeling, en het frontiermodel Muse Wonder werd in oktober gelanceerd. Ember is het kleine, en Meta noemt het het meest efficiënte model in de familie.
Het is een multimodaal model: het neemt tekst, afbeeldingen, audio en video in één gesprek, zodat een agent screenshots, grafieken, gescande documenten, spraakmemo's en video kan lezen zonder een apart model. Het contextvenster is 1.048.576 tokens (1M), met tot 524.288 outputtokens (512K) per verzoek. Dat is genoeg om een hele codebase of een grote documentset in één gesprek te voeren.
Het is nu beschikbaar als muse-ember-1.0 op de Meta Model API en in Muse Code, en ook op Google Cloud en Oracle Cloud. De gewichten zijn gesloten, dus dit is een API-only model, geen open download. Meta zegt ook dat Ember het eerste model is dat is getraind met Muse Wonder Full, het grensmodel, en dat zelfs goedkopere modellen al in training zijn. Op dezelfde dag zette Meta Muse ook op Apple Watch en Wear OS.
Prijs: dezelfde prijs, maar een heel andere rekening
Hier is het deel waar de meeste koppen het mis hebben. De per-token prijzen van Ember zijn exact hetzelfde als die van Haiku 5.5 en GPT-6 Luna. De besparingen komen door efficiëntie, niet door een goedkopere tariefkaart.
| Prijs per 1 miljoen tokens | Tot 200.000 tokens | Tokens boven 200K |
|---|---|---|
| Input | $0.10 | $0.30 |
| Gecachte invoer | $0.004 | $0.012 |
| Output | $0.50 | $1.50 |
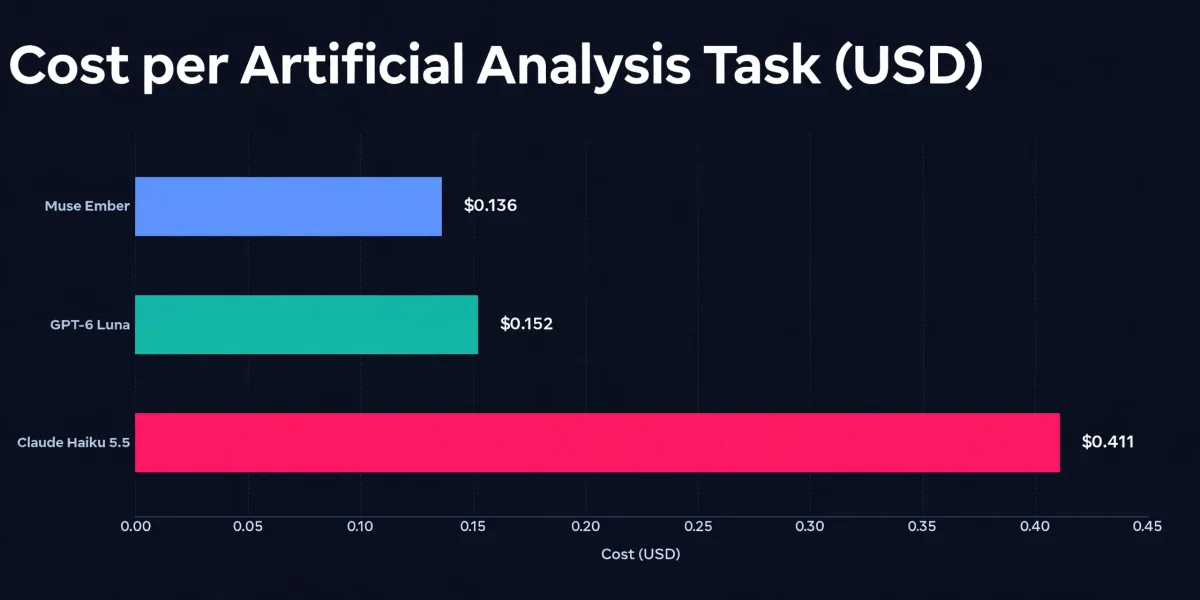
De hogere laag geldt voor het hele verzoek zodra het 200.000 tokens overschrijdt, dus lang-context calls kosten drie keer zoveel per token. Het echte bedrag om in de gaten te houden is de kosten per voltooide taak. Op Artificial Analysis-benchmarks betaalt Ember gemiddeld ongeveer $0,14 per taak, Haiku 5,5 ongeveer $0,41 en GPT-6 Luna ongeveer $0,15. Ember bereikt dezelfde score als Haiku terwijl hij ongeveer een derde van de outputtokens gebruikt, en daar krimpt de rekening.
Wat schaal betreft, scoort Meta's eigen grotere model Muse Spark 1.3 37 op dezelfde index, één punt boven Ember, maar kost $2,39 per taak, ongeveer 17 keer meer dan Ember. De ruil is duidelijk: één extra indexpunt voor 17 keer de taakkosten.
Benchmarks: waar Ember wint en waar het verliest
Meta publiceerde tien head-to-head vergelijkingen met maximale redeneerinspanning. De grootste kloof zit in zakelijke workflows, de kleinste in mergeable code.
| Benchmark | Muze Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Kunstmatige Analyse Index | 36 | 36 | 28 |
| Kosten per AA-taak | $0.136 | $0.411 | $0.152 |
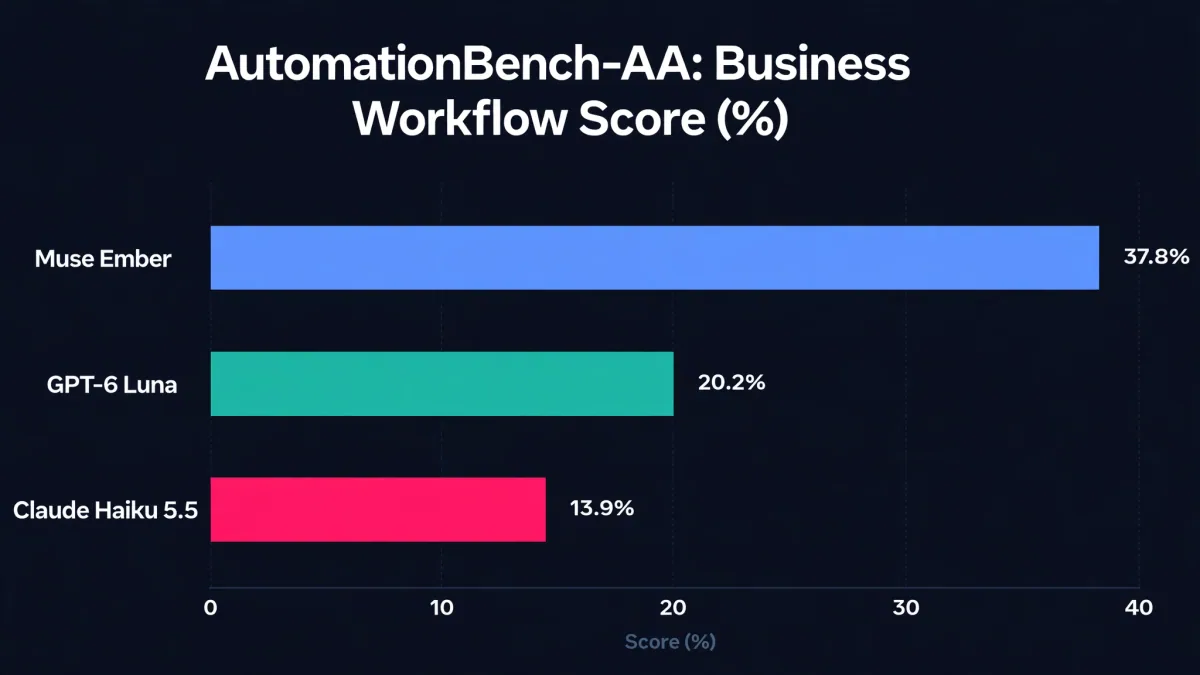
| AutomationBench-AA (bedrijfsworkflows) | 37.8% | 13.9% | 20.2% |
| Laatste Examen van Agenten | 61.6% | 57.0% | 57.1% |
| Terminal-Bench 4.0 (agentische codering) | 40.9% | 39.2% | 16.4% |
| Coderingsagent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA (samenvoegbare code) | 27.2% | 34.9% | 25.2% |
| OSWorld 2.1 (computergebruik, binair) | 33.8% | 27.8% | 17.0% |
| GDP.pdf-AA (lange documenten) | 22.8% | 20.8% | 22.8% |
| PerceptionBench (visueel, met tools) | 80.6% | 78.6% | 62.8% |
Lees de tabel zorgvuldig. Ember's opvallende resultaat is AutomationBench-AA, dat 657 echte bedrijfsworkflows uitvoert: 37,8% tegenover Haiku's 13,9%, bijna drie keer hoger. Het voert ook aan op agentische codering in Terminal-Bench en op de Coding Agent Index, die het model meet binnen zijn echte coderingskabel.
Maar FrontierCode 2.0-AA, de test die het dichtst bij code ligt die je zonder bewerkingen kunt samenvoegen, gaat de andere kant op: Haiku 5.5 scoort 34,9% tegenover Ember's 27,2%. En op de hoofdindex zelf is de gelijkstand afgerond: niet afgerond, Haiku is 36,2 en Ember 35,8. Zelfde score op de grafiek, maar een klein echt verschil eronder. Meta voerde ook vier van de tien vergelijkingen zelf uit en noemt de concurrerende runs best-effort, dus behandel de cijfers als leveranciersgerapporteerd.
Welk model te kiezen
Kies Muse Ember als je agenten op grote schaal draait: ondersteuning voor triage, documentextractie, routering, toolcalls en herhaalde codeersubtaken. Het contextvenster van 1 miljoen en de kosten van $0,14 per taak maken het de goedkoopste manier om de hele dag Haiku-niveau intelligentie te draaien. Houd de 200K token-laag in de gaten, waar de prijzen verdrievoudigen.
Kies Claude Haiku 5.5 als je agent code schrijft die schoon moet samensmelten, of als je een vastgestelde dataverwerkingsovereenkomst en ecosysteem nodig hebt. Het kost ongeveer drie keer zoveel per taak voor dezelfde indexscore, maar het wint de benchmark voor samenvoegbare code met ruime marge.
Kies GPT-6 Luna als je de laag-risico goedkope optie binnen het ecosysteem van OpenAI wilt. Het loopt achter op beide concurrenten op de index met 28, maar de kosten per taak zijn bijna net zo laag als die van Ember, en het event Ember op het gebied van lang-documenten.
Voor teams die agenten bouwen, is de praktische stap een splitsing: Ember voor de repetitieve stappen met veel volume, en een sterker model voor de uiteindelijke code of beslissing die juist moet zijn. Dat is precies de werklast waarvoor Ember is gebouwd. Als je zo'n setup plant, analyseert onze gids voor AI-agentontwikkelingsdiensten wat het kost om een agentensysteem te bouwen, en je kunt ook een AI-automatiseringsbureau inhuren om het voor je te bouwen.
Anthropic staat ook niet stil. Het nieuwe frontiermodel Claude Fable 5.2 behaalde de eerste plaats op dezelfde index met 65, en OpenAI's vlaggenschip GPT-6 Astra is het model waaraan de grotere broers en zussen van Ember worden gemeten. De race tussen kleine modellen draait nu om kosten per voltooide taak, niet om kosten per token, en Ember heeft net het bedrag neergezet: $0,14.
FAQ
Wat is Meta Muze Ember?
Muse Ember is Meta's kleinste en meest efficiënte AI-model, gelanceerd op 9 november 2026. Het is gebouwd voor het repetitieve werk dat AI-agenten de hele dag doen: tooloproepen, coderen van subtaken, routering, extractie en lang-document parsing. Het is beschikbaar als muse-ember-1.0 op de Meta Model API en Muse Code.
Hoeveel kost Muse Ember?
Muse Ember kost $0,10 per miljoen inputtokens en $0,50 per miljoen outputtokens voor prompts tot 200.000 tokens, met gecachete input van $0,004. Boven 200.000 tokens stijgen de tarieven, $0,012 gecachet en $1,50 output. Op Artificial Analysis-benchmarks is het gemiddeld ongeveer $0,14 per taak.
Is Muse Ember beter dan Claude Haiku 5.5?
Op de Artificial Analysis Intelligence Index scoren beide 36 bij maximale redenering, en Ember kost ongeveer een derde per taak. Ember wint ook groot op zakelijke workflows (37,8% tegenover 13,9% op AutomationBench-AA). Haiku 5.5 is sterker op mergeable code, met 34,9% tegenover Ember's 27,2% op FrontierCode 2.0-AA.
Is Muse Ember open source?
Nee. Meta heeft de gewichten niet vrijgegeven. Muse Ember is een API-only model, beschikbaar via de Meta Model API, Muse Code, Google Cloud en Oracle Cloud.
Wat is het contextvenster van Muse Ember?
Muse Ember heeft een contextvenster van 1.048.576 tokens (1M) en ondersteunt tot 524.288 outputtokens (512K) per verzoek. Het accepteert tekst, afbeeldingen, audio en video als input.
Bronnen: Meta AI Research, "Introducing Our Kleinste, Meest Efficiënte Model: Muse Ember", 9 november 2026; Artificial Analysis Intelligence Index v5, 9 november 2026. De benchmarkcijfers zijn zoals gepubliceerd door Meta en worden door leveranciers gerapporteerd.
- Muse Ember
- Meta Muse
- Claude Haiku 5.5
- GPT-6 Luna
- AI benchmarks