KI-News8 Min. LesezeitVon JH Akash
Qwen4-Max Vorschau: 14 Tage Live, 1Million Kontext, Kein Preis
Alibaba hat Qwen4-Max Preview am 11. November eröffnet und am 25. November eingestellt. Es hat einen Kontext für eine Million Token und eine Ausgabeobergrenze von 393.216 Tokens, aber keine Benchmarks, keine Modellkarte und keinen Preis pro Token.
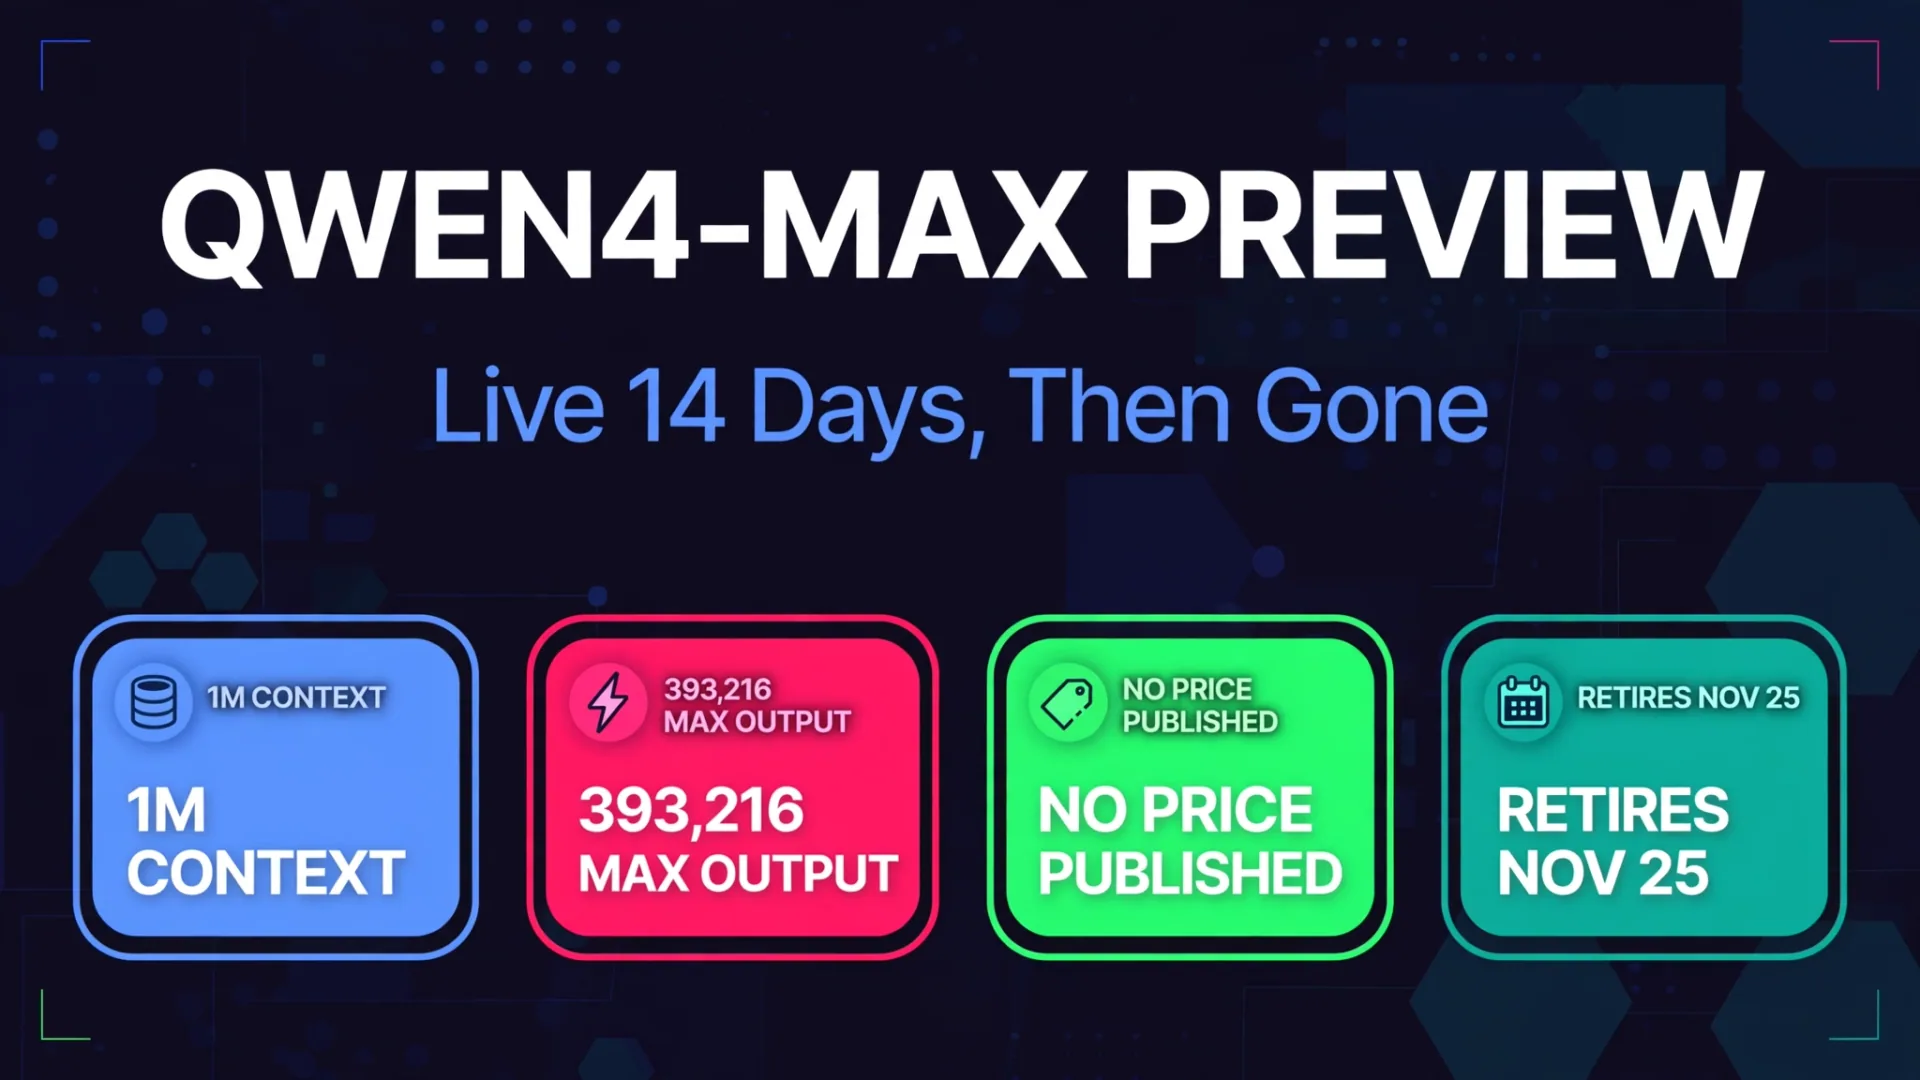
Am 11. November 2026 eröffnete Alibaba die Qwen4-Max Preview, das erste Modell seiner Qwen4-Generation. Es enthält einen Satz, den man bei einer Flaggschiff-Einführung fast nie sieht: Die Vorschau läuft bis zum 25. November, in diesem Zeitraum werden keine Änderungen vorgenommen, und das Modell wird nach Ablauf der Vorschau ausgemustert.
Vierzehn Tage. Dann weg. Und Alibaba veröffentlichte keine Benchmark-Werte, keine Modellkarte, keine Parameteranzahl, keine Gewichtungen und keinen Preis pro Token. Hier ist, was das Modell tatsächlich ist, was die frühen Tests zeigen und ob es sich für deine zwei Wochen lohnt.
Was Qwen4-Max Preview ist
Qwen4-Max Preview ist die Early-Access-Version von Qwen4, Alibaba's nächster Flaggschiff-Generation, die erstmals auf der Apsara-Konferenz im September 2026 vorgestellt wurde. Es ist das einzige Qwen4-Modell, das heute jemand anrufen kann. Der Rest der Familie, Qwen4-Plus, Qwen4-Flash und ein 27B-Modell für den lokalen Einsatz, hat kein bekanntgegebenes Datum.
| Spezifikation | Qwen4-Max Vorschau |
|---|---|
| Modell-ID | qwen4-max-preview (alias qwen4.0-max-preview) |
| Status | Vorschau, 11. bis 25. November 2026 (Peking-Zeit) |
| Kontextfenster | 1.000.000 Token |
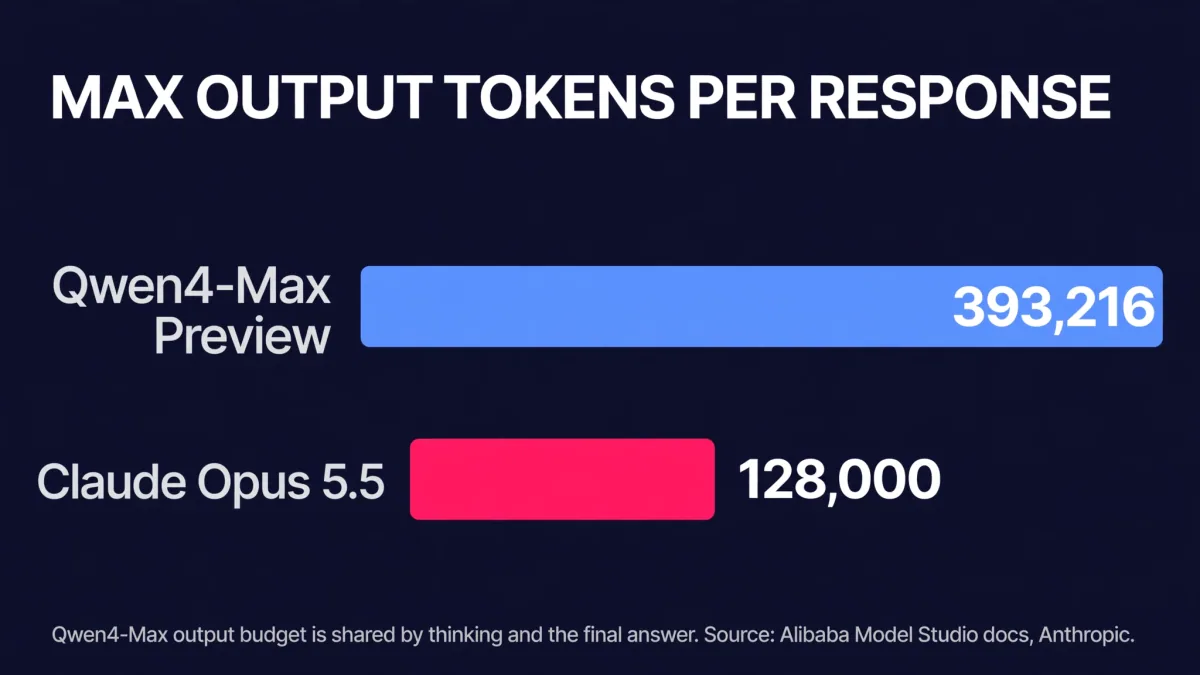
| Maximale Leistung | 393.216 Token, geteilt durch Denken und die endgültige Antwort |
| Eingabe | Text, Bilder und Video |
| Denken | Standardmäßig aktiviert, reasoning_effort niedrig, mittel oder xhoch (standardmäßig xhoch). |
| Zugang | Nur Token-Plan-Abonnement, Singapur-Endpunkt |
| Pay-as-you-go | Nicht unterstützt, öffnet ein gewöhnlicher Model Studio-Schlüssel dieses Modell nicht |
| Benchmarks | Keine veröffentlicht, vom Anbieter gemeldet oder unabhängig |
| Parameteranzahl | Nicht veröffentlicht |
| Gewichte und Lizenz | Nicht veröffentlicht |
| Preis pro Token | Nicht veröffentlicht |
Der 1M-Token-Kontext ist für die Familie nicht neu. Das vorherige Flaggschiff, Qwen3.8-Max, startete am 3. August 2026 mit einem eigenen Million-Token-Kontext. Neu ist die Output-Obergrenze: 393.216 Token in einer einzigen Antwort, wobei die Begründung und die endgültige Antwort dieses Budget teilen. Das entspricht etwa dem Dreifachen der üblichen 128.000-Token-Ausgabe-Decke von Claude Opus 5.5.
Das schnelle Urteil
Qwen4-Max Preview ist eine zweiwöchige Testfahrt, kein Modell, auf dem du aufbauen kannst. Der 1M-Kontext und die enorme Output-Decke sind real und dokumentiert, und die ersten praktischen Tests sind schnell. Aber ohne Benchmarks, ohne Preis pro Token und mit einem festen Rückzugsdatum überlebt nichts, was du auf genau diesem Modell maßst oder baust, den 25. November weiter. Probiere es aus, wenn du neugierig bist oder wenn du auf Alibaba-Stack versendest. Migriere keine Produktionsarbeiten dorthin.
| Frage | Kurze Antwort |
|---|---|
| Geht es schnell? | Frühe Tests sagen ja, viel schneller als Qwen3.8-Max bei denselben Aufgaben |
| Ist es gut? | Unbekannt, es gibt noch keinen Benchmark |
| Ist es billig? | Es gibt keinen Preis pro Token, nur ein Token Plan-Abonnement |
| Kann ich darauf aufbauen? | Nein, es geht am 25. November 2026 in den Ruhestand |
| Ist es offenes Gewicht? | Keine Gewichte veröffentlicht |
Qwen4-Max Vorschau gegen Claude Opus 5.5 gegen Qwen3.8-Max
Das ist der ehrliche Vergleich: die Zahlen, die existieren, und die Lücken, in denen sie nicht existieren.
| Qwen4-Max Vorschau | Claude Opus 5.5 | Qwen3.8-Max | |
|---|---|---|---|
| Kontextfenster | 1.000.000 Token | 1.000.000 Token | 1.000.000 Token |
| Maximaler Ausgang pro Antwort | 393.216 Marken | 128.000 Token (300.000 auf der Batches API) | Nicht veröffentlicht |
| Eingangstypen | Text, Bild, Video | Text, Bild | Text, Bild |
| Künstliche Analyse-Intelligenz-Index | Keine Partitur veröffentlicht | 59, Platz 5 von 74 | 34 |
| Preis pro 1-Million-Token | Nicht veröffentlicht, nur Token Plan | 4 $ Eingang, 20 $ Ausgabe | Hier nicht abgedeckt |
| Verfügbarkeit | 11.–25. November 2026, dann in den Ruhestand gegangen | Aktiv, Ruhestand nicht vor dem 22. September 2027 | Aktiv |
Das Kontextfenster ist ein echter Drei-Wege-Gleichstand bei 1 Millionen Tokens. Das Output-Ceiling ist der Punkt, an dem die Qwen4-Max Preview hervorsticht, und im Verfügbarkeitsfenster bricht es aus: 14 Tage gegenüber mehr als 300 Tagen garantierter Verfügbarkeit für Opus 5.5.
Preisgestaltung: Ein Abo, keine Preiskarte
Alibaba hat keinen Preis pro Token für die Qwen4-Max-Vorschau veröffentlicht. Der einzige Zugang ist der Token-Plan, ein monatliches Abonnement für Coding- und Agenten-Tools, und die Nutzung zieht monatliche Credits. Unabhängige Abdeckung der Preisseite listet Einzelpläne mit 6 $ (Lite), 10 $ (Essential), 18$ (Standard) und 43 $ (Pro) pro Monat auf, mit einem Startangebot von 3 $ pro Monat für neue Nutzer. Alibaba veröffentlicht für dieses Modell keinen Credits-pro-Token-Tarif, sodass es keine Möglichkeit gibt, Kosten pro Aufgabe zu berechnen, bis Sie Credits verbraucht und zuschauen.
| Plan | Preis pro Monat |
|---|---|
| Startangebot für neue Nutzer | $3 |
| Lite | $6 |
| Wesentlich | $10 |
| Standard | $18 |
| Pro | $43 |
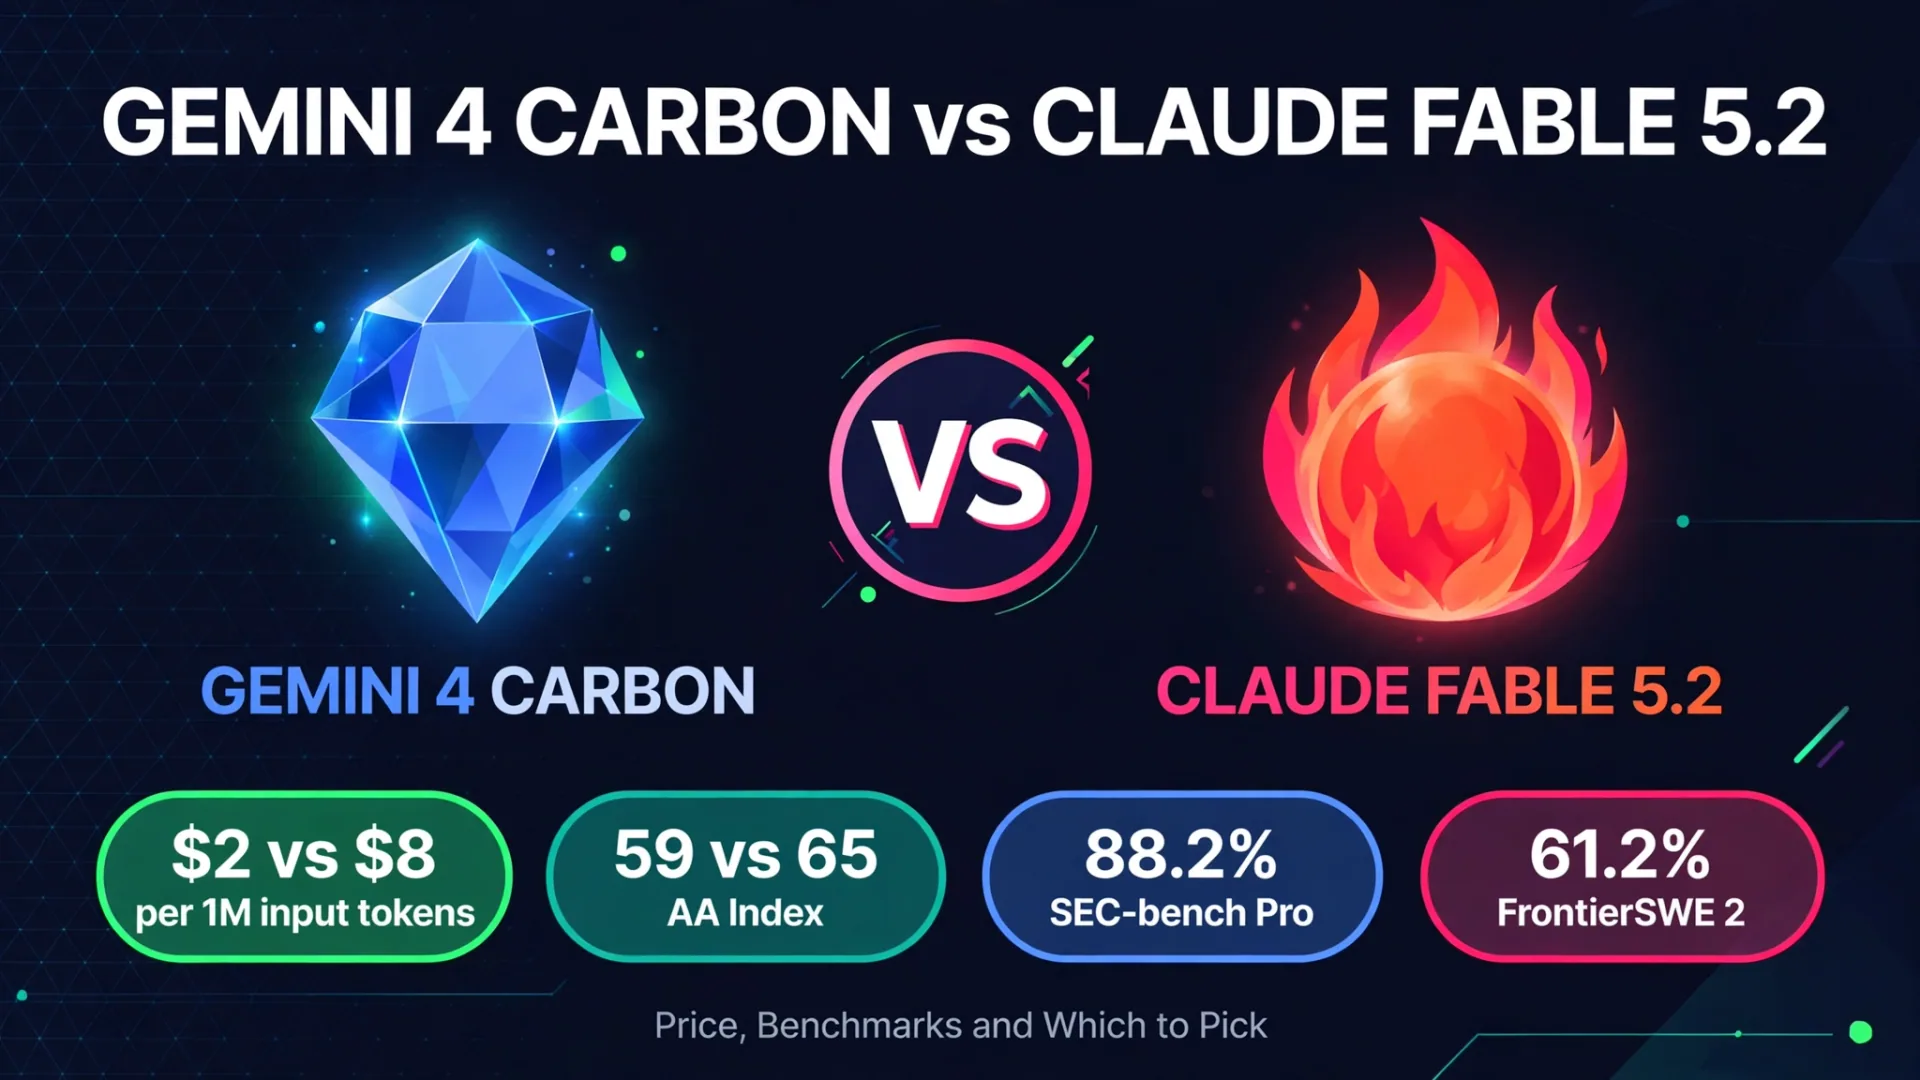
Vergleiche das mit den Zinskarten, um die du dich tatsächlich planen kannst: Claude Opus 5.5 mit 4 $ Input und 20$ Output pro 1Million Token, und Gemini 4 Carbon vs Claude Fable 5.2: $2 gegen 8$ für den aktuellen Preiskrieg am oberen Ende. Ein Abonnement ohne veröffentlichten Preis pro Token ist das Gegenteil von transparenten Preisen und der schwächste Teil dieses Launches.
Benchmarks: Es gibt keine
Alibaba's Startpost und Modelldokumentation enthalten keinerlei Benchmark-Zahlen. Bis zum 12. November hatte auch kein unabhängiges Labor eine Bewertung veröffentlicht. Artificial Analysis hat keine Seite für Qwen4-Max Preview, und LMArena hatte keine Bewertung. Ein Diagramm, das Qwen4-Max auf Platz 53 im Artificial Analysis-Index zeigt, kursiert in den sozialen Medien, aber Artificial Analysis gibt keinen Qwen4-Eintrag an, daher sollte diese Zahl als nicht verifiziert behandelt werden.
Stattdessen gibt es eine Handvoll praktischer Tests:
| Früher Test | Ergebnis |
|---|---|
| 20 Codierungstests, Qwen4-Max vs Qwen3.8-Max | Qwen4-Max bestand 20 von 20 in etwa 2,5 Minuten, Qwen3.8-Max brauchte 17 Minuten |
| T-Rex-Spiel-Build-Test | Schneller als Claude Fable 5.2 und Gemini 4 Carbon, aber der Tester bewertete Fable mit 5.2 trotzdem als den besten insgesamt |
| Geschwindigkeit vs. GPT-6.1 Terra | Ein Nutzer von Hacker News stellte fest, dass Qwen4-Max etwas langsamer war |
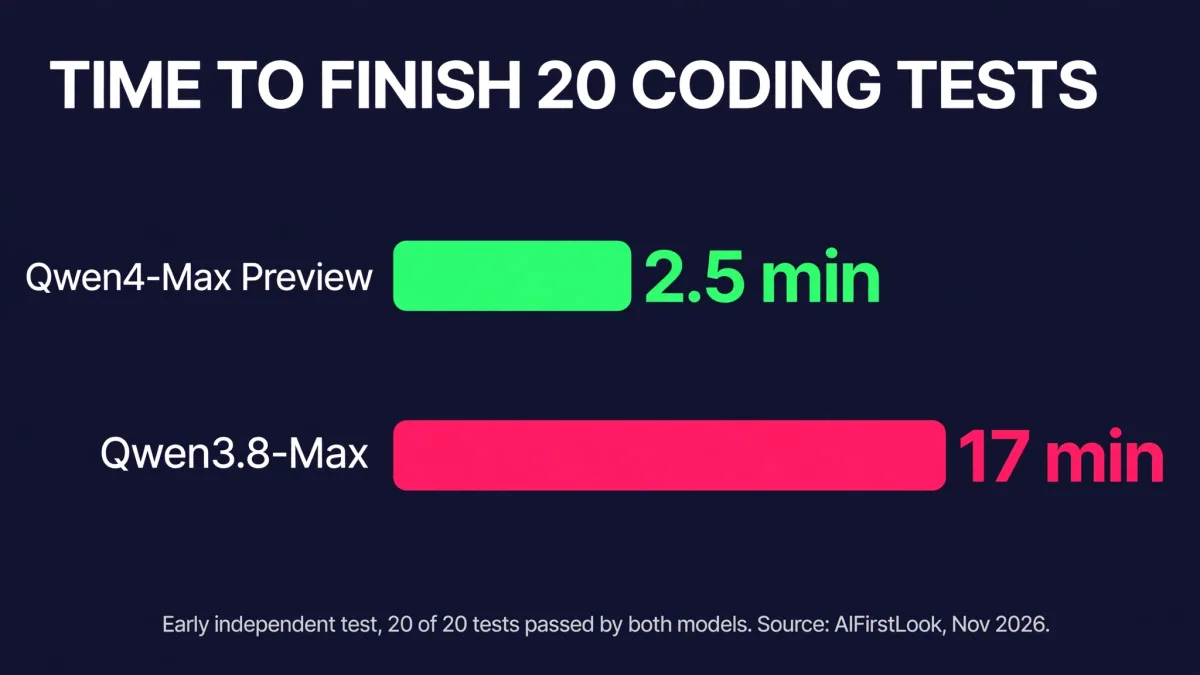
Das 2,5-Minuten- vs. 17-Minuten-Ergebnis ist das auffälligste frühe Signal, etwa 6,8-mal schneller als das vorherige Flaggschiff bei denselben 20 Tests, wobei beide Modelle alle 20 bestanden. Aber es ist ein kleiner Testsatz von einem Tester, kein Benchmark. Bis ein Labor eine echte Suite durchführt, ist jede Qualitätsbehauptung über Qwen4-Max Alibaba's Wort oder eine Anekdote.
Zum Kontext, wie echte Benchmark-Tabellen aussehen, wenn sie existieren, siehe Claude Fable 5.2: #1 bei 65, 20 % günstiger, 30 % schneller und Gemini 4 Wasserstoff: 2,5x schneller, 1,50 $ pro 1 Million.
Was fehlt und warum es wichtig ist
Die fehlende Hälfte dieses Starts ist länger als die ausgelieferte Hälfte:
- Keine Benchmarks. Es gibt nichts, was man mit Claude Fable 5.2, GPT-6 oder Gemini 4 Carbon vergleichen könnte. Jede Seite, die heute Qwen4-Max nach Qualität bewertet, ist Spekulation.
- Keine Parameteranzahl. Weder totale noch aktive Parameter werden veröffentlicht, sodass Speicher und Geschwindigkeit nicht aus der Architektur abgeleitet werden können.
- Kein Preis pro Token. Die Kosten pro Aufgabe können nicht berechnet werden, sondern werden erst nach dem Ausgeben der Credits gespürt.
- Keine Gewichte. Nichts namens Qwen4 existiert in der Qwen-Organisation auf Hugging Face, also gibt es nichts zu hosten oder zu feinjustieren.
- Keine Modellkarte. Keine veröffentlichte Sicherheits-, Schulungs- oder Bewertungsdokumentation.
- Kein vollständiges Veröffentlichungsdatum. Der Rest der Qwen4-Familie hat kein angekündigtes Datum, und die Token Plan-Seite nennt keinen Ersatz für die Vorschau, wenn sie in den Ruhestand geht.
Alibaba friert das Modell für das Fenster ein und stellt es danach zurück, sodass jeder Benchmark, Kostenschätzung oder Sicherheitstest dieses Modells nur bis zum 25. November nützlich bleibt. Das ist die wahre Geschichte dieses Markteinstiegs: ein Flaggschiff, das man zwei Wochen lang testen und dann verlieren kann.
Welche soll ich wählen
Probieren Sie Qwen4-Max Preview aus, wenn Sie bereits den Token Plan von Alibaba nutzen, den 1M-Kontext und die 393.216-Token-Output-Obergrenze für lange agentische Aufträge testen möchten oder Qwen4 vor der vollständigen Veröffentlichung bewerten. Behandeln Sie es als Demo mit Deadline.
Überspringen Sie es und verwenden Sie Claude Opus 5.5, wenn: Sie ein dokumentiertes Modell mit veröffentlichtem Preis, echten Benchmark-Scores und einer Altersvorsorge benötigen. Opus 5.5 erreicht 59 im Artificial Analysis Intelligence Index, kostet 4 US-Dollar Eingabe und 20 US-Dollar Ausgabe pro 1-Million-Token und ist garantiert bis mindestens zum 22. September 2027 verfügbar.
Überspringen Sie es und verwenden Sie Qwen3.8-Max, wenn: Sie die Qwen-Familie heute auf einer normalen API verwenden möchten. Es ist das vorherige Flaggschiff, hat offene Gewichte und verschwindet nicht in zwei Wochen.
Warten Sie auf die vollständige Qwen4-Veröffentlichung, wenn Sie Benchmarks, Gewichtungen oder einen Preis pro Token möchten, bevor Sie sich festlegen. Die Vorschau beantwortet keine dieser Fragen.
Wenn Ihr Team entscheidet, auf welchem Modell ein KI-Produkt gebaut wird, ist diese Entscheidung viel wichtiger als jeder einzelne Launch. Unser Leitfaden , wie man einen KI-Agenten baut , behandelt, wie man ein Modell auswählt, Bewertungen vorbereitet und einen Agenten ausliefert, der nach dem Start weiterarbeitet.
FAQ
Wann geht die Qwen4-Max Preview in den Ruhestand?
Am 25. November 2026 um 24:00 Uhr Pekinger Zeit, also um 11:00 Uhr ET am 25. November. In der Dokumentation von Alibaba steht, dass während der Vorschauperiode keine Änderungen vorgenommen werden und das Modell nach Abschluss ausgemustert wird.
Wie viel kostet Qwen4-Max Preview?
Es gibt keinen Preis pro Token. Der Zugang erfolgt über das Token-Plan-Abonnement von Alibaba, wobei individuelle Tarife zu 6, 10, 18 und 43 Dollar pro Monat und ein Startangebot von 3 Dollar pro Monat für neue Nutzer angeboten werden. Die Nutzung reduziert monatliche Credits, und Alibaba veröffentlicht für dieses Modell keinen Credit-pro-Token-Tarif.
Hat Qwen4-Max Preview Benchmarks?
Nein. Alibaba veröffentlichte keine Benchmark-Tabelle mit der Vorschau, und kein unabhängiges Labor hatte bis zum 12. November 2026 eine Punktzahl veröffentlicht. Eine zirkulierende Tabelle, die 53 im Artificial Analysis-Index angibt, ist nicht verifiziert, da Artificial Analysis keinen Qwen4-Eintrag aufführt.
Was ist das Kontextfenster der Qwen4-Max-Vorschau?
1.000.000 Token, dasselbe wie Claude Opus 5.5 und das vorherige Flaggschiff Qwen3.8-Max. Die maximale Ausgabe pro Antwort beträgt 393.216 Token, geteilt durch das Denken des Modells und seine endgültige Antwort.
Ist Qwen4-Max Preview Open Weight?
Nein. Es wurden keine Gewichte, Lizenzen oder Parameterzahlen veröffentlicht, und in der Qwen-Organisation auf Hugging Face existiert nichts mit dem Namen Qwen4. Der Rest der Qwen4-Familie, einschließlich eines 27B-Modells für den lokalen Einsatz, hat kein bekanntgegebenes Datum.
Wie greife ich auf die Qwen4-Max-Vorschau zu?
Nur über Alibaba's Token Plan, auf dem Singapur-Endpunkt token-plan.ap-southeast-1.maas.aliyuncs.com. Pay-as-you-go wird nicht unterstützt, und ein gewöhnlicher Model Studio-Schlüssel öffnet dieses Modell nicht. Es ist auch in der Qwen-App verfügbar.
Das Fazit
Qwen4-Max Preview ist Alibaba's ungewöhnlichster Flaggschiff-Markt: ein großes Modell mit großem Kontextfenster und einer riesigen Ausgangsgrenze, ohne Benchmarks, ohne Preis und mit einem 14-tägigen Ablaufdatum ausgeliefert. Das frühe Geschwindigkeitssignal ist real und beeindruckend, aber die Geschwindigkeit eines kleinen Testsets ist keine Qualität, und ein Modell, das am 25. November in den Ruhestand geht, kann nicht die Grundlage von irgendetwas sein, das Sie ausliefern. Testen Sie es diese Woche, wenn Sie neugierig sind. Bauen Sie darauf niemals auf.
- Qwen4-Max Preview
- Alibaba Qwen
- Qwen4
- AI benchmarks
- AI pricing