KI-News5 Min. LesezeitVon JH Akash
Edge0-145B: 145B KI läuft auf einer RTX 5090
Edge0-145B packt 145B Parameter auf einer einzigen RTX 5090 und erzielt 86,5 auf Terminal-Bench 2.1. Hier sind die Benchmarks, Geschwindigkeit, Preis und die Catches.
Edge0-145B: 145B KI läuft auf einer RTX 5090
Am 12. November 2026 veröffentlichte Edge00 Edge0-145B, ein KI-Modell mit 145 Milliarden Parametern, das auf einer einzigen Verbrauchergrafikkarte läuft. Die Gewichte landeten am 11. November auf Hugging Face, der offizielle Blogbeitrag folgte am 12. November, und bis zum 14. November hatte das Modell bereits 61.000 Downloads mit 11.379 Sternen auf GitHub überschritten.
Die Schlagzeile ist einfach: Frontier-Class-KI, auf Ihrem eigenen Computer, ohne Cloud-Rechnung. Hier ist, was das Modell tatsächlich ist, was die Zahlen sagen und wo sich das Kleingedruckte versteckt.
Was Edge0-145B ist
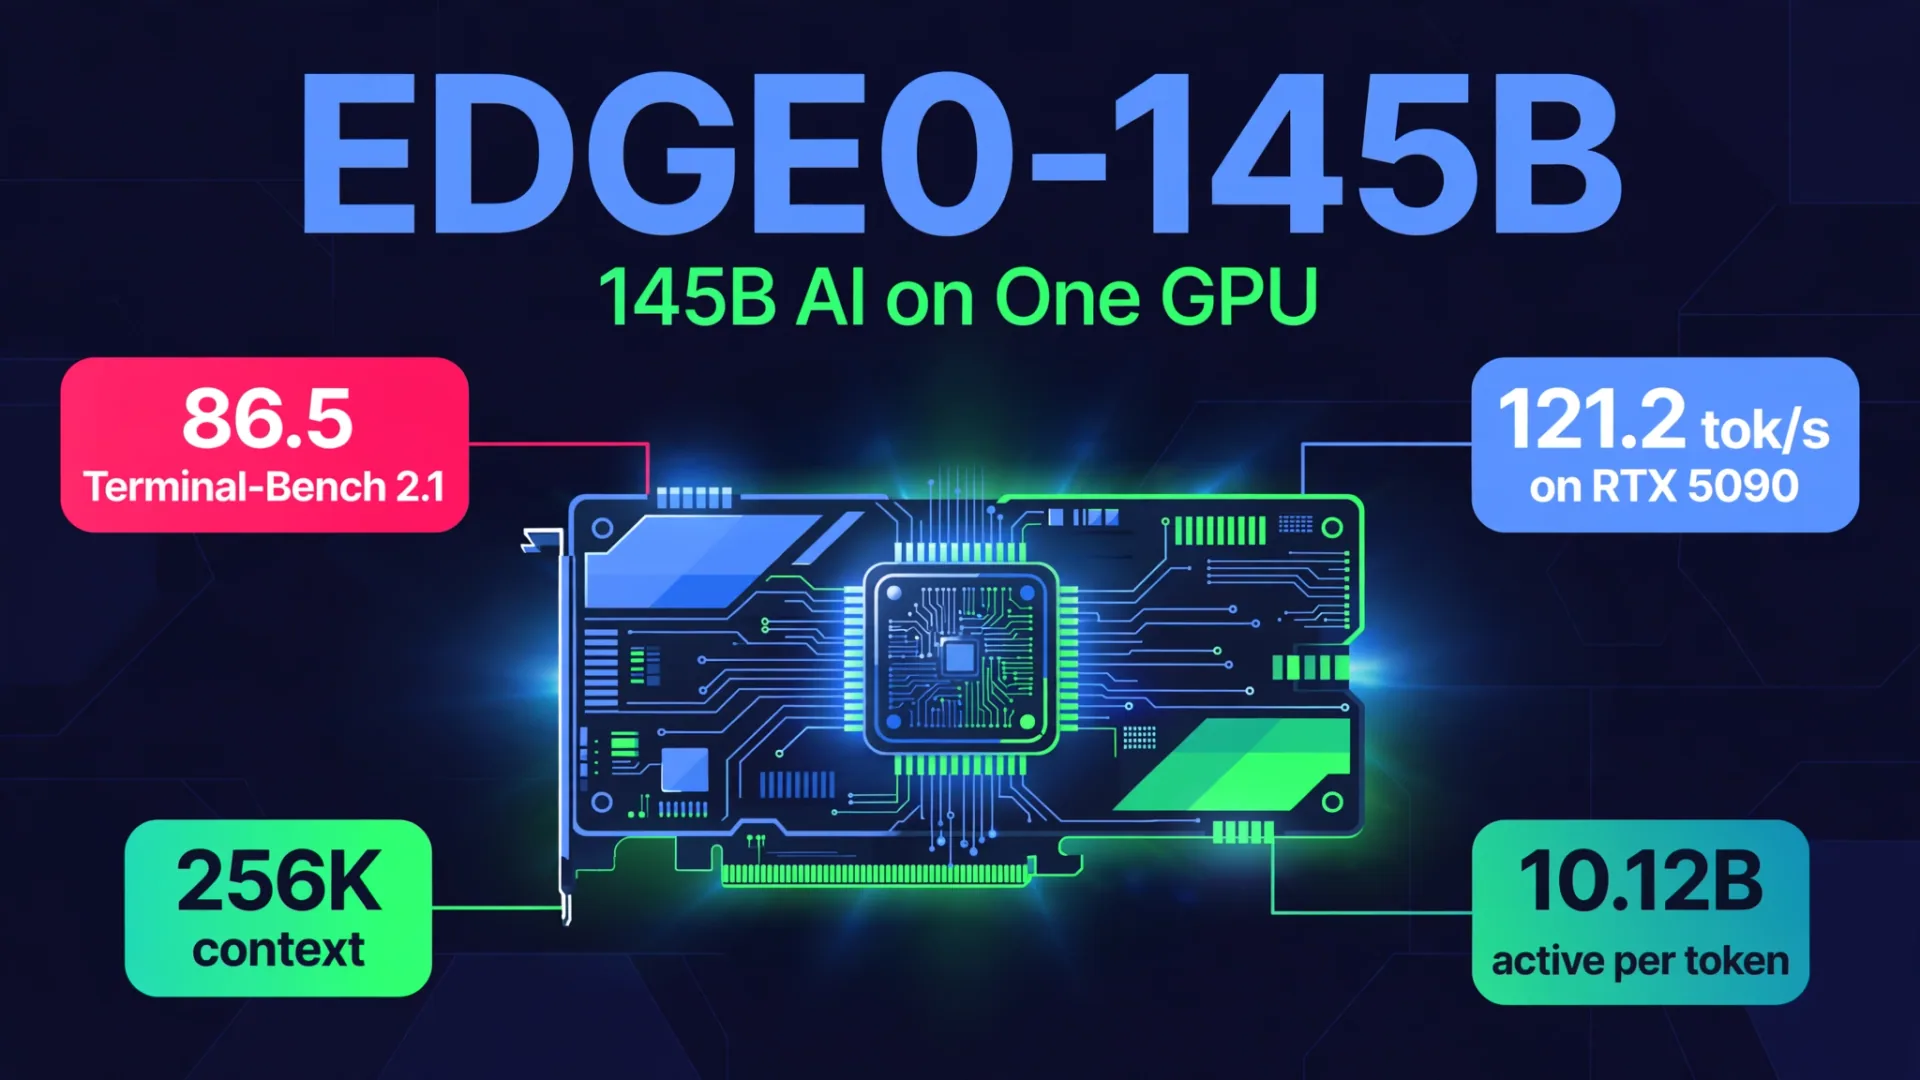
Edge0-145B ist ein latentes, sparse-Mix-of-Experten-Modell. Es hat insgesamt 145 Milliarden Parameter, aber pro Token sind nur 10,12 Milliarden aktiv, weshalb es überhaupt auf eine GPU passt. Die Architektur verwendet 48 Schichten und 512 Experten pro Schicht, wobei 10 geroutete Experten plus 1 gemeinsamer Experte pro Token aktiv ist. Sie wurde nativ mit 4-Bit-Präzision trainiert und wird mit einem Kontextfenster von 256K ausgeliefert.
| Spezifikation | Edge0-145B |
|---|---|
| Gesamtparameter | 145B |
| Aktiv pro Token | 10.12B |
| Architektur | Latente, spärliche MoE, 48 Schichten, 512 Experten |
| Kontextfenster | 256.000 Token |
| Trainingspräzision | Natives 4-Bit |
| Gewichte | Q3_K 40,81 GiB, NVFP4 47,79 GiB |
| Basismodell | Qwen3.8-Flash-Next (laut Hugging Face-Metadaten) |
| Lizenz | Edge0 Community Model Lizenz 1.0 |
| Veröffentlichung | 12. November 2026 |
Ein kleineres Geschwister, Edge0-120B, startete am selben Tag mit insgesamt 120 Milliarden Parametern und 8,64 Milliarden aktiven Tokens.
Die Geschwindigkeitszahlen
Edge0 meldet diese Dekodierungsgeschwindigkeiten aus seinen eigenen Tests, behandelt sie daher als vom Hersteller berichtet, bis unabhängige Läufe existieren.
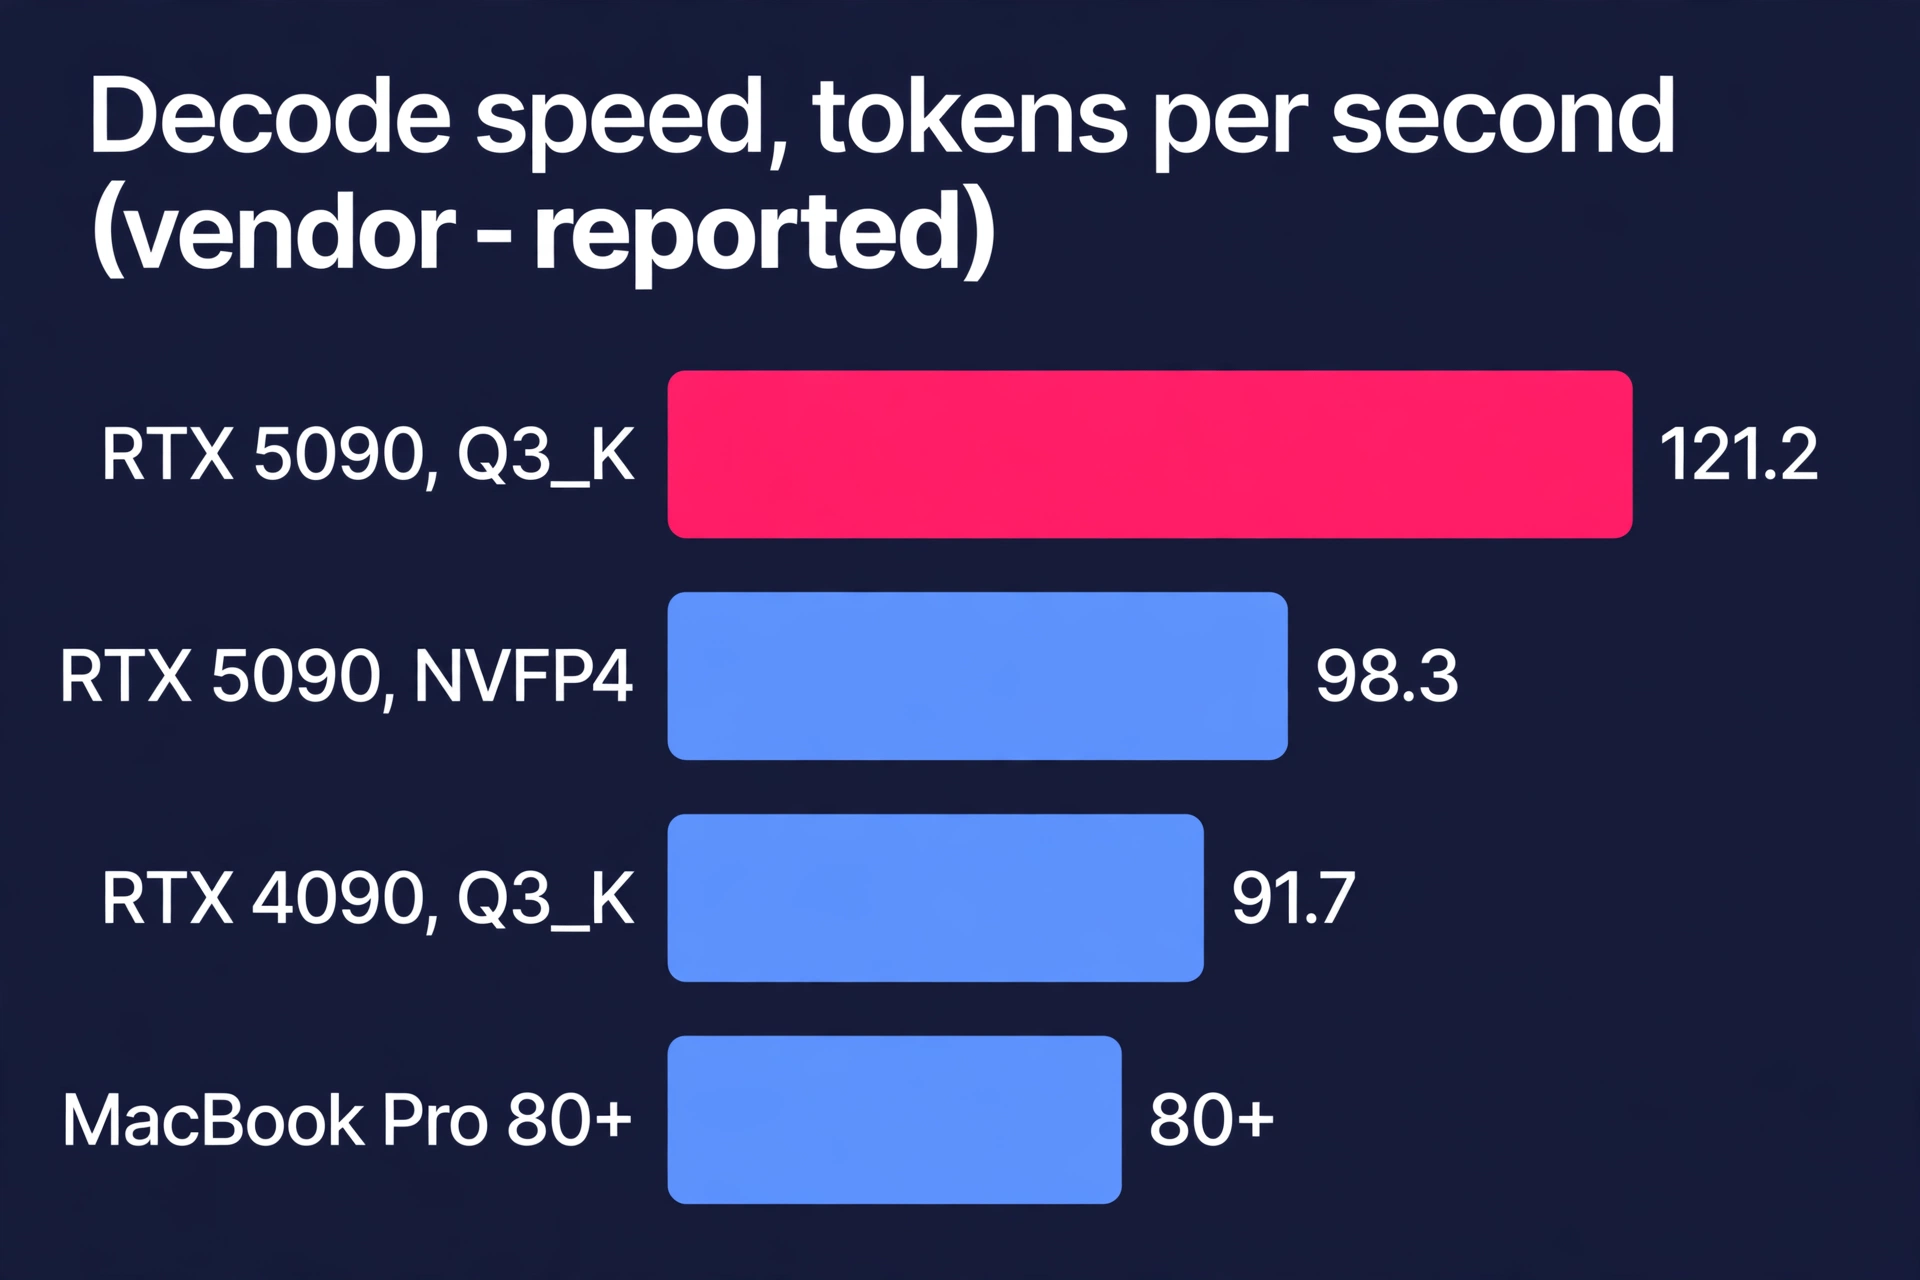
Auf einer RTX 5090 D mit 24 GB Speicherdekodiert der Q3 K-Build mit 121,2 Token pro Sekunde und 3.554,9 Token pro Sekunde bei 16K-Token-Prefill. Der NVFP4-Build läuft mit 98,3 Tokens pro Sekunde Dekodierung und 3.165,7 Tokens pro Sekunde Prefill. Der gleiche Q3K-Build erreicht 91,7 Token pro Sekunde auf einem RTX 4090. Auf einem MacBook Pro meldet Edge0 mehr als 1.100 Prefill pro Sekunde und mehr als 80 Tokens pro Sekunde Dekodierung, bei etwa 120W typischer Leistung, mit 128K bis 256K Kontext bei nahezu gleicher Geschwindigkeit.
Die Unterstützung am ersten Tag umfasst macOS, Windows und Linux auf Apple M-Series Laptops sowie RTX Spark, RTX 4090 und RTX 5090 GPUs.
Die Benchmark-Zahlen
Jede Punktzahl unten stammt aus den internen Bewertungen von Edge0. Das Unternehmen sagt, dass ein technischer Bericht mit vollständigen Aufbau- und Reproduktionsanweisungen noch in Austragung kommt, also lesen Sie diese als Ansprüche und nicht als abgeklärten Messungen.
| Benchmark | Edge0-145B | Nächster Vergleich |
|---|---|---|
| DeepSWE 1.1 | 64.6 | Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4 |
| Terminal-Bench 2.1 | 86.52 | Qwen3.8-Flash-Next 83.3, DeepSeek-V4-Flash 82.7, Claude Opus 4.6 Max 78.2 |
| GPQA-Diamond | 90.4 | DeepSeek-V4-Flash 90.8, Claude Opus 4.6 Max 91.3 |
| IFBench | 80.6 | - |
| HLE | 35.4 | - |
| AA-LCR | 79.3 | - |
| Sechs-Benchmark-Mittelwert | 72.8 | Qwen3.8-Flash-Next 71.7 |
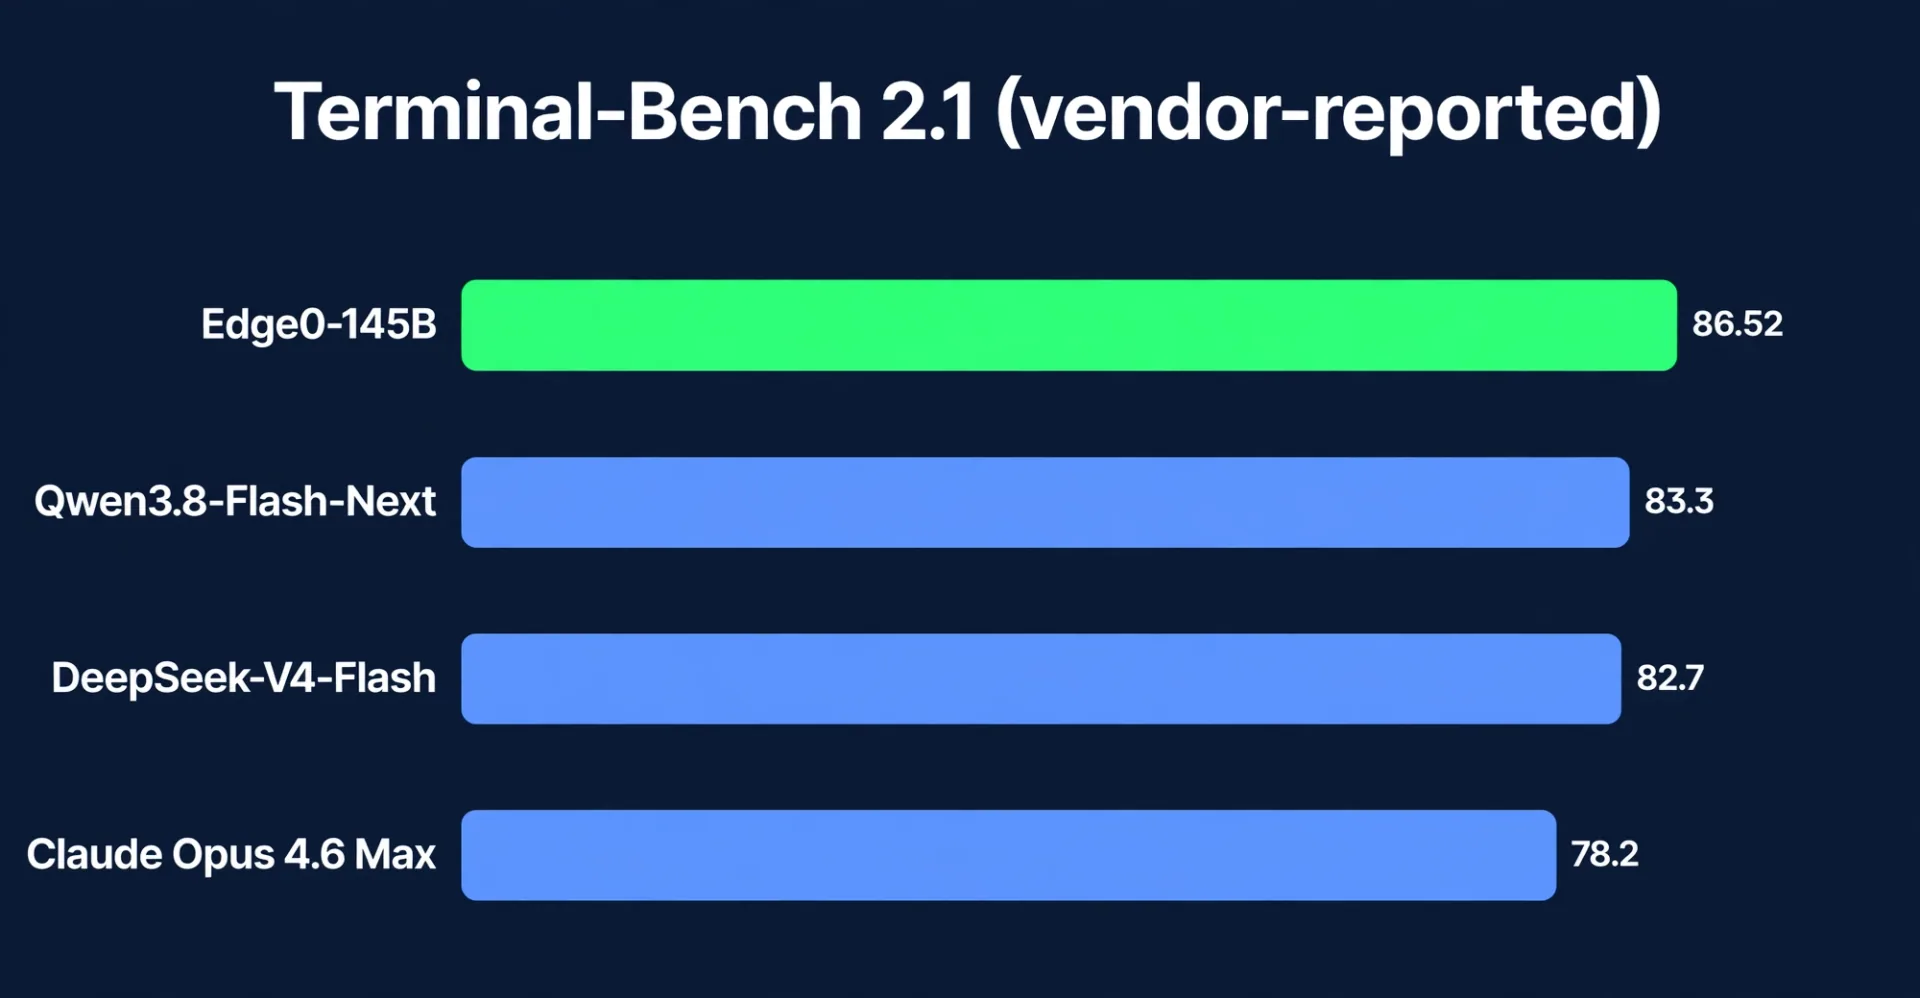
Das Ergebnis von Terminal-Bench 2.1 ist der Blickfang: 86,52 gegenüber 78,2 für Claude Opus 4.6 in seiner Max-Konfiguration. Aber beachten Sie die GPQA-Diamond-Spalte, in der Edge0 sowohl DeepSeek-V4-Flash als auch Claude Opus 4.6 hinter ihnen liegt. Kein einzelner Benchmark entscheidet ein Modell, und Cross-Benchmark-"Gewinner" existieren nicht. Testen Sie es an Ihren eigenen Aufgaben.
Was es kostet
| Option | Preis |
|---|---|
| Edge0-145B Gewichte | Frei zum Download |
| Edge0-Inferenzrahmen | Apache 2.0, kostenlos |
| Ihre Kosten | Eine GPU, Strom und deine Zeit |
| Gemini 4 Wasserstoff-API | 1,50 $ pro 1 Million Eingabetoken |
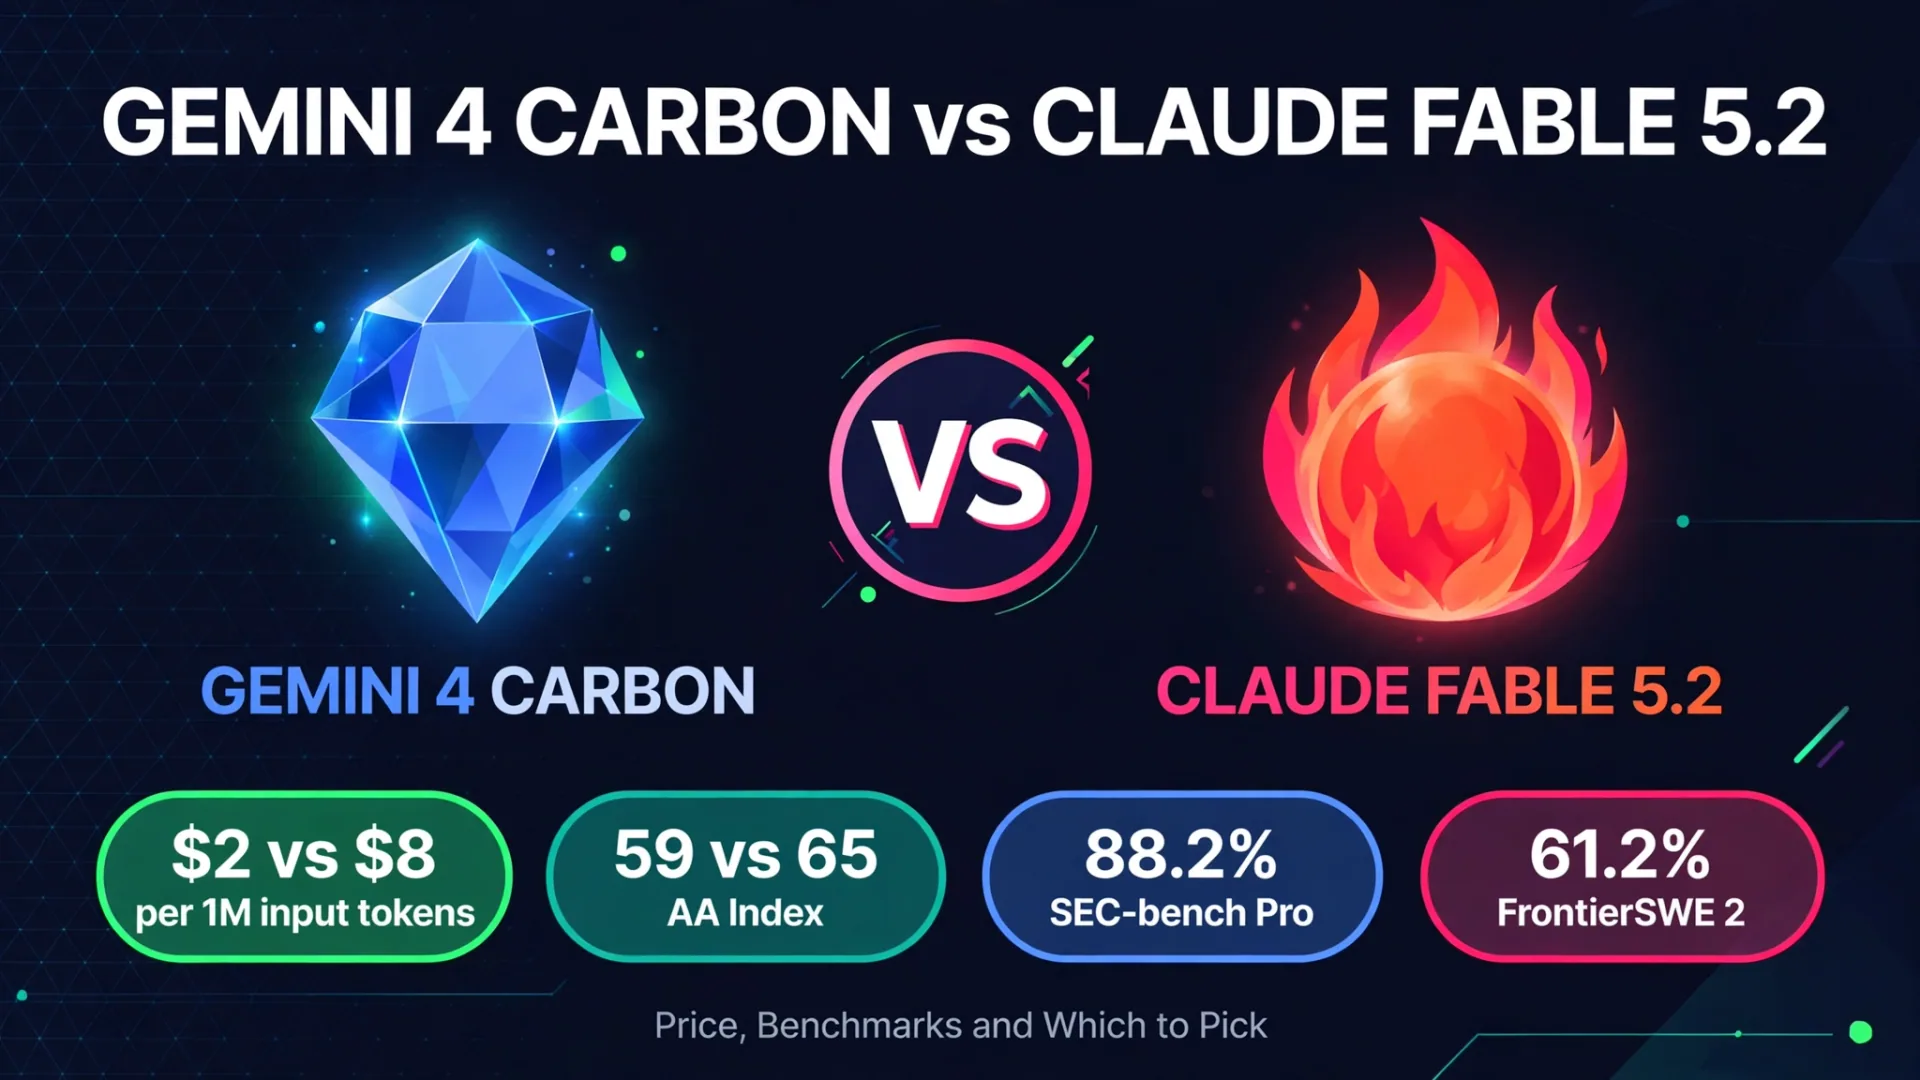
| Claude Fable 5.2 API | 8 $ pro 1 Million Eingabe, 40 $ pro 1 Million Ausgabetoken |
Bei Edge0-145B gibt es keine Rechnung pro Token. Der Trade ist anders: Sie zahlen in Hardware und Einrichtungszeit statt API-Gebühren, und Ihre Daten bleiben auf Ihrem eigenen Rechner. Für Teams, die Automatisierung auf ihrer eigenen Hardware bauen, ist dieser Handel der ganze Sinn. Wenn Sie sehen wollen, wie die Cloud-Preise im Vergleich stehen, umfasst unsere Gemini 4 Hydrogen-Analyse Googles 1,50 $ pro 1-Million Token-Modell, und die Anthropic IPO-Geschichte zeigt, wie sehr Investoren das Unternehmen hinter Claude heute wertschätzen.
Die Fänge
Drei Dinge, die du vor dem Download wissen solltest.
Die Überschrift mit 29 GB benötigt den Kontext. Edge0 sagt, das Modell läuft mit 29 GB Peak-Speicher auf einem Laptop, aber die Hugging Face-Modellkarte misst insgesamt etwa 61,5 GiB für den NVFP4-Build: 23,25 GiB Videospeicher plus 38,27 GiB System-RAM. Die 29 GB sind nur GPU-Speicher. Stelle sicher, dass dein Rechner den passenden RAM hat.
Es ist Open-Weight, nicht Open-Source. Die Gewichte fallen unter die Edge0 Community Model License 1.0, die einige Verwendungen wie den Verkauf, das Mieten oder Lizenzieren der Gewichte sowie den Betrieb eines Modelldienstes für eine separate schriftliche Lizenz vorbehält. Der Inferenz-Framework-Code ist Apache 2.0, aber die Gewichte nicht. Lesen Sie die Lizenz, bevor Sie ein kommerzielles Produkt darauf aufbauen.
Es basiert auf Qwen. Die Metadaten von Hugging Face nennt Alibaba's Qwen3.8-Flash-Next als Basismodell, und die Veröffentlichung ist eine Ableitung dieses Modells. Edge0s eigener Blog nennt Qwen nicht. Das ist wichtig, wenn Ihre Compliance-Regeln auf die Modellabstammung achten.
Welche soll ich wählen
Wähle Edge0-145B, wenn du eine 24-GB-GPU oder einen starken Apple Silicon Laptop hast, deine Daten lokal bleiben sollen und Agenten oder Codierungs-Workloads ausführst, bei denen eine pro Token Cloud-Rechnung schaden würde. Nimm den NVFP4- oder Q3_K-Build, führe deine tatsächlichen Workflows aus und vergleiche mit deinem aktuellen Stack Qualität, Latenz und Stromkosten.
Bleib bei einem Cloud-Modell, wenn du eine verwaltete API, garantierte Verfügbarkeit oder ein Modell mit unabhängiger Benchmark-Verifikation brauchst. Der technische Bericht für Edge0-145B ist noch ausstehend, und kein unabhängiges Labor hat die Hauptpunkte bisher reproduziert.
Warte ab, ob du dich zwischen Edge0-145B und seinem Schwester entscheidest. Edge0-120B ist kleiner und günstiger im Betrieb, und die erste Welle unabhängiger Tests wird uns zeigen, welches Bestand hat. Für einen umfassenderen Blick auf die Build-vs-Buy-Entscheidung siehe Custom AI vs Off-the-Shelf AI: 76 % Buy First.
FAQ
Ist Edge0-145B wirklich kostenlos?
Die Gewichte können kostenlos von Hugging Face heruntergeladen werden, und das Inferenz-Framework ist Apache 2.0. Sie zahlen weiterhin für GPU, Strom und Einrichtungszeit, und einige kommerzielle Anwendungen benötigen eine separate Lizenz unter der Edge0 Community Model License 1.0.
Kann Edge0-145B auf einem Laptop laufen?
Edge0 sagt ja: Bei einem MacBook Pro meldet er mehr als 80 Token pro Sekunde Dekodierung mit 29 GB GPU-Spitzenspeicher. Der gesamte gemessene Fußabdruck beträgt etwa 61,5 GiB inklusive Systemspeicher, daher wird ein gut ausgerüsteter Laptop benötigt.
Wie schnell ist Edge0-145B auf einer RTX 5090?
Edge0 meldet eine Dekodierung von 121,2 Token pro Sekunde mit dem Q3_K-Build und 98,3 Token pro Sekunde mit dem NVFP4-Build, beides vom Hersteller gemeldete Zahlen aus den eigenen Tests des Unternehmens.
Ist Edge0-145B besser als Claude Opus 4.6?
Auf Terminal-Bench 2.1 meldet Edge0 86,52 gegenüber 78,2 für Claude Opus 4.6 Max. Bei GPQA-Diamond führt Claude mit 91,3 zu 90,4. Die Ergebnisse werden vom Anbieter berichtet und es gibt noch keine unabhängige Bestätigung, sodass kein fester Gewinner vorliegt.
Wo kann ich Edge0-145B herunterladen?
Die Gewichte liegen auf Hugging Face unter Edge0/Edge0-145B-q3k und Edge0-145B-NVFP4, und das Inferenz-Framework und die Bereitstellungstools befinden sich auf GitHub unter Edge0-AI/Edge0.
Was ist der Unterschied zwischen Edge0-145B und Edge0-120B?
Edge0-145B hat insgesamt 145B Parameter mit 10,12B aktiv pro Token; Edge0-120B hat insgesamt 120B mit 8,64B aktiv. Beide wurden am 12. November 2026 gestartet, und das 120B-Modell ist die leichtere, günstigere Option.
- Edge0-145B
- open source AI
- local AI
- RTX 5090
- AI benchmarks