KI8 Min. LesezeitVon JH Akash
Drex Max v1 erklärt: 27B-Entscheidungsmodell auf Apple Silicon
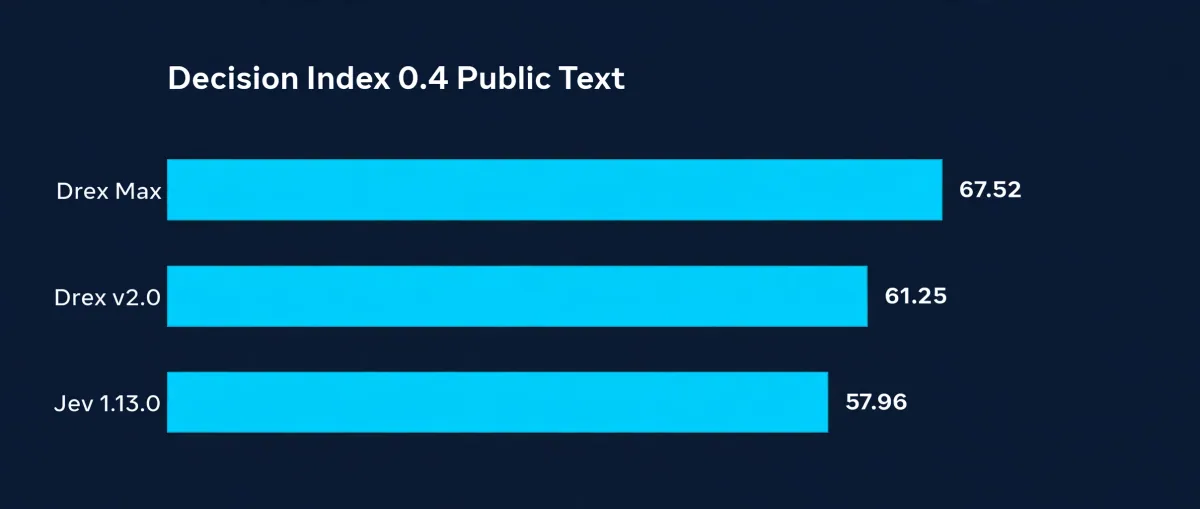
Nace AI hat Drex Max v1 am 1. November 2026 als Open Source veröffentlicht: ein Entscheidungsmodell mit 27 Milliarden Milliarden und 67,52 auf Decision Index 0,4, 262K Kontext und lokalem Mac läuft ab 24 GB.
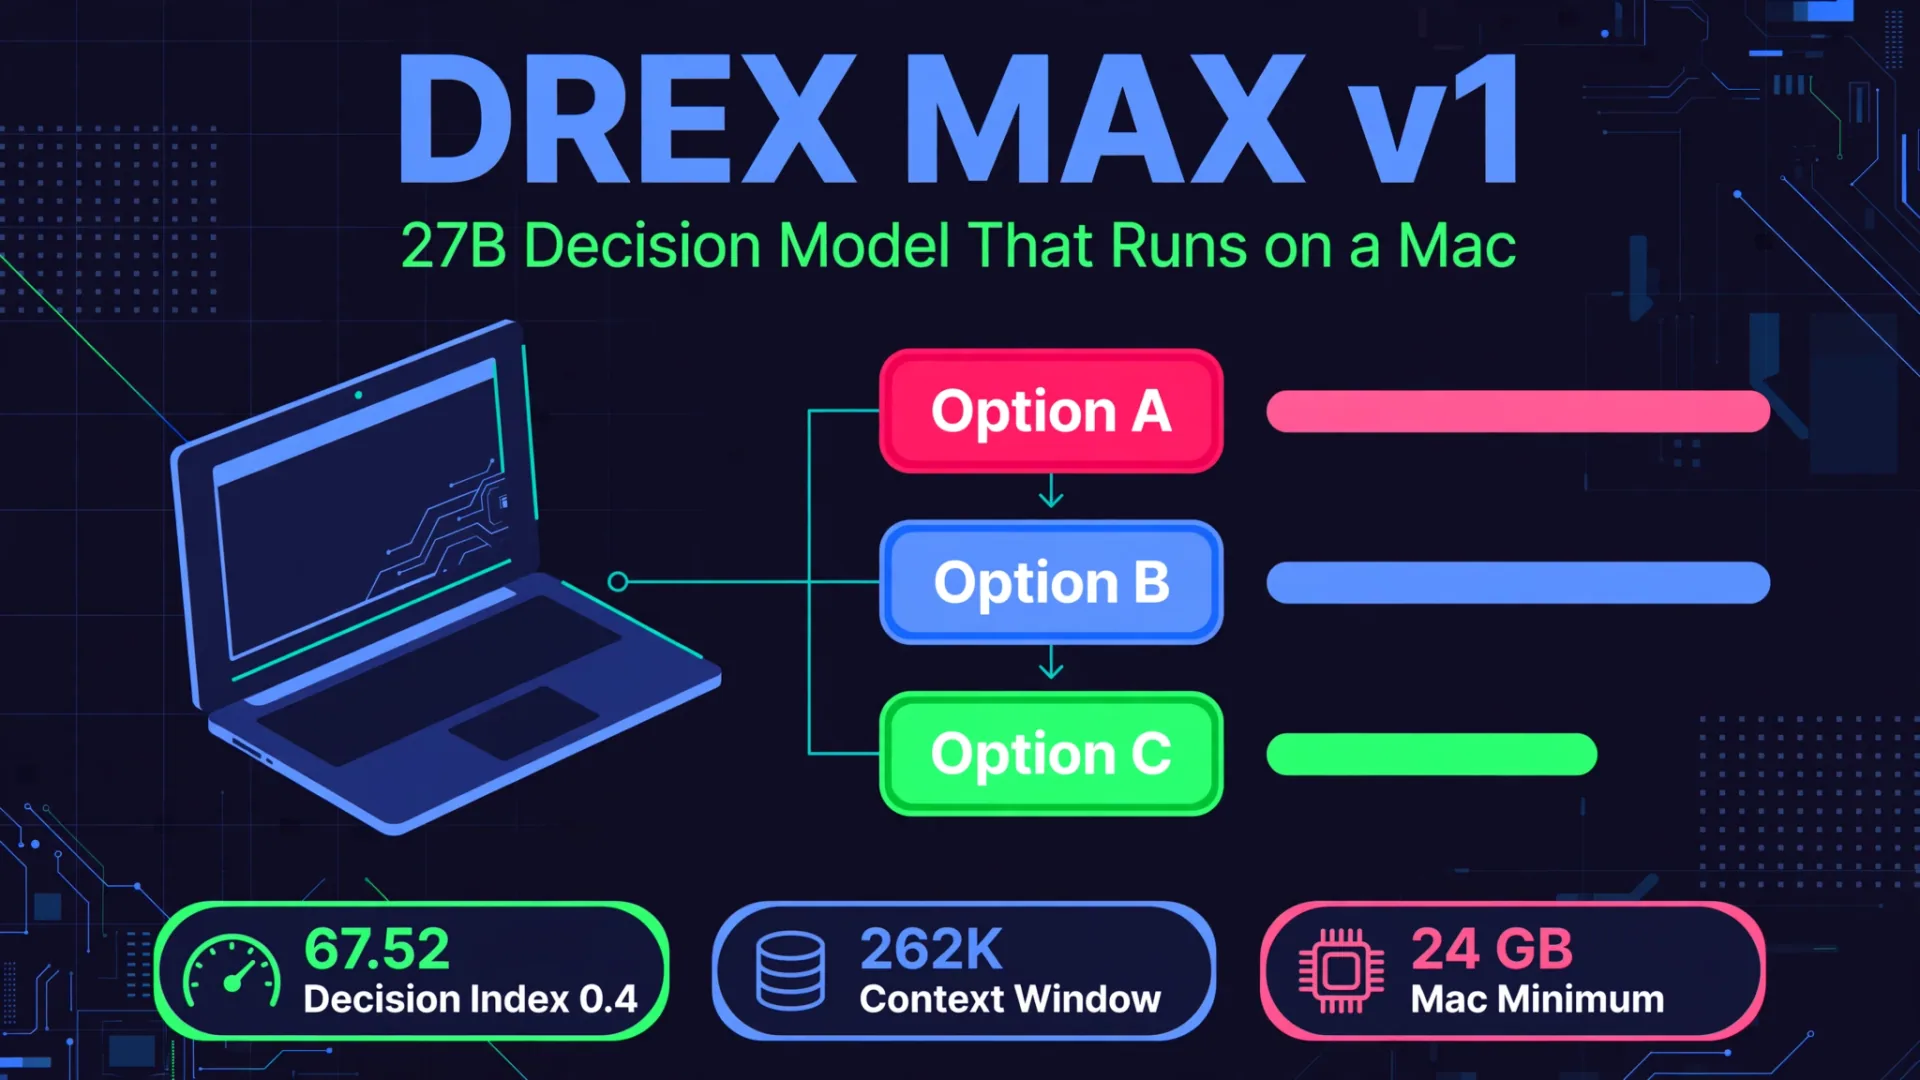
Die meisten KI-Modelle antworten dir mit Absätzen. Nace AIs Drex Max v1 macht etwas anders, und genau dieser Unterschied ist der ganze Punkt. Als Open Source am 1. November 2026 gemeldet, ist Drex Max v1 ein Entscheidungsmodell mit 27 Milliarden Parametern. Du gibst ihm einen Kontext und eine getippte Frage, und es liefert eine Wahrscheinlichkeit für jede Option in einem Vorwärtspass. Es erzeugt überhaupt keinen Text.
Das macht es zu einem Werkzeug für die wiederholten Entscheidungen innerhalb der Software: Welches Team soll ein Ticket bearbeiten, ob eine Anfrage dringend ist, welchen Weg ein Agent als Nächstes einschlagen sollte. Anstatt eine Chatbot-Antwort zu analysieren und zu hoffen, dass das Format hält, bekommt man Zahlen, die man thresholden, protokollieren und testen kann.
Das schnelle Urteil
| Frage | Antwort |
|---|---|
| Was ist das? | Drex Max v1, ein 27B-Openweight-Entscheidungsmodell von Nace AI |
| Offene Gewichte gemeldet | 1. November 2026 |
| Was es bewirkt | Beantwortet getippte Fragen mit Wahrscheinlichkeiten, in einem einzigen Vorwärtspass, ohne Textgenerierung |
| Modellgröße | 27 Milliarden Parameter, dicht, mit einem 255-Wege-Auslesekopf |
| Kontextfenster | Bis zu 262.144 Token, wobei 16.384 Token standardmäßig pro Anfrage gelten |
| Schlagzeilenmusik | 67,52 auf Decision Index 0,4 für öffentlichen Text, vom Anbieter berichtet |
| Lokales Mac-Minimum | 24 GB Speicher für den affinen Q4-Checkpoint, nur Text |
| Lizenz | Nace.AI Open RAIL-M, das Open Weights ist, nicht Open Source im strengen Sinne |
| Wer sollte es zuerst probieren | Entwickler bauen Routing-, Triage-, Klassifizierungs- oder Leitplankenkontrollen |
Was ein Entscheidungsmodell eigentlich ist
Ein normales Sprachmodell nimmt einen Prompt und generiert die nächsten Tokens. Drex Max nimmt eine andere Eingabeform an. Eine Anfrage enthält ein state, das Text, JSON oder Bilder sein kann, plus eine oder mehrere benannte Fragen. Jede Frage hat einen festen Typ:
- Wahl. Wählen Sie zwischen benannten Optionen, zum Beispiel Abrechnung, technisch oder anderes.
- Ja oder nein. Eine binäre Frage, genannt
noulin der Modellkarte. - Punktzahl. Eine Ordinalpunktzahl, zum Beispiel Routine, bald oder dringend.
Das Modell liefert dann eine Wahrscheinlichkeit für jede Option zurück. In Nace' eigenem Beispiel gibt ein Doppelabrechnungsticket eine Abrechnung bei 0,9988 zurück, technisch bei 0,0003 und andere bei 0,0009. Das ist eine Entscheidung, auf die Sie direkt reagieren können: Routen zur Abrechnung und nur Fälle mit geringer Konfidenz an einen Menschen senden.
Weil nichts erzeugt wird, es keine Prosa zu analysieren gibt, keine Formatierung und keine erfundene Erklärung, die als Grund verkleidet ist. Der Kompromiss ist genauso klar. Drex Max kann deine Antwort nicht schreiben, ein Dokument in Prosa zusammenfassen oder ein Gespräch führen. Es urteilt. Ein generatives Modell muss trotzdem sprechen.
Architektur in einfachen Begriffen
Drex Max ist ein dichtes 27B-Backbone mit 64 Schichten. Achtundvierzig sind Gated DeltaNet-Linear-Attention-Schichten, die von links nach rechts verlaufen, und 16 sind Full-Attention-Schichten, die jede vierte Schicht platzieren. Diese Full-Attention-Schichten sind nicht kausal, sodass jeder Token die gesamte Sequenz abdecken kann. Dieses Detail ist für das Ausführen wichtig: Der gebündelte Loader übernimmt die nicht-kausale Aufmerksamkeit, und Nace warnt, dass ein einfacher kausaler Chat-Run die veröffentlichten Werte nicht reproduzieren wird.
Bilder passieren einen nativen Vision-Turm und bleiben für jede Frage in einer Anfrage sichtbar. Ein 255-Wege-Anzeigekopf wandelt den zuletzt versteckten Zustand in Wahrscheinlichkeiten über bis zu 255 Optionen pro Frage um. Das Standard-Anfragelimit beträgt 16.384 Token, und es kann bis zum vollen 262.144-Token-Fenster erhöht werden.
Benchmarks: Was die Zahlen aussagen und was nicht
Alle untenstehenden Bewertungen werden von Nace AI auf seiner Hugging Face-Modellkarte vom 19. Oktober 2026 vom Anbieter angegeben. Behandeln Sie sie als eigene Ergebnisse von Nace auf öffentlichen Suites, nicht als unabhängige Verifikation. Verschiedene Benchmarks sind nicht direkt vergleichbar, daher halten die untenstehenden Tabellen jeden Index getrennt.
Entscheidungsindex 0.4, öffentlicher Text
| Modell | Öffentlicher Index | Raw | Werkzeuge | Sprache | Bergung | Wissen und Vernunft | Kunst |
|---|---|---|---|---|---|---|---|
| Drex Max (27B) | 67.52 | 75.4 | 81.9 | 72.2 | 68.8 | 57.1 | 53.4 |
| Drex v2.0 (35B) | 61.25 | 70.55 | 76.5 | 65.3 | 63.0 | 47.9 | 53.9 |
| Jev 1.13.0 | 57.96 | 68.55 | 75.1 | 59.2 | 55.4 | 53.9 | 39.1 |
Drex Max führt Drex v2.0 um 6,27 Punkte in diesem öffentlichen Index und Jev 1.13.0 um 9,56 Punkte. Der öffentliche Index umfasst im Durchschnitt 37 Benchmarks in fünf Bereichen. Der Lauf umfasste 140.620 Anfragen, von denen 140.178 wertbar waren und alle beantwortet wurden. Unbeantwortete Anfragen gelten als falsch, was die richtige Regel ist, die man vor dem Vergleich von Werten verschiedener Modelle beachten sollte.
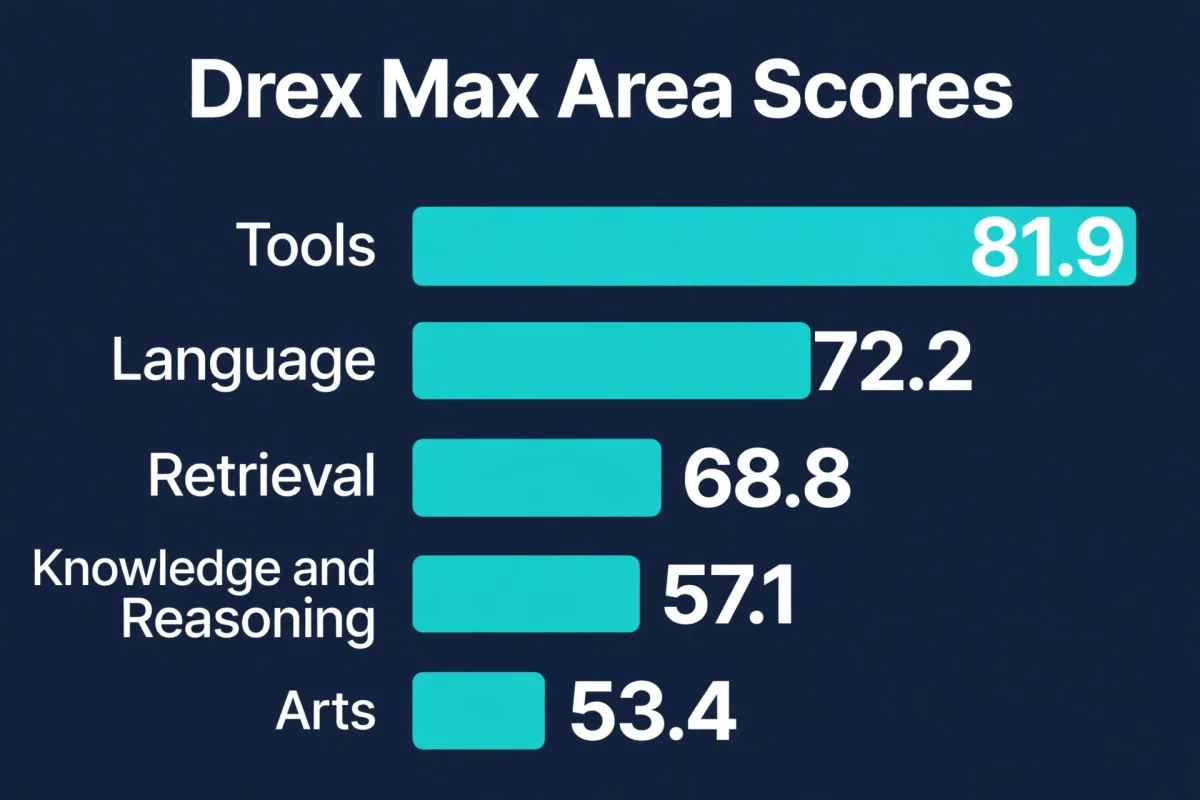
Die Flächenaufschlüsselung ist nützlicher als die Überschrift. Werkzeuge mit 81,9 sind der stärkste Bereich, gefolgt von Sprache mit 72,2 und Abruf bei 68,8. Wissen und Schlussfolgerung bei 57,1 und Kunst bei 53,4 sind schwächer, was zu einem Modell passt, das auf strukturierte Entscheidungen statt auf breites Wissen oder kreatives Urteil basiert.
Andere gemeldete Ergebnisse wurden getrennt gehalten
| Index | Drex Max-Punktzahl | Anmerkungen |
|---|---|---|
| Öffentlicher Visionsindex, Entscheidungsindex 0,4 | 73.92 | Über 12.210 Zeilen, einschließlich InfographicVQA bei 97,3 |
| Entscheidungsindex für künstliche Analyse | 64 | Vierter von 18, einen Punkt hinter den Führenden mit 65 |
| JevBench | 92,2 Prozent | 213 von 231 |
| Entscheidungsbank v4 | 94,30 Prozent | 1010 von 1071 |
Kombinieren Sie diese nicht zu einer einzigen Rangliste. Der Artificial Analysis Index zum Beispiel ist ein gewichteter Durchschnitt seiner eigenen vier Tests und platziert Drex Max hinter drei Modellen mit 65 und vor Claude Haiku 5.5 (Low) mit 61. Die ehrliche Lesart ist enger gefasst: Bei Entscheidungsaufgaben ist Drex Max mit den Spitzen seiner eigenen Kategorie konkurrierend und am stärksten, wenn die Aufgabe auf Werkzeugnutzung oder Abruf basiert.
Was der Betrieb kostet: Hardware, keine Token
Auf der Modellkarte gibt es keinen API-Preis pro Token, also budgetiere das nicht wie bei einem gehosteten Chatbot. Die Kosten sind Downloadgröße und Hardware. Nace veröffentlicht mehrere Checkpoints für verschiedene Maschinen.
| Kontrollpunkt | Größe | Benötigtes Gedächtnis | Am besten für |
|---|---|---|---|
| BF16-Gewichte | Etwa 49 GB | NVIDIA H100 80 GB, 48,6 GiB geladen | Vollwertiges Python läuft auf NVIDIA-GPUs, einschließlich Images |
| 8-Bit-Backbone | Etwa 26 GB | NVIDIA L40S 48 GB, 25,9 GiB geladen | Kleinere NVIDIA läuft, einschließlich Abbildungen |
| Q8_0 GGUF | 27,25 GB | 48 GB Apple Silicon Mac | Lokaler Mac-Text läuft über llama.cpp, Ollama oder Kapitsa |
| Affine Q4 | 14,45 GB | 24 GB oder mehr Apple Silicon Mac | Lokaler Mac-Text läuft über Kapitsa oder MLX |
Zwei Grenzen entscheiden die Wahl. Erstens sind lokale Mac- und CPU-Pfade vorerst nur Text. Wenn deine Entscheidung Bilder benötigt, brauchst du den Python-Pfad auf einer NVIDIA-GPU. Zweitens hat die Quantisierung in Nace's Tests gut bestanden: Bei einem 48 GB Apple M5 Pro entsprach der Q80 GGUF dem H100 bf16-Output innerhalb von 0,02 pro Wahrscheinlichkeit, und affines Q4 blieb innerhalb von 0,0329 von Q80 ohne Wahlwechsel. Kleiner änderte die gewählte Antwort in diesen Tests nicht.
Für einen ersten Test ist der praktische Weg der kleinste, der zu deiner Maschine passt. Lade den affinen Q4-Checkpoint herunter, wenn du einen 24-GB-Mac hast, oder den Q8_0 GGUF, wenn du 48 GB hast, und teste ihn auf deinen eigenen Tickets, Routen oder Policy-Checks, bevor du einem öffentlichen Score vertraust. Eine Benchmark-Suite ist nicht deine Arbeitsbelastung.
Welche Einrichtung sollte ich wählen
Wenn du einen 24-GB-Mac und reine Textentscheidungen hast: Nutze den affinen Q4-Checkpoint über Kapitsa oder MLX und teste zuerst mit deinen echten Kategorien.
Wenn du einen Mac mit 48 GB hast und reine Textoptionen: Nutze das Q8_0 GGUF über llama.cpp, Ollama oder Kapitsa. Es ist näher an der vollständigen BF16-Ausgabe und läuft weiterhin lokal.
Wenn du Image-Entscheidungen brauchst: Nutze den Python-Pfad auf einer NVIDIA-GPU mit bf16- oder 8-Bit-Gewichten. Erwarte nicht, dass die Mac-Builds Images schon verarbeiten.
Wenn du ein Modell gar nicht ausführen möchtest: Nutze die gehostete Version von Nace für Routing-, Klassifikations- und Richtlinienprüfungen und prüfe die aktuellen Preise auf der Nace-Konsole, bevor du darauf aufbaust. Die Modellkarte veröffentlicht keinen gehosteten Preis, daher erfindet dieser Beitrag keinen einen.
Der Lizenzfang zum Lesen vor der kommerziellen Nutzung
Open Weights sind nicht dasselbe wie Open Source. Du bekommst die Gewichte, aber nicht unbedingt die Trainingsdaten oder eine permissive Open-Source-Lizenz. Drex Max wird unter der Nace.AI Open RAIL-M-Lizenz veröffentlicht. Eine unabhängige Liste, die die Lizenzflaggen liest, ist Grenzen, die es wert sind, mit der eigenen rechtlichen Überprüfung überprüft zu werden, einschließlich freier kommerzieller Nutzung nur unter Einnahme- und Finanzierungsgrenzen sowie einer Sperre für konkurrierende Entscheidungsprodukte. Lies die tatsächliche Lizenz im Modell-Repository, bevor du ein kommerzielles Produkt darauf auslieferst. Für persönliche, Forschungs- oder interne Tests ist die lokale Version der einfache Weg, sie zu bewerten.
Warum diese Veröffentlichung für KI-Agenten wichtig ist
Agenten scheitern meist nicht bei der Generierung, sondern bei den kleinen Entscheidungen zwischen den Schritten: routen Sie dies, eskalieren Sie das, lassen Sie dieses Tool aufrufen, blockieren Sie das. Ein generatives Modell kann diese Fragen beantworten, aber es beantwortet es in Prosa, und Prosa muss parsiert werden. Ein Entscheidungsmodell liefert eine Wahrscheinlichkeitsverteilung über eine feste Menge von Optionen zurück, was genau das ist, was ein Agenten-Router, eine Triage-Warteschlange oder eine Leitplanke möchte.
Deshalb ist auch der lokale Aspekt entscheidend. Routing- und Policy-Checks betreffen oft sensible Tickets, Dokumente oder Screenshots. Die lokale Ausführung der Entscheidung behält diesen Kontext auf der eigenen Hardware, anstatt ihn für jedes Urteil an einen gehosteten Dienst zu schicken. Drex Max ist kein Ersatz für einen Frontier-Chatbot. Es ist ein spezialisierter Judge, den man neben einem laufen lassen kann, und die Openweights-Veröffentlichung vom 1. November macht das für Entwickler mit einem fähigen Mac oder GPU praktisch.
Möchten Sie Agenten bauen, die diese Art von Routing in der Produktion verwenden? Lesen Sie unsere Anleitungen zu AI-Agentenentwicklungsdiensten und wie man eine KI-Automatisierungsagentur engagiert. Für mehr Openweight-Starts siehe Mistral Large 4 Openweights erklärt, Liquid AI LFM3 erläutert, Kimi K3.1 Pro erklärt und Apple Intelligence in China auf Alibaba Qwen.
Quellen: Nace AI Model Card auf Hugging Face (https://huggingface.co/nace-ai/drex-max-v1), MarkTechPost-Berichterstattung vom 1. November 2026 (https://wisevoter.com/world/2026/11/01/nace-ai-open-sources-drex-max-v1) und Artiverse-Berichterstattung, die darauf hinweist, dass sie von Nace AI gesponsert wird (https://www.artiverse.ca/drex-max-puts-a-27b-decision-model-on-apple-silicon/).
Was ist Drex Max v1?
Drex Max v1 ist ein Entscheidungsmodell mit 27 Milliarden Parametern von Nace AI. Es beantwortet getippte Fragen zu einem gegebenen Kontext mit einer Wahrscheinlichkeit für jede Option in einem Vorwärtspass und erzeugt keinen Text.
Ist Drex Max ein Chatbot?
Nein. Es chattet nicht, schreibt keine Prosa und generiert keine Antworten. Es bewertet zwischen den Optionen, die du definierst, was es nützlich für Routen, Triage, Klassifizierung und Leitplankenprüfungen innerhalb von Software und KI-Agenten macht.
Kann Drex Max auf einem Mac laufen?
Ja, für Textentscheidungen. Der affine Q4-Checkpoint läuft auf Apple Silicon Macs mit 24 GB oder mehr Speicher über Kapitsa oder MLX, und der Q8_0 GGUF benötigt 48 GB. Bildentscheidungen benötigen weiterhin den Python-Pfad auf einer NVIDIA-GPU.
Was ist der Benchmark-Score von Drex Max?
Nace nennt im Decision Index 0,4 für öffentliche Texte 67,52, vor Drex v2.0 mit 61,25 und Jev 1.13.0 mit 57,96. Dies sind vom Anbieter berichtete Werte, also testen Sie das Modell an Ihrer eigenen Arbeitslast, bevor Sie sich darauf verlassen.
Ist Drex Max kostenlos und Open Source?
Die Gewichte sind unter der Nace.AI Open RAIL-M Lizenz öffentlich, aber das sind offene Gewichte, nicht im strengen Sinne Open Source. Prüfen Sie die Lizenz auf kommerzielle Grenzwerte, bevor Sie ein Produkt darauf versenden.
Wie viel Kontext kann Drex Max bewältigen?
Bis zu 262.144 Token, mit 16.384 Token als Standard pro Anfrage. Erhöhen Sie das Limit nur, wenn Ihre Anfragen tatsächlich das längere Zeitfenster benötigen.
- drex max
- nace ai
- decision model
- open weight models
- apple silicon
- ai agents