KI8 Min. LesezeitVon JH Akash
Mistral Large 4 offene Gewichte erklärt: Le Chonk, das 1T-Modell, das du herunterladen kannst
Mistral veröffentlichte am 29. Oktober 2026 Large 4 Open Weights: 1T-Parameter, 52B aktiv, 41 % Terminal-Bench 4.0, 0,70 $/2,10 $ API-Preis und eine modifizierte MIT-Lizenz.
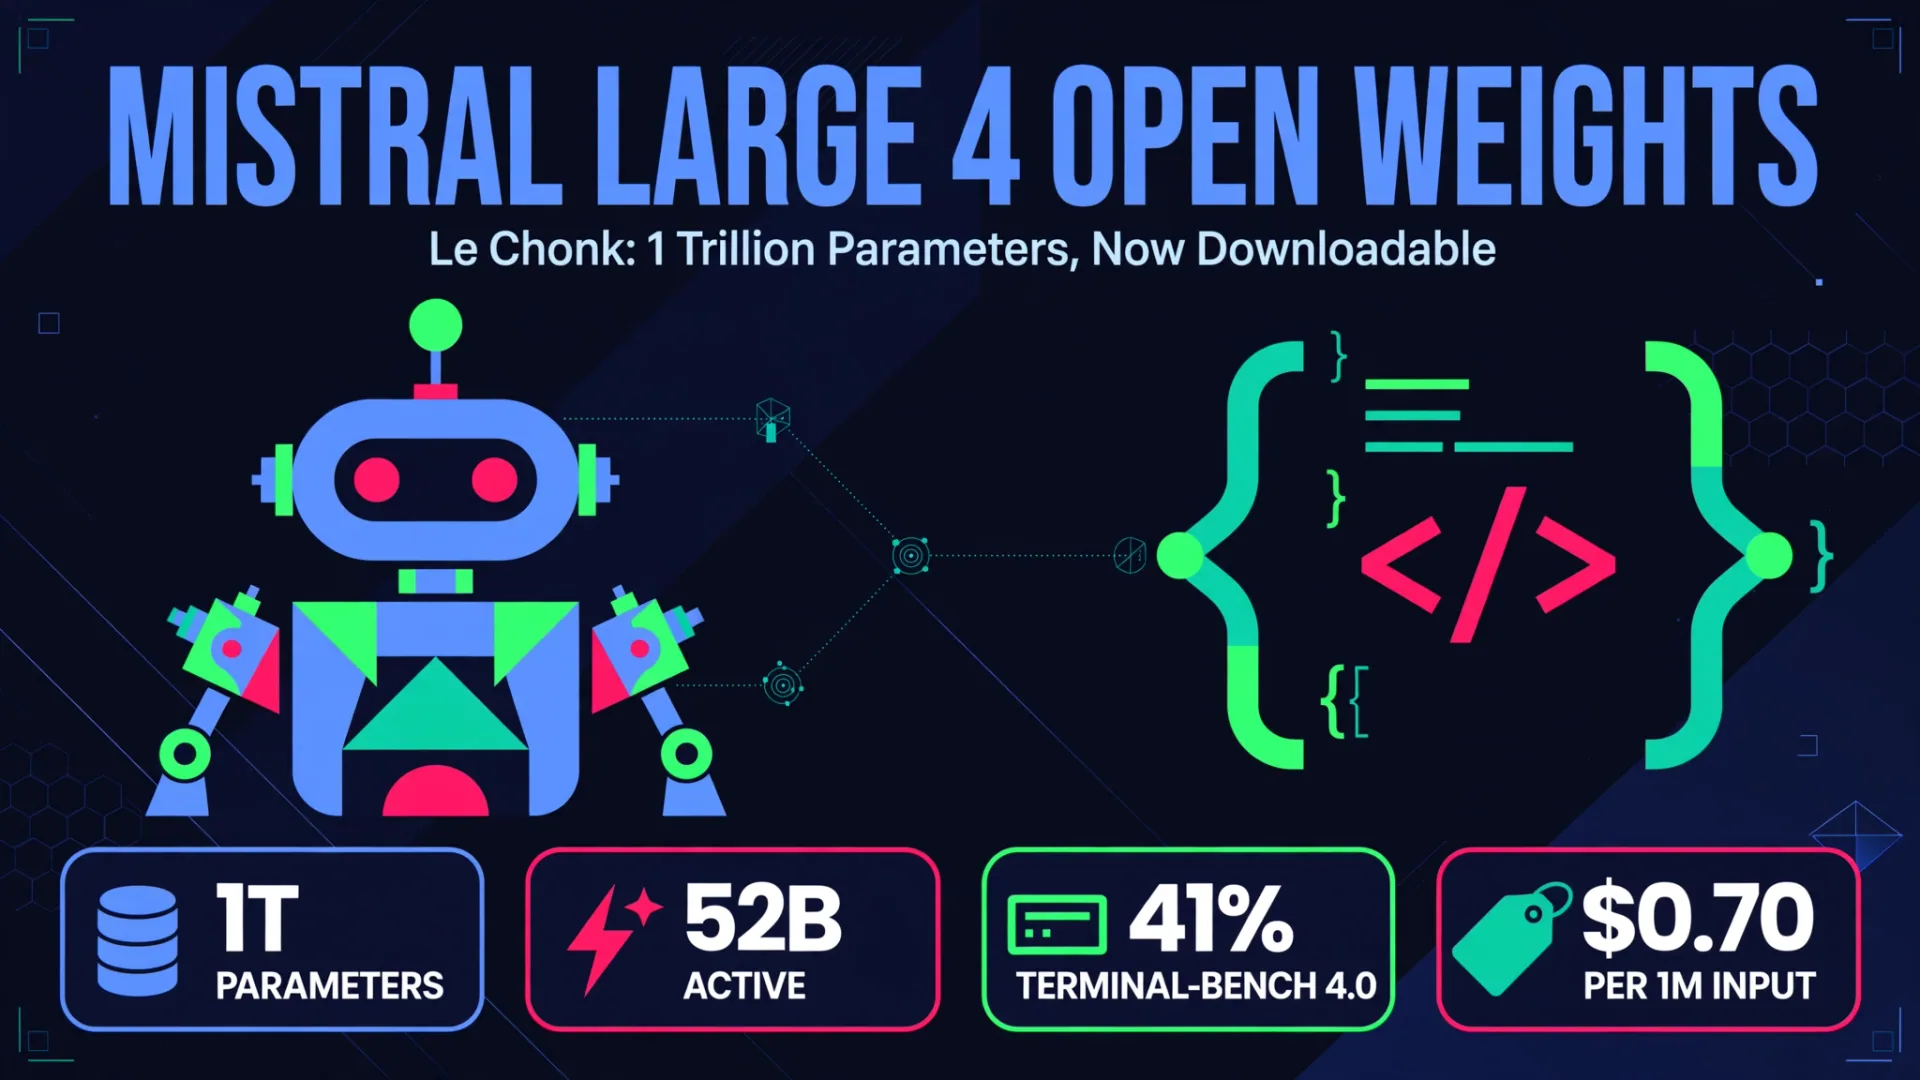
Mistral veröffentlichte die offenen Gewichte von Mistral Large 4 am 29. Oktober 2026, drei Wochen nach der öffentlichen Vorschau des Modells am 6. Oktober. Mit dem Spitznamen "Le Chonk" ist es das Flaggschiff des französischen Labors: ein native multimodales Mix-of-Experten-Modell mit etwa 1 Billion Gesamtparametern, von denen pro Token nur etwa 52 Milliarden aktiv sind. Dieses Design ist der ganze Sinn. Man erhält eine Skala mit Billionenparametern für Wissen und Fähigkeit, aber man zahlt nur für etwa 5 Prozent der Gewichtungen pro Token Compute.
Die Veröffentlichung ist wichtig, weil es sich nicht mehr um eine Demo oder nur API-Vorschau handelt. Die Gewichtungen liegen auf Hugging Face als Mistral-Large-4-1T-A52B, bereit zum Herunterladen, Feinabstimmen und Betrieb auf eigenen Servern mit vLLM oder SGLang. Mistral präsentiert Large 4 besonders in zwei Bereichen: agentischer Codierung und defensiver Cybersicherheit. Jede Benchmark-Zahl unten wird von Mistral vom Anbieter berichtet, also behandeln Sie dies als Anspruch des Unternehmens, bis unabhängige Tester sie wiederholen. Der vollständige technische Bericht ist weiterhin als demnächst erscheinend gelistet.
Das schnelle Urteil
| Frage | Antwort |
|---|---|
| Was ist das? | Mistral Large 4, Spitzname Le Chonk, ein nativ multimodales Open-Weight-Modell |
| Freigegebene Gewichte | 29. Oktober 2026 (öffentliche Vorschau: 6. Oktober 2026) |
| Architektur | Mischung von Experten, etwa 1 T Gesamtparameter, etwa 52 Milliarden aktiv pro Token |
| Kontextfenster | 1 Million Token |
| Sprachen | Text- und Bildeingang, muttersprachliche Beherrschung in mehr als 160 Sprachen |
| Gebaut für | Agentische Codierung, Cybersicherheitsabwehr, Unternehmensagenten |
| Denkmodi | Niedrig, Mittel und Hoher (Hoher ist der Standard) |
| Lizenz | Mistral Ecosystem Open-Weight-Lizenz, eine modifizierte MIT-Lizenz |
| API-Preis | 0,70 $ pro 1 Million Eingabetoken, 0,07 $ gecachte Eingabe, 2,10 $ pro 1 Million Ausgabetoken |
| Selbsthosting | Hugging Face Weights, vLLM oder SGLang, auch auf Mistral Studio, OpenRouter, Microsoft Foundry und NVIDIA Endpunkten |
| Der Haken | Unternehmen, die es als gehostetes Modell anbieten, benötigen eine separate kommerzielle Lizenz |
Was hat sich seit der Vorschau vom 6. Oktober geändert?
Die Schlagzeilenverbesserung liegt bei Terminal-Bench 4.0, einem Test der in einem Terminal durchgeführten Codierungsarbeit. Mistral berichtet, dass der Wert von 28 Prozent bei der Vorschau auf 41 Prozent in der Open-Weight-Version gestiegen ist, ein Anstieg um 13 Punkte, während die Output-Token um 30 Prozent sanken. Mistral schreibt drei zusätzliche Wochen Reinforcement Learning für die Fortschritte an, einschließlich effizienterem Schließen und geringeren Inferenzkosten.
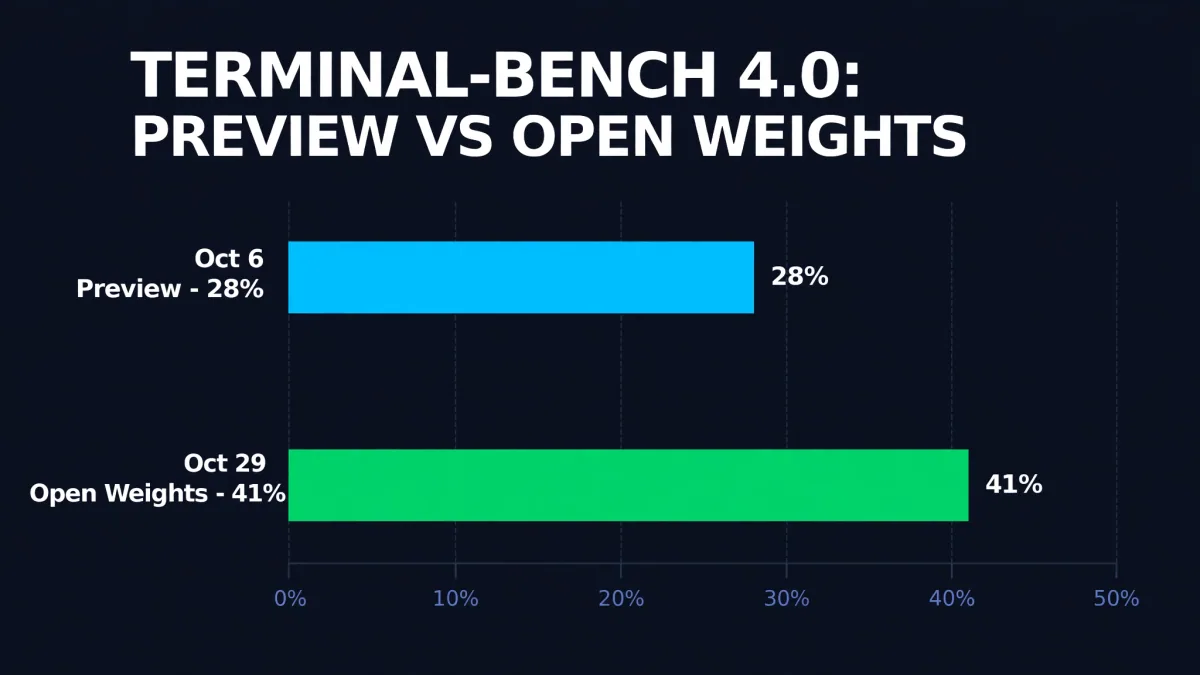
Dieser einzelne Sprung verändert das Modell. In der Vorschau sah Large 4 wie ein vielversprechender, aber hinterherlaufender Coder aus. In der Openweight-Version gibt Mistral einen Wert von 48 Prozent im Artificial Analysis Coding Agent Index an, was effektiv mit GLM-5.3 gleichauf liegt, während im Durchschnitt 47 Prozent weniger Token pro Aufgabe verwendet werden. Im privaten FrontierCode 2.0-Benchmark von Cognition, der testet, ob ein Repository-Maintainer die Codeänderung eines Agenten zusammenführen würde, nennt Mistral 19,7 Prozent, den höchsten Wert unter den Openweight-Modellen. Zum Kontext: Closed Models liegen bei demselben Test immer noch weit voraus: Claude Opus 5.5 erreicht laut Berichterstattung über Mistrals Ankündigung 46 Prozent. Open Weights schließen die Lücke, sie haben sie nicht geschlossen.
Benchmark-Tabelle (alle von Mistral vom Anbieter berichtet)
| Benchmark | Mistral Large 4 Wertung | Was es misst |
|---|---|---|
| FrontierCode 2.0 | 19.7% | End-to-End-Codequalität, Top-Score unter den offenen Modellen |
| Terminal-Bench 4.0 | 41 % (Vorschau: 28 %) | Codierungsarbeit, die in einem Terminal durchgeführt wird |
| Kodierungsagentenindex | 48% | Agentencoding, effektiv gleichauf mit GLM-5.3, mit 47 % weniger Token pro Aufgabe |
| Cyber-Index | 51% | Findung, Reproduktion, Validierung und Patching von Schwachstellen |
| B3 Agent Security Benchmark | 97,1 % Angriffsresistenz (Vorschau: 93,3 %) | Widerstand gegen Agentenangriffe |
| Bösartige Cyber-Prompts | 96,6 % Ablehnungsrate | Ablehnung bösartiger Cybersecurity-Anfragen |
| FinWorkBench | 73.3% | Finanz-Arbeitsabläufe |
| BrowseComp | 84,5 % (Vorschau-Kontrollpunkt: 75 %) | Deep-Web-Forschung |
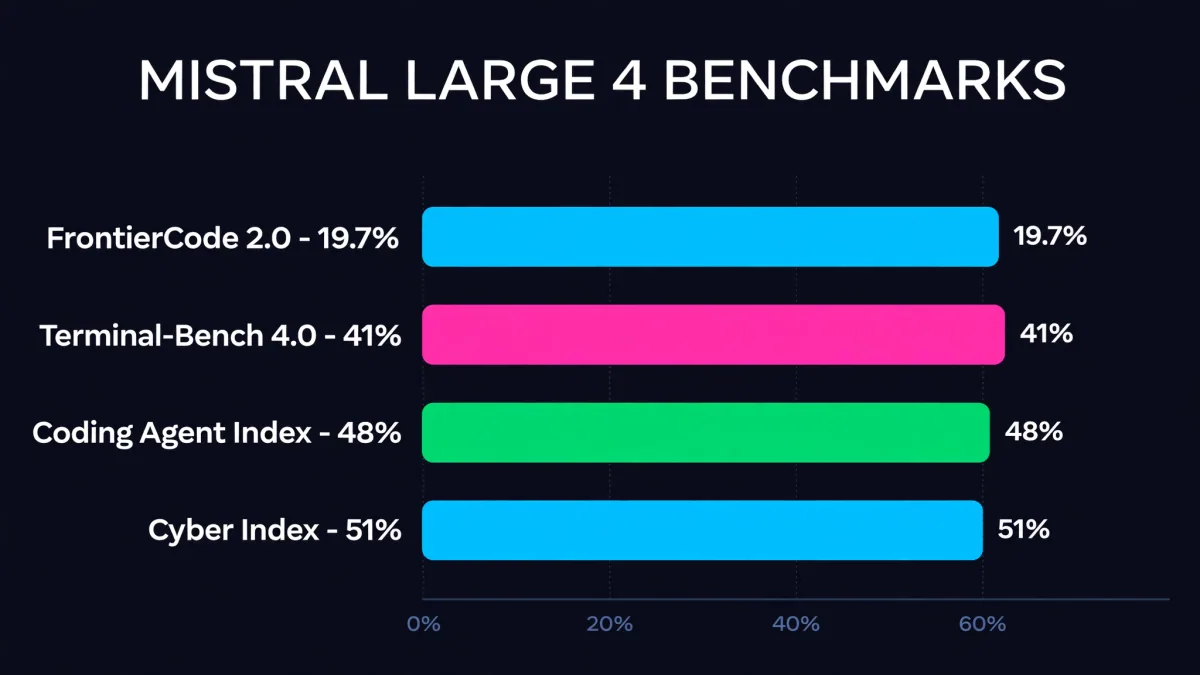
Lesen Sie diese Zahlen mit zwei Vorsichten. Erstens sind verschiedene Benchmarks nicht miteinander vergleichbar, sodass ein höherer Prozentsatz bei einem Test nicht bedeutet, dass das Modell insgesamt "besser" ist als bei einem anderen. Zweitens waren unabhängige Prüfungen weniger großzügig: Eine in der Coverage zitierte Prüfung belegte Large 4 auf Platz 32 von 44 im Gesamtindex, obwohl sie in einem rechtlichen Benchmark nahe an der Spitze standen. Vendor-Benchmarks sind ein Ausgangspunkt für Ihre eigenen Tests, kein Urteil.
Preistabelle
| Verlauf | Preis |
|---|---|
| Mistral API, Eingabe | 0,70 $ pro 1-Million-Token |
| Mistral-API, zwischengespeicherte Eingabe | $0,07 pro 1M-Token |
| Mistral API, Ausgabe | 2,10 $ pro 1M-Token |
| Vorschau-Listenpreis (zum Vergleich) | 1,36 $ Eingabe, 4,18 $ Ausgabe pro 1 Million Token |
| Selbstgehostete Gewichte | Kostenlos herunterzuladen, du bezahlst deine eigenen GPUs |
| Wiederverkaufsmodell als Dienstleistung | Eine separate gewerbliche Lizenz von Mistral ist erforderlich |
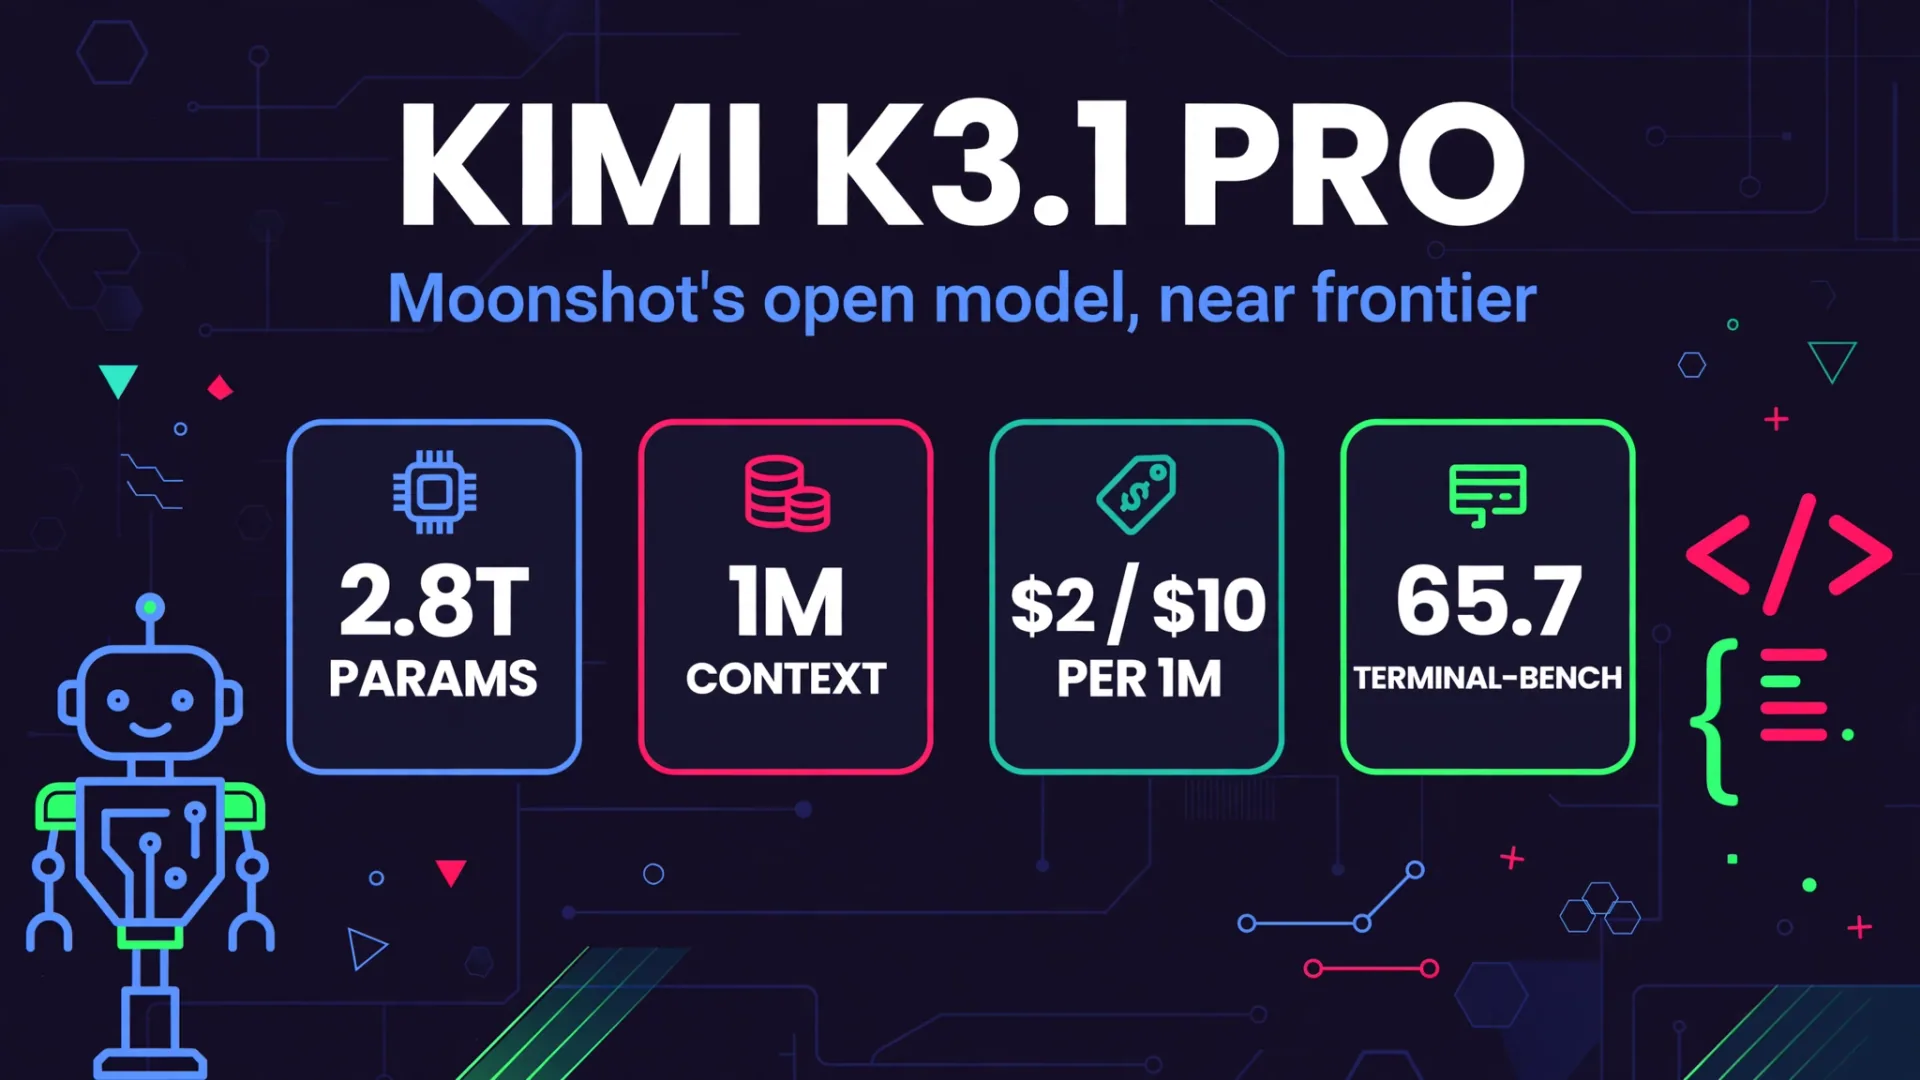
Der Preis für die neue API beträgt ungefähr die Hälfte des Preview-Listenpreises, was dem Startrabatt entspricht, den Mistral während der Vorschau angeboten hat. Zum Vergleich: Moonshots Kimi K3.1 Pro kostet 2 $ Eingabe und 10 $ Ausgabe pro 1 Mio. Token, daher ist die API von Large 4 für ein Frontier-Class-Open-Modell aggressiv bepreist. Der günstigere Token-Preis hilft nur, wenn die Token-Effizienz in Ihrer Arbeitslast gilt – messen Sie also die Kosten pro abgeschlossene Aufgabe und nicht pro Token.
Die Lizenz, in klarer Sprache
Big 4 wird unter der Mistral Ecosystem Open-Weight-Lizenz veröffentlicht, einer modifizierten Version der MIT-Lizenz. Sie können sie nutzen, modifizieren, verfeinern und kommerzielle Produkte darauf kostenlos bauen. Es gibt eine Ausnahme, und sie ist wichtig: Unternehmen, die ein Model-as-a-Service-Angebot betreiben, also gehosteten Zugriff auf das Modell selbst verkaufen, müssen zunächst eine separate kommerzielle Lizenz von Mistral erhalten. Die Berichterstattung merkt an, dass die Ankündigung nicht klar definiert, wo das Wrappen des Modells in ein SaaS-Produkt endet und Model-as-a-Service beginnt, also wenn Sie den Zugang weiterverkaufen wollen, lassen Sie die Lizenzfrage schriftlich beantworten, bevor Sie darauf aufbauen.
Souveränität und Sicherheit: die andere Hälfte des Spielfelds
Mistral hat Large 4 von Grund auf in seinen eigenen europäischen Rechenzentren trainiert, angeblich auf etwa 3.800 NVIDIA Grace Blackwell-GPUs (einige Berichterstattungen gehen von 4.000 aus), und präsentiert das Modell als souveräne KI: Organisationen können es inspizieren, anpassen und innerhalb ihrer eigenen Firewalls betreiben, ohne auf Mistrals API angewiesen zu sein. Das ist ein echter Vorteil für regulierte Branchen, Regierungsarbeit und alle mit strengen Regeln zur Datenresidenz.
In Sachen Sicherheit bewegt sich Mistral auf einem vorsichtigen Weg. Es berichtet eine Bewertung von 51 Prozent im Artificial Analysis Cyber Index und eine Ablehnungsrate von 96,6 Prozent bei bösartigen Cyberanfragen und sagt, dass Leitplanken defensive Arbeit bewahren, während sie Angriffe blockieren. Gleichzeitig räumt Mistral ein, dass es während der Vorschau Potenzial für einen Aufstieg bei echten Angriffen gesehen hat, und eine weniger eingeschränkte Variante, die auf Penetrationstests und Red-Teaming abgestimmt ist, bleibt auf geprüfte Unternehmensdesignpartner, darunter Orange Cyberdefense, beschränkt – unter Verträgen, die Tests auf eigene oder ausdrücklich autorisierte Systeme beschränken. Sobald Gewichte öffentlich sind, können sie nicht mehr abgeschaltet werden, sodass die offene Freigabe selbst eine Entscheidung darüber ist, ob der Verteidigungswert das Missbrauchsrisiko überwiegt.
Was es braucht, um es selbst zu leiten
Dies ist kein Laptop-Modell. Laut SGLang-Dokumentation läuft die Standardversion auf acht NVIDIA B300-GPUs, eine stärker komprimierte Variante auf vier GB300-GPUs. Die meisten Teams profitieren besser von der gehosteten API, einem Partner-Endpunkt wie Microsoft Foundry oder OpenRouter oder von Mistral Forge für die Feinabstimmung aufgabenspezifischer Varianten, anstatt das vollständige Modell selbst zu hosten. Wenn Sie stattdessen ein kleines offenes Modell für On-Device-Arbeit wünschen, sehen Sie sich unseren Beitrag über Liquid AI LFM3 an, sechs 2B-Klasse-Modelle, die genau für diese Aufgabe gebaut wurden. Für einen kontrastierenden Fall eines leistungsstarken Modells, das Sie gar nicht herunterladen können, sehen Sie sich Gemini 4 Carbon an, Googles Cybersicherheitsmodell, das derzeit auf geprüfte Verteidiger beschränkt ist. Und wenn Sie offene Modelle gegen Frontier-geschlossene abwägen, ist unsere Kimi K3.1 Pro-Analyse ein nützlicher zweiter Datenpunkt.
Welche soll ich wählen
Wähle die Mistral-API , wenn du Large 4 schnell testen möchtest oder wenn du Frontier-Class-Open-Model-Codierung brauchst, ohne GPUs zu kaufen. Der Preis von 0,70 $/2,10 $ und der 1 Million Kontext machen es günstig, es auszuprobieren.
Wähle Self-Hosting, wenn Datenresidenz, Souveränität oder tiefgehende Anpassung der entscheidende Faktor sind und du das GPU-Budget hast. Du hast die volle Kontrolle, aber du besitzt auch die Bereitstellung, Sicherheit und Aktualisierung.
Wählen Sie Feinabstimmung über Mistral Forge , wenn Sie einen schmalen, klar definierten Job haben, wie einen Sicherheitsworkflow oder einen internen Codieragenten, bei dem eine abgestimmte kleinere Variante das allgemeine Modell in Bezug auf Kosten und Genauigkeit schlagen kann.
Überspringen Sie es erstmal, wenn Sie vorhaben, den Zugriff auf gehostete Modelle weiterzuverkaufen, ohne die kommerzielle Lizenz zu regeln, wenn Sie ein Modell brauchen, das auf bescheidener Hardware läuft, oder wenn Ihre Arbeitslast bereits von einem günstigeren kleinen Modell gut bedient wird. Und wenn Sie unabhängig von der Offenheit die absolut beste Coding-Bewertung benötigen, führen geschlossene Modelle wie Claude Opus 5.5 bei FrontierCode 2.0 immer noch mit großem Vorsprung, basierend auf den gemeldeten Zahlen.
Für Teams, die Produktions-KI-Systeme bauen, ist die Modellwahl nur die halbe Arbeit. CodeMyPixel baut KI-Agentenentwicklungsdienste und hilft Unternehmen, eine KI-Automatisierungsagentur zu engagieren, um Modelle wie diese in echte Workflows umzusetzen, mit den Leitplanken, Evaluierungen und Kostenkontrollen, die ein Rohmodell-Download nicht bietet.
Was ist Mistral Large 4?
Mistral Large 4 ist das Flaggschiff-Openweight-Modell von Mistral AI und trägt den Spitznamen Le Chonk. Es handelt sich um ein nativ multimodales Mix-of-Experten-Modell mit etwa 1 Billion Gesamtparametern und etwa 52 Milliarden Aktiven pro Token, einem Kontextfenster von 1 Million Tokens und Sprachflüssigkeit in mehr als 160 Sprachen.
Ist Mistral Large 4 wirklich kostenlos?
Die Gewichte können unter der Mistral Ecosystem Open-Weight-Lizenz kostenlos heruntergeladen, genutzt, modifiziert, verfeinert und gebaut werden. Die einzige Ausnahme sind Model-as-a-Service-Unternehmen, die eine separate kommerzielle Lizenz von Mistral benötigen. Selbsthosting kostet weiterhin GPU-Infrastruktur, oder Sie zahlen den Mistral-API-Preis von 0,70 $ pro 1 Million Eingabetoken und 2,10 $ pro 1 Million Ausgabetoken.
Wie schneidet Large 4 im Vergleich zu GLM-5.3 und Claude Opus 5.5 ab?
Laut von Anbietern berichteten Zahlen gleicht Large 4 GLM-5.3 mit 48 Prozent im Coding Agent Index, verwendet 47 Prozent weniger Token, und führt offene Modelle auf FrontierCode 2.0 mit 19,7 Prozent an. Claude Opus 5.5 führt mit 46 Prozent immer noch denselben FrontierCode-Test an, sodass geschlossene Frontier-Modelle in Sachen roher Codierungsfähigkeit weiterhin führen.
Welche Hardware brauche ich, um Mistral Large 4 zu betreiben?
Die Standardversion benötigt ernsthafte Hardware: acht NVIDIA B300 GPUs laut SGLang-Dokumentation oder vier GB300 für eine komprimierte Variante. Die meisten Nutzer sollten mit der Mistral API, OpenRouter oder Microsoft Foundry beginnen, anstatt selbst zu hosten.
Wo kann ich Mistral Large 4 herunterladen?
Die Gewichte werden auf Hugging Face als Mistral-Large-4-1T-A52B veröffentlicht, für die Bereitstellung mit vLLM oder SGLang. Das Modell ist außerdem über Mistral Studio, die Mistral API, OpenRouter, Microsoft Foundry und von NVIDIA gehostete Endgeräte verfügbar.
Sollte mein Unternehmen auf Mistral Large 4 umsteigen?
Wechsle, wenn Souveränität, Datenresidenz oder Feinabstimmungskontrolle für dich wichtig sind oder wenn die Token-Effizienzbehauptung in deinen eigenen Tests Bestand hat. Teste es zuerst an deinen eigenen Aufgaben, bestätige die Lizenzposition, wenn du Access weiterverkaufst, und vergleiche Kosten pro abgeschlossene Aufgabe – nicht nur Kosten pro Token, bevor du dich entscheidest.
- mistral large 4
- le chonk
- open weight models
- mistral ai
- ai coding
- cybersecurity ai
- frontier models