KI9 Min. LesezeitVon JH Akash
Liquid AI LFM3 erklärt: 6 offene 2B-Modelle
Liquid AI brachte LFM3 am 27. Oktober 2026 auf den Markt: sechs Openweight-2B-Modelle aus einem 1,7-Milliarden-Backbone, 256K Kontext, 1 GB bei 4-Bit, API ab 0,08 US-Dollar pro 1-Million-Token.
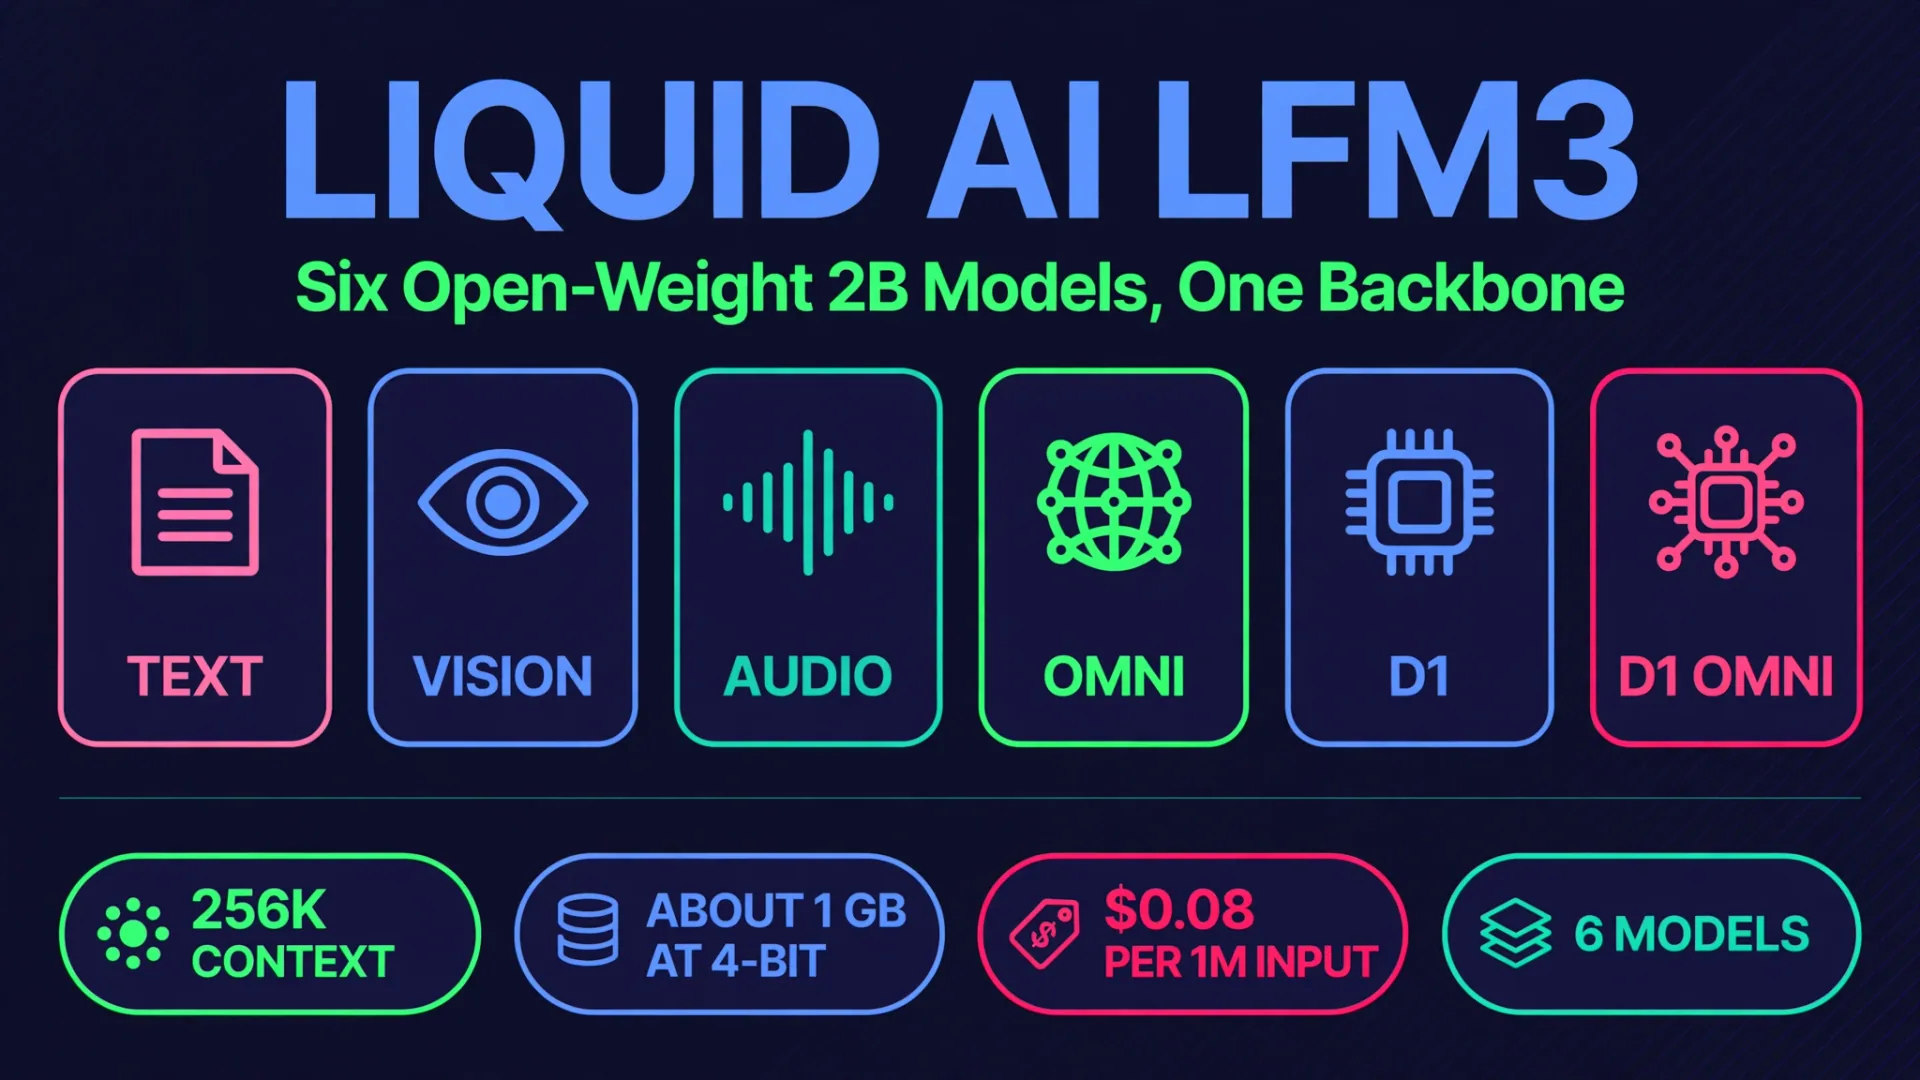
Liquid AI brachte LFM3 am 27. Oktober 2026 auf den Markt, und es handelt sich um eine andere Art von Modellveröffentlichung. Statt eines riesigen Flaggschiffs ist LFM3 eine Familie von sechs Openweight-Modellen in der 2B-Parameterklasse, die alle aus demselben 1,7-Milliarden-Backbone stammen. Text-, Vision-, Audio-, Omni- und zwei Entscheidungsmodelle teilen sich eine Architektur, sodass ein Team die benötigte Modalität wählen kann, ohne für jedes einen neuen Stack zu lernen. Der Pitch ist keine rohe Leistung. Es ist Footprint: ein leistungsfähiges kleines Modell, das auf Handys, Laptops, einem Raspberry Pi 5 und Edge-Hardware läuft und auf einer einzigen GPU fein abgestimmt werden kann.
Das Timing ist entscheidend. Frontier-Modelle werden immer größer und teurer im Betrieb, während die meisten echten Geschäftsaufgaben – das Lesen eines Dokuments, das Überprüfen eines Fotos, das Beantworten eines Sprachbefehls oder das Bewerten einer Liste von Optionen – kein riesiges Modell benötigen. Sie brauchen ein kleines, schnelles, privates Modell, das dort läuft, wo die Daten bereits sind. LFM3 ist Liquid AIs Wette, dass hier die nächste Welle der KI-Implementierung stattfindet: auf dem Gerät, vor Ort und in unternehmensgesteuerten Systemen.
Das schnelle Urteil
| Frage | Antwort |
|---|---|
| Was ist das? | LFM3, eine Familie von sechs offenen 2B-Klasse-Modellen von Liquid AI |
| Stapellauf | 27. Oktober 2026 |
| Gemeinsames Rückgrat | LFM3-1.7B-Base, 1.73B Parameter |
| Kontext | 256K-Token auf der Modellkarte (gehostete API listet 128K, siehe Preishinweis unten) |
| Trainingsdaten | 22T-Tokens des Vortrainings |
| Grundfläche | Etwa 1 GB Speicher bei 4-Bit-Präzision für das Textmodell |
| Lizenz | LFM Open License v1.0, Open-Weight |
| Verfügbar auf | Hugging Face, Liquid AI Playground, Liquid AI API, OpenRouter, Qualcomm AI Hub, Vercel |
| Am besten für | On-device-Agenten, Sehinspektion, Stimme und kalibrierte Entscheidungen |
| Nicht für | Starke agentische Codierung oder komplexes mehrstufiges Schließen (Liquid AI sagt das selbst) |
Die sechs Modelle, ein Rückgrat
Jedes LFM3-Modell zweigt von LFM3 bis 1.7B-Base ab. Dieses gemeinsame Backbone macht die Familie ungewöhnlich: eine Architektur, sechs Spezialisierungen.
| Modell | Eingänge | Ausgaben | Wofür es ist |
|---|---|---|---|
| LFM3-1.7B | Text | Text | Allgemeiner Text, Agenten, Werkzeugnutzung |
| LFM3-VL-2B | Text, Bilder, Video | Text | Seh- und Videoverständnis, Inspektion |
| LFM3-Audio-2B | Text oder Audio | Text oder Rede | Sprachbefehle, Transkription, Sprache |
| LFM3-Omni-2B | Text, Bilder, Video, Audio | Text und Rede | Vollwertige multimodale Assistenten |
| d1-2B | Fragen (Liste) | Kalibrierte Antworten | Entscheidungen mit Wahrscheinlichkeiten, nicht mit generiertem Text |
| d1-omni-2B | Multimodale Fragen | Kalibrierte Antworten | Entscheidungen, die auf Bildern, Audio und Dokumenten basieren |
Die Entscheidungsmodelle verdienen eine besondere Erwähnung, da sie anders funktionieren als ein normaler Chatbot. Anstatt einen Absatz zu generieren, beantwortet d1 eine ganze Liste von Fragen in einem einzigen Vorwärtsdurchgang, jede mit einer kalibrierten Wahrscheinlichkeit. Es kann auch getippte Antworten zurückgeben: auf ein Objekt zeigen, einen Wert aus einem Dokument ablesen, eine Zahl mit einem Bereich schätzen oder jede Option auswählen, die zutrifft. Für geschäftliche Arbeitsabläufe wie Triage, Bewertung und Routing ist diese strukturierte Ausgabe oft nützlicher als flüssige Prosa.
Im Rückgrat: eine Tri-Hybrid-Architektur
LFM3-1.7B-Base verfügt über 24 Schichten: 13 gated short Convolutions, fünf Sliding-Window-Aufmerksamkeitsschichten mit einem 256-Token-Fenster und sechs globale Aufmerksamkeitsschichten. Die Faltungen verwenden eine Kernelgröße von 7, gegenüber 3 in LFM2. Drei Änderungen definieren das Design: kopfweisen Gated Attention, die Aktivierungsausreißer unterdrücken kann, die die Quantisierung beeinträchtigen; partielle RoPE, bei der globale Aufmerksamkeitsschichten nur die höchstfrequente Hälfte jedes Kopfes rotieren; und eine Sandwich-Norm, die die Ein- und Ausgänge jedes Blocks normalisiert.
Liquid AI sagt, diese Architektur sei aus einer Hardware-in-the-Loop-Suche über 14 Geräte- und Backend-Kombinationen entstanden, darunter das Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI, Arm und x86 Cloud-CPUs, GPUs sowie die Qualcomm Hexagon NPU. Die praktischen Ergebnisse, alle vom Hersteller berichtet: LFM3-1.7B schlägt seinen Vorgänger LFM2.5-2.6B bei 35 Prozent weniger Parametern, läuft mit 8K-Token im Kontext etwa 25 Prozent schneller und dekodiert 1,8 bis 2,8-mal schneller als das nächste Modell bei den drei getesteten On-Device-Setups. Bei einem einzelnen NVIDIA B300 sagt Liquid AI, dass LFM3-1.7B 3,6 Milliarden Token pro Tag bei 1.024 gleichzeitigen Anfragen produzieren kann.
Das Vortraining lief auf 22T-Token, wobei die letzten 3,5T-Token eine mittlere Trainingsphase mit kuratierten Daten mit einem größeren Anteil an agentischen Traces und Tool-Calls bildeten, was das Kontextfenster ebenfalls auf 256K-Token erweiterte. Das Nachtraining erfolgte in vier Phasen: überwachtes Feinabstëmmung bei 1,75T-Tokens, gemischtes Reinforcement Learning, Multi-Domain-On-Policy-Destillation durch sechs spezialisierte Reinforcement-Learning-Lehrer und agentisches Reinforcement Learning in realen Agenten-Harnesses.
Benchmarks: stark bei Agenten und Tools, ehrlich bezüglich der Grenzen
Alle untenstehenden Benchmark-Zahlen werden von Liquid AI vom Anbieter berichtet, anhand seines Startposts und der Modellkarte. Behandeln Sie sie als eigene Messungen von Liquid AI, nicht als unabhängige Ergebnisse.
| Benchmark | LFM3-1.7B | Was es testet |
|---|---|---|
| LiveClaw | 45.60 | Agentische Aufgaben |
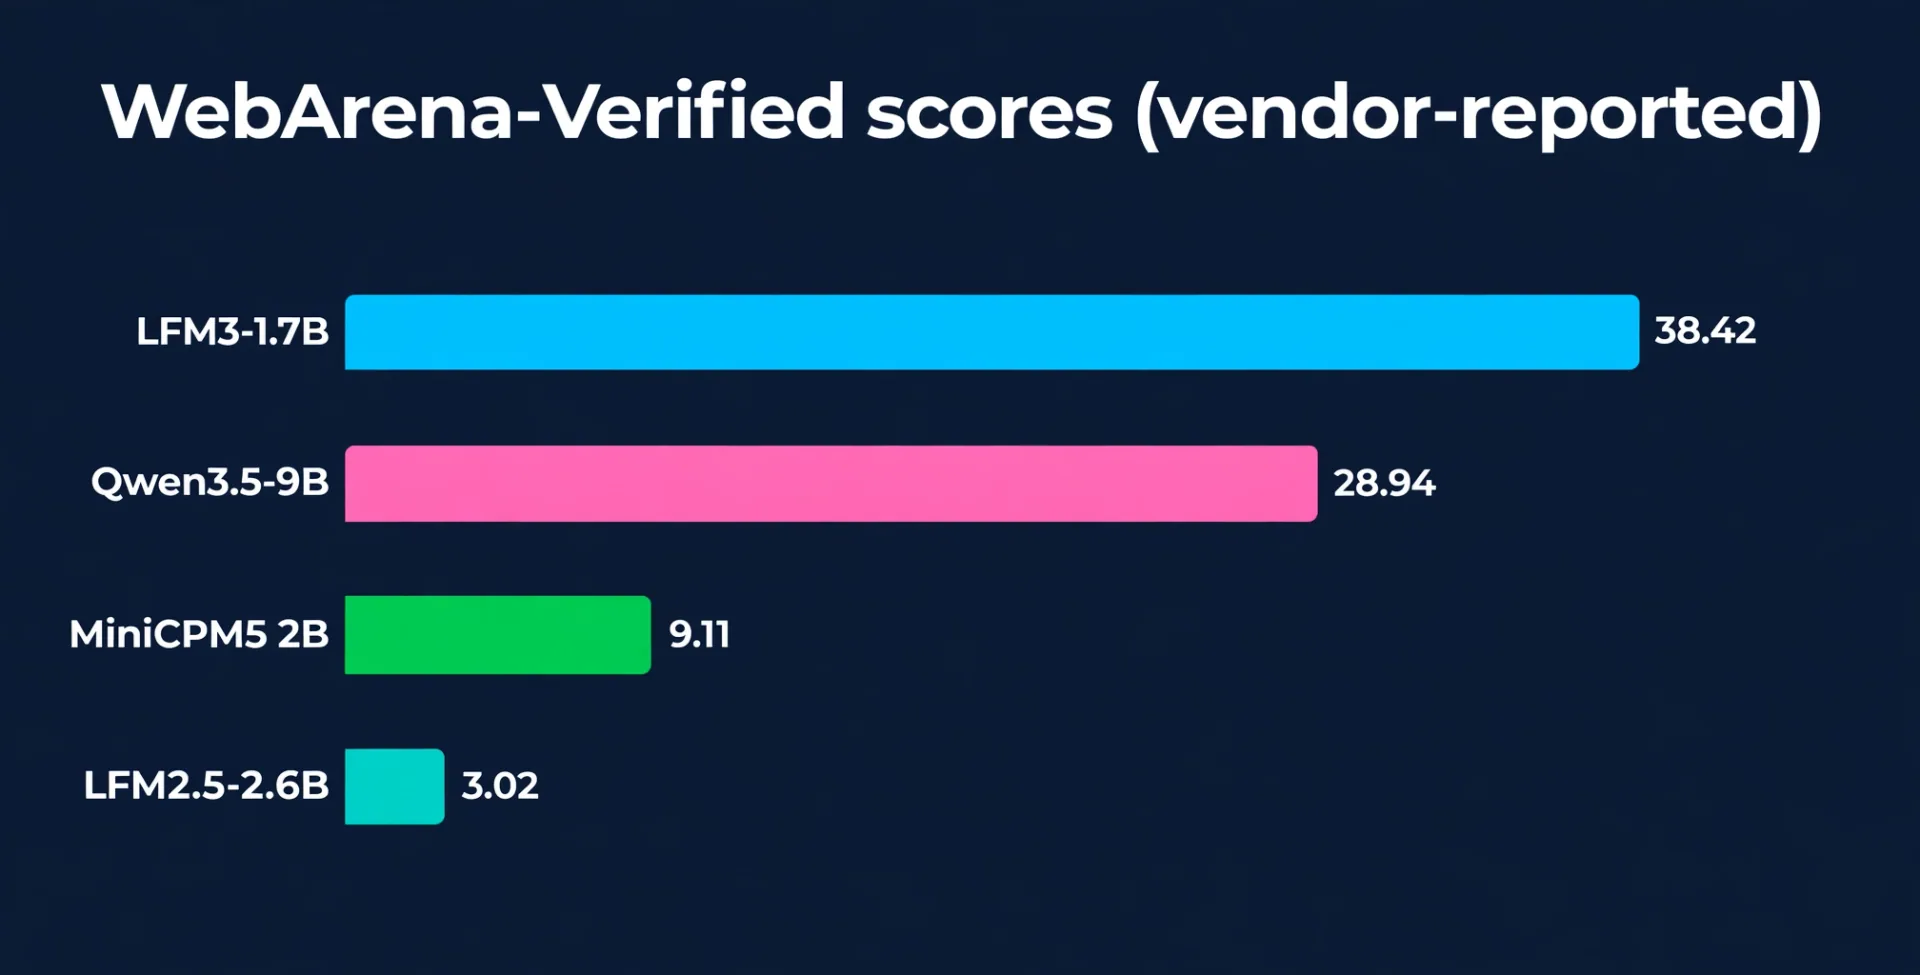
| WebArena-Verifiziert | 38.42 | Webagent-Aufgaben |
| BFCL V4 | 71.39 | Werkzeugruf |
| ToolSandbox | 80.36 | Werkzeugnutzung |
| IFEval | 96.66 | Anleitung zum Nachverfolgen |
| SWE-Bench Verifiziert | 43.40 | Agentische Codierung |
| GPQA Diamond | 63.37 | Fachwissen |
| Die letzte Prüfung der Menschheit (keine Werkzeuge) | 7.17 | Hartes Wissen |
Der Sprung zu WebArena-Verified ist die Überschrift: 38,42 für LFM3-1,7B gegenüber 3,02 für den Vorgänger LFM2.5-2.6B. Das ist eine echte Änderung der Art für ein 1,7B-Modell und passt zum Schwerpunkt auf agentisches Training. Aber dieselbe Tabelle zeigt die Grenzen: Ein 7,17 für Humanity's Last Exam ohne Werkzeuge ist schwach, und die eigene Modellkarte von Liquid AI besagt, dass das Modell wegen seiner geringen Größe nicht für agentisches Codieren oder komplexes mehrstufiges Denken empfohlen wird. Kleine Modelle sind ein Handel, kein kostenloses Mittagessen.
Die anderen Modalitäten haben ihre eigenen Zahlen. LFM3-VL-2B ist das erste LFM-Vision-Modell, das Videoeingabe akzeptiert, und Liquid AI berichtet, dass es den Durchschnitt über 62 Vision-Benchmarks von 57,6 auf 71,4 gegenüber LFM2.5-VL-3B erhöht, während 1,9B-Parameter gegenüber 3,1B verwendet werden. LFM3-Audio-2B unterstützt 18 Sprachen, mit einer Sprachqualität von 3,83 auf UTMOSv2 gegenüber 3,22 für seinen Vorgänger, der Zeit bis zum ersten Token so niedrig wie 50 ms und einer Sprachgenerierung in etwa 87-facher Echtzeit auf einem einzelnen CPU-Thread auf einem Apple M4 Max. LFM3-Omni-2B mit 2,2B-Parametern schlägt Modelle bis zu 10,7B auf den Audio-Visual-Understanding-Benchmarks Daily-Omni, WorldSense und AV-SpeakerBench. Das d1-2B-Entscheidungsmodell ersetzt d1-3B durch ein Drittel weniger Parameter und erzielt auf ImajevBench 75,5 gegenüber 64,0.
Preisgestaltung: Einige der günstigsten gehosteten Token gibt
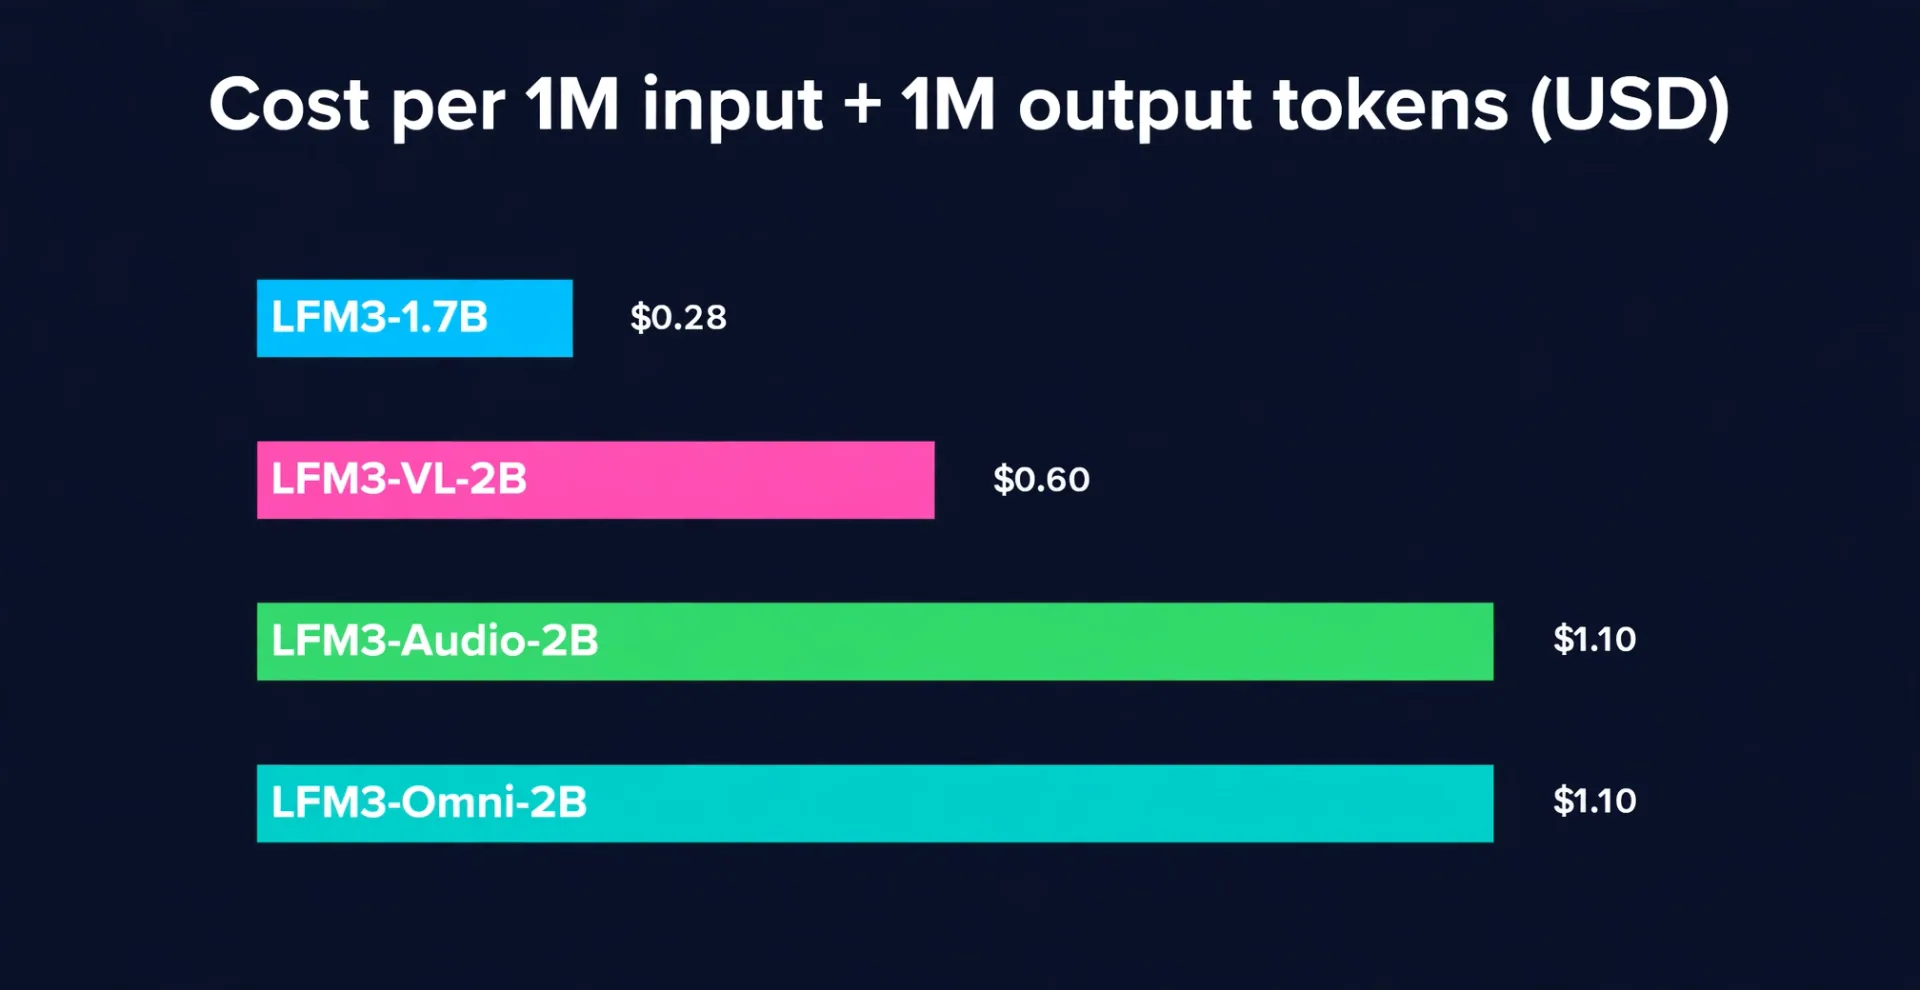
Die Hosting-API-Preise stammen aus dem Modellkatalog von Liquid AI, wie von VentureBeat berichtet. Die Preise liegen in USD pro Million Token.
| Modell | Eingabe | Zwischengespeicherte Eingabe | Ausgabe | 1M Eingang + 1M Ausgang |
|---|---|---|---|---|
| LFM3-1.7B | $0.08 | $0.02 | $0.20 | $0.28 |
| LFM3-VL-2B | $0.10 | $0.02 | $0.50 | $0.60 |
| LFM3-Audio-2B | $0.10 | $0.02 | $1.00 | $1.10 |
| LFM3-Omni-2B | $0.10 | $0.02 | $1.00 | $1.10 |
Audio-Token kosten bei den Audio- und Omni-Modellen extra: 2,00 $ pro Million Audio-Input-Token und 10,00 $ pro Million Audio-Output-Tokens. Zwei Dinge, die Sie vor dem Budget prüfen sollten: Die gehostete API nennt ein Kontextlimit von 128.000 Tokens, während die Modellkarte mit 256.000 Wörtern anwirbt, also bestätigen Sie, welches Limit für Ihre Bereitstellungsroute gilt. Und für datenschutzsensible Käufer gibt Liquid AI an, dass auf seinen gehosteten Modellen keine Datenspeicherung gilt: Das eingereichte Material wird zur Erfüllung von Anfragen verwendet und nicht gespeichert, protokolliert oder für Schulungen verwendet.
Zum Vergleich: Das Textmodell mit 0,28 $ pro Million Eingaben plus einer Million Ausgabetoken liegt weit unter der Flaggschiff-Kategorie. Das ist der Sinn dieser Klasse: Wenn man Millionen kleiner Aufgaben ausführt, entscheidet der Preis pro Token, ob das Produkt überhaupt lebensfähig ist. Wenn man die Preise für gehostete kleine Modelle allgemein vergleicht, zeigt unsere aktuelle Aufschlüsselung von GPT-6.1 Terra, wie OpenAI sein eigenes schnelles Mid-Tier-Modell bepreist, und unser Kimi K3.1 Pro-Beitrag behandelt einen weiteren Open-Weight-Start desselben Monats.
Welches Modell solltest du wählen?
Wählen Sie LFM3-1.7B für Textagenten, Dokumentenarbeit und Tool-Calling-Workflows, bei denen Kosten und Geschwindigkeit wichtiger sind als Frontier-Reasoning. Es ist die Standardwahl und die mit der größten Benchmark-Abdeckung.
Wählen Sie LFM3-VL-2B für alles, was Bilder oder Videos betrachtet: Qualitätskontrolle, Dokumentenlesung, Schadensbewertung, Regalkontrollen. Das eigene Beispiel von Liquid AI ist aufschlussreich: Das Feinabstimmen von VL-2B auf etwa 3.000 öffentlichen Windturbinenblättern für einige Stunden auf einem A100 erhöhte die Fehlerklassifizierungsgenauigkeit auf 67 Prozent. Das ist das Handbuch für kleine Modelle: Beginnen Sie mit einem ordentlichen allgemeinen Modell, optimieren Sie Ihre eigenen Bilder und setzen Sie auf Ihrer eigenen Hardware ein.
Wählen Sie LFM3-Audio-2B für Sprachschnittstellen, Anrufbearbeitung und Transkription, wo eine geringe Latenz wichtig ist. Eine 50-ms-Zeit bis zum ersten Token und die On-Geräte-Sprachgenerierung machen es zu einem Kandidaten für Kioske, Autos und Fabrikhallen ohne eine Rundreise in die Cloud.
Wählen Sie LFM3-Omni-2B , wenn ein einzelner Assistent Text, Bild, Video und Audio gemeinsam bearbeiten muss, zum Beispiel ein Außendiensthelfer, der die Maschine sieht, den Techniker hört und zurückspricht.
Wählen Sie d1-2B oder d1-omni-2B, wenn Sie Entscheidungen brauchen, nicht Prosa: Triage-Warteschlangen, Lead-Scoring, Content Routing oder jeder Workflow, bei dem eine kalibrierte Wahrscheinlichkeit und eine strukturierte Antwort einen Absatz schlagen. Das ist die unternehmensorientiertste Idee in der Familie und am wenigsten wie ein Chatbot.
Jedes LFM3-Modell kann auf einer einzigen GPU fein abgestimmt werden, mit veröffentlichten Notebooks für überwachte Feinabstimmung, DPO, GRPO und fortlaufendes Vortraining. Laufzeiten umfassen llama.cpp, MLX, vLLM, SGLang und Ollama, mit Checkpoint-Varianten in BF16, FP8, NVFP4, GGUF, MLX und ONNX. Day-0-Startpartner sind Ambarella, AMD, Arm, Intel über OpenVINO, NVIDIA, OpenRouter, Qualcomm und Vercel, und Liquid AI sagt, Mercedes-Benz und Shopify bei Pre-Release-Tests und -Bewertungen zusammengearbeitet.
Liquid AI adaptierte VL-2B außerdem in drei Robotikmodelle für Orchestrierung, Navigation und Manipulation und berichtete über einen durchschnittlichen Erfolg von 96,2 Prozent über die vier LIBERO-Suiten und 45,7 Prozent bei RoboCasa-GR1-Tabletop-Aufgaben, wobei Aktionsabschnitte auf einem Jetson AGX Orin in weniger als 50 ms generiert wurden. Robotik ist für ein 2B-Modell noch früh, aber die Latenzzahl ist der interessante Teil: Kleine Modelle können die Schleife schnell genug schließen, um eine echte Steuerung zu ermöglichen.
Die ehrlichen Grenzen
Kein 1.7B-Modell ersetzt ein Frontier-Modell, und LFM3 tut es auch nicht so. Wissensintensive Fragen, harte Mathematik und lange, mehrstufige Argumentation sind Schwachstellen, und die eigene Anleitung von Liquid AI hält Nutzer von agentischer Codierung mit dieser Größenklasse ab. Wenn Ihre Aufgabe tiefgehende Forschung oder komplexe Planung erfordert, möchten Sie dennoch ein größeres Modell, möglicherweise mit LFM3, das die günstige, schnelle und volumenreiche Schicht darum herum übernimmt. Dieses geschichtete Setup mit kleinen Modellen am Rand und Frontier-Modellen für die harten Fälle ist auch der Grund, wie die meisten ernsthaften KI-Agentenentwicklungsprojekte tatsächlich gebaut werden. Wenn Sie ein solches System planen, baut unser Team Agenten auf diese Weise; sehen Sie, wie Sie eine KI-Automatisierungsagentur engagieren können , um zu prüfen, bevor Sie sich festlegen.
Ein weiterer Punkt, den du überprüfen solltest, ist die Lizenz. LFM3 wird unter der LFM Open License v1.0 als Open-Weight ausgeliefert, aber "Open"-Lizenzen unterscheiden sich in ihren kommerziellen Bedingungen, also lies den eigentlichen Lizenztext für deine Revenue Tier und den Anwendungsfall, bevor du ein kommerzielles Produkt darauf auslieferst.
FAQ
Was ist Liquid AI LFM3?
LFM3 ist eine Familie von sechs Openweight-KI-Modellen, die am 27. Oktober 2026 von Liquid AI eingeführt wurden. Alle sechs zweig aus demselben LFM3-1.7B-Basis-Backbone ab und decken Text, Vision, Audio, Omni und Entscheidungsfindung in der 2B-Parameterklasse ab.
Wie groß ist LFM3-1.7B wirklich?
Das Textmodell verfügt über 1,73 Milliarden Parameter, ein 256K-Token-Kontextfenster auf seiner Modellkarte und ein Vokabular mit 128.000 Tokens, das 16 Sprachen unterstützt. Bei 4-Bit-Präzision benötigt es etwa 1 GB Speicher, weshalb es auf Telefonen und kleinen Edge-Geräten laufen kann.
Kann LFM3 auf einem Handy laufen?
Ja, das ist das Designziel. Liquid AI hat es auf dem Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI und dem Qualcomm Hexagon NPU getestet und berichtet, dass es 1,8 bis 2,8 Mal schneller dekodiert als das nächste Modell bei seinen getesteten On-Device-Setups.
Wie viel kostet die LFM3-API?
Das Textmodell kostet 0,08 $ pro Million Eingabetokens, 0,02 $ zwischengespeichert und 0,20 $ pro Million Ausgabetoken, was 0,28 $ für eine Million Eingaben plus eine Million Ausgabetoken ergibt. Vision kostet 0,60 $ auf derselben Basis, Audio und Omni kosten 1,10 $ vor Audio-Token-Gebühren.
Ist LFM3 wirklich offen?
Die Gewichte sind Open-Weight unter der LFM Open License v1.0 und verfügbar auf Hugging Face, dem Liquid AI Playground und der Liquid AI API. Prüfen Sie die Lizenzbedingungen für Ihren kommerziellen Anwendungsfall, da Open-Weight-Lizenzen variieren.
Welches LFM3-Modell sollte ich wählen?
Wählen Sie 1,7B für Textagenten, VL-2B für Bilder und Video, Audio-2B für Sprache, Omni-2B für kombinierte multimodale Assistenten und d1-2B oder d1-omni-2B, wenn Sie kalibrierte Entscheidungen mit Wahrscheinlichkeiten statt generiertem Text benötigen.
Wie schneidet LFM3 im Vergleich zum Kimi K3.1 Pro oder GPT-6.1 Terra ab?
Sie richten sich an verschiedene Stufen. Kimi K3.1 Pro ist ein viel größeres offenes Modell, das nahe der Grenze ausgerichtet ist, und GPT-6.1 Terra ist OpenAI's gehostetes Mid-Tier-Computermodell. LFM3 ist kleiner, günstiger und darauf ausgelegt, auf dem Gerät zu laufen. Vergleiche sie mit deiner eigenen Aufgabe und Hardware, nicht mit einem einzelnen Benchmark, da verschiedene Benchmarks unterschiedliche Fähigkeiten messen.
Wo kann ich LFM3 ausprobieren?
Auf Hugging Face, dem Liquid AI Playground, der Liquid AI API und über Partner wie OpenRouter, Qualcomm AI Hub und Vercel.
Quellen: Liquid AI-Startbeitrag, Unite.AI Deckung über den Markteinführung, VentureBeat-Preisberichterstattung und die LFM3-1.7B-Modellkarte auf Hugging Face.
- liquid ai lfm3
- lfm3
- open weight models
- on-device ai
- liquid ai
- ai agents
- small language models