IA11 min di letturaDi JH Akash
Liquido AI LFM3 spiegato: 6 modelli a peso aperto 2B
Liquid AI ha lanciato LFM3 il 27 ottobre 2026: sei modelli open-weight di classe 2B da una backbone da 1,7 miliardi, contesto 256K, 1 GB a 4 bit, API da 0,08 dollari per 1 milione di token.
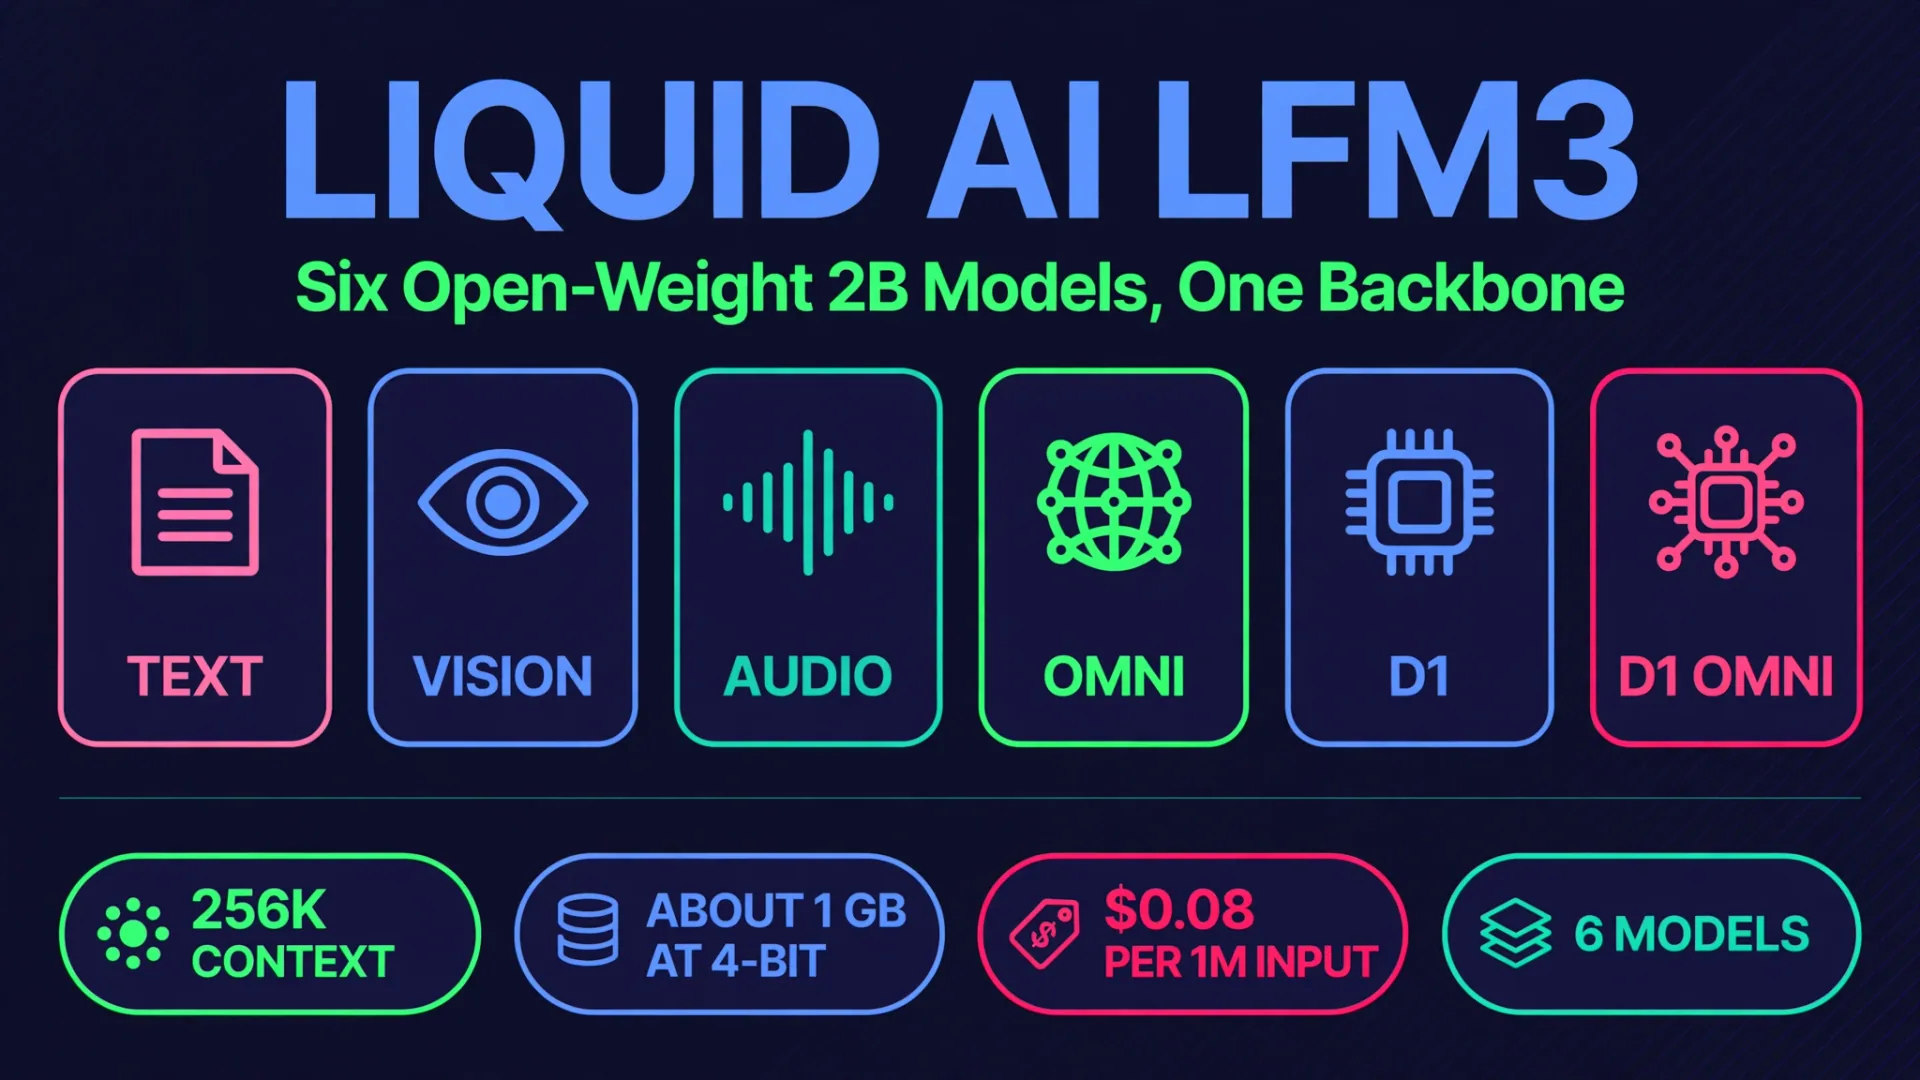
Liquid AI ha lanciato LFM3 il 27 ottobre 2026, ed è un tipo diverso di rilascio di modello. Invece di un unico grande modello di punta, LFM3 è una famiglia di sei modelli open-weight nella classe 2B parametri, tutti ramificati dalla stessa backbone 1,7B. Testo, visione, audio, omni e due modelli decisionali condividono una sola architettura, così un team può scegliere la modalità necessaria senza imparare uno stack nuovo per ciascuno. Il pitch non è potenza grezza. È l'impronta: un modello piccolo e capace che gira su telefoni, laptop, un Raspberry Pi 5 e hardware edge, e che può essere finemente calibrato su una singola GPU.
Il tempismo conta. I modelli frontier diventano sempre più grandi e costosi da gestire, mentre la maggior parte dei veri compiti aziendali, leggere un documento, controllare una foto, rispondere a comandi vocali, assegnare una lista di opzioni, non necessitano di un modello gigante. Hanno bisogno di un modello piccolo, veloce e privato che giri dove già si trovano i dati. LFM3 è la scommessa di Liquid AI che qui avverrà la prossima ondata di implementazione dell'IA: su dispositivo, in sede e all'interno dei sistemi controllati dall'azienda.
Il verdetto rapido
| Domanda | Risposta |
|---|---|
| Cos'è? | LFM3, una famiglia di sei modelli open-weight della classe 2B di Liquid AI |
| Lancio | 27 ottobre 2026 |
| Spina dorsale condivisa | LFM3-1.7B-Base, parametri 1.73B |
| Contesto | 256K token sulla scheda modello (l'API ospitata elenca 128K, vedi la nota prezzi qui sotto) |
| Dati di addestramento | Gettoni 22T di pre-addestramento |
| Impronta | Circa 1 GB di memoria con precisione a 4 bit per il modello di testo |
| Licenza | LFM Open License v1.0, open-weight |
| Disponibile su | Hugging Face, Liquid AI Playground, Liquid AI API, OpenRouter, Qualcomm AI Hub, Vercel |
| Il meglio per | Agenti on-device, ispezione visiva, voce e decisioni calibrate |
| Non per | Codifica agentica pesante o ragionamento complesso a più passi (lo dice Liquid AI stesso) |
I sei modelli, una spina dorsale
Ogni modello LFM3 si dirama da LFM3-1.7B-Base. Quella spina dorsale condivisa è ciò che rende la famiglia insolita: un'architettura, sei specializzazioni.
| Modello | Ingressi | Output | A cosa serve |
|---|---|---|---|
| LFM3-1.7B | Testo | Testo | Testo generale, agenti, uso degli strumenti |
| LFM3-VL-2B | Testo, immagini, video | Testo | Visione e comprensione video, ispezione |
| LFM3-Audio-2B | Testo o audio | Testo o discorso | Comandi vocali, trascrizione, parlato |
| LFM3-Omni-2B | Testo, immagini, video, audio | Testo e voce | Assistenti multimodali completi |
| d1-2B | Domande (elenco) | Risposte calibrate | Decisioni con probabilità, non testo generato |
| d1-omni-2B | Domande multimodali | Risposte calibrate | Decisioni basate su immagini, audio e documenti |
I modelli decisionali meritano una nota speciale perché funzionano in modo diverso rispetto a un chatbot normale. Invece di generare un paragrafo, d1 risponde a un'intera lista di domande in un unico passaggio in avanti, ognuna con una probabilità calibrata. Può anche restituire risposte tipizzate: puntare un oggetto, leggere un valore da un documento, stimare un numero con un intervallo o scegliere ogni opzione che si applica. Per i flussi di lavoro aziendali come triage, valutazione e instradamento, quell'output strutturato è spesso più utile della prosa fluente.
All'interno della spina dorsale: un'architettura tri-ibrida
LFM3-1.7B-Base ha 24 livelli: 13 convoluzioni brevi gate, cinque livelli di attenzione a finestra scorrevole con una finestra di 256 token e sei livelli di attenzione globale. Le convoluzioni utilizzano una dimensione kernel di 7, rispetto a 3 in LFM2. Tre cambiamenti definiscono il design: attenzione gateata a testa, che può sopprimere outlier di attivazione che danneggiano la quantizzazione; RoPE parziale, dove i livelli di attenzione globale ruotano solo la metà di frequenza più alta di ogni testa; e una norma sandwich che normalizza l'input e l'output di ogni blocco.
Liquid AI afferma che questa architettura è nata da una ricerca hardware-in-the-loop su 14 combinazioni di dispositivi e backend, tra cui Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI, CPU cloud Arm e x86, GPU e la NPU Qualcomm Hexagon. I risultati pratici, tutti riportati dai fornitori: LFM3-1,7B batte il suo predecessore LFM2.5-2,6B utilizzando parametri in meno del 35%, gira circa il 25% più velocemente con token 8K nel contesto e decodifica da 1,8 a 2,8 volte più velocemente rispetto al modello successivo sui tre sistemi testati da Liquid AI. Su un singolo NVIDIA B300, Liquid AI afferma che LFM3-1,7B può produrre 3,6 miliardi di token al giorno con 1.024 richieste contemporanee.
Il pre-addestramento è stato eseguito su token da 22T, con i token finali da 3,5T che hanno costituito una fase intermedia su dati curati con una quota maggiore di tracce agentiche e chiamate a strumenti, che hanno esteso anche la finestra di contesto a 256K token. Il post-addestramento si è svolto in quattro fasi: fine-tuning supervisionato su token 1,75T, apprendimento per rinforzo misto, distillazione multi-dominio on-policy da parte di sei insegnanti specialisti di reinforcement-learning e apprendimento per rinforzo agentico all'interno di real agent harnesses.
Benchmark: forte su agenti e strumenti, onesto sui limiti
Tutti i numeri dei benchmark qui sotto sono riportati dal fornitore da Liquid AI, dal suo launchpost e dalla scheda modello. Trattali come misurazioni personali di Liquid AI, non come risultati indipendenti.
| Benchmark | LFM3-1.7B | Cosa testa |
|---|---|---|
| LiveClaw | 45.60 | Compiti agentici |
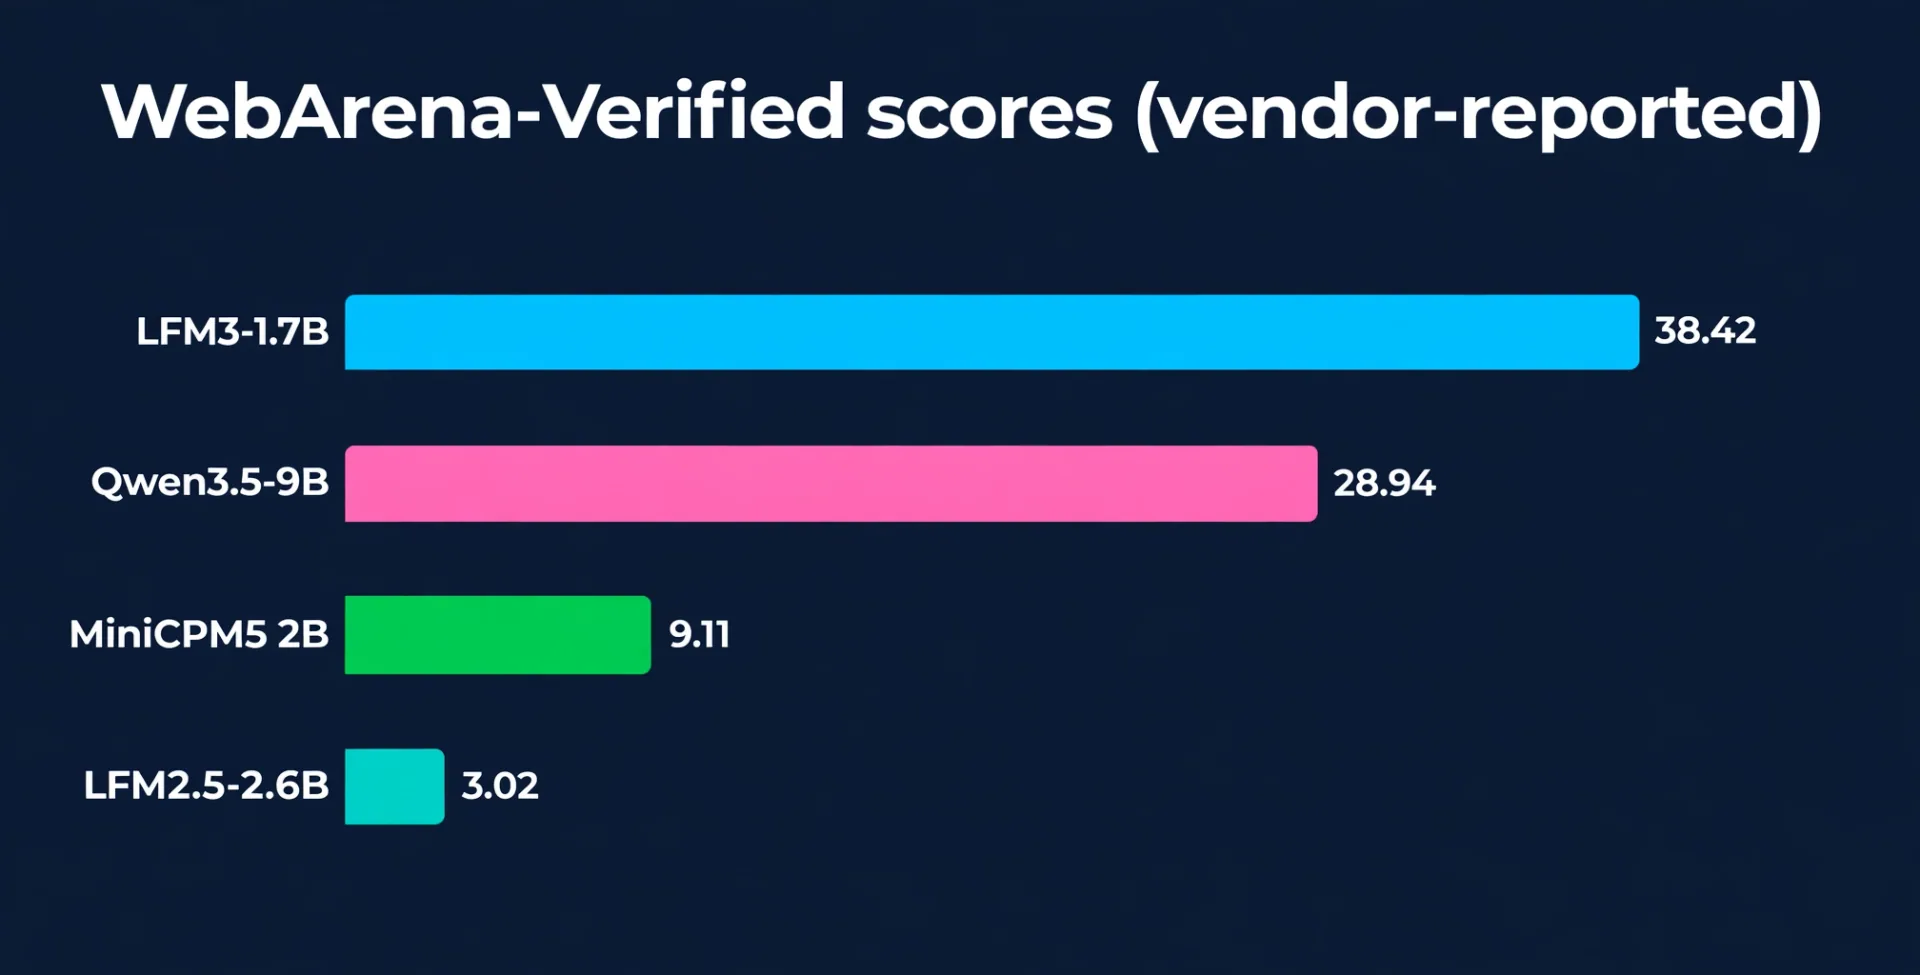
| WebArena-Verified | 38.42 | Compiti di agente web |
| BFCL V4 | 71.39 | Chiamata degli strumenti |
| Toolbox | 80.36 | Uso degli utensili |
| IFEval | 96.66 | Istruzioni successive |
| SWE-bench verificato | 43.40 | Codifica agentica |
| GPQA Diamond | 63.37 | Conoscenze esperte |
| L'ultimo esame dell'umanità (senza strumenti) | 7.17 | Conoscenza concreta |
Il salto su WebArena-Verified è il titolo: 38,42 per LFM3-1,7B contro 3,02 per il suo predecessore LFM2.5-2,6B. Questo è un vero cambiamento di natura per un modello 1,7B, e si allinea con l'enfasi sull'addestramento agentico. Ma la stessa tabella mostra i limiti: un 7,17 su Humanity's Last Exam senza strumenti è debole, e la scheda modello di Liquid AI afferma che il modello non è raccomandato per la codifica agentica o per ragionamenti complessi a più passi a causa delle sue dimensioni ridotte. I modelli piccoli sono uno scambio, non un pranzo gratuito.
Le altre modalità hanno i propri numeri. LFM3-VL-2B è il primo modello di visione LFM ad accettare input video, e Liquid AI riporta di aumentare la media su 62 benchmark di visione da 57,6 a 71,4 rispetto a LFM2,5-VL-3B, utilizzando parametri 1,9B contro 3,1B. LFM3-Audio-2B supporta 18 lingue, con qualità vocale di 3,83 su UTMOSv2 contro 3,22 del predecessore, tempo per il primo token fino a 50 ms e generazione vocale circa 87 volte in tempo reale su un singolo thread CPU su un Apple M4 Max. LFM3-Omni-2B, con parametri 2,2B, è riportato superare i modelli fino a 10,7B parametri nei benchmark audio-visivi Daily-Omni, WorldSense e AV-SpeakerBench. Il modello decisionale d1-2B sostituisce d1-3B con un terzo di parametri in meno e ottiene un punteggio di 75,5 contro 64,0 su ImajevBench.
Prezzi: alcuni dei token ospitati più economici in circolazione
La valutazione delle API ospitate proviene dal catalogo dei modelli di Liquid AI, come riportato da VentureBeat. I prezzi sono in USD per milione di token.
| Modello | Input | Input con cache | Produzione | 1M in ingresso + 1M in uscita |
|---|---|---|---|---|
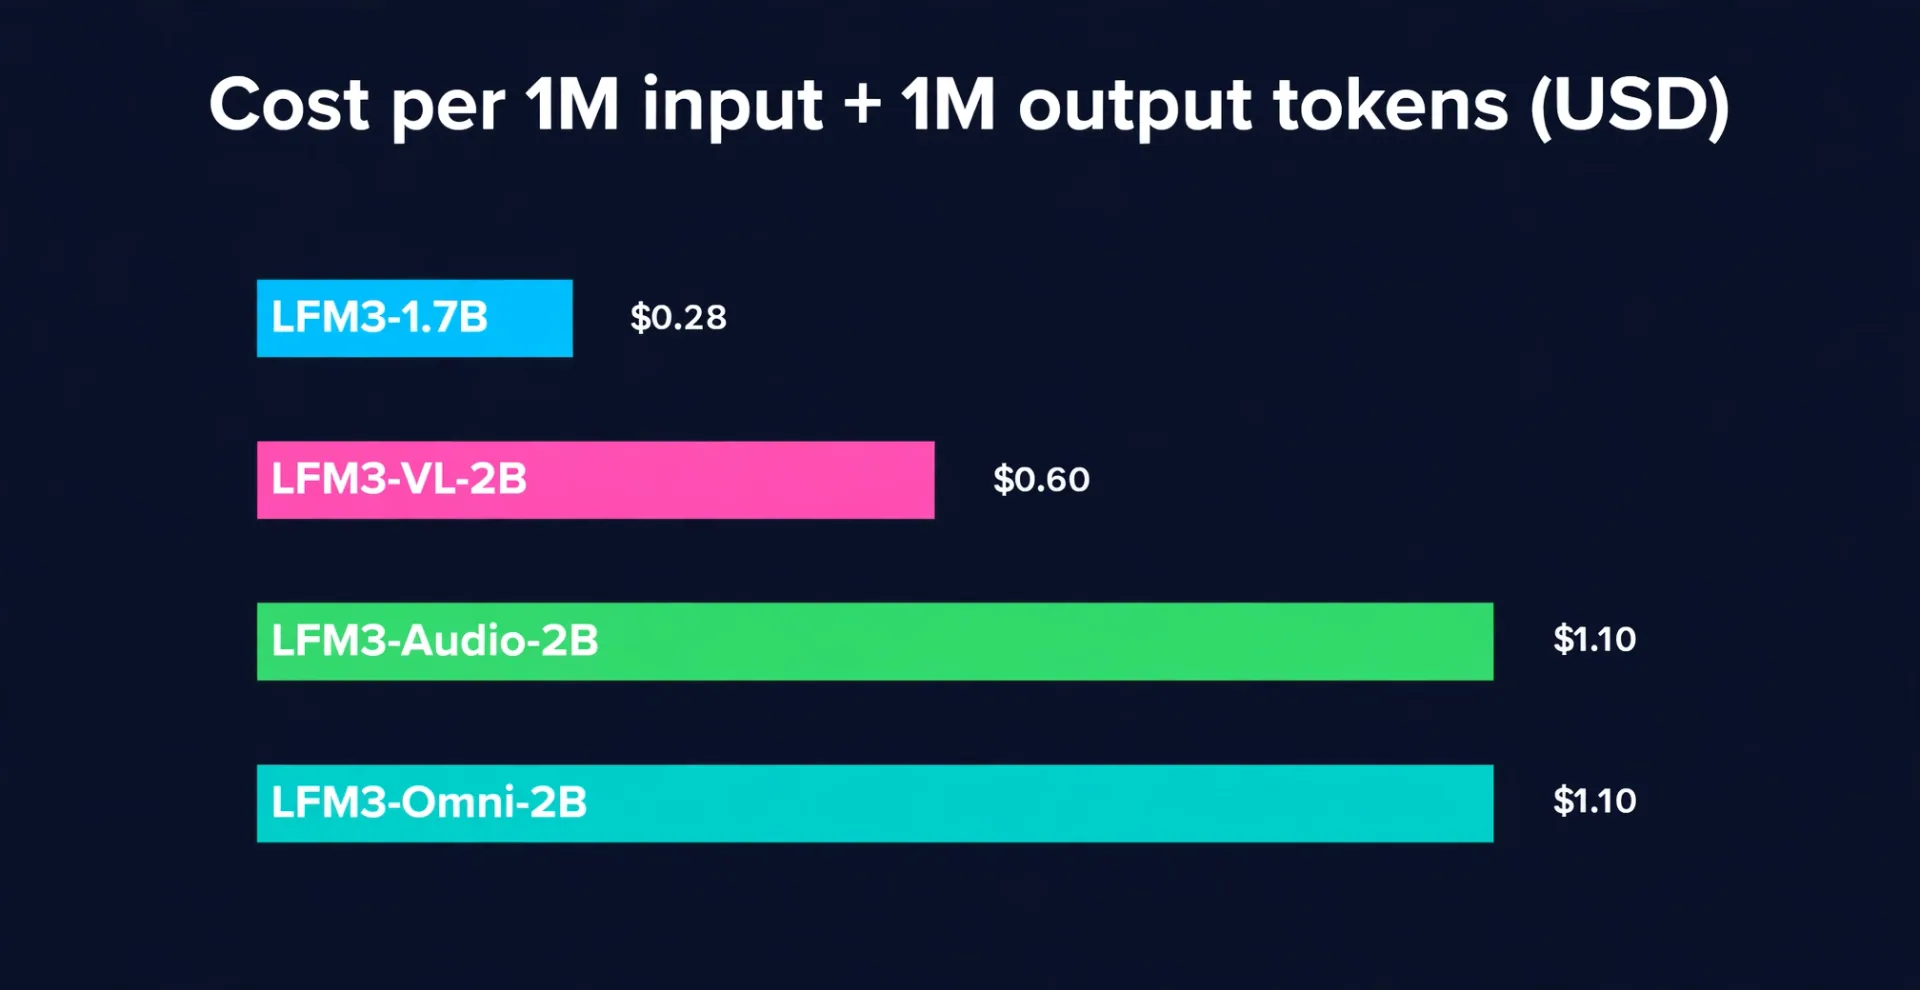
| LFM3-1.7B | $0.08 | $0.02 | $0.20 | $0.28 |
| LFM3-VL-2B | $0.10 | $0.02 | $0.50 | $0.60 |
| LFM3-Audio-2B | $0.10 | $0.02 | $1.00 | $1.10 |
| LFM3-Omni-2B | $0.10 | $0.02 | $1.00 | $1.10 |
I token audio costano un costo extra sui modelli Audio e Omni: 2,00 dollari per milione di token di ingresso audio e 10,00 dollari per ogni milione di token di uscita audio. Due cose da controllare prima di fare un budget: l'API ospitata indica un limite contestuale di 128.000 token, mentre la scheda modello pubblicizza 256K, quindi verifica quale limite si applica alla tua via di distribuzione. E per gli acquirenti sensibili alla privacy, Liquid AI dichiara zero ritenzione dati sui suoi modelli ospitati: il materiale inviato viene usato per soddisfare richieste e non viene trattenuto, registrato o usato per la formazione.
Per confronto, il modello di testo a 0,28 dollari per milione di input più un milione di token in output è molto al di sotto del livello di punta. Questo è il punto di questa classe: quando esegui milioni di piccoli compiti, il prezzo per token decide se il prodotto è effettivamente valido. Se confronti i prezzi dei piccoli modelli ospitati in modo più ampio, la nostra recente analisi di GPT-6.1 Terra mostra come OpenAI prezzi il proprio modello di fascia media veloce, e il nostro post su Kimi K3.1 Pro copre un altro lancio open-weight dello stesso mese.
Quale modello dovresti scegliere?
Scegli LFM3-1.7B per agenti di testo, lavoro documentale e flussi di lavoro di chiamata di strumenti dove costi e velocità contano più del ragionamento frontier. È la scelta predefinita e quella con la maggiore copertura di benchmark.
Scegli LFM3-VL-2B per tutto ciò che guarda immagini o video: ispezione di qualità, lettura di documenti, valutazione dei danni, controlli sugli scaffali. L'esempio di Liquid AI è significativo: mettere a punto VL-2B su circa 3.000 foto pubbliche di pale di turbine eoliche per alcune ore su un A100 ha aumentato la precisione della classificazione dei difetti al 67 percento. Questo è il manuale per i modelli piccoli: partire da un modello generale decente, ottimizzare le tue immagini, installare sul tuo hardware.
Scegli LFM3-Audio-2B per le interfacce vocali, la gestione delle chiamate e la trascrizione dove la bassa latenza conta. Un tempo di 50 ms per il primo token e la generazione vocale sul dispositivo la rendono candidata per chioschi, auto e stabilimenti senza dover andare e venire nel cloud.
Scegli LFM3-Omni-2B quando un singolo assistente deve gestire testo, immagine, video e audio insieme, ad esempio un assistente del servizio sul campo che vede la macchina, ascolta il tecnico e risponde.
Scegli d1-2B o d1-omni-2B quando hai bisogno di decisioni, non prosa: code di triage, lead scoring, routing dei contenuti o qualsiasi flusso di lavoro in cui una probabilità calibrata e una risposta strutturata battono un paragrafo. Questa è l'idea più orientata all'enterprise della famiglia, e la meno simile a un chatbot.
Ogni modello LFM3 può essere messo a punto su una singola GPU, con notebook pubblicati per la supervisione di fine-tuning, DPO, GRPO e pre-addestramento continuo. I runtime includono llama.cpp, MLX, vLLM, SGLang e Ollama, con varianti checkpoint in BF16, FP8, NVFP4, GGUF, MLX e ONNX. I partner per il lancio Day-0 includono Ambarella, AMD, Arm, Intel tramite OpenVINO, NVIDIA, OpenRouter, Qualcomm e Vercel, e Liquid AI, secondo Mercedes-Benz e Shopify collaborato per test e valutazioni pre-rilascio.
Liquid AI ha anche adattato VL-2B in tre modelli robotici per orchestrazione, navigazione e manipolazione, riportando un successo medio del 96,2% nelle quattro suite LIBERO e del 45,7% nei compiti da tavolo RoboCasa-GR1, con azioni generate in meno di 50 ms su un Jetson AGX Orin. La robotica è ancora agli inizi per un modello 2B, ma la parte interessante è il numero di latenza: i modelli piccoli possono chiudere il ciclo abbastanza velocemente da permettere un vero controllo.
I limiti onesti
Nessun modello 1.7B sostituisce un modello frontier, e LFM3 non finge di farlo. Domande basate sulla conoscenza, matematica complessa e ragionamento lungo a più passi sono punti deboli, e le direttive di Liquid AI sconsigliano gli utenti a evitare la codifica agentica con questa classe di dimensioni. Se il tuo compito richiede una ricerca approfondita o una pianificazione complessiva, vuoi comunque un modello più grande, magari con LFM3 che gestisce il livello economico, veloce e ad alto volume intorno ad esso. Quella configurazione stratificata, modelli piccoli al bordo e modelli frontier per i casi rigidi, è anche il modo in cui vengono effettivamente costruite la maggior parte dei progetti seri di sviluppo di agenti AI . Se stai pianificando questo tipo di sistema, il nostro team costruisce agenti in questo modo; vedi come assumere un'agenzia di automazione AI per sapere cosa controllare prima di impegnarti.
L'altra cosa da verificare è la licenza. LFM3 viene distribuita sotto la LFM Open License v1.0 come open-weight, ma le licenze "open" differiscono nei loro termini commerciali, quindi leggi il testo effettivo della licenza per il tuo livello di ricavo e il caso d'uso prima di spedire un prodotto commerciale su di esso.
Domande frequenti
Cos'è Liquid AI LFM3?
LFM3 è una famiglia di sei modelli di intelligenza artificiale open-weight lanciati da Liquid AI il 27 ottobre 2026. Tutti e sei si diramano dalla stessa backbone LFM3-1.7B-Base e coprono testo, visione, audio, omni e decision-making, nella classe dei parametri 2B.
Quanto è davvero grande LFM3-1.7B?
Il modello di testo ha parametri di 1,73B, una finestra di contesto di 256K token sulla scheda modello e un vocabolario di 128.000 token, con supporto per 16 lingue. Con una precisione a 4 bit richiede circa 1 GB di memoria, motivo per cui può funzionare su telefoni e dispositivi edge piccoli.
LFM3 può funzionare su un telefono?
Sì, questo è l'obiettivo di design. Liquid AI lo ha testato su Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI e Qualcomm Hexagon NPU, e riporta che decodifica da 1,8 a 2,8 volte più velocemente rispetto al modello successivo sui suoi configurazioni testate sul dispositivo.
Quanto costa l'API di LFM3?
Il modello di testo costa 0,08 dollari per milione di token di ingresso, 0,02 dollari in cache e 0,20 dollari per milione di token in uscita, il che corrisponde a 0,28 dollari per un milione di token in ingresso più un milione di token in uscita. Vision costa 0,60 dollari sulla stessa base, mentre Audio e Omni costano 1,10 dollari prima che i token audio addebitino.
LFM3 è davvero aperto?
I pesi sono a peso aperto secondo la LFM Open License v1.0 e disponibili su Hugging Face, Liquid AI Playground e Liquid AI API. Controlla i termini di licenza per il tuo caso d'uso commerciale, poiché le licenze per i pesi aperti variano.
Quale modello LFM3 dovrei scegliere?
Scegli 1.7B per gli agenti di testo, VL-2B per immagini e video, Audio-2B per la voce, Omni-2B per assistenti multimodali combinati e d1-2B o d1-omni-2B quando hai bisogno di decisioni calibrate con probabilità invece che testo generato.
Come si confronta LFM3 con Kimi K3.1 Pro o GPT-6.1 Terra?
Puntano a livelli diversi. Kimi K3.1 Pro è un modello open molto più grande e orientato verso la frontiera, e GPT-6.1 Terra è il modello di uso medio ospitato da OpenAI per computer. LFM3 è più piccolo, economico e progettato per funzionare su un dispositivo. Confrontali con il tuo compito e hardware, non su un singolo benchmark, poiché benchmark diversi misurano competenze diverse.
Dove posso provare LFM3?
Su Hugging Face, il Liquid AI Playground, l'API Liquid AI e attraverso partner come OpenRouter, Qualcomm AI Hub e Vercel.
Fonti: post di lancio di Liquid AI, copertura Unite.AI lancio, copertura dei prezzi VentureBeat e la scheda modello LFM3-1.7B su Hugging Face.
- liquid ai lfm3
- lfm3
- open weight models
- on-device ai
- liquid ai
- ai agents
- small language models