IA5 min di letturaDi JH Akash
Spiegazione dell'API OpenAI Decisions: cosa significa GA per gli agenti AI
OpenAI ha reso la sua API Decisions generalmente disponibile il 22 ottobre 2026. Alimentata da GPT-6 Luna, restituisce probabilità, scelte e punteggi fino a 10 volte più veloci, con un prezzo da $0,10 per ogni token da 1M. Prezzi, benchmark e quando utilizzarlo.
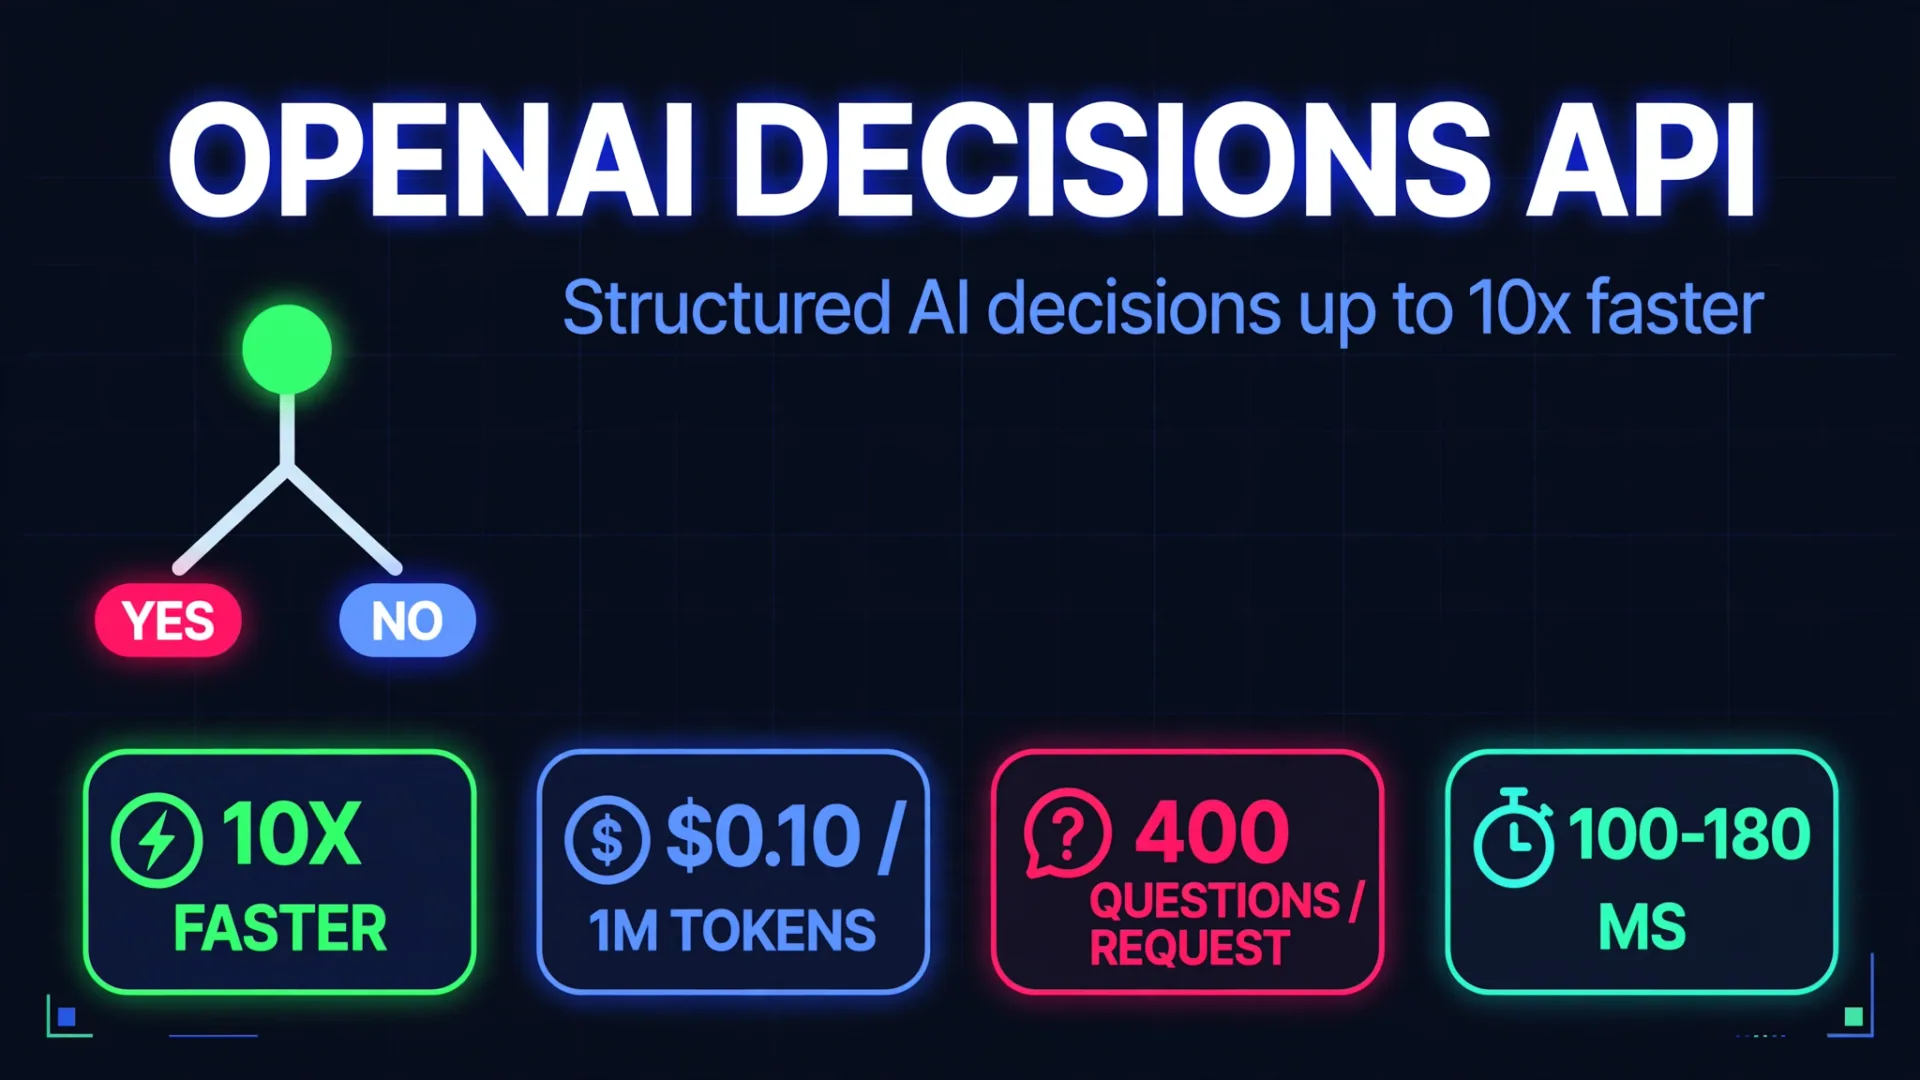
OpenAI ha reso la sua API Decisions generalmente disponibile, un'interfaccia per sviluppatori alimentata da GPT-6 Luna che restituisce probabilità, scelte e punteggi invece che paragrafi di testo. OpenAI afferma di poter fornire queste decisioni fino a 10 volte più velocemente rispetto a GPT-6 Luna tramite l'API Response, con un prezzo degli input che parte da 0,10 dollari per 1 milione di token. Ecco cosa è cambiato nel rilascio GA del 22 ottobre 2026, quanto costa e se la tua app dovrebbe utilizzarlo.
Il verdetto rapido: API Risposte vs API Decisioni
| Aspetto | API Risposte | Decisions API |
|---|---|---|
| Produzione | Testo aperto | Probabilità, scelta o punteggio |
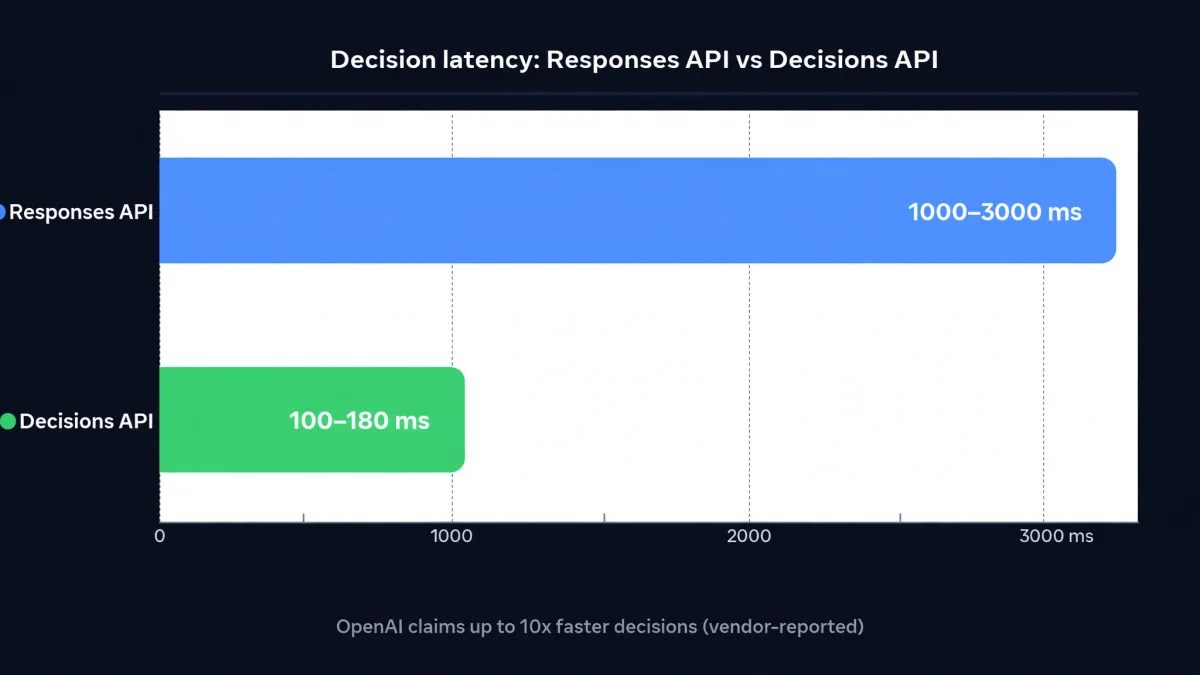
| Latenza tipica delle decisioni | 1 a 3 secondi | 100-180 ms (riportato dal fornitore) |
| Prezzo degli input | Velocità standard di Luna per GPT-6 | $0,10 per ogni token di input da 1M |
| Il meglio per | Ragionamento, spiegazione, uso degli strumenti | Classificazione ad alto volume, instradamento, punteggio |
Cosa è cambiato nella versione GA (22 ottobre 2026)
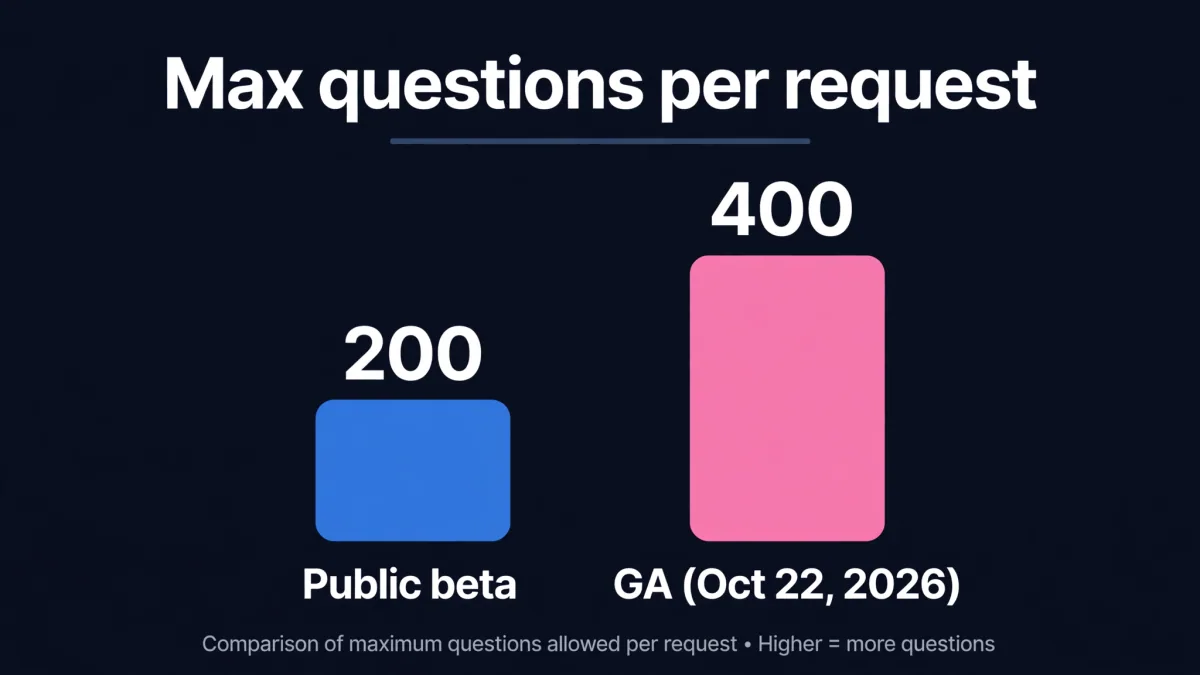
L'API Decisions aveva già avuto una beta pubblica prima dell'annuncio di GA, e la versione generalmente disponibile raddoppia il limite di chiavi e aggiunge funzionalità di produzione:
- 400 domande per richiesta, rispetto alle 200 della beta pubblica
- Prompt caching, con input nella cache prezzato a $0,01 per 1M token
- Integrazione nativa GPT-Live, così le app vocali live possono attivare decisioni man mano che arrivano le trascrizioni
- Input JSON strutturato, più immagini all'interno di istruzioni testuali o istruzioni individuali per domande
- Residenza per inferenza negli Stati Uniti e nell'UE, con Zero Data Retention disponibile per i clienti idonei
- Un endpoint dedicato
/v1/decisionse un Giochi delle Decisioni per sperimentare prima dell'integrazione
Come funziona: i tre tipi di decisione
Gli sviluppatori forniscono tre cose: le informazioni da valutare, le domande a cui rispondere e il formato di output consentito. L'API supporta tre tipi di decisione.
| Tipo di decisione | Cosa restituisce | Esempio |
|---|---|---|
| Predicato | Probabilità che una condizione sia vera | Stima se un pacco appare danneggiato |
| Scelta | Una selezione tra opzioni predefinite | Instrada un ticket di supporto al supporto di fatturazione o tecnico |
| Punteggio | Punteggio contro i livelli ordinati | Valuta un problema come minore, moderato o grave |
Per le domande di scelta e punteggio, l'API restituisce anche informazioni di probabilità e una misura di confidenza, così i team possono automatizzare casi fiduciosi e inviare quelli incerti a un revisore umano. Una risposta strutturata non garantisce una decisione corretta: sia OpenAI che i suoi clienti sottolineano che gli sviluppatori devono testare le loro domande, misurare l'accuratezza e stabilire soglie sensate.
Prezzi
| Componente | Prezzo |
|---|---|
| Input non memorizzato nella cache | $0,10 per ogni token da 1M |
| Input con cache | $0,01 per 1M di gettoni |
| Token di output | Nessuna carica separata per token di uscita |
Le scritture di cache, i premi di elaborazione regionale e le regole di pricing a lungo contesto possono influenzare la bolletta finale, quindi consulta la guida ufficiale ai prezzi prima di stimare i costi di produzione.
La storia della velocità, in numeri
Il responsabile prodotto API di OpenAI, Nikunj Handa, ha detto a TechCrunch che l'azienda ha ridotto i tempi di risposta alle decisioni da uno a tre secondi a circa 100-180 millisecondi. OpenAI sostiene che l'API possa essere fino a 10 volte più veloce di GPT-6 Luna tramite l'API Responses, e ritiene che ulteriori ottimizzazioni possano raggiungere circa 60 millisecondi.
I primi clienti hanno pubblicato i propri risultati. Trattali come benchmark riportati dai clienti, non come benchmark indipendenti:
| Azienda | Risultato riportato |
|---|---|
| Scatola | Selezione delle rotte circa 5 volte più veloce su 30 certificati assicurativi, con una precisione corrispondente all'approccio Responses API |
| Datadog | Latenza al 95° percentile 40 volte superiore per un flusso di lavoro di valutazione a rischio di comando rispetto ai modelli frontier disponibili |
| Parla | Il tempo tra le azioni dell'IA è sceso da 1,4 secondi a 0,13 secondi, un miglioramento di oltre il 90 percento |
Anche la concorrenza si sta spostando
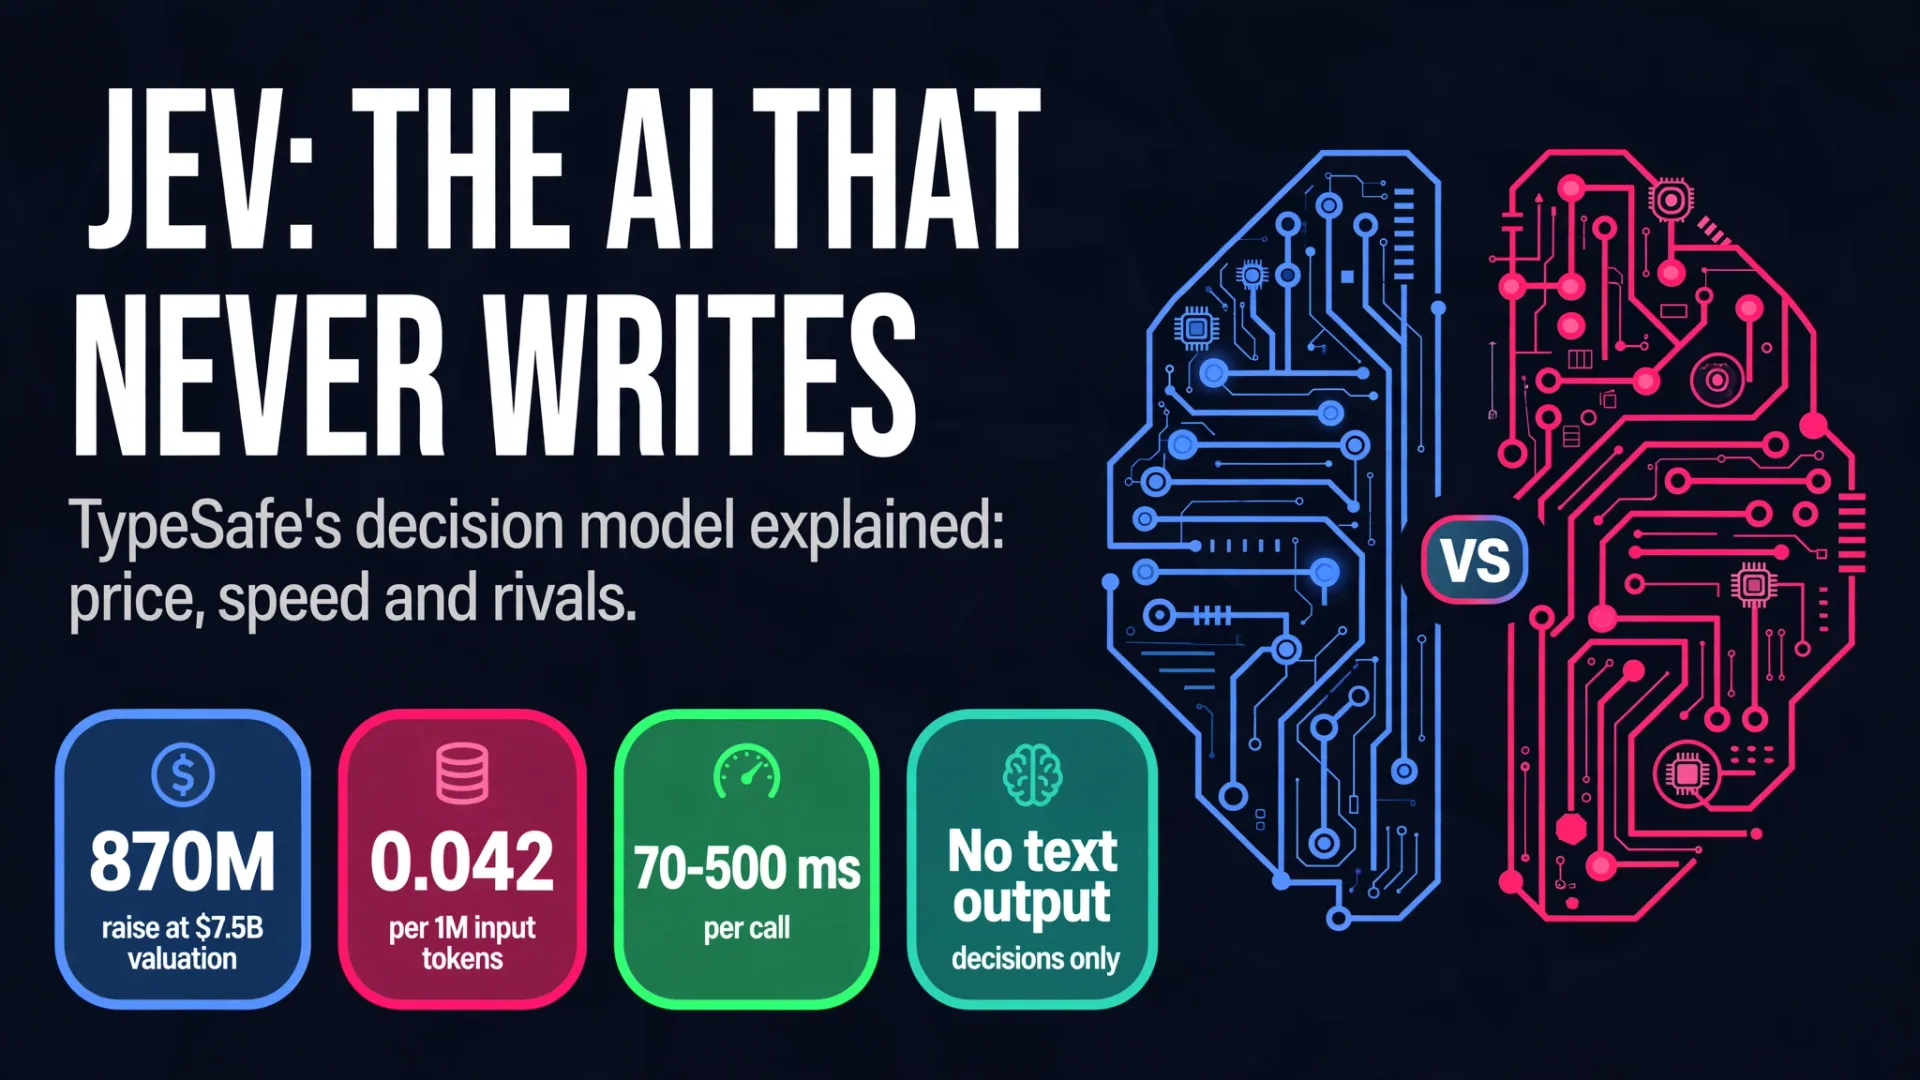
OpenAI non è l'unico nella corsa al modello decisionale. TypeSafe, la startup dietro il modello decisionale Jev, ha recentemente raggiunto una valutazione di circa 7,6 miliardi di dollari e ha ampliato Jev con supporto a immagini e decisioni condizionate. Liquid (D1 Ultra) e Base Lab (Elephant-1) stanno anch'essi distribuendo modelli concorrenti. In due benchmark decisionali pubbliche riportati nella copertura del lancio, TypeSafe Jev si è classificato 7° e 3° mentre il modello decisionale di OpenAI si è classificato all'8° e 14° posto. Le classifiche cambiano man mano che i benchmark si aggiornano, quindi trattateli come istantanee, non come un verdetto finale.
Quale dovresti usare?
Usa l'API Decisions quando il tuo carico di lavoro è ad alto volume, ripetibile e sensibile alla latenza: classificando le transazioni, instradando ticket di supporto, valutando il rischio o decidendo la prossima azione di un agente AI. Rimani con l'API Responses quando hai bisogno di spiegazioni, generazione aperta, catene di ragionamento o uso flessibile. Molti sistemi di produzione utilizzano entrambi, con le decisioni gestite dall'API Decisions e tutto il resto sull'API Responses.
Se stai costruendo flussi di lavoro per agenti, questo è esattamente il tipo di impianto idraulico che conta. CodeMyPixel costruisce soluzioni di sviluppo di agenti AI personalizzate e sistemi completi di automazione AI per team che necessitano di modelli che svolgano lavoro reale, non solo generare testo. Per il contesto del modello, consulta le nostre analisi di GPT-6 Astra e Claude Opus 5.5.
Domande frequenti
Cos'è l'API Decisions di OpenAI?
Un'interfaccia per sviluppatori che utilizza GPT-6 Luna per valutare testo, immagini e dati strutturati, restituendo probabilità, scelte predefinite o punteggi su cui le applicazioni possono agire direttamente.
L'API Decisions è davvero dieci volte più veloce?
OpenAI afferma che può essere fino a 10 volte più veloce di GPT-6 Luna tramite l'API Response. Questo è un massimo riportato dal fornitore, non una garanzia. La latenza effettiva dipende dalla dimensione dell'input, dalla complessità della domanda, dalle condizioni di rete e dal carico di lavoro. I risultati riportati dai clienti (Box a 5x, Datadog a 40x p95, Speak che taglia da 1,4s a 0,13s) sono specifici per le loro valutazioni.
Quanto costa l'API Decisions?
Il prezzo base pubblicato è di 0,10 $ per ogni token di input non memorizzato da 1 milione di cache e di 0,01 dollari per ogni token di input memorizzato in cache, senza alcun costo separato per token di output. Le scritture di cache e i premi regionali possono aggiungere costo.
L'API Decisions può sostituire l'API Response?
Non per ogni compito. È progettata per una classificazione, selezione e punteggio mirati. L'API Risposte rimane la scelta giusta per la generazione di testo aperto, il ragionamento e i flussi di lavoro guidati dagli strumenti.
Quando è diventata l'API Decisions generalmente disponibile?
22 ottobre 2026, dopo una beta pubblica. La versione GA ha raddoppiato il limite di domande per richiesta da 200 a 400 e ha aggiunto la cache dei prompt, l'integrazione nativa GPT-Live e l'input JSON strutturato.
- openai decisions api
- gpt-6 luna
- ai agents
- openai api pricing
- llm latency