IA7 min di letturaDi JH Akash
Spiegazione del Kimi K3.1 Pro: il modello Open di Moonshot si avvicina alla frontiera
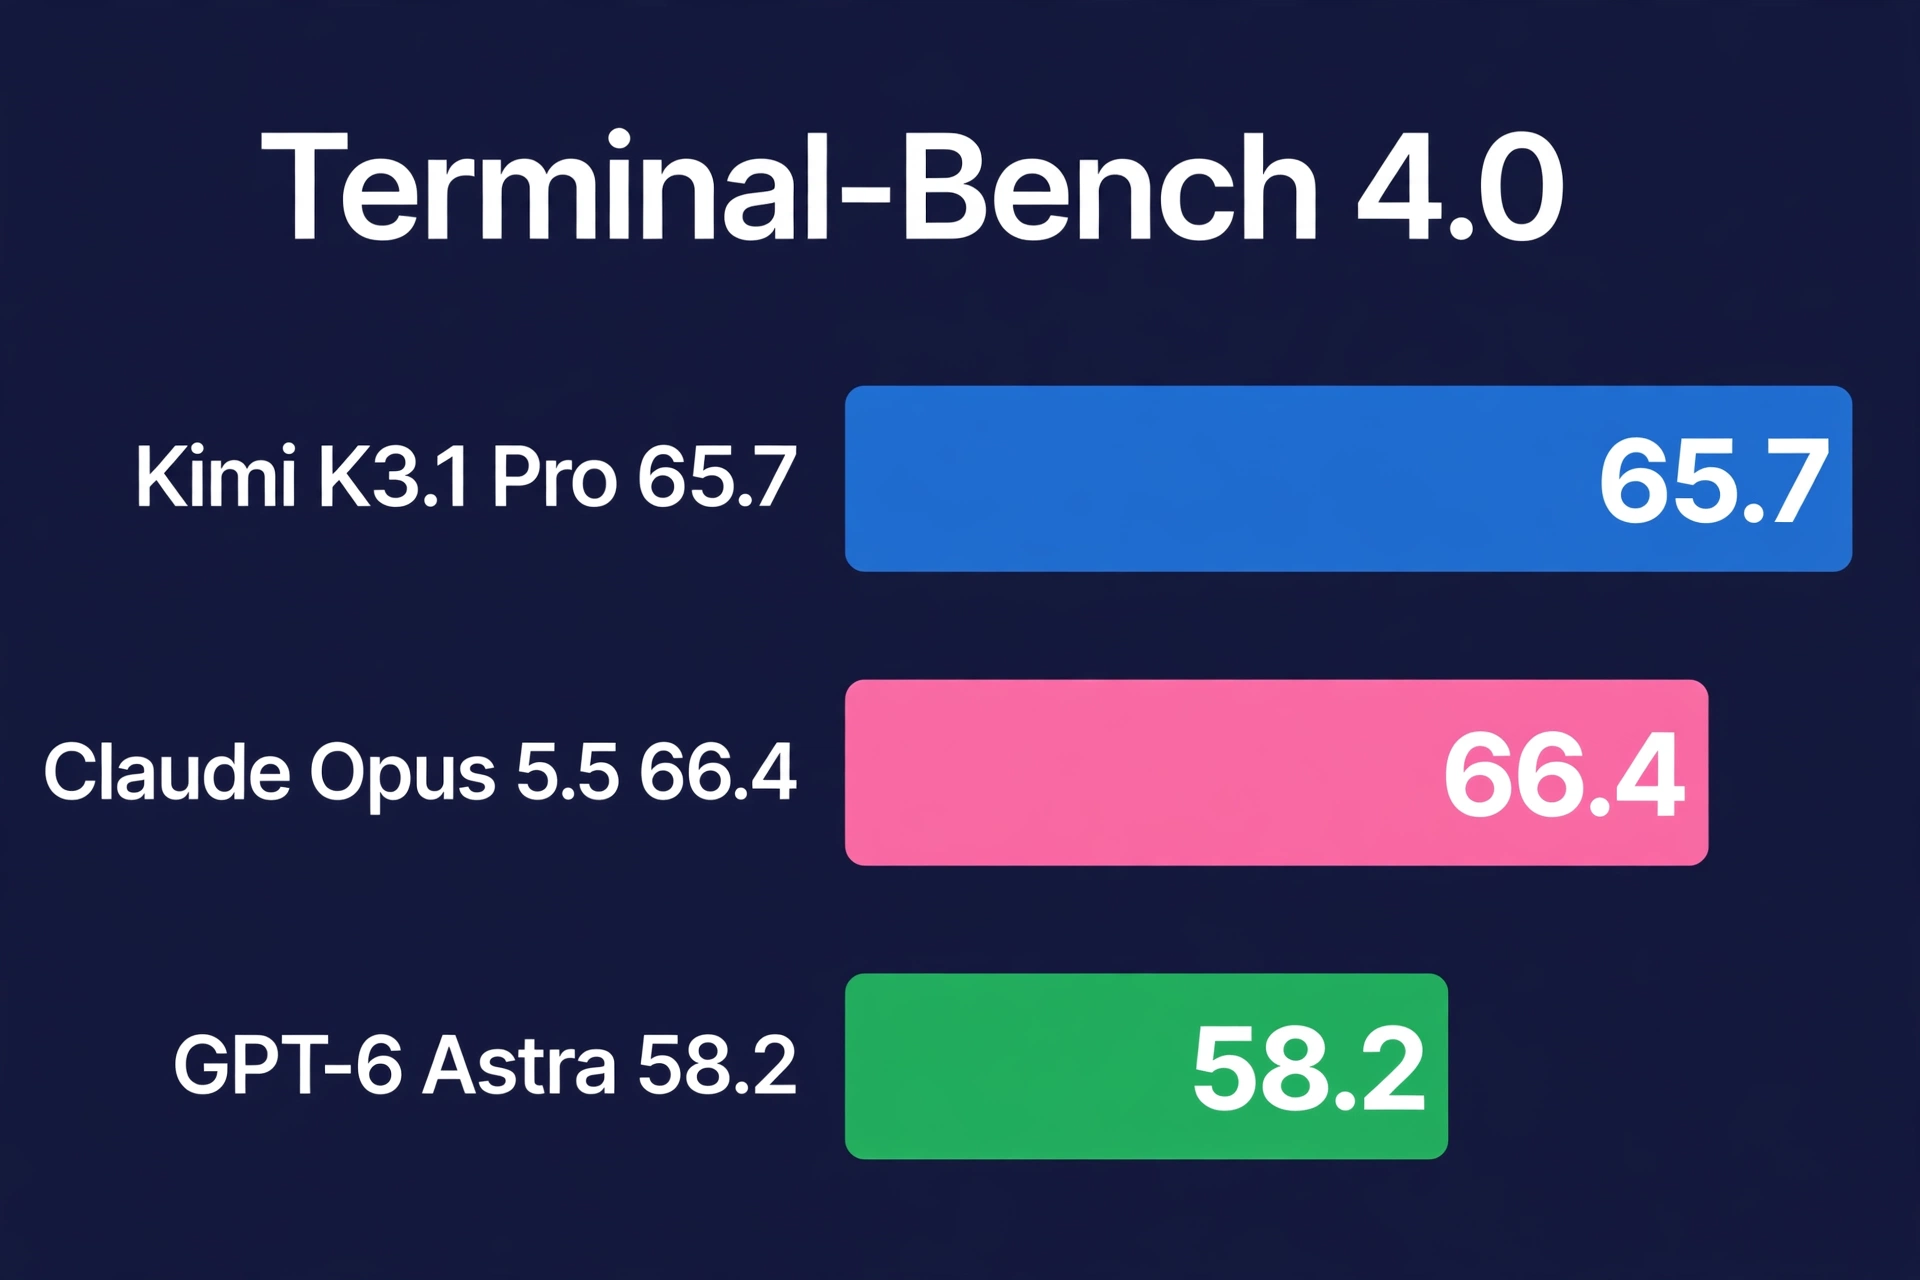
Moonshot ha lanciato Kimi K3.1 Pro il 23 ottobre 2026: un modello openweight da 2.8T, contesto 1M, 65.7 su Terminal-Bench 4.0, prezzo 2$2/$10 per token 1M, pesi previsti per il 4 novembre.
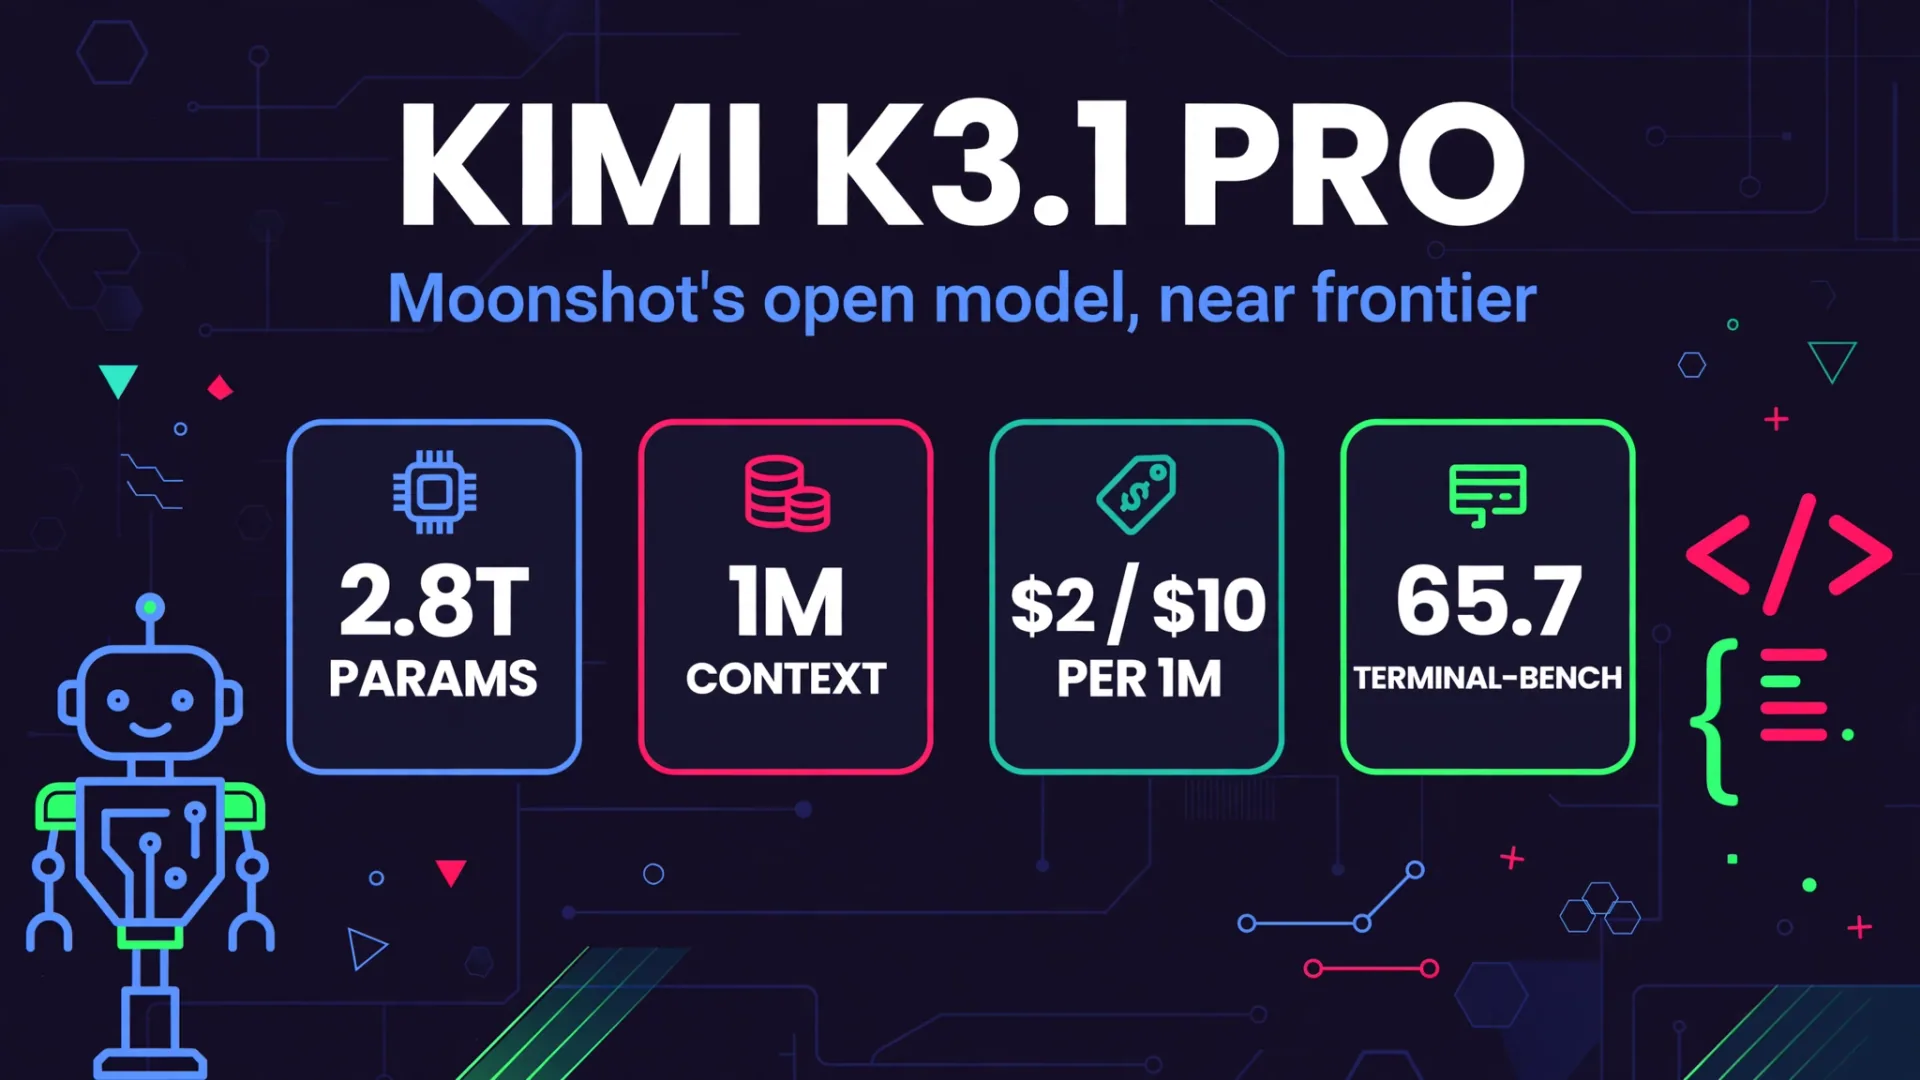
Moonshot AI ha lanciato Kimi K3.1 Pro il 23 ottobre 2026, ed è la prova più recente che il divario tra modelli a peso aperto e modelli frontier chiusi è ora molto piccolo. Non è un modello base completamente nuovo. Moonshot lo descrive come una versione post-addestrata di Kimi K3, spinta attraverso molto più apprendimento per rinforzo in centinaia di domini. Il risultato è un modello misto di esperti con circa 2,8 trilioni di parametri totali, 104 miliardi di utenti attivi per token e una finestra contestuale da 1 milione di token, con input di testo e immagini.
Ora è disponibile su Kimi.ai, Kimi Work, Kimi Code e l'API Kimi. Una variante complementare, Kimi K3.1 Pro Highspeed, promette le stesse capacità a 2-3 volte la velocità. I pesi completi del modello sono promessi entro il 4 novembre 2026, il che lo renderebbe il modello open-weight più forte nelle classifiche indipendenti, se questa classifica dovesse mantenersi. Fino ad allora, l'API è l'unico modo per farlo funzionare e i requisiti di licenza e hardware per l'auto-hosting sono ancora sconosciuti.
Il verdetto rapido: Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra
| Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| Terminal-Bench 4.0 (riportato dal fornitore) | 65.7 | 66.4 | 58.2 |
| Maratona SWE (segnalata dal fornitore) | 51.7 | 46.3 | 42.5 |
| Ultimo esame degli agenti (riportato dal fornitore) | 43.2 | 42.6 | 32.8 |
| Indice di Intelligenza per l'Analisi Artificiale | 55 | 58 | 53 |
| Finestra di contesto | 1M di gettoni | Non confrontato qui | Non confrontato qui |
| Prezzo di input API per 1M di token | $2 | $4 (riportato, tramite Highspeed match) | Non elencato in questo confronto |
| Pesi aperti | Promesso entro il 4 novembre 2026 | No | No |
Leggi attentamente la tabella. Kimi K3.1 Pro è dietro a Opus 5.5 di soli 0,7 punti su Terminal-Bench 4.0 ed è davanti a GPT-6 Astra nello stesso test, ma benchmark diversi misurano abilità diverse, quindi nessun singolo punteggio rende un modello il vincitore assoluto. La storia onesta è più ristretta: nei test di agenti di codifica, questo modello open-weight ora gioca nella stessa categoria del closed frontier.
Cosa è cambiato rispetto a Kimi K3
Kimi K3 è stato lanciato nel luglio 2026 come modello aperto di classe 3T. K3.1 Pro mantiene questa base e scala il post-addestramento invece di preaddestrare un nuovo modello da zero. Moonshot afferma di aver ottimizzato il suo framework di reinforcement learning, l'elaborazione a lungo contesto, l'efficienza dell'addestramento e l'infrastruttura. I vantaggi pratici si riflettono nel lavoro completo di progetto: codifica su un'intera base di codice, modellazione parametrica 3D in Blender e strumenti CAD, build di progetti completi in Unity, Unreal e Godot, e flussi di lavoro finanziari end-to-end.
Un'affermazione del fornitore merita un'etichetta chiara. Moonshot afferma che le allucinazioni nei compiti di modellazione finanziaria sono diminuite del 65% rispetto alla generazione precedente. Questa è una cifra riportata dal fornitore, non un risultato verificato indipendentemente, quindi trattala come una dichiarazione da testare sui tuoi compiti finanziari, non come una garanzia.
Prezzi
| Modello | Input per 1M di token | Output per token da 1M | Input nella cache per 1M di token |
|---|---|---|---|
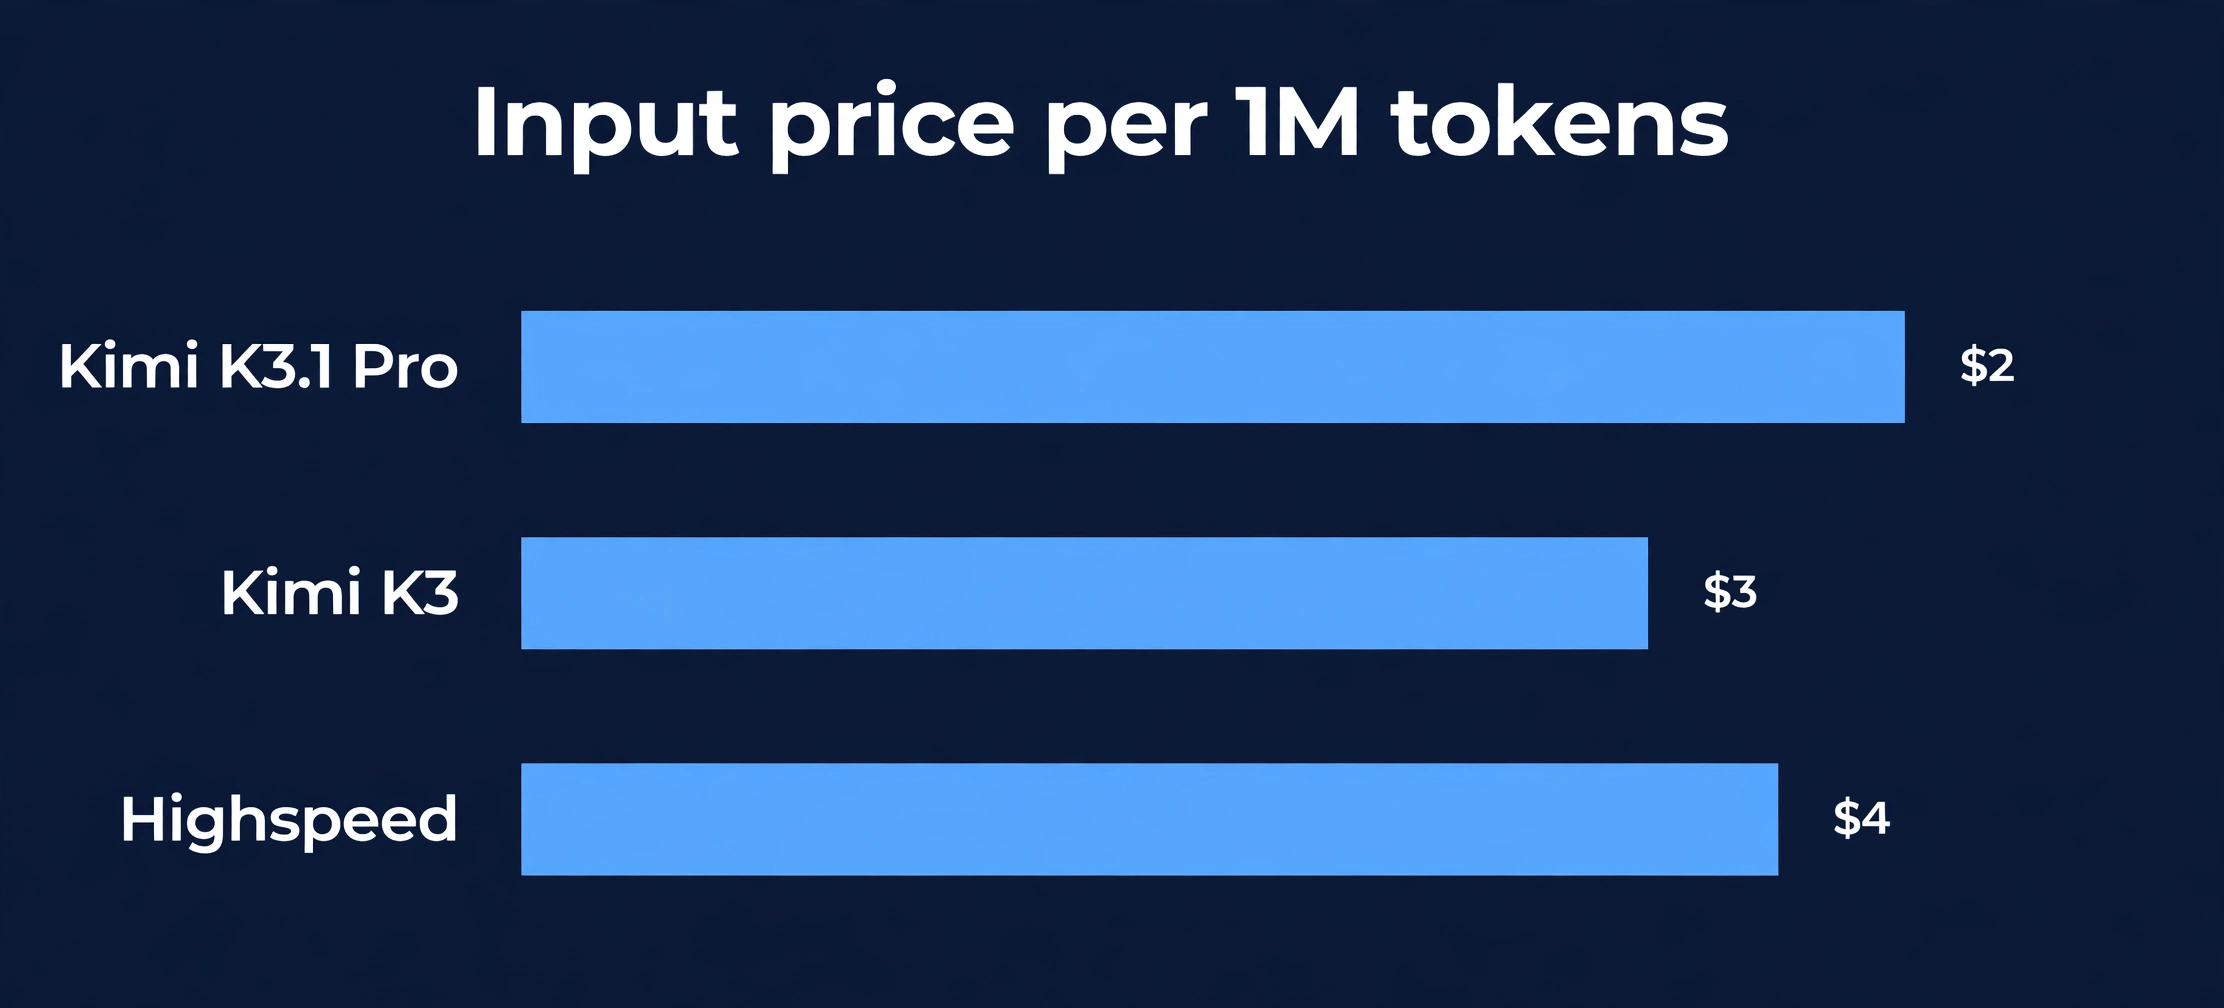
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| Kimi K3 | $3 | $15 | $0.30 |
Questo rappresenta una riduzione di un terzo rispetto a K3 su input, uscita e cache input. Il prezzo standard corrisponde a GPT-6.1 Sol a $2/$10, secondo la copertura del lancio, mentre il livello Highspeed a $4/$20 corrisponde al tasso riportato di Opus 5.5. Non è elencato alcun sovrapprezzo a lungo contesto, e le scritture di cache sono fatturate separatamente per TTL (5 minuti o 1 ora).
Il problema è l'uso dei token. L'Analisi Artificiale ha misurato Kimi K3.1 Pro a 77 token al secondo di output e ha stimato circa 1,98-$2,11 per compito di benchmark, quasi invariato rispetto a K3, perché il nuovo modello utilizza più token di output per raggiungere i punteggi. Più economico per token non significa sempre più economico per compito finito, quindi misura i tuoi carichi di lavoro prima di cambiare.
Benchmark, con le oneste avvertenze
Tutti i dati di benchmark in questa tabella sono riportati dai fornitori, dal grafico di lancio di Moonshot, con modelli eseguiti con il massimo sforzo di riflessione. La verifica indipendente è ancora limitata perché i pesi non sono ancora stati pubblicati.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 |
| Maratona SWE | 51.7 | 46.3 | 42.5 |
| Ultimo Esame degli Agenti | 43.2 | 42.6 | 32.8 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 |
| L'ultimo esame dell'umanità, con gli strumenti | 70.0 | 67.7 | 57.2 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 |
| BenchCAD, con gli strumenti | 92.7 | 96.2 | 95.9 |
| Scienza Terminal-Bench 0.1 | 38.1 | 63.3 | 68.1 |
Il punto debole è reale. Su Terminal-Bench Science 0.1, Kimi K3.1 Pro ottiene 38,1 contro 63,3 per Opus 5.5 e 68,1 per GPT-6 Astra. Se il tuo lavoro è ricerca scientifica pesante in terminale, questo non è ancora il modello da individuare solo sui benchmark. Controlli indipendenti aggiungono anche sfumature: Analisi Artificiale assegna Kimi K3.1 Pro al 55 nel suo Indice di Intelligenza, quarto assoluto, in aumento di 11 punti rispetto ai 44 di K3, dietro Opus 5.5 al 58 e Claude Sonnet 5.5 e Muse Wonder Full pari merito al 56. Un tester indipendente ha valutato la scena 3D e il lavoro sul sito web sopra il GPT-5.6 Sol ma sotto il GPT-6.1 Sol, quindi la qualità creativa è ancora in spicco in alcuni compiti.
La storia di sicurezza che conta prima che i pesi cadano
Moonshot ha deliberatamente limitato questo modello prima di promettere pesi a cielo aperto. Durante l'addestramento, il team ha riscontrato che le competenze di scoperta e sfruttamento delle vulnerabilità sono aumentate man mano che la fine-tuning è stata scalata, guidata dai materiali di cybersecurity presenti nel corpus di addestramento e dai relativi compiti di apprendimento per rinforzo. Ha rimosso quei dati in entrambe le fasi.
Nel suo test interno xdev-bench-hard, in cui il modello riceve codice sorgente con una vulnerabilità recentemente rivelata e deve scrivere un exploit in un ambiente isolato, la versione sperimentale senza restrizioni ha ottenuto il 90,5%, la versione finale K3.1 Pro 81% e Kimi K3 il 33,3%. Questi sono dati interni non verificati, e Moonshot stessa afferma che il modello è ancora indietro rispetto ai modelli proprietari più esperti disponibili da almeno tre mesi in tali compiti, pur rimanendo utile per audit software difensivi. Il punto per gli acquirenti è semplice: i pesi a vuoto sono potenti, e Moonshot ha scelto di spedirli solo dopo aver ridotto la capacità di attacco informatico più precisa.
Quale dovresti scegliere?
Scegli Kimi K3.1 Pro se vuoi prestazioni quasi di frontiera da codice agente a un prezzo di $2/$10, una finestra di contesto da 1M e un percorso per i pesi aperti il 4 novembre. Si adatta a programmazione completa di progetti, cicli di agenti, flussi di lavoro 3D e CAD e ricerche finanziarie dove puoi verificare i risultati.
Scegli Kimi K3.1 Pro Highspeed se la latenza è il collo di bottiglia nel tuo loop agente e puoi pagare il doppio per token per 2 o 3 volte la velocità.
Resta su Claude Opus 5.5 se il tuo lavoro si basa su compiti terminali molto scientifici o sul punteggio più alto dell'indice indipendente, e accetti pesi chiusi e costi per compito più elevati. Resta su GPT-6 Astra se sei già costruito sullo stack di OpenAI e il suo ecosistema conta più del risparmio per token.
Se stai costruendo flussi di lavoro di agente su uno di questi modelli, questo è esattamente il tipo di impianto idraulico che determina costi e velocità in produzione. CodeMyPixel costruisce soluzioni di sviluppo di agenti AI personalizzate e sistemi completi di automazione AI per team che necessitano di modelli che svolgano lavoro reale, non solo generare testo. Per il contesto del modello, consulta le nostre analisi di GPT-6 Astra e Claude Opus 5.5.
Domande frequenti
Cos'è Kimi K3.1 Pro?
Una versione post-addestrata del Kimi K3 di Moonshot AI, lanciata il 23 ottobre 2026. È un modello di esperti con circa 2,8 trilioni di parametri totali, 104 miliardi di parametri attivi per token, una finestra di contesto da 1 milione di token e input di testo più immagini. È disponibile su Kimi.ai, Kimi Work, Kimi Code e l'API Kimi.
Quanto costa Kimi K3.1 Pro?
Il prezzo standard è di $2 ogni 1 milione di token di input, $10 per 1 milione di token di output e $0,20 per ogni milione di token di input memorizzato. La variante Highspeed costa $4/$20/$0,20. Questo è un terzo in meno per token rispetto al Kimi K3, che era $3/$15/$0,30.
Il Kimi K3.1 Pro è migliore del Claude Opus 5.5?
Non in generale. Su Terminal-Bench 4.0 riportato dai fornitori, Kimi K3.1 Pro ottiene 65,7 contro Opus 5,5 a 66,4, e guida in SWE Marathon e Agents' Last Exam. Su Terminal-Bench Science 0.1 è nettamente indietro con 38,1 contro 63,3. Nell'indice indipendente di Intelligenza dell'Analisi Artificiale, Opus 5.5 è in testa a 58 contro Kimi K3.1 Pro a 55. Benchmark diversi non sono comparabili come vincitore singolo, quindi scegli in base al carico di lavoro.
Quando verranno rilasciati i pesi Kimi K3.1 Pro?
Moonshot afferma di aver previsto di rilasciare i pesi completi dei modelli entro il 4 novembre 2026. I requisiti di licenza e hardware non sono ancora confermati, quindi i piani di self-hosting dovrebbero attendere quella pubblicazione.
Cos'è il Kimi K3.1 Pro Highspeed?
Una variante più veloce dello stesso modello che Moonshot dice offre un'uscita da 2 a 3 volte più veloce al doppio del prezzo del token (4 dollari in ingresso, 20 dollari in uscita per 1 milione di token, ingresso in cache invariato a 0,20 dollari). Si adatta ai loop di agenti sensibili alla latenza dove la velocità vale il prezzo.
- kimi k3.1 pro
- moonshot ai
- open weight models
- ai coding agents
- claude opus 5.5
- gpt-6 astra