IA10 min de lecturePar JH Akash
Mistral Large 4 Poids ouverts expliqué : Le Chonk, le modèle 1T que vous pouvez télécharger
Mistral a publié les 4 grands poids ouverts le 29 octobre 2026 : paramètres 1T, 52B actifs, 41 % Terminal-Bench 4,0, tarification API de 0,70 $/2,10 $, et licence MIT modifiée.
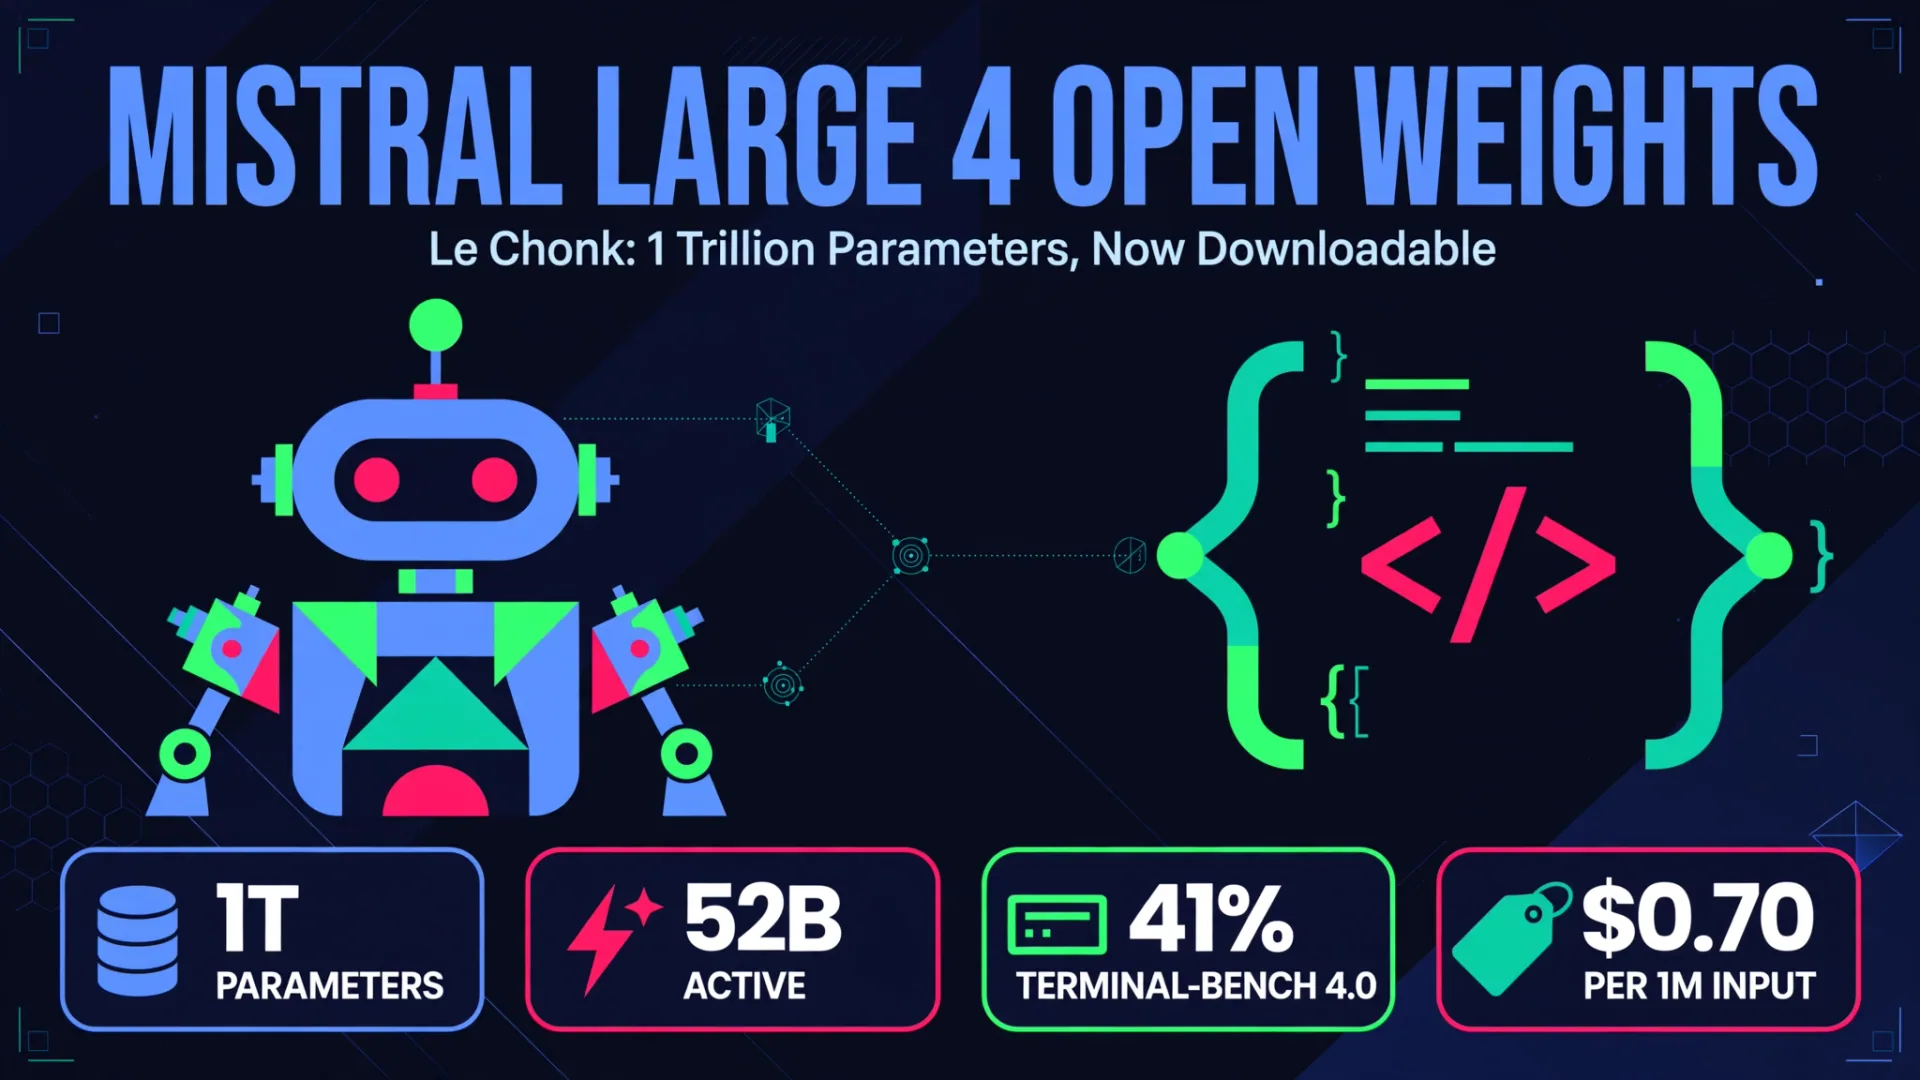
Mistral a publié les poids ouverts de Mistral Large 4 le 29 octobre 2026, trois semaines après la présentation publique du modèle le 6 octobre. Surnommé « Le Chonk », c’est le modèle phare du laboratoire français : un modèle multimodal natif, composé d’experts avec environ 1 000 milliards de paramètres au total, dont seulement environ 52 milliards par jeton. Ce design est tout l’enjeu. Vous obtenez une échelle de trillions de paramètres pour la connaissance et la capacité, mais vous ne payez que le calcul pour environ 5 % des poids de chaque jeton.
La version est importante car il ne s’agit plus d’une démo ni d’une prévisualisation uniquement API. Le poids est sur Hugging Face sous le nom de Mistral-Large-4-1T-A52B, prêt à être téléchargé, affiné et exécuté sur vos propres serveurs avec vLLM ou SGLang. Mistral propose aux Big 4 deux postes en particulier : le codage agent et la cybersécurité défensive. Chaque numéro de benchmark ci-dessous est rapporté par les fournisseurs de Mistral, donc considérez-le comme une revendication de l’entreprise jusqu’à ce que des testeurs indépendants le répètent. Le rapport technique complet est toujours annoncé comme prochainement disponible.
Le verdict rapide
| Question | Réponse |
|---|---|
| Qu’est-ce que c’est ? | Mistral Large 4, surnommé Le Chonk, un modèle multimodal à poids ouvert natif. |
| Poids libérés | 29 octobre 2026 (aperçu public : 6 octobre 2026) |
| Architecture | Mélange d’experts, environ 1T de paramètres au total, environ 52 milliards d’actifs par jeton |
| Fenêtre de contexte | 1 million de jetons |
| Langues | Saisie de texte et d’images, aisance native dans plus de 160 langues |
| Construit pour | Codage agentique, défense en cybersécurité, agents d’entreprise |
| Modes de raisonnement | Bas, moyen et haut (Haut est la norme par défaut) |
| Licence | Licence Mistral Ecosystem Open-Weight, une licence modifiée du MIT |
| Prix de l’API | 0,70 $ par 1M de jetons d’entrée, 0,07 $ d’entrée en cache, 2,10 $ par 1M de jetons de sortie |
| Auto-hébergement | Hugging Face weights, vLLM ou SGLang, également sur Mistral Studio, OpenRouter, Microsoft Foundry et les terminaux NVIDIA |
| Le piège | Les entreprises qui le proposent en tant que service modèle hébergé ont besoin d’une licence commerciale distincte |
Ce qui a changé depuis la bande-annonce du 6 octobre
L’amélioration principale concerne le Terminal-Bench 4.0, un test du travail de codage effectué dans un terminal. Mistral rapporte que le score est passé de 28 % lors de l’aperçu à 41 % dans la version en poids ouvert, soit un bond de 13 points, tandis que les jetons de sortie ont chuté de 30 %. Mistral attribue trois semaines supplémentaires d’apprentissage par renforcement pour ces gains, incluant un raisonnement plus efficace et des coûts d’inférence plus faibles.
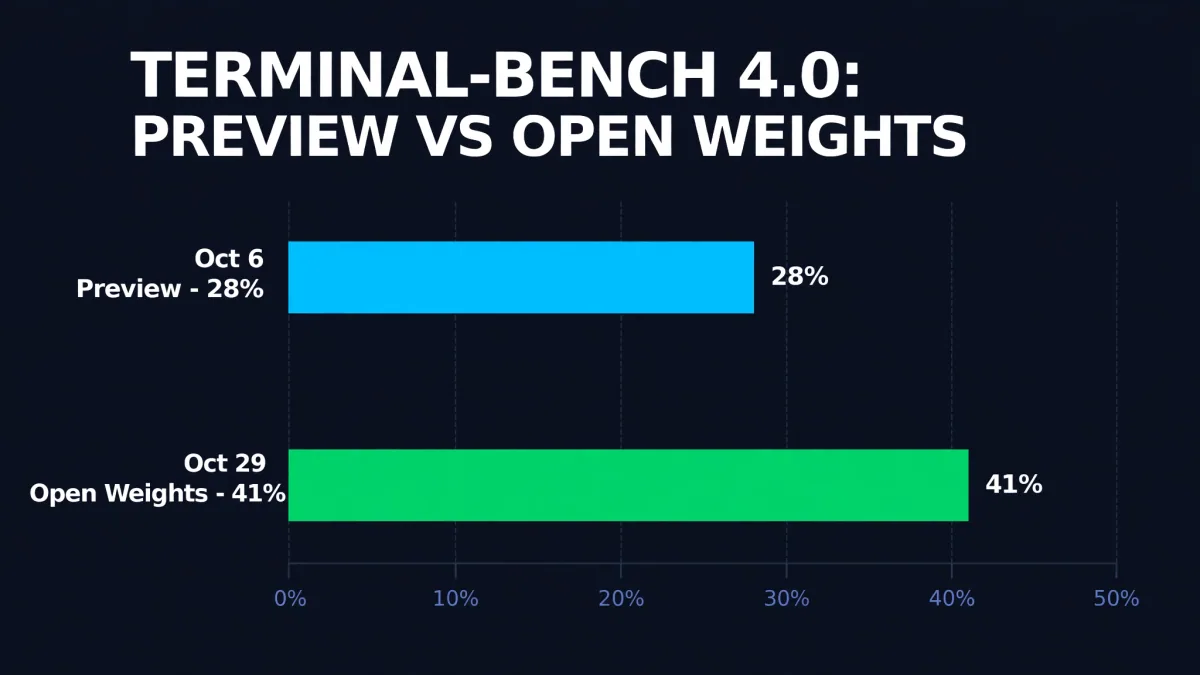
Ce seul saut recadre le modèle. En aperçu, Large 4 semblait être un codeur prometteur mais en retard. Dans la version en poids ouvert, Mistral le rapporte à 48 % sur l’Artificial Analysis Coding Agent Index, à égalité avec GLM-5,3, tout en utilisant en moyenne 47 % de jetons en moins par tâche. Sur le benchmark privé FrontierCode 2.0 de Cognition, qui teste si un mainteneur de dépôt fusionnerait le changement de code d’un agent, Mistral rapporte 19,7 %, le meilleur score parmi les modèles à poids ouvert listés. Pour contexte, les modèles fermés restent largement en avance sur ce même test : Claude Opus 5.5 obtient un score de 46 %, selon la couverture de l’annonce de Mistral. Les pondérations ouvertes réduisent l’écart, ils ne l’ont pas comblé.
Tableau de benchmark (tous rapportés par les fournisseurs par Mistral)
| Référence | Score Mistral Large 4 | Ce qu’il mesure |
|---|---|---|
| FrontierCode 2.0 | 19.7% | Qualité du code de bout en bout, meilleur score parmi les modèles ouverts listés |
| Terminal Bench 4.0 | 41 % (aperçu : 28 %) | Travail de codage effectué dans un terminal |
| Index d’agent de codage | 48% | Le codage des agents, effectivement lié à GLM-5.3, avec 47 % de tokens en moins par tâche |
| Cyber Index | 51% | Trouver, reproduire, valider et corriger des vulnérabilités |
| Benchmark de sécurité des agents B3 | 97,1 % de résistance aux attaques (aperçu : 93,3 %) | Résistance aux attaques d’agents |
| Prompts cyber malveillants | Taux de refus de 96,6 % | Refus de demandes malveillantes de cybersécurité |
| FinWorkbench | 73.3% | Flux de travail financiers |
| BrowseComp | 84,5 % (point de contrôle en aperçu : 75 %) | Recherche sur le deep web |
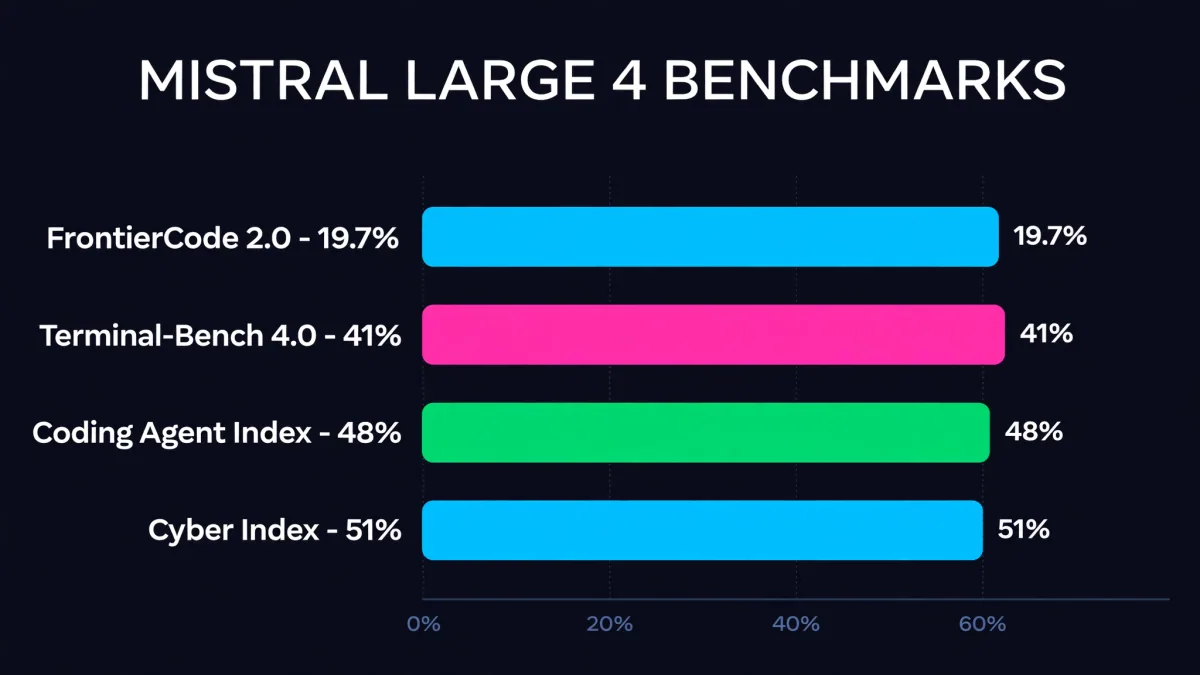
Lisez ces chiffres avec deux mises en garde. Premièrement, les différents benchmarks ne sont pas comparables entre eux, donc un pourcentage plus élevé sur un test ne signifie pas que le modèle est « meilleur » globalement que sur un autre. Deuxièmement, les audits indépendants ont été moins généreux : un audit cité dans la couverture a classé Large 4 32e sur 44 dans un indice global, tout en le plaçant près du sommet d’un benchmark légal. Les benchmarks des fournisseurs sont un point de départ pour vos propres tests, pas un verdict.
Tableau tarifaire
| Itinéraire | Prix |
|---|---|
| Mistral API, entrée | 0,70 $ par 1M de jetons |
| API Mistral, entrée mise en cache | 0,07 $ par 1M de jetons |
| API Mistral, sortie | 2,10 $ par 1M de jetons |
| Aperçu du prix catalogue (pour comparaison) | 1,36 $ d’entrée, 4,18 $ de sortie par 1M de jetons |
| Poids auto-hébergés | Téléchargement gratuit, vous payez pour vos propres GPU |
| Revente en mode modèle en tant que service | Licence commerciale distincte de Mistral requise |
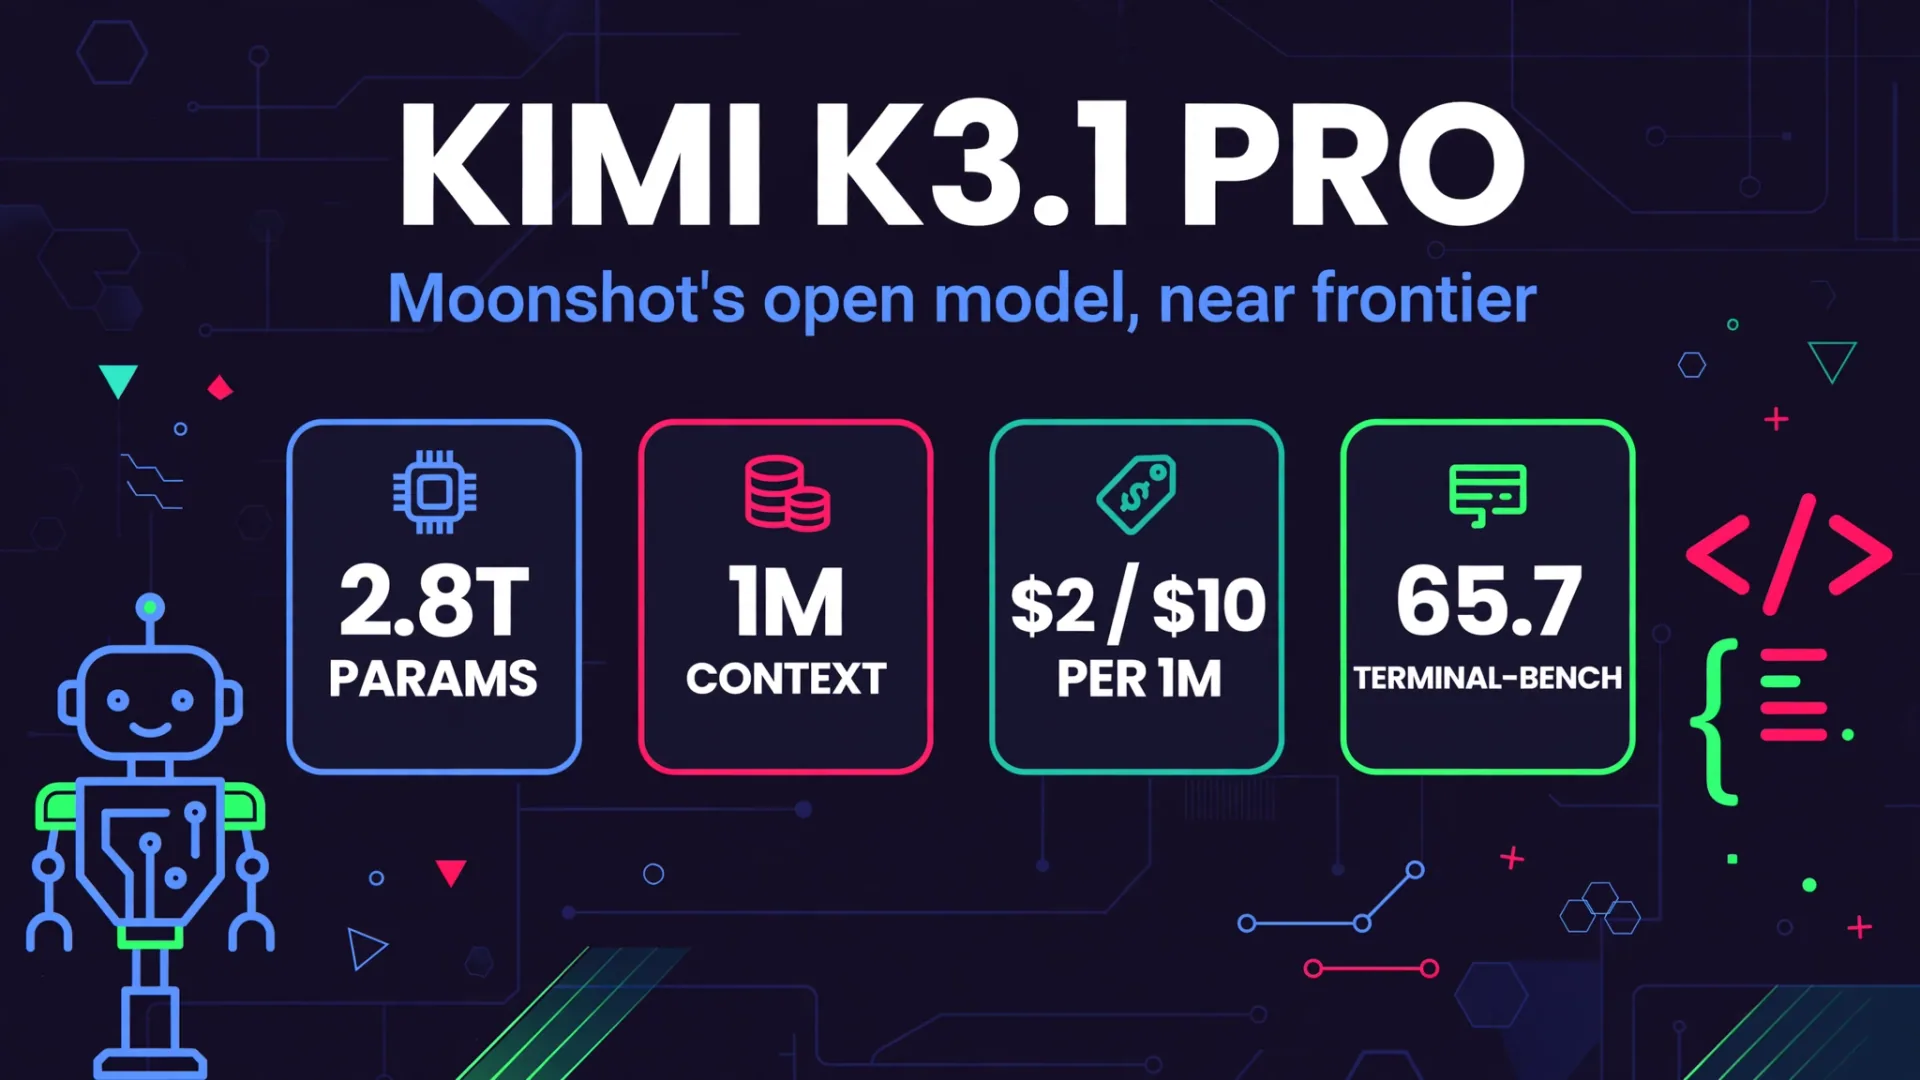
Le prix de la nouvelle API est environ la moitié du prix de liste de prévisualisation, ce qui correspond à la remise de lancement que Mistral a affichée lors de la prévisualisation. Pour comparaison, le Kimi K3.1 Pro de Moonshot coûte 2 $ en entrée et 10 $ en sortie par 1 million de jetons, donc l’API des Big 4 est tarifée agressivement pour un modèle ouvert de classe frontier. Le prix inférieur du token n’aide que si l’exigence d’efficacité du token tient dans votre charge de travail, donc mesurez le coût par tâche terminée, pas le coût par jeton.
La licence, en termes simples
Large 4 est publié sous la licence Mistral Ecosystem Open-Weight, une version modifiée de la licence MIT. Vous pouvez l’utiliser, le modifier, l’ajuster et construire des produits commerciaux dessus gratuitement. Il existe une exception, et elle est importante : les entreprises qui exploitent un modèle en tant que service, c’est-à-dire qui vendent un accès hébergé au modèle lui-même, doivent d’abord obtenir une licence commerciale distincte auprès de Mistral. La couverture précise que l’annonce ne définit pas clairement où s’arrête l’emballage du modèle dans un produit SaaS et où commence le modèle en tant que service, donc si vous envisagez de revendre l’accès, obtenez une réponse écrite à la question de la licence avant de développer dessus.
Souveraineté et sécurité : l’autre moitié du pitch
Mistral a entraîné le Big 4 de zéro dans ses propres centres de données européens, apparemment sur environ 3 800 GPU NVIDIA Grace Blackwell (certains rapports situent ce chiffre à 4 000), et présente ce modèle comme une IA souveraine : les organisations peuvent l’inspecter, le personnaliser et l’exécuter dans leurs propres pare-feux sans dépendre de l’API de Mistral. C’est un véritable avantage pour les industries réglementées, le travail gouvernemental et toute personne ayant des règles strictes de résidence des données.
En matière de sécurité, Mistral marche sur une ligne prudente. Il rapporte un score de 51 % à l’Artificial Analysis Cyber Index et un taux de refus de 96,6 % sur les requêtes cyber malveillantes, et il affirme que les garde-fous préservent le travail défensif tout en bloquant les attaques. Parallèlement, Mistral admet avoir vu un potentiel d’amélioration dans la conduite d’attaques réelles lors de la prévisualisation, et une variante moins restreinte, conçue pour les tests d’intrusion et le red-teaming, reste limitée aux partenaires de conception d’entreprise vérifiés, dont Orange Cyberdefense, sous contrats qui restreignent les tests aux systèmes possédés ou explicitement autorisés. Une fois les pondérations publiques, elles ne peuvent plus être désactivées, donc la publication ouverte elle-même est un jugement sur la valeur défensive l’emportant sur le risque d’abus.
Ce qu’il faut pour le gérer soi-même
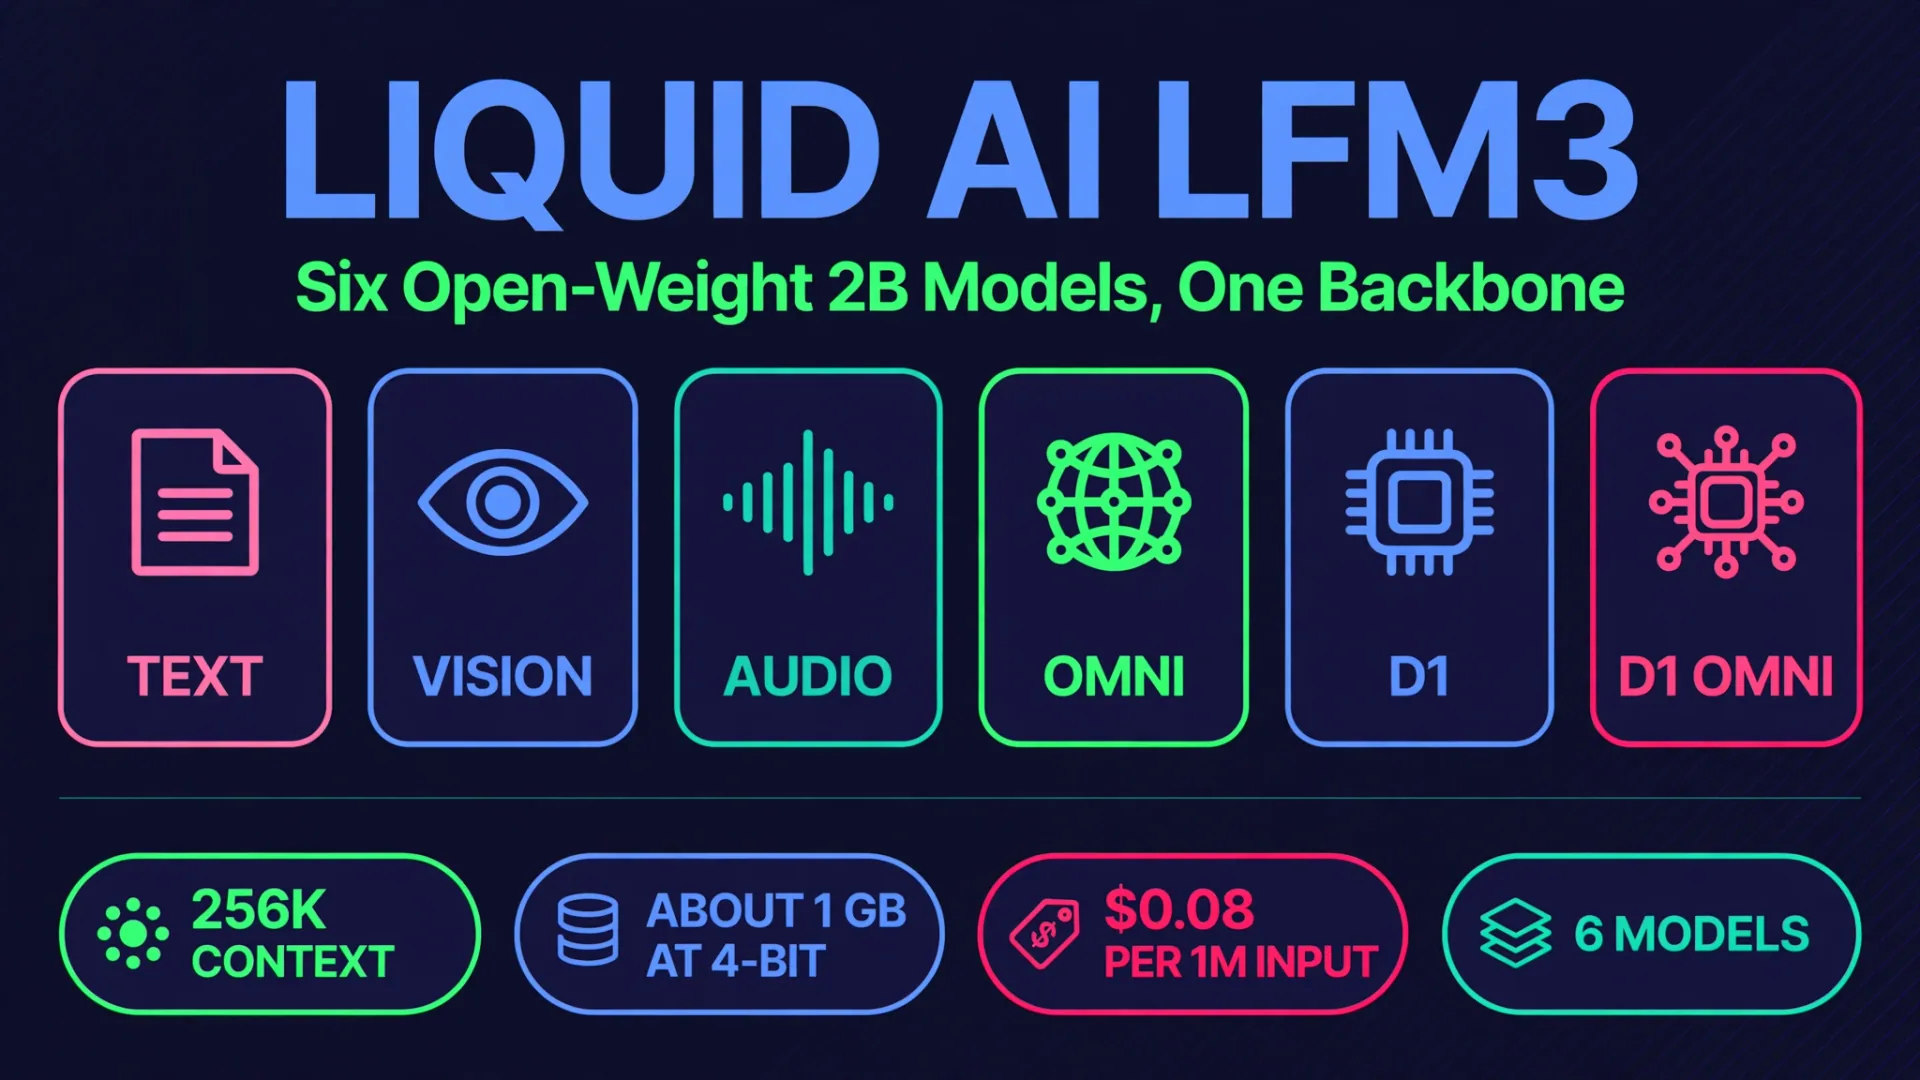
Ce n’est pas un modèle portable. Selon la documentation SGLang citée dans la couverture, la version standard fonctionne sur huit GPU NVIDIA B300, et une variante plus compressée sur quatre GB300. La plupart des équipes seront mieux servies par l’API hébergée, par un point partenaire comme Microsoft Foundry ou OpenRouter, ou par Mistral Forge pour affiner des variantes spécifiques à chaque tâche, plutôt que d’auto-héberger le modèle complet. Si vous préférez un petit modèle ouvert pour le travail sur l’appareil, consultez notre article sur Liquid AI LFM3, six modèles de classe 2B conçus précisément pour cette tâche. Pour un cas contrasté d’un modèle puissant que vous ne pouvez absolument pas télécharger, voir Gemini 4 Carbon, le modèle de cybersécurité de Google actuellement limité aux défenseurs vérifiés. Et si vous comparez les modèles ouverts aux modèles fermés Frontier, notre analyse Kimi K3.1 Pro est un second point de données utile.
Lequel choisir
Choisissez l’API Mistral si vous voulez tester rapidement un Big 4, ou si vous avez besoin d’un codage open model de classe Frontier sans acheter de GPU. Le prix de 0,70 $/2,10 $ et le contexte de 1 million rendent l’essai peu coûteux.
Choisissez l’auto-hébergement si la résidence des données, la souveraineté ou une personnalisation profonde sont les facteurs décisifs, et vous avez le budget GPU. Vous avez le contrôle total, mais vous gérez aussi le déploiement, la sécurité et les mises à jour.
Choisissez l’ajustement fin via Mistral Forge si vous avez un travail précis et bien défini, comme un flux de travail de sécurité ou un agent de codage interne, où une variante plus petite et affinée pourrait surpasser le modèle général en termes de coût et de précision.
Laissez-le passer pour l’instant si vous prévoyez de revendre l’accès aux modèles hébergés sans régler la licence commerciale, si vous avez besoin d’un modèle qui fonctionne sur du matériel modeste, ou si votre charge de travail est déjà bien prise en charge par un modèle petit moins cher. Et si vous cherchez le meilleur score de codage possible, quelle que soit l’ouverture, des modèles fermés comme Claude Opus 5.5 mènent toujours largement FrontierCode 2.0, d’après les chiffres rapportés.
Pour les équipes qui construisent des systèmes d’IA en production, le choix des modèles ne représente que la moitié du travail. CodeMyPixel développe des services de développement d’agents IA et aide les entreprises à engager une agence d’automatisation IA pour intégrer ce type de modèles dans de vrais flux de travail, avec les garde-fous, l’évaluation et les contrôles de coûts qu’un téléchargement brut de modèle n’inclut pas.
Qu’est-ce que Mistral Large 4 ?
Mistral Large 4 est le modèle phare à poids ouvert de Mistral AI, surnommé Le Chonk. C’est un modèle multimodal natif, composé d’experts, avec environ 1 000 milliards de paramètres au total et environ 52 milliards d’actifs par jeton, une fenêtre de contexte d’un million de jetons, et une maîtrise de plus de 160 langues.
Mistral Large 4 est-il vraiment gratuit ?
Les poids sont gratuits à télécharger, utiliser, modifier, ajuster et construire des produits commerciaux sous la licence Mistral Ecosystem Open-Weight. La seule exception concerne les entreprises Model-as-a-Service, qui ont besoin d’une licence commerciale distincte de Mistral. L’auto-hébergement vous coûte toujours une infrastructure GPU, ou vous pouvez payer le prix de l’API Mistral de 0,70 $ par 1 million de jetons d’entrée et 2,10 $ par 1 million de jetons de sortie.
Comment le Grand 4 se compare-t-il au GLM-5.3 et au Claude Opus 5.5 ?
Sur les chiffres rapportés par les fournisseurs, le Grand 4 égalise GLM-5.3 à 48 % sur l’Indice des Agents de Codage tout en utilisant 47 % de tokens en moins, et il devance les modèles ouverts sur FrontierCode 2.0 à 19,7 %. Claude Opus 5.5 mène toujours ce même test FrontierCode avec 46 %, donc les modèles frontières fermés restent en tête en termes de capacité de codage brut.
Quel matériel dois-je utiliser pour faire fonctionner Mistral Large 4 ?
La version standard nécessite un matériel sérieux : huit GPU NVIDIA B300 selon la documentation SGLang, ou quatre GB300 pour une variante compressée. La plupart des utilisateurs devraient commencer par l’API Mistral, OpenRouter ou Microsoft Foundry plutôt que par l’auto-hébergement.
Où puis-je télécharger Mistral Large 4 ?
Les poids sont publiés sur Hugging Face sous le nom Mistral-Large-4-1T-A52B, pour un déploiement avec vLLM ou SGLang. Le modèle est également disponible via Mistral Studio, l’API Mistral, OpenRouter, Microsoft Foundry et des points de terminaison hébergés chez NVIDIA.
Mon entreprise devrait-elle passer à Mistral Large 4 ?
Changez si la souveraineté, la résidence des données ou le contrôle de fin ajustement vous concernent, ou si la revendication d’efficacité du token tient la route dans vos propres tests. Testez-la d’abord sur vos propres tâches, confirmez la position de la licence si vous revendez l’accès, et comparez le coût par tâche terminée, pas seulement par jeton, avant de vous engager.
- mistral large 4
- le chonk
- open weight models
- mistral ai
- ai coding
- cybersecurity ai
- frontier models