IA12 min de lecturePar JH Akash
Explication du LFM3 Liquid AI : 6 modèles 2B à poids ouvert
Liquid AI a lancé LFM3 le 27 octobre 2026 : six modèles de classe 2B à poids ouvert issus d’une seule infrastructure dorsale de 1,7 milliard, contexte 256K, 1 Go en 4 bits, API à 0,08 $ par 1 million de jetons.
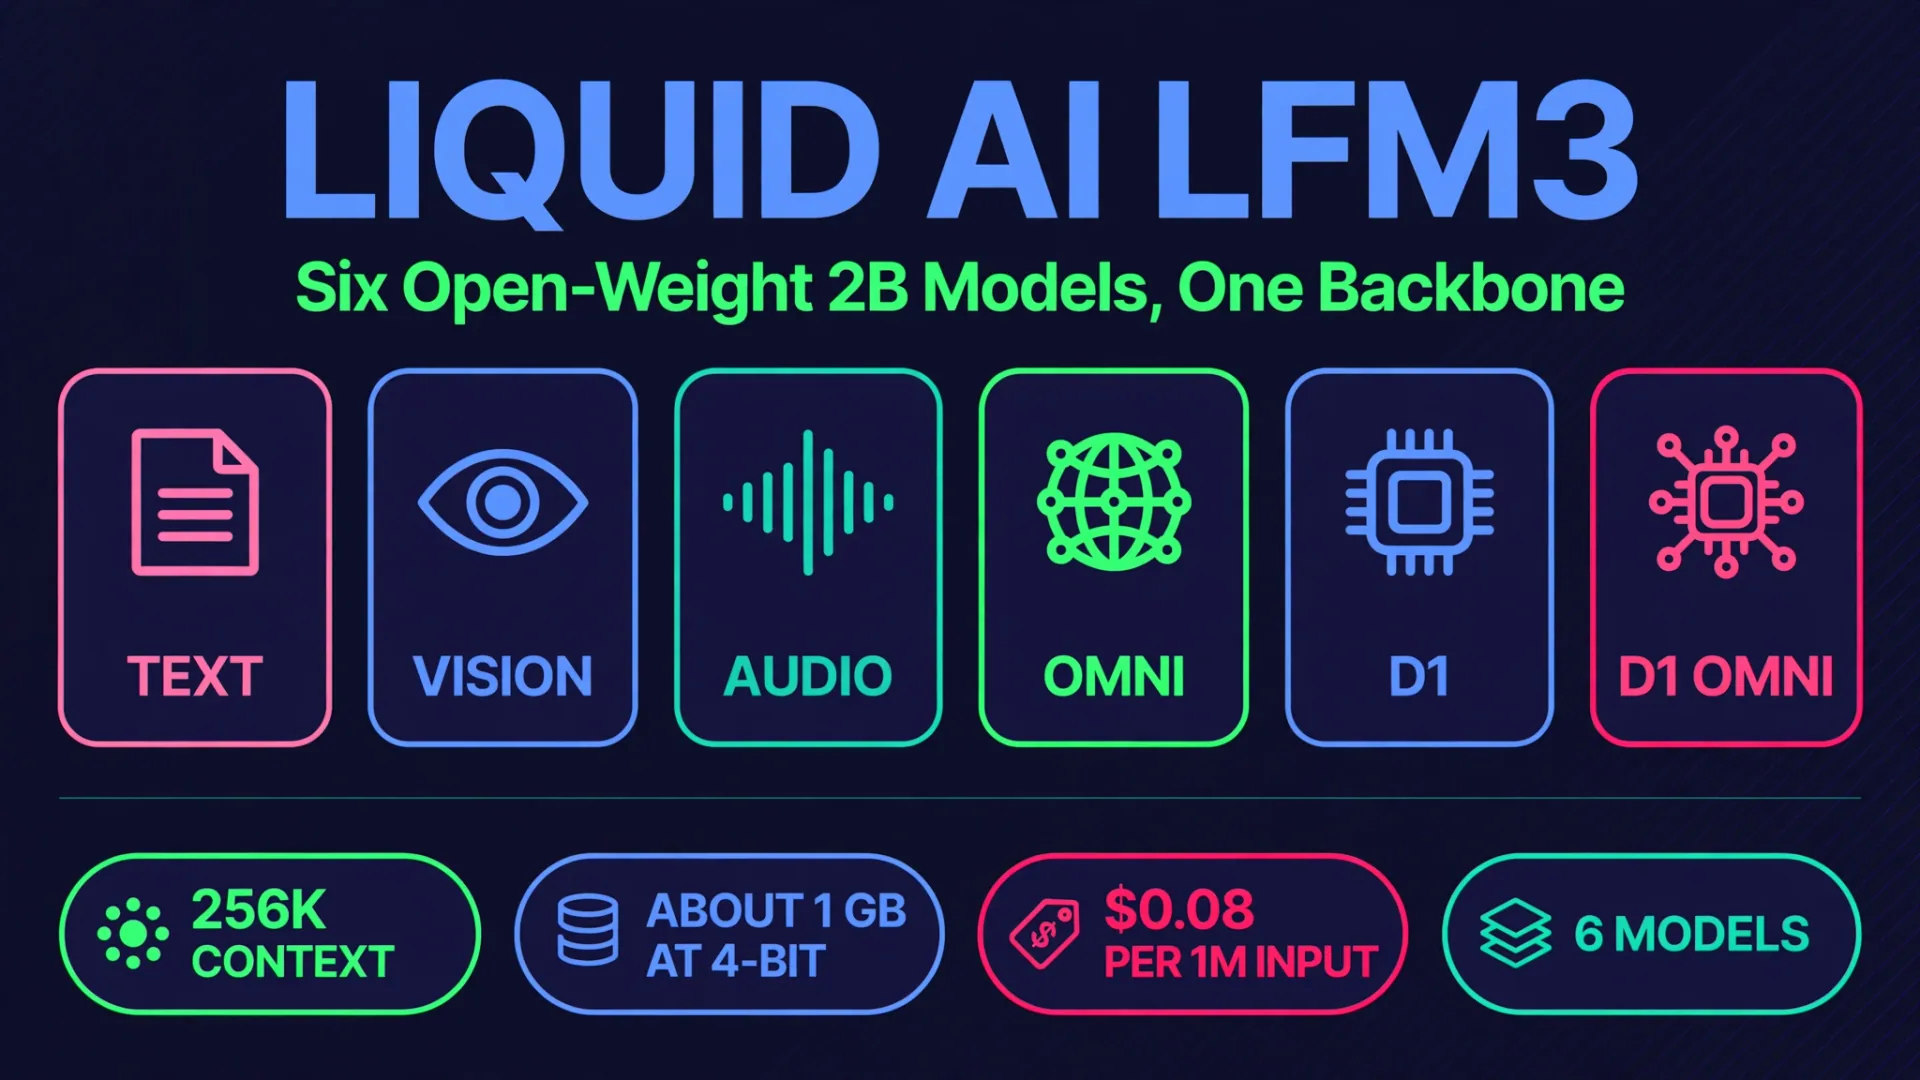
Liquid AI a lancé LFM3 le 27 octobre 2026, et il s’agit d’une version de modèle différente. Au lieu d’un immense modèle phare, LFM3 est une famille de six modèles à poids ouvert dans la catégorie des paramètres 2B, tous dérivés du même backbone 1,7B. Le texte, la vision, l’audio, l’omni et deux modèles de décision partagent une architecture, permettant à une équipe de choisir la modalité dont elle a besoin sans apprendre une nouvelle pile pour chacun. Le pitch n’est pas la puissance brute. C’est l’empreinte : un petit modèle performant qui fonctionne sur téléphones, ordinateurs portables, un Raspberry Pi 5 et du matériel de périphérie, et qui peut être affiné sur un seul GPU.
Le timing compte. Les modèles Frontier deviennent de plus en plus gros et coûteux à faire fonctionner, tandis que la plupart des vraies tâches professionnelles, lire un document, vérifier une photo, répondre à une commande vocale, établir une liste d’options, n’ont pas besoin d’un modèle géant. Ils ont besoin d’un modèle privé petit et rapide qui fonctionne là où se trouvent déjà les données. LFM3 est le pari de Liquid AI que c’est là que la prochaine vague de déploiement de l’IA aura lieu : sur appareil, sur site et à l’intérieur des systèmes contrôlés par l’entreprise.
Le verdict rapide
| Question | Réponse |
|---|---|
| Qu’est-ce que c’est ? | LFM3, une famille de six modèles de classe 2B à poids ouvert de Liquid AI |
| Lancement | 27 octobre 2026 |
| Colonne vertébrale partagée | LFM3-1,7B-Base, paramètres 1,73B |
| Contexte | 256K jetons sur la carte modèle (l’API hébergée affiche 128K, voir la note tarifaire ci-dessous) |
| Données d’entraînement | Jetons 22T de pré-entraînement |
| Empreinte | Environ 1 Go de mémoire à une précision de 4 bits pour le modèle texte |
| Licence | LFM Open License v1.0, poids ouvert |
| Disponible sur | Hugging Face, Liquid AI Playground, API Liquid AI, OpenRouter, Qualcomm AI Hub, Vercel |
| Le meilleur pour | Agents embarqués, inspection visuelle, voix et décisions calibrées |
| Pas pour | Codage agent lourd ou raisonnement complexe en plusieurs étapes (l’IA liquide le dit lui-même) |
Les six modèles, une colonne vertébrale
Chaque modèle LFM3 se ramifie de LFM3-1.7B-Base. Cette colonne vertébrale partagée est ce qui rend la famille inhabituelle : une architecture, six spécialisations.
| Modèle | Entrées | Sorties | À quoi sert |
|---|---|---|---|
| LFM3-1.7B | Texte | Texte | Texte général, agents, utilisation des outils |
| LFM3-VL-2B | Texte, images, vidéo | Texte | Compréhension de la vision et de la vidéo, inspection |
| LFM3-Audio-2B | Texte ou audio | Texte ou parole | Commandes vocales, transcription, parole |
| LFM3-Omni-2B | Texte, images, vidéo, audio | Texte et parole | Assistants multimodaux complets |
| d1-2B | Questions (liste) | Réponses calibrées | Décisions avec probabilités, pas de texte généré |
| d1-omni-2B | Questions multimodales | Réponses calibrées | Décisions fondées sur des images, des sons et des documents |
Les modèles de décision méritent une attention particulière car ils fonctionnent différemment d’un chatbot classique. Au lieu de générer un paragraphe, d1 répond à toute une liste de questions en un seul passage en avant, chacune avec une probabilité calibrée. Il peut aussi renvoyer des réponses tapées : pointer un objet, lire une valeur d’un document, estimer un nombre avec une plage, ou choisir toutes les options applicables. Pour les flux de travail métier comme le triage, le notage et le routage, cette sortie structurée est souvent plus utile qu’une prose fluide.
À l’intérieur de la colonne vertébrale : une architecture tri-hybride
LFM3-1.7B-Base comporte 24 couches : 13 convolutions courtes par filtres, cinq couches d’attention à fenêtre glissante avec une fenêtre de 256 jetons, et six couches d’attention globale. Les convolutions utilisent une taille de noyau de 7, contre 3 dans LFM2. Trois changements définissent la conception : attention par tête par tête, qui peut supprimer les valeurs aberrantes d’activation nuisant à la quantification ; RoPE partielle, où les couches d’attention globale ne font tourner que la moitié de fréquence la plus élevée de chaque tête ; et une norme sandwich qui normalise l’entrée et la sortie de chaque bloc.
Liquid AI indique que cette architecture est issue d’une recherche matérielle en boucle sur 14 combinaisons d’appareils et de backend, dont le Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI, les processeurs cloud Arm et x86, GPU, ainsi que le NPU Qualcomm Hexagon. Les résultats concrets, tous rapportés par le fournisseur : LFM3-1,7B bat son prédécesseur LFM2,5-2,6B tout en utilisant 35 % de paramètres en moins, tourne environ 25 % plus vite avec des jetons 8K dans le contexte, et décode de 1,8 à 2,8 fois plus rapidement que le modèle suivant sur les trois configurations embarquées par Liquid AI. Sur un seul NVIDIA B300, Liquid AI affirme que LFM3-1,7B peut produire 3,6 milliards de jetons par jour à 1 024 requêtes simultanées.
Le pré-entraînement fonctionnait sur des jetons 22T, les derniers 3,5T formant une étape intermédiaire sur des données sélectionnées avec une plus grande part de traces agentiques et d’appels outils, ce qui étendait également la fenêtre de contexte à 256K jetons. L’après-entraînement s’est déroulé en quatre étapes : ajustement fin supervisé sur des jetons 1,75T, apprentissage par renforcement mixte, distillation multi-domaines sur politique par six enseignants spécialisés en apprentissage par renforcement, et apprentissage par renforcement agentique dans de vrais harnais d’agents.
Benchmarks : fort sur les agents et les outils, honnête sur les limites
Tous les chiffres de référence ci-dessous sont rapportés par les fournisseurs par Liquid AI, à partir de son lancement et de sa carte modèle. Considérez-les comme des mesures propres à Liquid AI, et non comme des résultats indépendants.
| Référence | LFM3-1.7B | Ce qu’il teste |
|---|---|---|
| LiveClaw | 45.60 | Tâches agentiques |
| WebArena vérifié | 38.42 | Tâches d’agent web |
| BFCL V4 | 71.39 | Appel d’outils |
| Boîte à sable à outils | 80.36 | Utilisation des outils |
| IFEval | 96.66 | Instruction suivant |
| Bench SWE vérifié | 43.40 | Codage agentique |
| Diamant GPQA | 63.37 | Connaissances expertes |
| Le dernier examen de l’humanité (pas d’outils) | 7.17 | Connaissances concrètes |
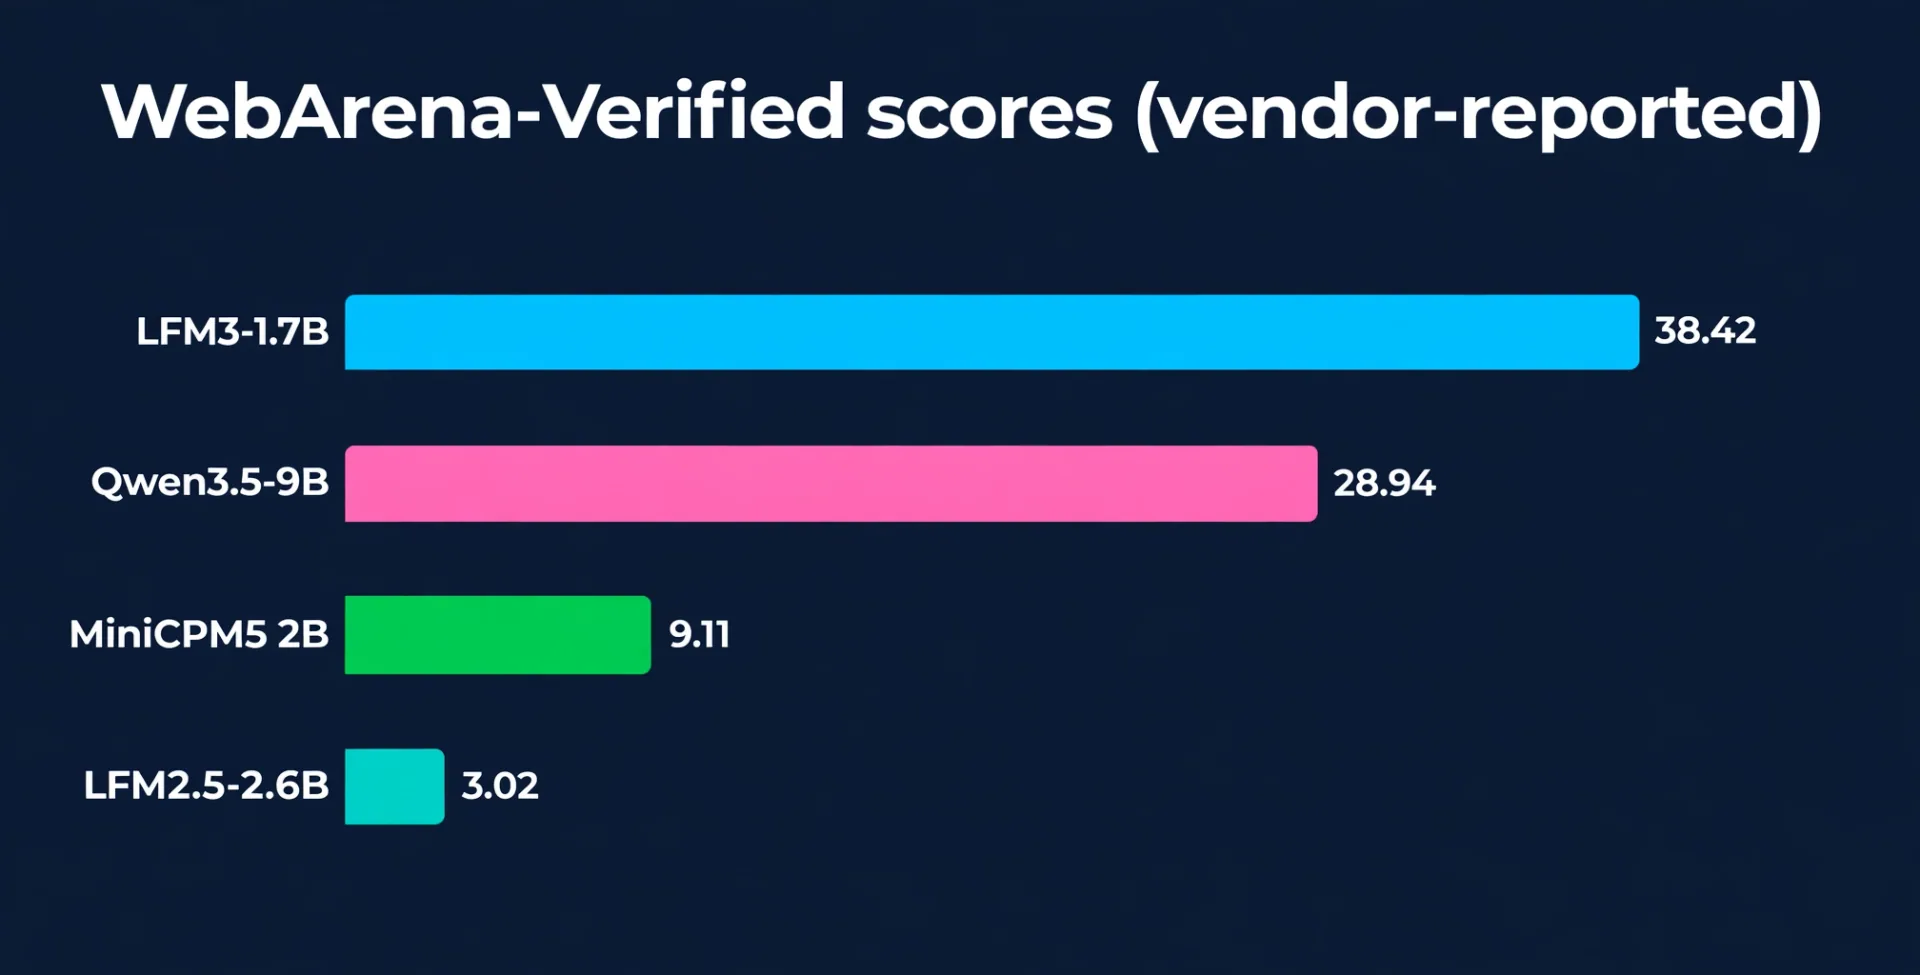
Le bond sur WebArena-Verified est le titre : 38,42 pour LFM3-1,7B contre 3,02 pour son prédécesseur LFM2,5-2,6B. C’est un vrai changement de nature pour un modèle 1,7B, et cela correspond à l’accent mis sur l’entraînement agentique. Mais le même tableau montre les limites : un 7,17 à Humanity’s Last Exam sans outils est faible, et la propre carte modèle de Liquid AI indique que le modèle n’est pas recommandé pour le codage agent ou le raisonnement complexe en plusieurs étapes en raison de sa petite taille. Les petits modèles sont un échange, pas un repas gratuit.
Les autres modalités ont leurs propres chiffres. LFM3-VL-2B est le premier modèle de vision LFM à accepter l’entrée vidéo, et Liquid AI rapporte qu’il augmente la moyenne sur 62 benchmarks de vision de 57,6 à 71,4 contre LFM2,5-VL-3B, tout en utilisant des paramètres de 1,9B contre 3,1B. LFM3-Audio-2B prend en charge 18 langues, avec une qualité de parole de 3,83 sur UTMOSv2 contre 3,22 pour son prédécesseur, un temps de premier jeton aussi bas que 50 ms, et une génération de voix à environ 87 fois le temps réel sur un seul thread CPU sur un Apple M4 Max. LFM3-Omni-2B, à 2,2 milliards de paramètres, devrait surpasser les modèles jusqu’à 10,7 milliards sur les benchmarks audiovisuels Daily-Omni, WorldSense et AV-SpeakerBench. Le modèle de décision d1-2B remplace d1-3B par un tiers de paramètres en moins et obtient un score de 75,5 contre 64,0 sur ImajevBench.
Tarification : certains des tokens hébergés les moins chers qui existent
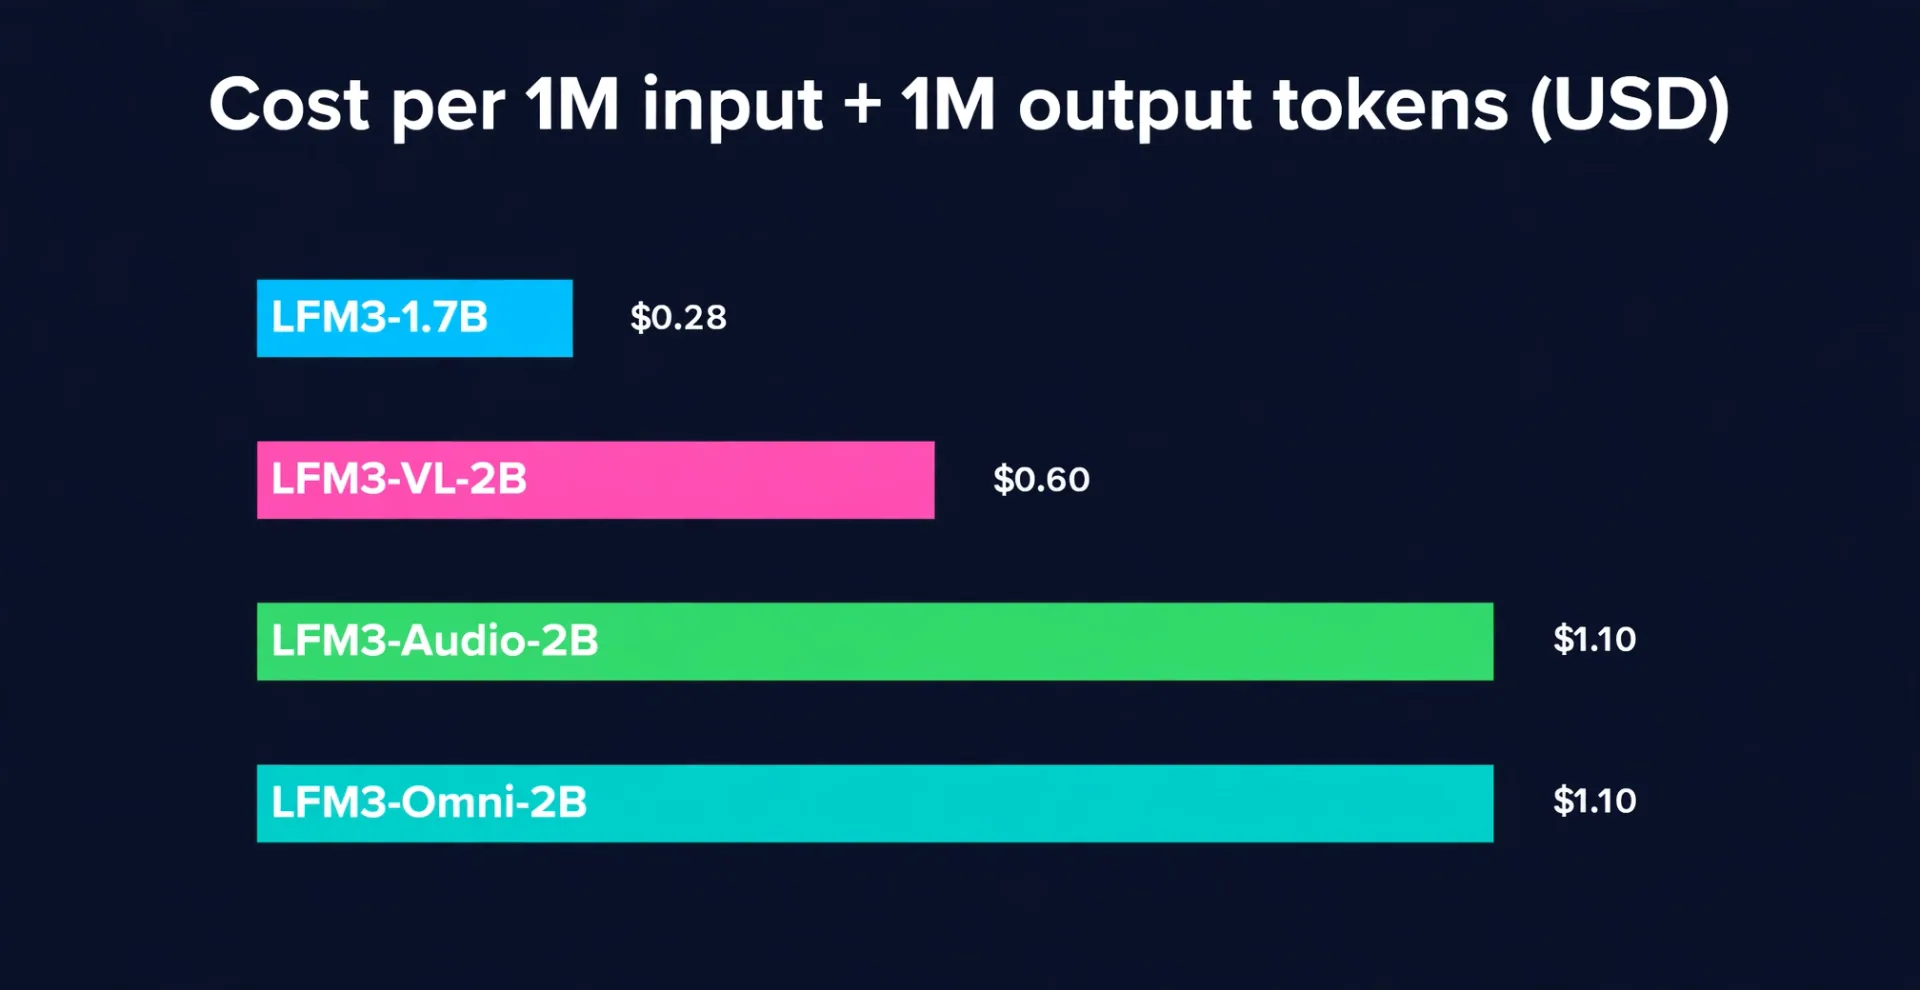
La tarification des API hébergées provient du catalogue de modèles de Liquid AI, comme le rapporte VentureBeat. Les prix sont en USD par million de tokens.
| Modèle | Entrée | Entrée mise en cache | Production | 1M d’entrée + 1M de sortie |
|---|---|---|---|---|
| LFM3-1.7B | $0.08 | $0.02 | $0.20 | $0.28 |
| LFM3-VL-2B | $0.10 | $0.02 | $0.50 | $0.60 |
| LFM3-Audio-2B | $0.10 | $0.02 | $1.00 | $1.10 |
| LFM3-Omni-2B | $0.10 | $0.02 | $1.00 | $1.10 |
Les jetons audio coûtent un supplément sur les modèles Audio et Omni : 2,00 $ par million de jetons d’entrée audio et 10,00 $ par million de jetons de sortie audio. Deux choses à vérifier avant de budgétiser : l’API hébergée indique une limite contextuelle de 128 000 jetons, tandis que la carte modèle annonce 256K, donc confirmez quelle limite s’applique à votre itinéraire de déploiement. Et pour les acheteurs sensibles à la vie privée, Liquid AI indique une conservation nulle des données sur ses modèles hébergés : le matériel soumis est utilisé pour répondre aux demandes et n’est ni conservé, ni enregistré, ni utilisé pour la formation.
Pour comparaison, le modèle texte à 0,28 $ par million d’entrées plus un million de jetons de sortie est bien en dessous du niveau phare. C’est l’objectif de cette classe : lorsque vous exécutez des millions de petites tâches, le prix par jeton décide si le produit est viable. Si vous comparez plus largement les prix des petits modèles hébergés, notre récente analyse de GPT-6.1 Terra montre comment OpenAI évalue son propre modèle rapide de milieu de gamme et de gamme moyenne, et notre article Kimi K3.1 Pro couvre un autre lancement en open weight du même mois.
Quel modèle devriez-vous choisir ?
Choisissez LFM3-1.7B pour les agents textuels, le travail documentaire et les flux de travail d’appel d’outils où le coût et la rapidité comptent plus que le raisonnement de frontière. C’est le choix par défaut et celui qui couvre le plus les benchmarks.
Choisissez LFM3-VL-2B pour tout ce qui regarde des images ou des vidéos : inspection qualité, lecture de documents, évaluation des dommages, contrôles d’étagères. L’exemple même de Liquid AI est révélateur : ajuster VL-2B sur environ 3 000 photos publiques de pales d’éolienne pendant quelques heures sur un A100 a augmenté la précision de la classification des défauts à 67 %. C’est le manuel des petits modèles : partir d’un modèle général correct, affinez vos propres images, déployez sur votre propre matériel.
Choisissez LFM3-Audio-2B pour les interfaces vocales, la gestion des appels et la transcription lorsque la faible latence compte. Un temps de 50 ms jusqu’au premier jeton et la génération vocale sur l’appareil en font un candidat pour les bornes, voitures et usines sans avoir à aller vers le cloud.
Choisissez LFM3-Omni-2B lorsqu’un seul assistant doit gérer le texte, l’image, la vidéo et l’audio ensemble, par exemple un assistant de terrain qui voit la machine, entend le technicien et répond.
Choisissez d1-2B ou d1-omni-2B quand vous avez besoin de décisions, pas de la prose : files de triage, score des prospects, routage de contenu, ou tout workflow où une probabilité calibrée et une réponse structurée l’emportent sur un paragraphe. C’est l’idée la plus orientée entreprise de la famille, et la moins proche d’un chatbot.
Chaque modèle LFM3 peut être affiné sur un seul GPU, avec des notebooks publiés pour l’ajustement supervisé, le DPO, le GRPO et la pré-formation continue. Les temps d’exécution incluent llama.cpp, MLX, vLLM, SGLang et Ollama, avec des variantes de checkpoint en BF16, FP8, NVFP4, GGUF, MLX et ONNX. Les partenaires de lancement du jour 0 incluent Ambarella, AMD, Arm, Intel via OpenVINO, NVIDIA, OpenRouter, Qualcomm et Vercel, et Liquid AI, selon Mercedes-Benz et Shopify partenaires pour les tests et l’évaluation pré-lancement.
Liquid AI a également adapté VL-2B en trois modèles robotiques pour l’orchestration, la navigation et la manipulation, rapportant un succès moyen de 96,2 % sur les quatre suites LIBERO et 45,7 % sur les tâches de jeu de société RoboCasa-GR1, avec des blocs d’action générés en moins de 50 ms sur un Jetson AGX Orin. La robotique en est encore précoce pour un modèle 2B, mais le chiffre de latence est la partie intéressante : les petits modèles peuvent boucler la boucle assez rapidement pour un contrôle réel.
Les limites honnêtes
Aucun modèle 1.7B ne remplace un modèle frontière, et LFM3 ne prétend pas en faire partie. Les questions axées sur les connaissances, les mathématiques difficiles et le raisonnement long en plusieurs étapes sont des points faibles, et les directives propres à Liquid AI détournent les utilisateurs du codage agent avec cette classe de taille. Si votre tâche nécessite une recherche approfondie ou une planification complexe, vous voulez toujours un modèle plus grand, éventuellement avec LFM3 pour gérer la couche peu coûteuse, rapide et volumineuse autour. Cette configuration en couches, petits modèles en bordure et modèles frontière pour les cas durs, est aussi la façon dont la plupart des projets sérieux de développement d’agents IA sont réellement construits. Si vous envisagez ce type de système, notre équipe construit des agents ainsi ; voyez comment engager une agence d’automatisation de l’IA pour ce qu’il faut vérifier avant de vous engager.
L’autre chose à vérifier est la licence. LFM3 est livré sous la licence ouverte LFM v1.0 en tant que licence openweight, mais les licences « ouvertes » diffèrent dans leurs termes commerciaux, donc lisez le texte réel de la licence pour votre niveau de revenus et votre cas d’utilisation avant de livrer un produit commercial dessus.
FAQ
Qu’est-ce que Liquid AI LFM3 ?
LFM3 est une famille de six modèles d’IA à poids ouvert lancés par Liquid AI le 27 octobre 2026. Les six sont tous dérivés du même dorsal LFM3-1.7B-Base et couvrent le texte, la vision, l’audio, l’omni et la prise de décision, dans la classe des paramètres 2B.
Quelle est la taille réelle de LFM3-1.7B ?
Le modèle texte possède 1,73 B de paramètres, une fenêtre de contexte de 256 K jetons sur sa carte modèle, et un vocabulaire de 128 000 jetons, avec la prise en charge de 16 langues. Avec une précision de 4 bits, il consomme environ 1 Go de mémoire, ce qui explique pourquoi il peut fonctionner sur téléphones et petits périphériques en périphérie.
Le LFM3 peut-il fonctionner sur un téléphone ?
Oui, c’est l’objectif de conception. Liquid AI l’a testé sur le Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI et le NPU Qualcomm Hexagon, et rapporte qu’il décode de 1,8 à 2,8 fois plus vite que le modèle suivant sur ses configurations testées sur l’appareil.
Combien coûte l’API LFM3 ?
Le modèle texte coûte 0,08 $ par million de jetons d’entrée, 0,02 $ mis en cache, et 0,20 $ par million de jetons de sortie, ce qui équivaut à 0,28 $ pour un million de jetons d’entrée plus un million de jetons de sortie. Vision coûte 0,60 $ sur la même base, et Audio et Omni coûtent 1,10 $ avant frais de jetons audio.
LFM3 est-il vraiment ouvert ?
Les poids sont à poids ouvert sous la licence LFM Open License v1.0 et disponibles sur Hugging Face, Liquid AI Playground et Liquid AI API. Consultez les conditions de licence pour votre cas d’usage commercial, car les licences open weight varient.
Quel modèle LFM3 devrais-je choisir ?
Choisissez 1.7B pour les agents textuels, VL-2B pour les images et la vidéo, Audio-2B pour la voix, Omni-2B pour les assistants multimodaux combinés, et d1-2B ou d1-omni-2B lorsque vous avez besoin de décisions calibrées avec des probabilités au lieu du texte généré.
Comment LFM3 se compare-t-il au Kimi K3.1 Pro ou au GPT-6.1 Terra ?
Ils ciblent différents niveaux. Kimi K3.1 Pro est un modèle open beaucoup plus grand et orienté vers la frontière, et GPT-6.1 Terra est le modèle informatique intermédiaire hébergé d’OpenAI. LFM3 est plus petit, moins cher et conçu pour fonctionner sur un appareil. Comparez-les selon votre propre tâche et matériel, pas sur un seul benchmark, car différents benchmarks mesurent des compétences différentes.
Où puis-je essayer LFM3 ?
Sur Hugging Face, le Liquid AI Playground, l’API Liquid AI, et via des partenaires tels qu’OpenRouter, Qualcomm AI Hub et Vercel.
Sources : publication du lancement de l’IA liquide, couverture Unite.AI lancement, couverture tarifaire VentureBeat, et la carte modèle LFM3-1.7B sur Hugging Face.
- liquid ai lfm3
- lfm3
- open weight models
- on-device ai
- liquid ai
- ai agents
- small language models