Noticias de IA9 min de lecturaPor JH Akash
Vista previa de Qwen4-Max: 14 días en directo, 1M Contexto, sin precio
Alibaba abrió Qwen4-Max Preview el 11 de noviembre y lo retira el 25 de noviembre. Tiene un contexto de 1 millón de tokens y un techo de salida de 393.216 tokens, pero sin benchmarks, sin tarjeta modelo y sin precio por token.
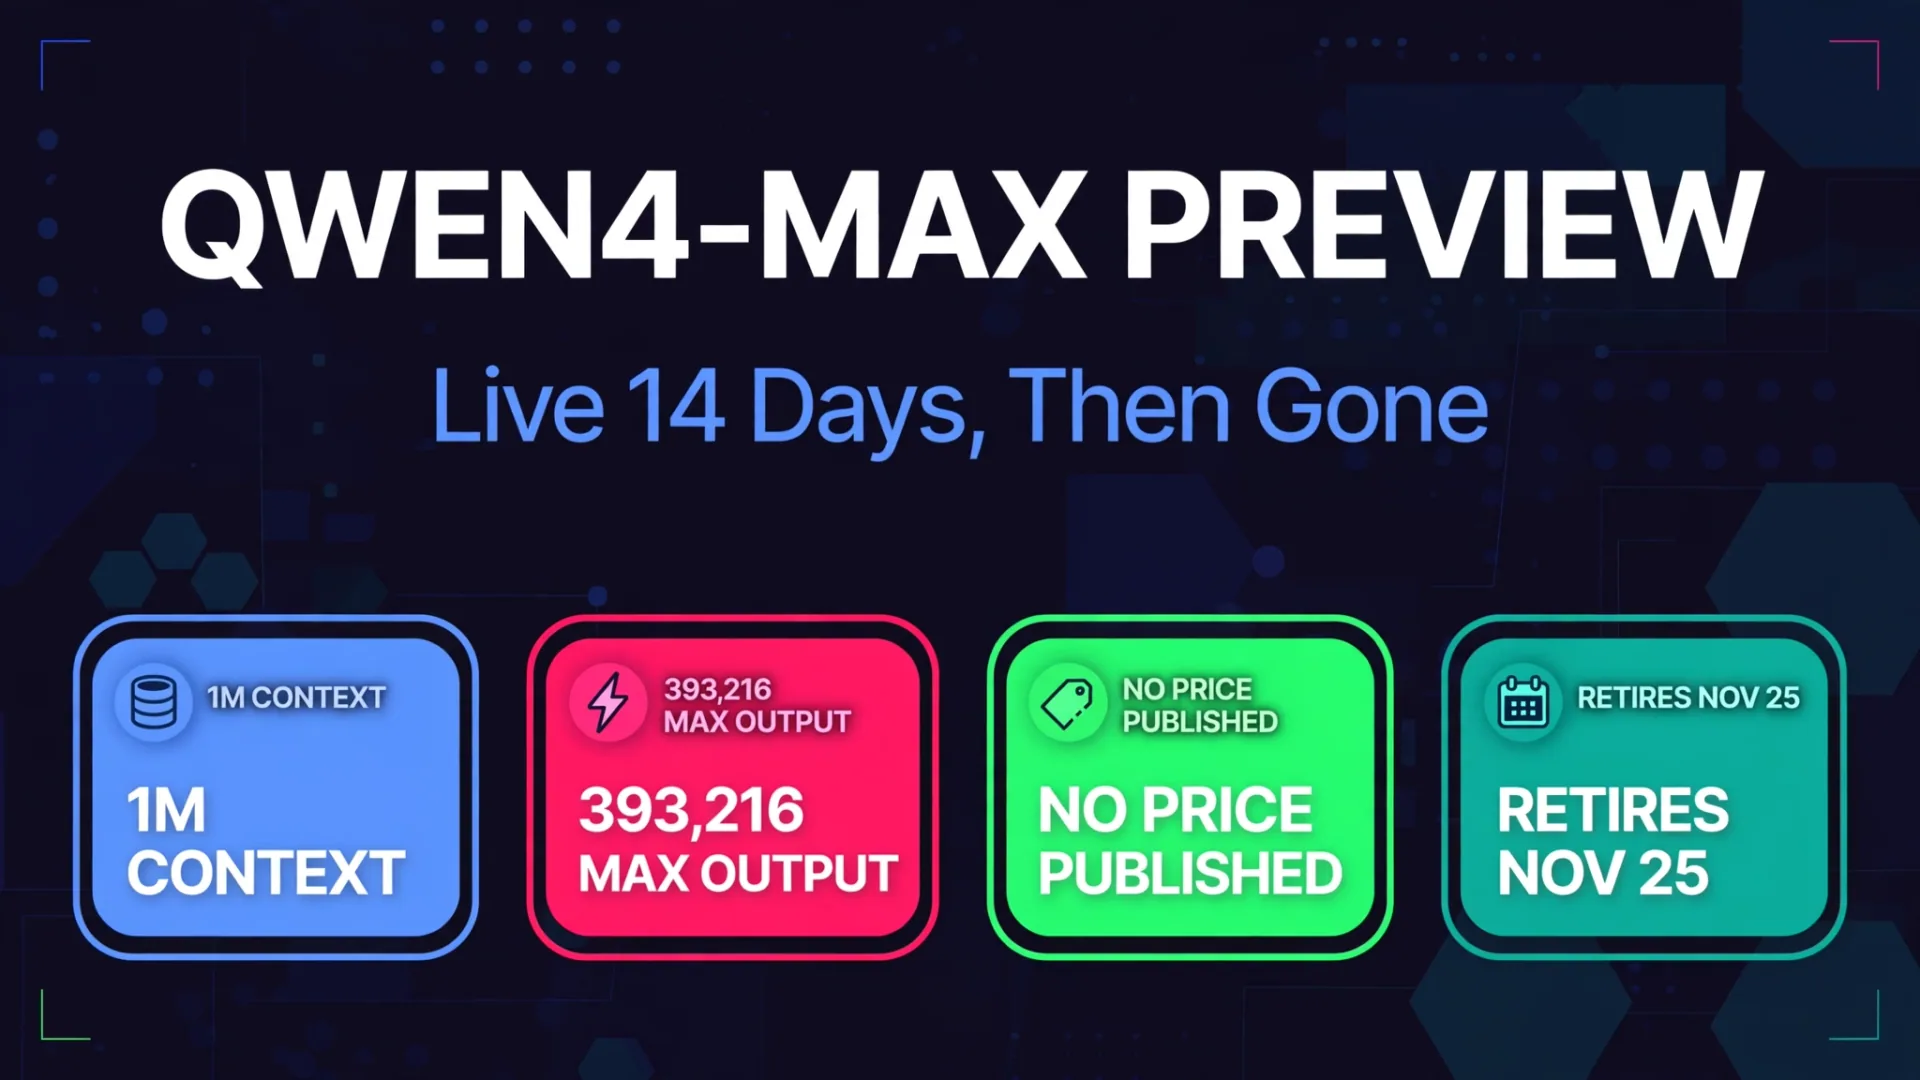
El 11 de noviembre de 2026, Alibaba inauguró Qwen4-Max Preview, el primer modelo de su generación Qwen4. Viene acompañado de una frase que casi nunca se ve en un lanzamiento insignia: la vista previa se extiende hasta el 25 de noviembre, no se harán cambios durante este periodo y el modelo se retirará tras finalizar la vista previa.
Catorce días. Luego desapareció. Y Alibaba no publicó puntuaciones de referencia, ni tarjeta modelo, ni conteo de parámetros, ni pesos ni precio por token con él. Esto es lo que realmente es el modelo, lo que muestran las primeras pruebas y si merece la pena tus dos semanas.
Qué es la Vista Previa de Qwen4-Max
Qwen4-Max Preview es la versión de acceso anticipado de Qwen4, la siguiente generación insignia de Alibaba, presentada por primera vez en su conferencia Apsara en septiembre de 2026. Es el único modelo Qwen4 que cualquiera puede llamar hoy en día. El resto de la familia, Qwen4-Plus, Qwen4-Flash y un modelo 27B destinado a despliegue local, no tiene fecha anunciada.
| Especificaciones | Vista previa de Qwen4-Max |
|---|---|
| ID del modelo | qwen4-max-preview (alias qwen4.0-max-preview) |
| Estado | Avance, del 11 al 25 de noviembre de 2026 (hora de Pekín) |
| Ventana de contexto | 1.000.000 de fichas |
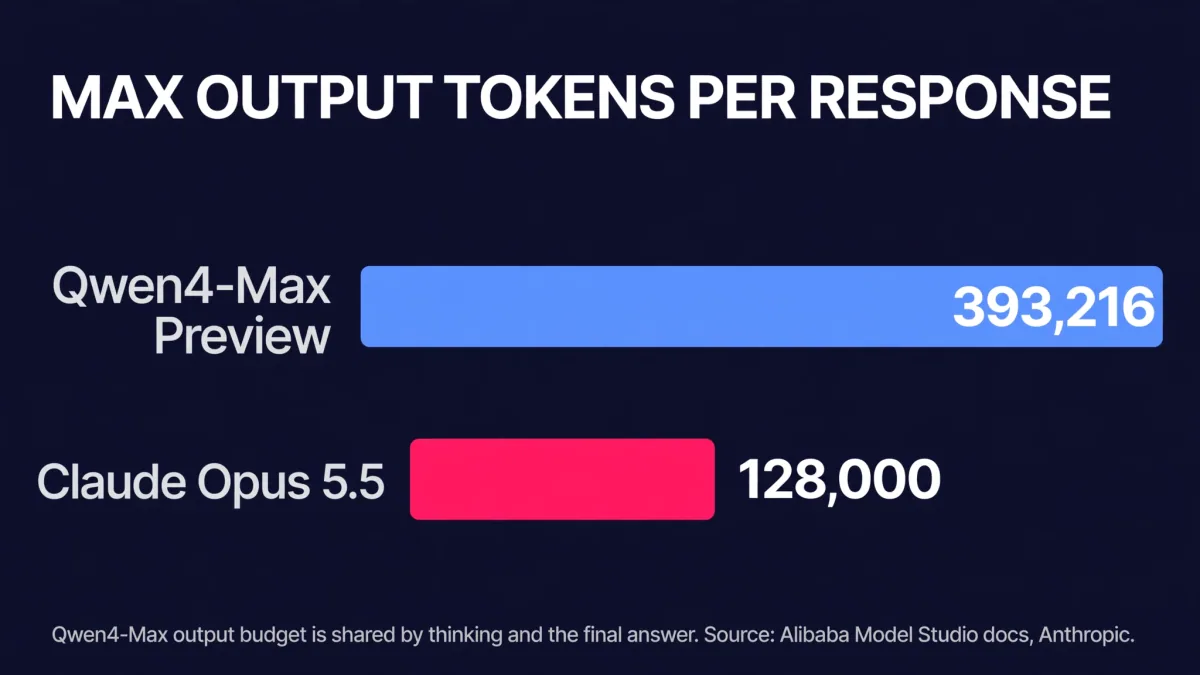
| Producción máxima | 393.216 fichas, compartidas por pensamiento y la respuesta final |
| Entrada | Texto, imágenes y vídeo |
| Pensamiento | Activado por defecto, reasoning_effort bajo, medio o xalto (por defecto xhigh) |
| Acceso | Solo suscripción al Plan de Tokens, endpoint de Singapur |
| Paga según la compra | No es compatible, una tecla Model Studio ordinaria no abre este modelo |
| Referencias | Ninguna publicada, reportada por el proveedor ni independiente |
| Recuento de parámetros | No publicado |
| Pesos y licencia | No publicado |
| Precio por token | No publicado |
El contexto de 1M de tokens no es nuevo para la familia. El anterior buque insignia, Qwen3.8-Max, se lanzó el 3 de agosto de 2026 con un contexto propio de un millón de tokens. Lo nuevo es el techo de salida: 393.216 tokens en una sola respuesta, con el razonamiento y la respuesta final compartiendo ese presupuesto. Eso es aproximadamente tres veces el techo estándar de salida de 128.000 tokens de Claude Opus 5.5.
El veredicto rápido
Qwen4-Max Preview es una prueba de dos semanas, no un modelo sobre el que puedas construir. El contexto de 1M y el enorme techo de salida son reales y documentados, y las primeras pruebas prácticas son rápidas. Pero sin benchmarks, sin precio por token y con una fecha de retirada estricta, nada de lo que midas o construyas sobre este modelo exacto sobrevive el 25 de noviembre. Pruébalo si tienes curiosidad o si lanzas en la pila de Alibaba. No migres el trabajo de producción a él.
| Pregunta | Respuesta corta |
|---|---|
| ¿Es rápido? | Las primeras pruebas dicen que sí, mucho más rápido que Qwen3.8-Max en las mismas tareas |
| ¿Está bien? | Desconocido, aún no existe ningún punto de referencia |
| ¿Es barato? | No existe un precio por token, solo una suscripción al Token Plan |
| ¿Puedo construir sobre ello? | No, se retira el 25 de noviembre de 2026 |
| ¿Es peso abierto? | No se publicaron pesos |
Vista previa de Qwen4-Max vs Claude Opus 5.5 vs Qwen3.8-Max
Esta es la comparación honesta: los números que existen, y los espacios en blanco donde no existen.
| Vista previa de Qwen4-Max | Claude Opus 5.5 | Qwen3.8-Max | |
|---|---|---|---|
| Ventana de contexto | 1.000.000 de fichas | 1.000.000 de fichas | 1.000.000 de fichas |
| Salida máxima por respuesta | 393.216 fichas | 128.000 tokens (300.000 en la API de lotes) | No publicado |
| Tipos de entrada | Texto, imagen, vídeo | Texto, imagen | Texto, imagen |
| Índice de Inteligencia de Análisis Artificial | No se publicó ninguna partitura | 59, clasificado 5º de 74 | 34 |
| Precio por cada 1M de fichas | No publicado, solo Token Plan | 4 dólares de entrada, 20 dólares de salida | No se trata aquí |
| Disponibilidad | 11-25 de noviembre de 2026, luego se jubiló | Activo, retirado no antes del 22 de septiembre de 2027 | Activo |
La ventana de contexto es un empate genuino a tres bandas con 1 millón de tokens. El techo de salida es donde destaca Qwen4-Max Preview, y la ventana de disponibilidad es donde se desmorona: 14 días frente a más de 300 días de disponibilidad garantizada para Opus 5.5.
Precios: una suscripción, no una tarjeta de tarifas
Alibaba no ha publicado precio por token para Qwen4-Max Preview. La única forma de acceder es el Plan de Token, una suscripción mensual para herramientas de codificación y agentes, y el uso reduce Créditos mensuales. La cobertura independiente de la página de precios lista planes individuales a 6 $ (Lite), 10 $ (Essential), 18 $ (Estándar) y 43 $ (Pro) al mes, con una oferta de lanzamiento de 3 $ al mes para nuevos usuarios. Alibaba no publica una tarifa de créditos por token para este modelo, por lo que no hay forma de calcular un coste por tarea hasta que gastes créditos y observes.
| Plan | Precio por mes |
|---|---|
| Oferta de lanzamiento para nuevos usuarios | $3 |
| Lite | $6 |
| Esencial | $10 |
| Estándar | $18 |
| Pro | $43 |
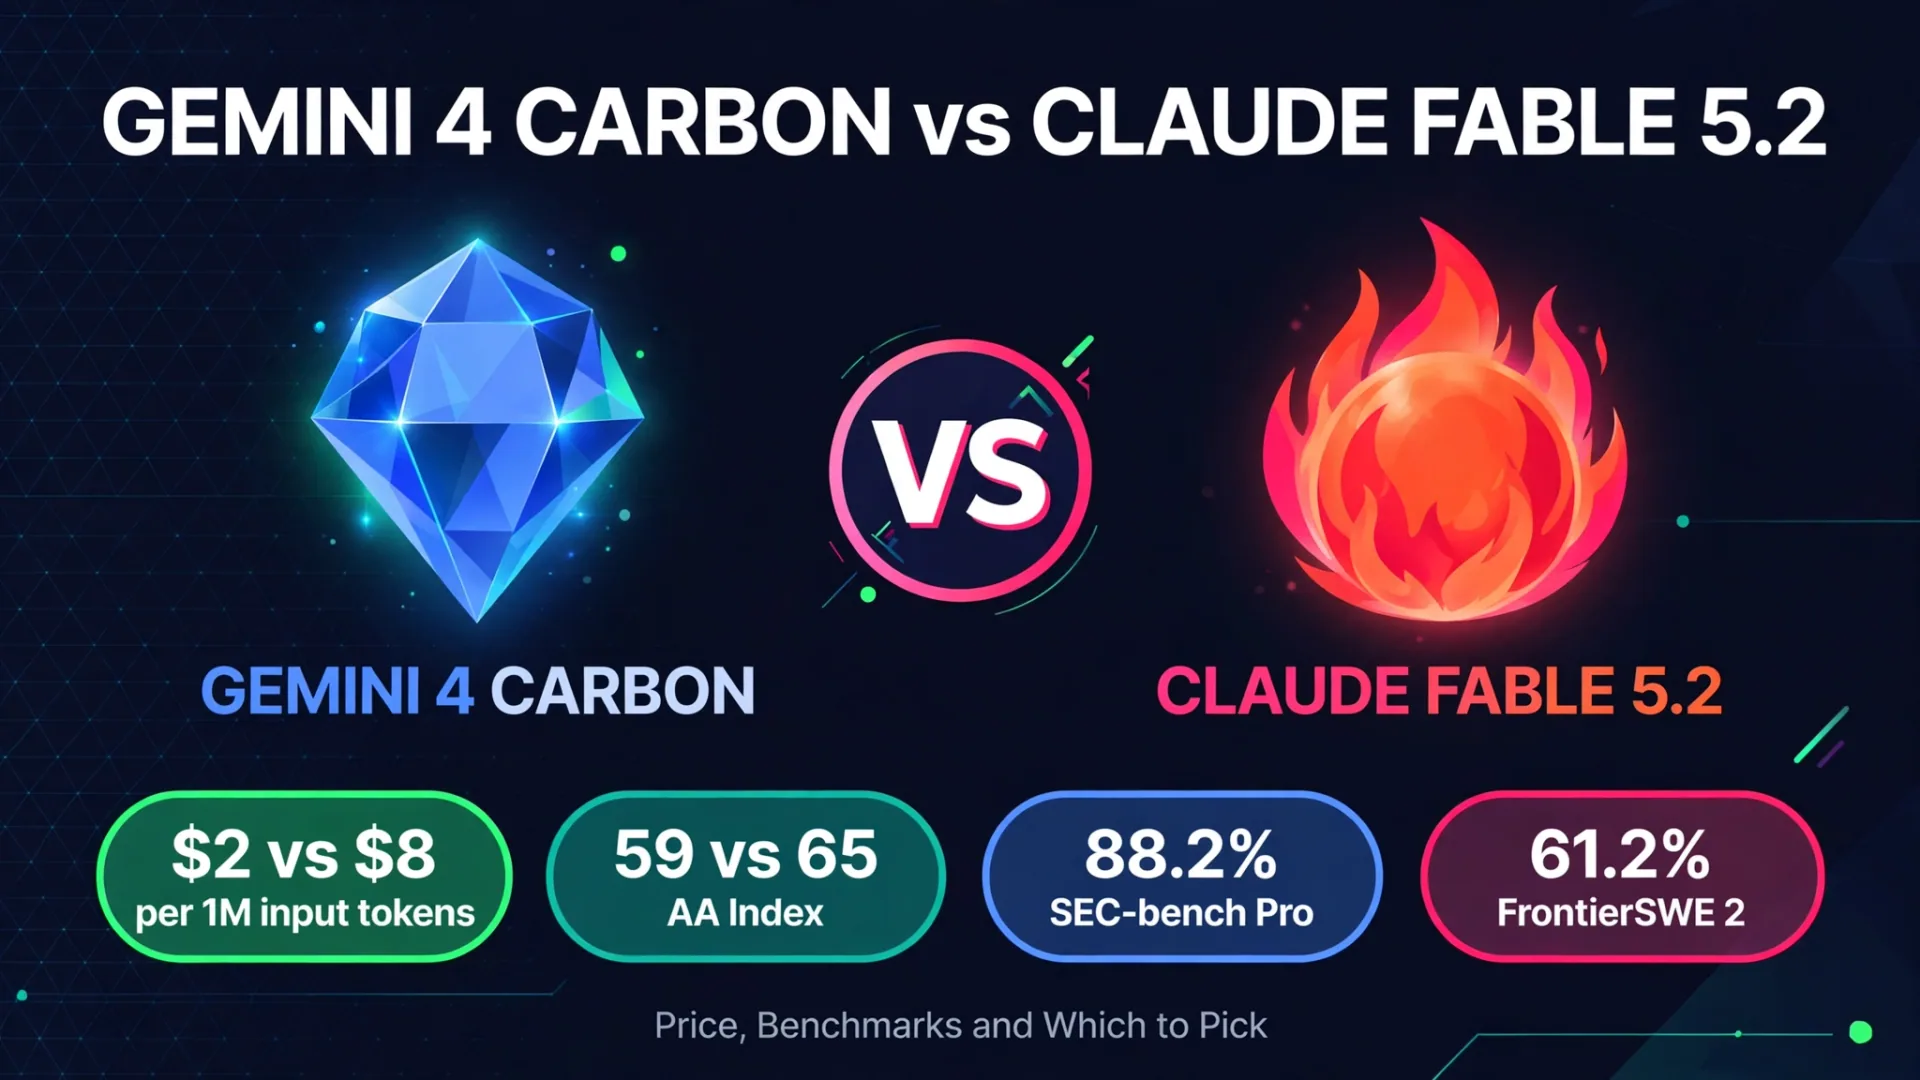
Compáralo con las tarjetas de tarifas en las que realmente puedes planificar: Claude Opus 5.5 con 4 $ de entrada y 20 $ de salida por 1 millón de tokens, y Gemini 4 Carbon vs Claude Fable 5.2: 2 $ frente a 8 $ para la actual guerra de precios en el segmento alto. Una suscripción sin tarifa publicada por token es lo opuesto a un precio transparente, y es la parte más débil de este lanzamiento.
Referencias: no hay ninguna
La documentación de la publicación de lanzamiento y el modelo de Alibaba no contienen números de referencia en absoluto. A fecha de 12 de noviembre, ningún laboratorio independiente había publicado ninguna puntuación tampoco. Artificial Analysis no tiene página para Qwen4-Max Preview, y LMArena no tenía puntuación. Un gráfico que muestra Qwen4-Max en el 53 del índice de Análisis Artificial circula en redes sociales, pero Artificial Analysis no incluye ninguna entrada de Qwen4, así que considera ese número como no verificado.
Lo que existe en su lugar son un puñado de pruebas prácticas:
| Prueba temprana | Resultado |
|---|---|
| 20 pruebas de codificación, Qwen4-Max vs Qwen3.8-Max | Qwen4-Max superó 20 de 20 en unos 2,5 minutos, Qwen3.8-Max tardó 17 minutos |
| Prueba de construcción del juego T-Rex | Terminó más rápido que Claude Fable 5.2 y Gemini 4 Carbon, pero el tester aún valoró a Fable como el mejor en general |
| Velocidad vs GPT-6.1 Terra | Un usuario de Hacker News encontró que Qwen4-Max era un poco más lento |
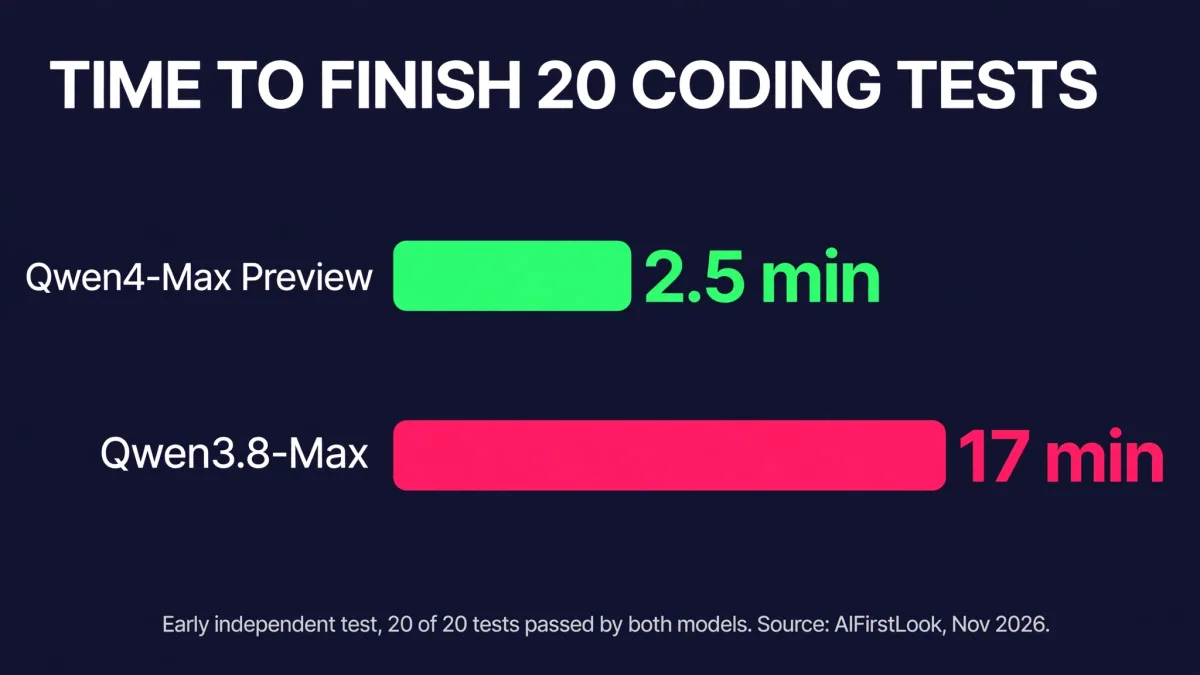
El resultado en 2,5 minutos frente a 17 minutos es la señal inicial más llamativa, unas 6,8 veces más rápida que la anterior insignia en las mismas 20 pruebas, con ambos modelos aprobando las 20. Pero es un pequeño conjunto de pruebas de un solo tester, no un benchmark. Hasta que un laboratorio ejecute una suite real, cada afirmación de calidad sobre Qwen4-Max es palabra o anécdota de Alibaba.
Para contextualizar cómo son las tablas de referencia reales cuando existen, véase Claude Fable 5.2: #1 a 65, 20% más barato, 30% más rápido y Gemini 4 Hidrógeno: 2,5 veces más rápido, 1,50 $ por 1 millón.
Qué falta y por qué es importante
La mitad que falta en este lanzamiento es más larga que la mitad enviada:
- Sin benchmarks. No hay nada que comparar con Claude Fable 5.2, GPT-6 o Gemini 4 Carbon. Cualquier página que clasifique a Qwen4-Max en calidad hoy en día es una suposición.
- No hay conteo de parámetros. Ni los parámetros totales ni los activos se publican, por lo que la memoria y la velocidad no pueden estimarse desde la arquitectura.
- No hay precio por ficha. No se puede calcular el coste por tarea, solo se siente después de gastar los Créditos.
- Sin pesas. No existe nada llamado Qwen4 en la organización Qwen en Hugging Face, así que no hay nada que autoalojar o afinar.
- No hay tarjeta modelo. No hay documentación publicada de seguridad, formación o evaluación.
- No hay fecha de lanzamiento completa. El resto de la familia Qwen4 no tiene fecha anunciada, y la página del Plan de Tokens no indica ningún reemplazo para la vista previa cuando se retire.
Alibaba congela el modelo para la ventana y lo retira después, por lo que cualquier referencia, estimación de coste o prueba de seguridad de este modelo exacto solo es útil hasta el 25 de noviembre. Esa es la verdadera historia de este lanzamiento: un buque insignia que puedes probar durante dos semanas y luego perder.
Cuál elegir
Prueba Qwen4-Max Preview si: ya usas el Token Plan de Alibaba, quieres probar el contexto de 1M y el techo de salida de 393.216 tokens en trabajos largos de agentes, o estás evaluando Qwen4 antes del lanzamiento completo. Trátalo como una demo con fecha límite.
Sáltate y usa Claude Opus 5.5 si: necesitas un modelo documentado con un precio publicado, puntuaciones reales de referencia y un compromiso de jubilación. Opus 5.5 obtiene una puntuación de 59 en el Índice de Inteligencia de Análisis Artificial, cuesta 4 $ de entrada y 20 $ de salida por cada token de 1 millón, y está garantizado disponible al menos hasta el 22 de septiembre de 2027.
Sáltalo y usa Qwen3.8-Max si: quieres la familia Qwen en una API normal hoy. Es la versión buque insignia anterior, tiene pesos abiertos y no va a desaparecer en dos semanas.
Espera a la versión completa de Qwen4 si: quieres referencias, pesos o un precio por token antes de comprometerte. La vista previa no responde a ninguna de esas preguntas.
Si tu equipo está decidiendo sobre qué modelo construir un producto de IA, esa elección importa mucho más que cualquier lanzamiento individual. Nuestra guía sobre cómo construir un agente de IA cubre cómo elegir un modelo, configurar evaluaciones y enviar un agente que siga funcionando tras el lanzamiento.
Preguntas frecuentes
¿Cuándo se retira la versión preliminar de Qwen4-Max?
25 de noviembre de 2026 a las 24:00 hora de Pekín, que es a las 11:00 a.m. ET del 25 de noviembre. La documentación de Alibaba indica que no se harán cambios durante el periodo de vista previa y que el modelo será retirado tras su finalización.
¿Cuánto cuesta la Vista Previa de Qwen4-Max?
No hay precio por token. El acceso se realiza mediante la suscripción al Plan de Tokens de Alibaba, con planes individuales listados en 6, 10 dólares, 18 y 43 dólares al mes, y una oferta de lanzamiento de 3 dólares al mes para nuevos usuarios. El uso reduce los créditos mensuales, y Alibaba no publica la tarifa de créditos por token para este modelo.
¿Tiene Qwen4-Max Preview benchmarks?
No. Alibaba no publicó ninguna tabla de referencia con la vista previa, y ningún laboratorio independiente había publicado una puntuación a fecha de 12 de noviembre de 2026. Un gráfico circulante que afirma el 53 en el índice de Análisis Artificial no está verificado, porque Análisis Artificial no incluye ninguna entrada de Qwen4.
¿Cuál es la ventana de contexto de la vista previa de Qwen4-Max?
1.000.000 de tokens, lo mismo que Claude Opus 5.5 y el anterior buque insignia Qwen3.8-Max. La salida máxima por respuesta es de 393.216 tokens, compartidos por el razonamiento del modelo y su respuesta final.
¿La versión preliminar de Qwen4-Max es de peso abierto?
No. No se han publicado pesos, licencias ni conteo de parámetros, y no existe nada llamado Qwen4 en la organización Qwen en Hugging Face. El resto de la familia Qwen4, incluido un modelo 27B destinado a despliegue local, no tiene fecha anunciada.
¿Cómo accedo a Qwen4-Max Preview?
Solo a través del Plan de Tokens de Alibaba, en el endpoint de Singapur token-plan.ap-southeast-1.maas.aliyuncs.com. No se soporta el sistema de pago por uso, y una clave de Model Studio ordinaria no abre este modelo. También está disponible en la aplicación Qwen.
La conclusión
Qwen4-Max Preview es el lanzamiento insignia más inusual de Alibaba: un modelo grande con una ventana de contexto amplia y un enorme techo de producción, enviado sin benchmarks, sin precio y con una fecha de caducidad de 14 días. La señal de velocidad temprana es real e impresionante, pero la velocidad en un pequeño set de pruebas no es calidad, y un modelo que se retira el 25 de noviembre no puede ser la base de nada de lo que envíes. Pruébalo esta semana si tienes curiosidad. Nunca construyas sobre ello.
- Qwen4-Max Preview
- Alibaba Qwen
- Qwen4
- AI benchmarks
- AI pricing