Noticias de IA6 min de lecturaPor JH Akash
Edge0-145B: 145B AI funciona con una RTX 5090
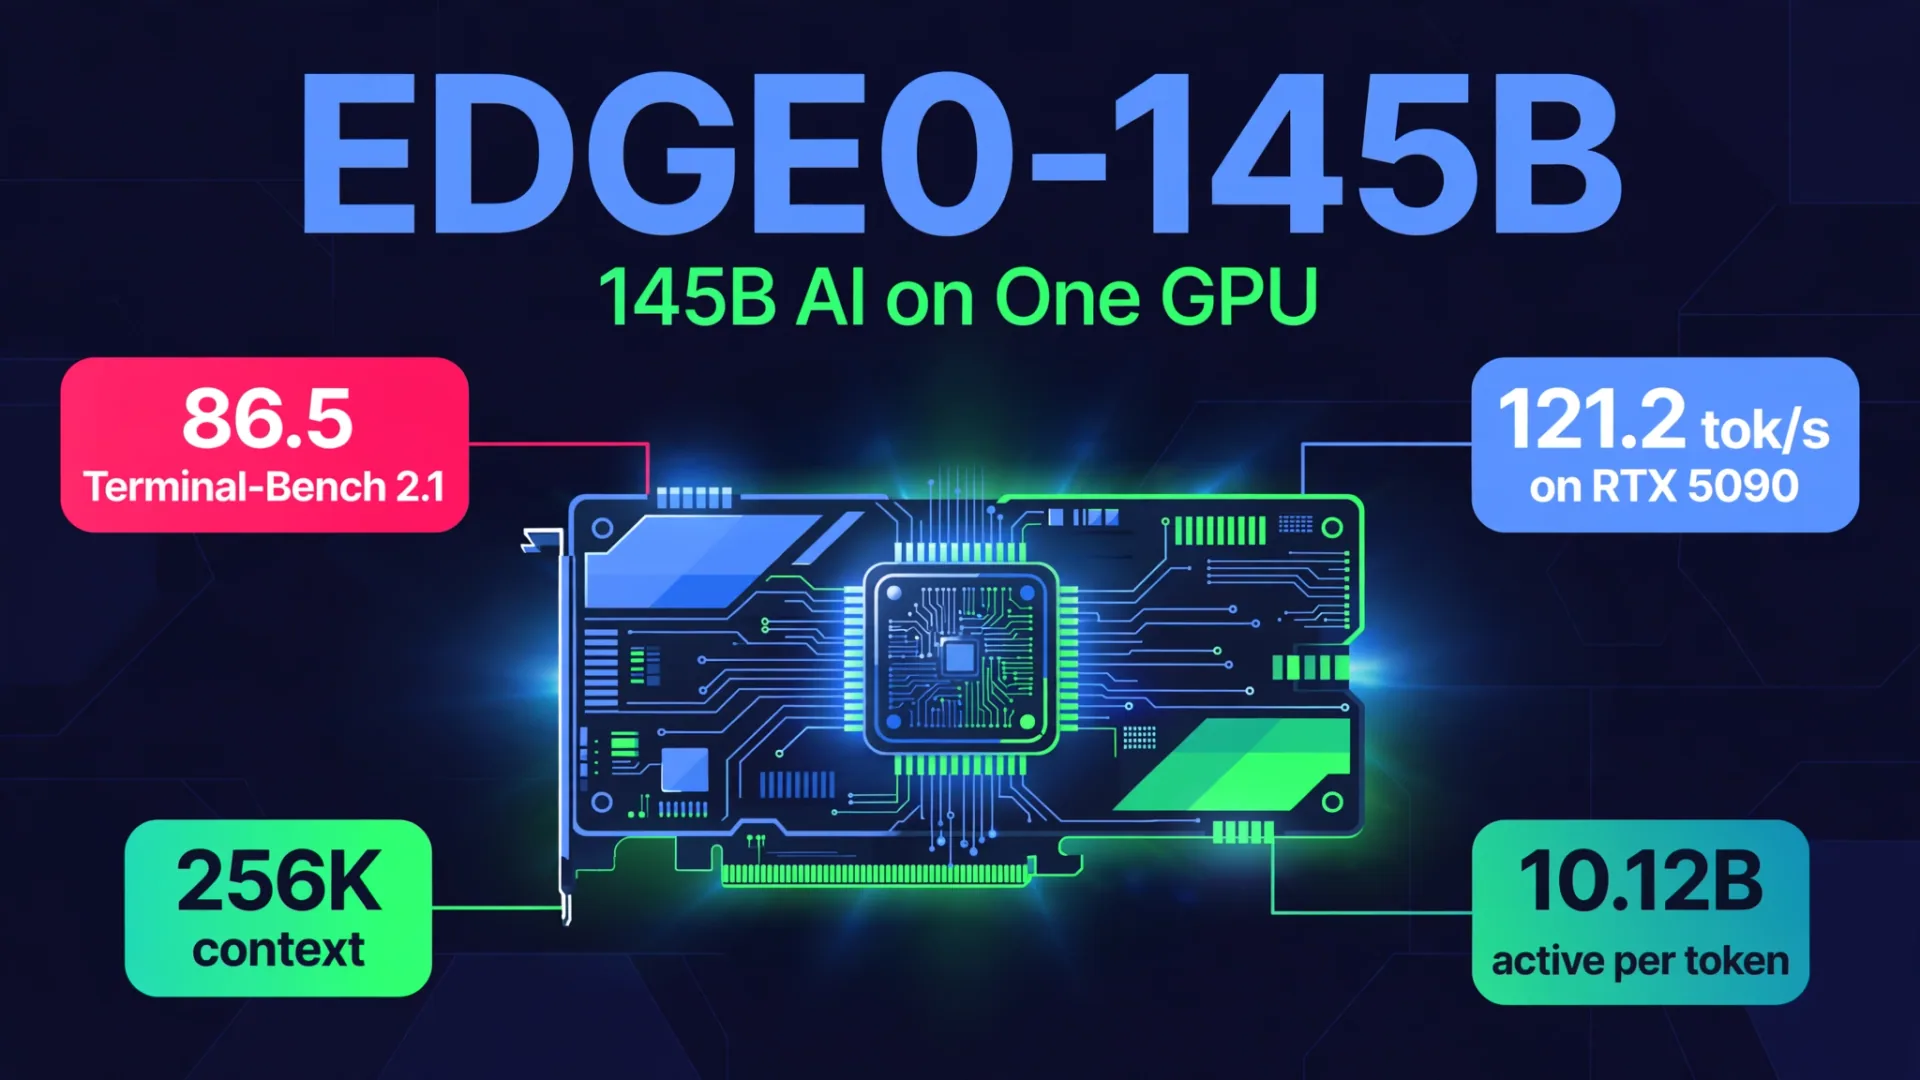
Edge0-145B agrupa 145B parámetros en una sola RTX 5090, obteniendo una puntuación de 86,5 en Terminal-Bench 2.1. Aquí están los benchmarks, velocidad, precio y los detalles.
Edge0-145B: 145B AI funciona con una RTX 5090
El 12 de noviembre de 2026, Edge0 lanzó Edge0-145B, un modelo de IA de 145.000 millones de parámetros que funciona en una única tarjeta gráfica de consumo. Los pesos se posaron en Hugging Face el 11 de noviembre, la entrada oficial del blog siguió el 12 de noviembre, y para el 14 de noviembre el modelo ya había superado las 61.000 descargas, con 11.379 estrellas en GitHub.
La afirmación principal es sencilla: IA de clase frontera, en tu propio ordenador, sin factura en la nube. Esto es lo que realmente es el modelo, qué dicen los números y dónde se esconden las letras pequeñas.
Qué es Edge0-145B
Edge0-145B es un modelo latente de mezcla dispersa de expertos. Tiene 145 mil millones de parámetros en total, pero solo 10.1200 millones están activos por cada token, por lo que cabe en una sola GPU. La arquitectura utiliza 48 capas y 512 expertos por capa, con 10 expertos enrutados más 1 experto compartido activo por token. Se entrenó nativamente con precisión de 4 bits y se entrega con una ventana de contexto de 256K tokens.
| Especificaciones | Edge0-145B |
|---|---|
| Parámetros totales | 145B |
| Activo por token | 10.12B |
| Arquitectura | MoE latente escaso, 48 capas, 512 expertos |
| Ventana de contexto | 256K fichas |
| Precisión de entrenamiento | 4 bits nativos |
| Pesos | Q3_K 40,81 GiB, NVFP4 47,79 GiB |
| Modelo base | Qwen3.8-Flash-Next (según los metadatos de Hugging Face) |
| Licencia | Licencia de Modelo Comunitario Edge0 1.0 |
| Lanzamiento | 12 de noviembre de 2026 |
Un hermano menor, Edge0-120B, se lanzó ese mismo día con 120B de parámetros totales y 8,64B activos por token.
Los números de velocidad
Edge0 informa de estas velocidades de decodificación a partir de sus propias pruebas, así que trátalas como reportadas por el proveedor hasta que existan ejecuciones independientes.
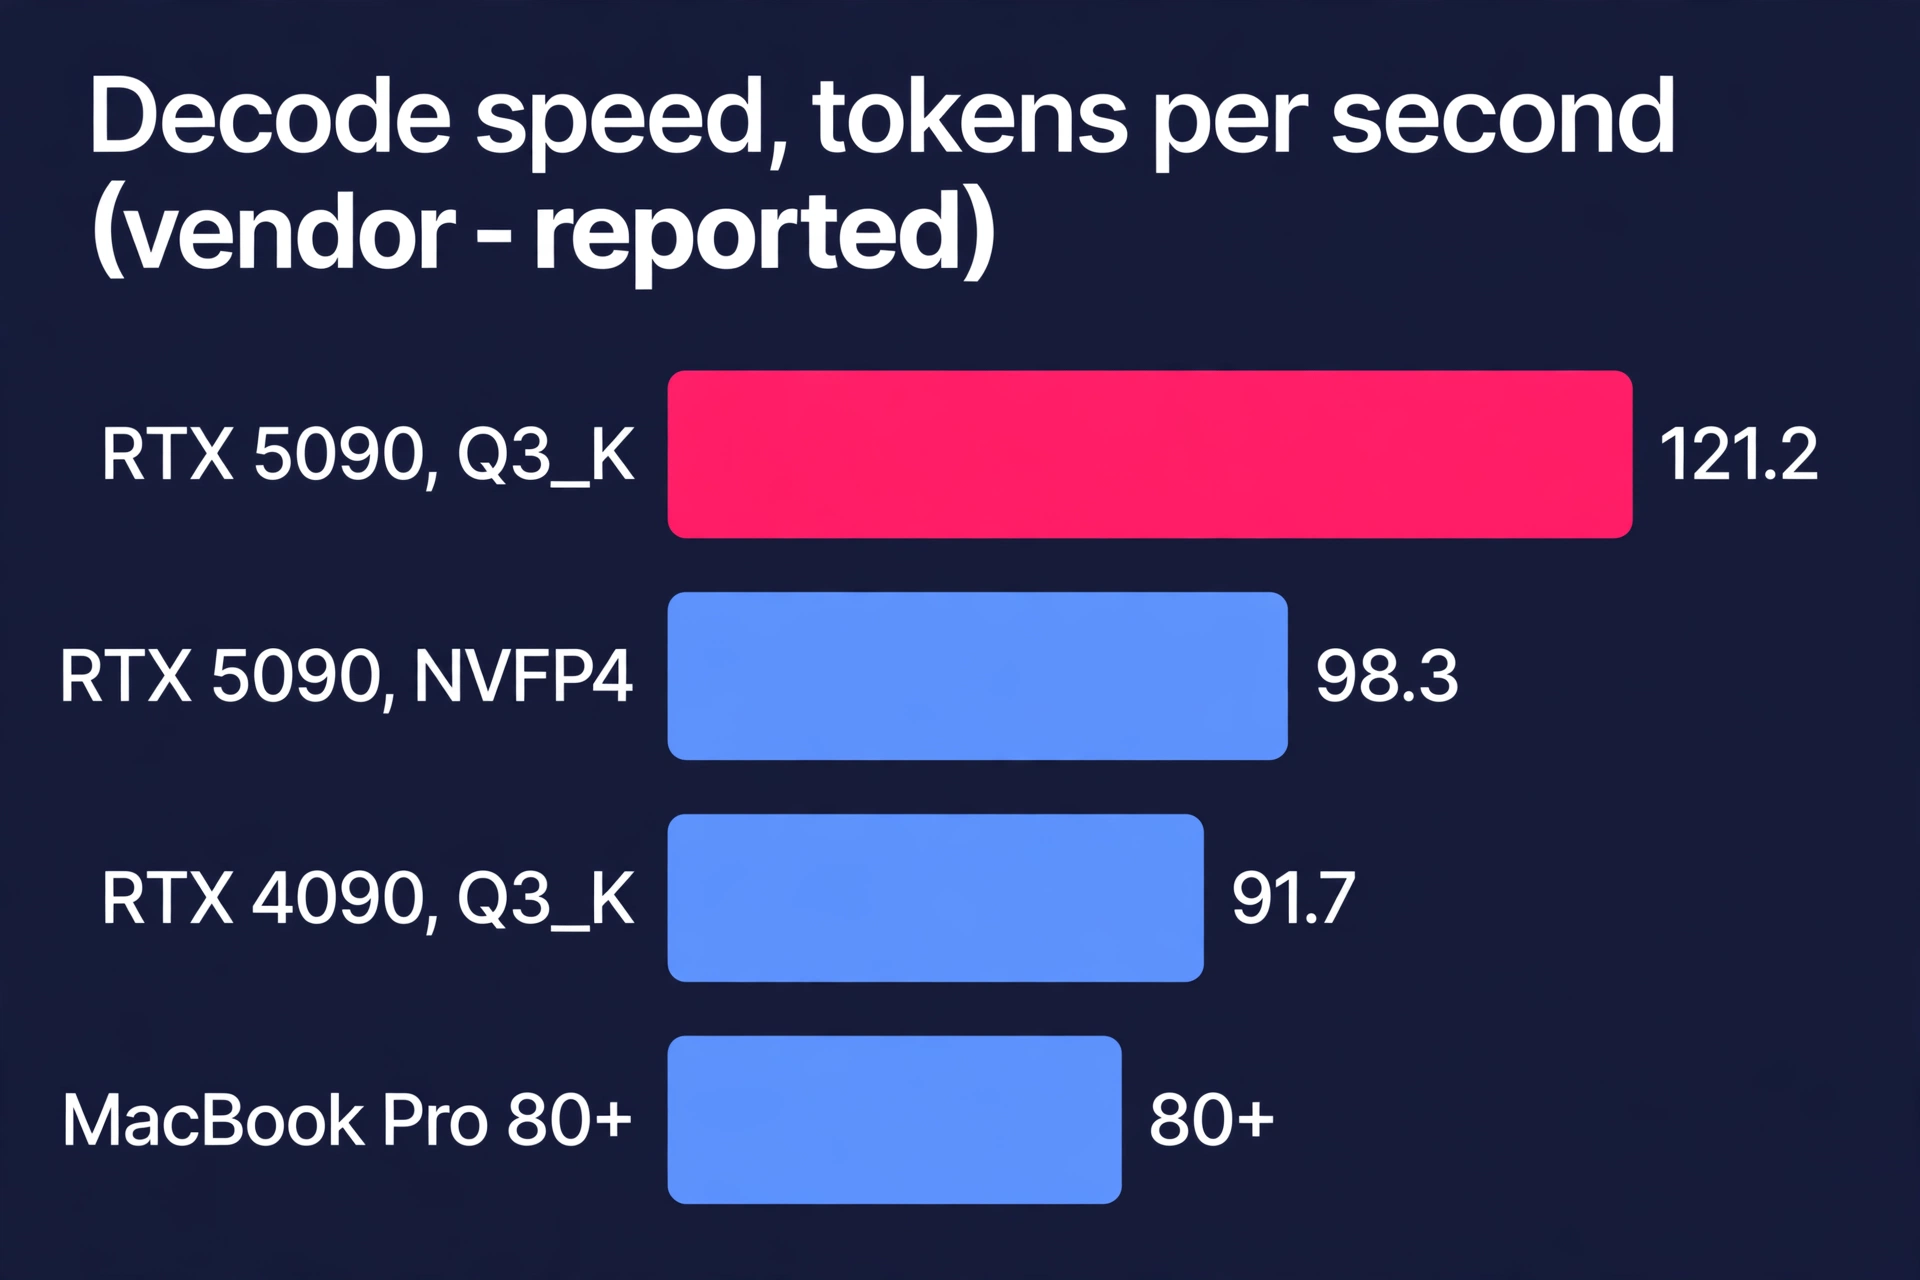
En una RTX 5090 D con 24 GB de memoria, la versión Q3K decodifica a 121,2 tokens por segundo con 3.554,9 tokens por segundo en prerelleno de 16K tokens. La versión NVFP4 funciona a 98,3 tokens por segundo de decodificación y 3.165,7 tokens por segundo de precargado. La misma versión Q3K alcanza 91,7 tokens por segundo en una RTX 4090. En un MacBook Pro, Edge0 reporta más de 1.100 tokens por segundo de precarga y más de 80 tokens por segundo de decodificación, con una potencia típica de unos 120W, con un contexto de 128K a 256K a casi la misma velocidad.
El soporte para el primer día cubre macOS, Windows y Linux en portátiles de la serie M de Apple y en las GPUs RTX Spark, RTX 4090 y RTX 5090.
Los números de referencia
Todas las puntuaciones siguientes provienen de evaluaciones internas propias de Edge0. La empresa dice que aún está en camino un informe técnico con instrucciones completas de configuración y reproducción, así que léyanlas como reclamaciones, no como mediciones asentadas.
| Índice de referencia | Edge0-145B | Comparación más cercana |
|---|---|---|
| DeepSWE 1.1 | 64.6 | Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4 |
| Terminal Bench 2.1 | 86.52 | Qwen3.8-Flash-Next 83.3, DeepSeek-V4-Flash 82.7, Claude Opus 4.6 Max 78.2 |
| GPQA-Diamond | 90.4 | DeepSeek-V4-Flash 90.8, Claude Opus 4.6 Max 91.3 |
| IFBench | 80.6 | - |
| HLE | 35.4 | - |
| AA-LCR | 79.3 | - |
| Media de seis referencias | 72.8 | Qwen3.8-Flash-Next 71.7 |
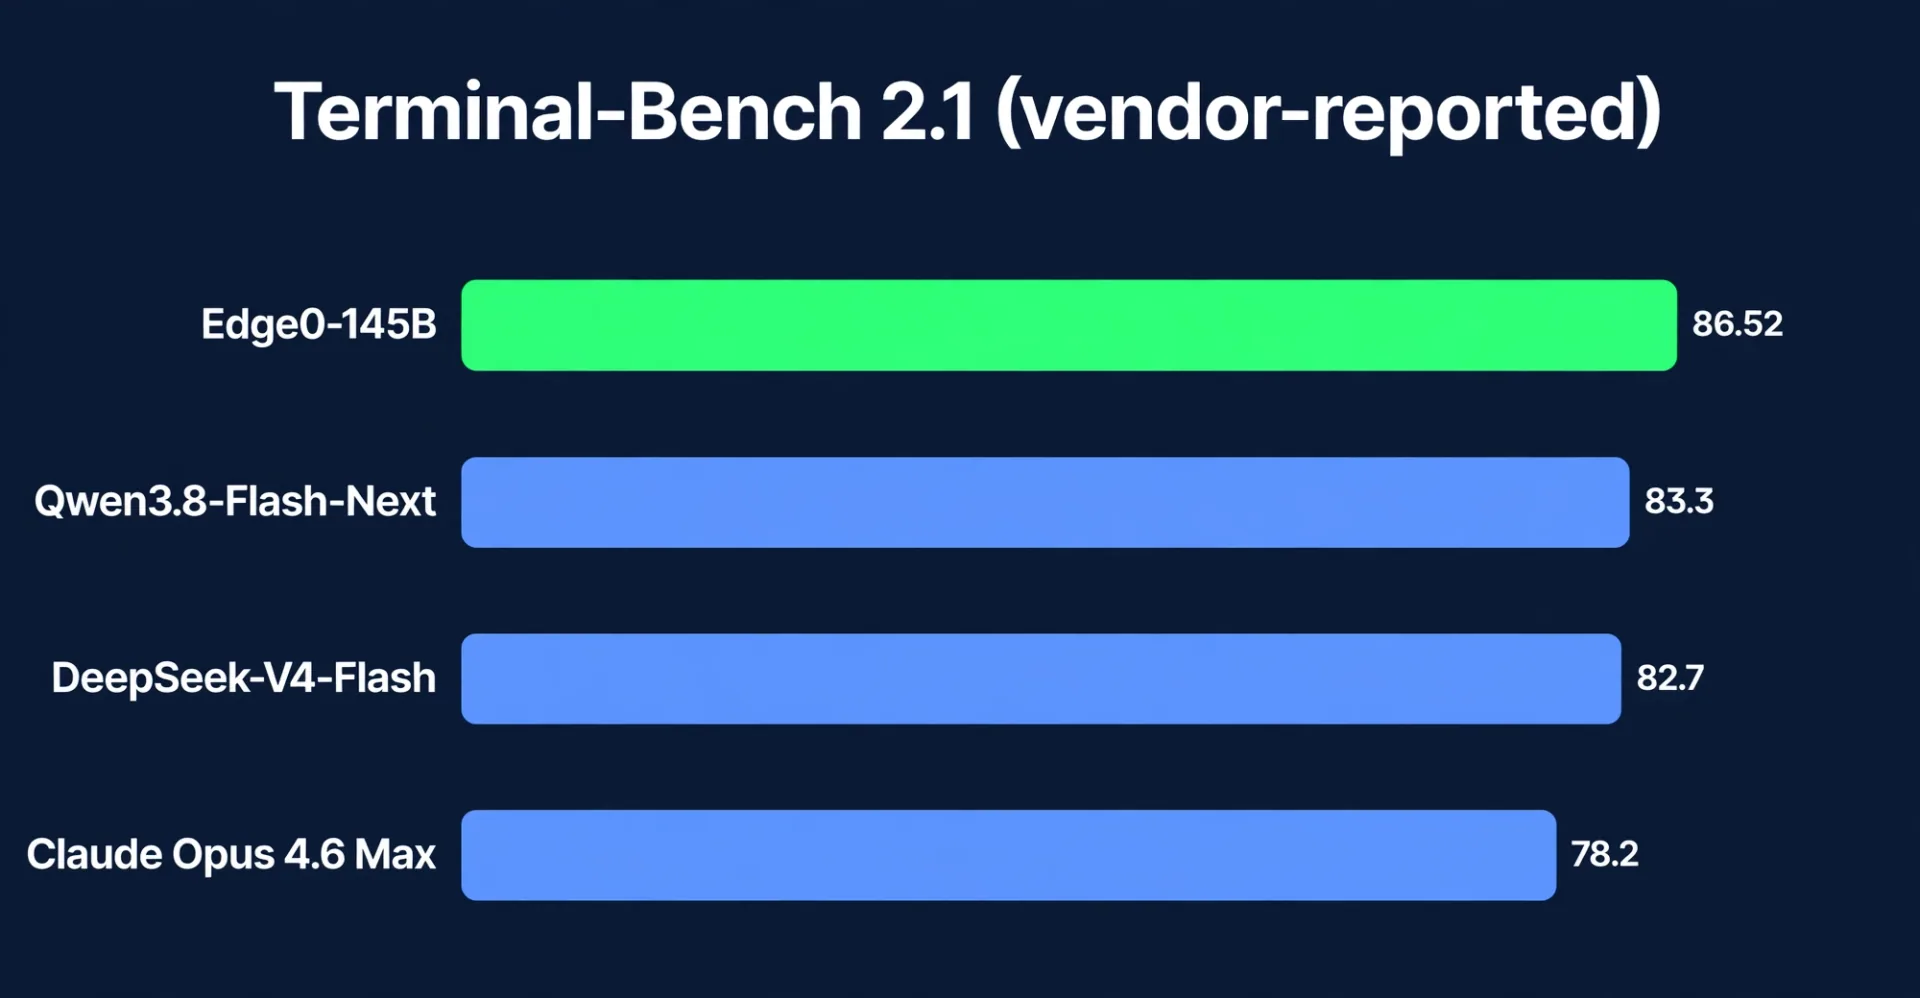
El resultado de Terminal-Bench 2.1 es el que llama la atención: 86,52 frente a 78,2 para Claude Opus 4.6 en su configuración Max. Pero fíjate en la columna GPQA-Diamond, donde Edge0 va por detrás tanto de DeepSeek-V4-Flash como de Claude Opus 4.6. Ningún benchmark único decide un modelo, y no existen "ganadores" de cross-benchmark. Pruébalo en tus propias tareas.
Cuánto cuesta
| Opción | Precio |
|---|---|
| Pesos Edge0-145B | Descarga gratuita |
| Marco de inferencia Edge0 | Apache 2.0, gratis |
| Tu coste | Una GPU, electricidad y tu tiempo |
| API de hidrógeno Gemini 4 | $1,50 por cada 1M de fichas de entrada |
| API de Claude Fable 5.2 | $8 por cada 1M de entrada, $40 por 1M de tokens de salida |
No hay factura por token con Edge0-145B. La operación es diferente: pagas en hardware y tiempo de configuración en lugar de comisiones de API, y tus datos permanecen en tu propia máquina. Para los equipos que construyen automatización en su propio hardware, ese intercambio es precisamente el objetivo. Si quieres ver cómo se compara el precio en la nube, nuestro análisis de Gemini 4 Hydrogen cubre el modelo de 1,50 $ por token de 1 millón de Google, y la historia de la IPO de Anthropic muestra cuánto valoran ahora los inversores a la empresa detrás de Claude.
Las capturas
Tres cosas que debes saber antes de descargar.
El titular de 29 GB necesita contexto. Edge0 dice que el modelo funciona con 29 GB de memoria máxima en un portátil, pero la tarjeta modelo Hugging Face mide unos 61,5 GiB en total para la versión NVFP4: 23,25 GiB de memoria de vídeo más 38,27 GiB de RAM del sistema. La cifra de 29 GB es solo memoria GPU. Asegúrate de que tu equipo tenga la RAM correspondiente.
Es open-weight, no open-source. Los weights están bajo la Edge0 Community Model License 1.0, que reserva algunos usos, como vender, alquilar o licenciar los weights y ejecutar un servicio de modelo, para una licencia escrita separada. El código del framework de inferencia es Apache 2.0, pero los weights no lo son. Lee la licencia antes de construir un producto comercial sobre ella.
Está construido sobre Qwen. Los metadatos de Hugging Face mencionan el Qwen3.8-Flash-Next de Alibaba como modelo base, y la versión es un derivado de ese modelo. El propio blog de Edge0 no menciona a Qwen. Eso importa si tus normas de cumplimiento se preocupan por la línea de modelos de la empresa.
Cuál elegir
Elige Edge0-145B si tienes una GPU de 24 GB o un portátil Apple Silicon potente, quieres que tus datos se mantengan locales y ejecutas agentes o cargas de código donde una factura de la nube por token sería perjudicial. Saca la versión NVFP4 o Q3_K, ejecuta tus flujos de trabajo reales y compara con tu pila actual en calidad, latencia y coste eléctrico.
Quédate con un modelo en la nube si necesitas una API gestionada, disponibilidad garantizada o un modelo con verificación independiente de benchmarks. El informe técnico de Edge0-145B sigue pendiente y ningún laboratorio independiente ha reproducido aún las puntuaciones principales.
Espera y observa si estás decidiendo entre Edge0-145B y su hermano. Edge0-120B es más pequeño y barato de ejecutar, y la primera oleada de pruebas independientes nos dirá cuál es la mejor opción. Para una visión más amplia de la decisión build-front-com-buy, consulta Custom AI vs Ready-the-Shelf: 76% Compra Primero.
Preguntas frecuentes
¿Es realmente gratis Edge0-145B?
Los pesos se pueden descargar gratis desde Hugging Face, y el framework de inferencia es Apache 2.0. Sigues pagando por la GPU, la electricidad y el tiempo de configuración, y algunos usos comerciales necesitan una licencia separada bajo la Edge0 Community Model License 1.0.
¿Puede funcionar el Edge0-145B en un portátil?
Edge0 dice que sí: en un MacBook Pro reporta más de 80 tokens por segundo de decodificación con 29 GB de memoria GPU pico. La superficie total medida es de unos 61,5 GiB incluyendo la RAM del sistema, así que se necesita un portátil bien especificado.
¿Qué velocidad tiene el Edge0-145B en una RTX 5090?
Edge0 informa de 121,2 tokens por segundo de decodificación con la versión Q3_K y 98,3 tokens por segundo con la versión NVFP4, cifras reportadas por el fabricante según las propias pruebas de la compañía.
¿Es mejor el Edge0-145B que el Claude Opus 4.6?
En Terminal-Bench 2.1, Edge0 reporta 86,52 frente a 78,2 para Claude Opus 4.6 Max. En GPQA-Diamond, Claude lidera 91,3 a 90,4. Las puntuaciones son reportadas por el proveedor y aún no existe una verificación independiente, por lo que no hay un ganador definido.
¿Dónde puedo descargar Edge0-145B?
Los peses están en Hugging Face bajo Edge0/Edge0-145B-q3k y Edge0-145B-NVFP4, y el marco de inferencia y las herramientas de despliegue están en GitHub bajo Edge0-AI/Edge0.
¿Cuál es la diferencia entre Edge0-145B y Edge0-120B?
Edge0-145B tiene 145B de parámetros totales con 10,12B activos por token; Edge0-120B tiene 120B en total con 8,64B activos. Ambos se lanzaron el 12 de noviembre de 2026, y el modelo 120B es la opción más ligera y barata de usar.
- Edge0-145B
- open source AI
- local AI
- RTX 5090
- AI benchmarks