AI8 min leestijdDoor JH Akash
LongCat 2.5 Uitgelegd: Meituan's 1.6T multimodale coderingsmodel
Meituan's LongCat 2.5 ging live op 2 november 2026: 1,6T parameters, 1 miljoen context, native beeld- en video-invoer, tegen $0,30/$1,20 per miljoen tokens. Benchmarks, prijs en de addertjespunten om te weten voordat je overstapt.
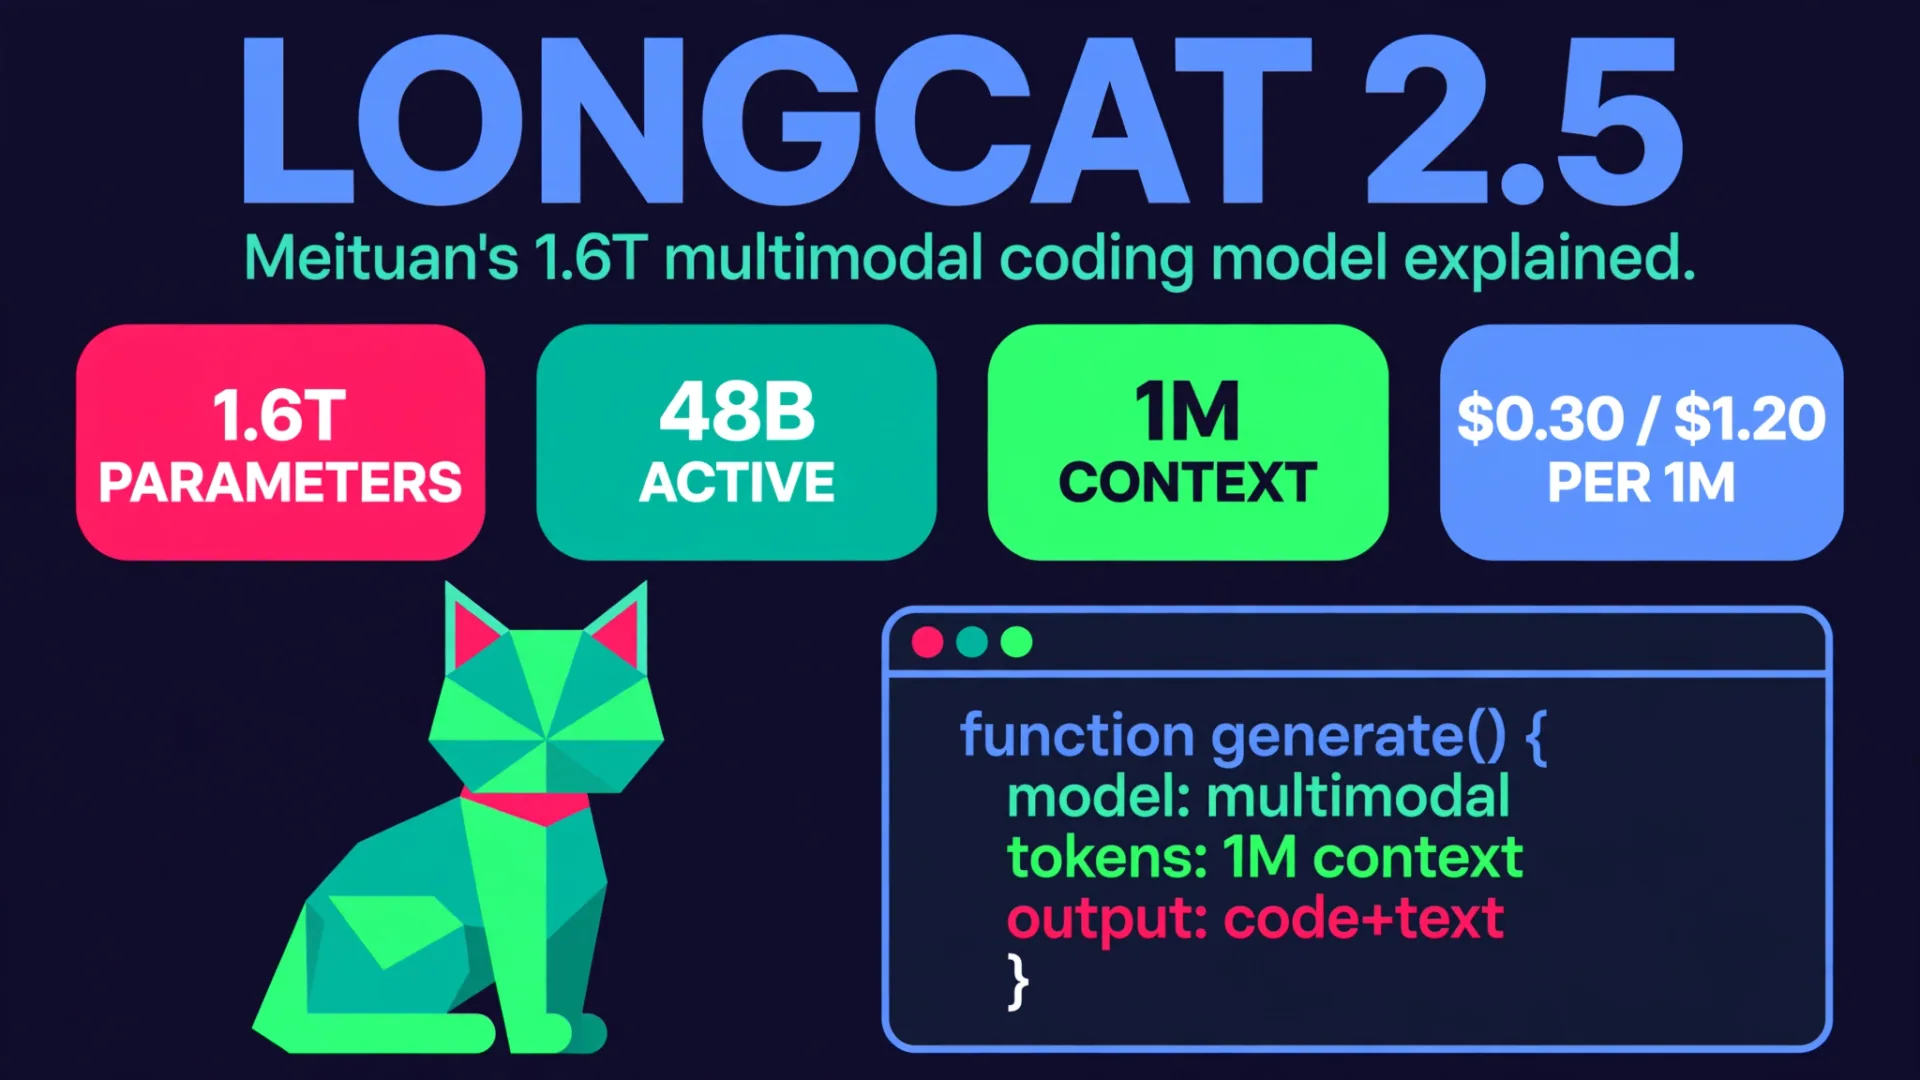
Het LongCat-team van Meituan bracht LongCat 2.5 uit op 2 november 2026, en de pitch is makkelijk te begrijpen: een model dat tekst, afbeeldingen en video kan lezen, lange coding-agent-taken kan uitvoeren, en dat kan doen tegen $0,30 per miljoen inputtokens en $1,20 per miljoen output tokens. De cijfers onder die pitch zijn interessanter dan de kop. LongCat 2.5 is een grote sprong ten opzichte van LongCat 2.0, het evenast met DeepSeek V4.1 Flash qua prijs, en de eigen benchmarktabel laat zien waar een goedkopere concurrent nog steeds voorloopt op puur coderen.
Dit is geen nieuw, groter model. LongCat 2.5 bouwt voort op LongCat 2.0, een model met 1,6 biljoen parameters van experts en ongeveer 48 miljard actieve parameters per token. De verandering is wat het model kan zien en hoeveel agenttraining het heeft gehad. Alle benchmarkscores in dit bericht worden door de leverancier gerapporteerd door Meituan, tenzij anders vermeld, en er was op het moment van schrijven geen onafhankelijk leaderboard een score van LongCat 2.5.
Snel oordeel
| Item | LongCat 2.5 |
|---|---|
| Uitgebracht | 2 november 2026, algemene beschikbaarheid op het LongCat API-platform |
| Grootte | 1,6 biljoen totale parameters, ongeveer 48 miljard actief per token |
| Input | Tekst, afbeeldingen en video. Output is alleen tekst |
| Context | 1 miljoen tokens. Plan ongeveer 128.000 tokens met maximale output |
| Prijs | $0,30 per miljoen niet-gecachete inputtokens, $0,006 per miljoen gecachte inputtokens, $1,20 per miljoen outputtokens, allemaal aangeduid met een tijdelijke korting |
| Gewichten | Niet uitgebracht. GitHub en Hugging Face zijn gemarkeerd als "binnenkort beschikbaar" |
| Het beste voor | Budgetcodeeragenten die screenshots of schermopnames moeten lezen |
| Pas op voor | Geen lijstprijs, geen gepubliceerd beleid voor gegevensbewaring, en nog geen onafhankelijke scores |
Wat is er veranderd ten opzichte van LongCat 2.0
LongCat 2.0 was alleen tekst- en open weight-functionaliteit, uitgebracht onder een MIT-licentie met gewichten op Hugging Face. LongCat 2.5 behoudt hetzelfde 1.6T / 48B-skelet en voegt native vision plus long-horizon agenttraining toe. De preview verscheen op 25 september 2026 en algemene beschikbaarheid volgde op 2 november 2026, met toevoeging van video-invoer en Codex-ondersteuning.
Visie is de hoofdfunctie. LongCat 2.5 zet afbeeldingen om in afzonderlijke tokens in dezelfde stroom als woorden, in plaats van een beeldencoder aan een tekstmodel te bevestigen. In de praktijk betekent dat native resolutie: een hoge screenshot wordt meer tokens in plaats van een samengedrukte thumbnail. De documentatie staat tot 50 afbeeldingen per verzoek toe van maximaal 10 MB per stuk, en tot 10 video's tot 100 MB elk en minder dan 3.600 seconden. Er is geen aparte prijslijn voor afbeeldingen of video. Je betaalt voor de tokens waarin ze veranderen.
Aan de agentkant beschrijft Meituan grootschalig long-horizon reinforcement learning op taken die zijn opgebouwd uit gefilterde GitHub-pull requests, met straffen voor repetitief redeneren en herhaalde toolcalls. Dat is belangrijk omdat het herhalen van lange taken de luidste klacht was van preview-gebruikers. Of algemene beschikbaarheid het heeft opgelost is het eerste wat je in je eigen repo moet testen.
LongCat 2.5 werkt ook over agent-harnasjes, met handleidingen voor Claude Code, Codex, OpenCode, Cline, Kilo Code en Hermes Agent, onder anderen. Het ondersteunt OpenAI-compatibele en Anthropic-compatibele eindpunten, dus het wisselen van harnasen is meestal een basis-URL en modelnaamwijziging: LongCat-2.5.
Benchmarks: een echte sprong, met een vangst
Meituans eigen tabel toont een grote sprong ten opzichte van LongCat 2.0 op agenttaken. Dit zijn door leveranciers gerapporteerde scores, uitgevoerd met denken ingeschakeld.
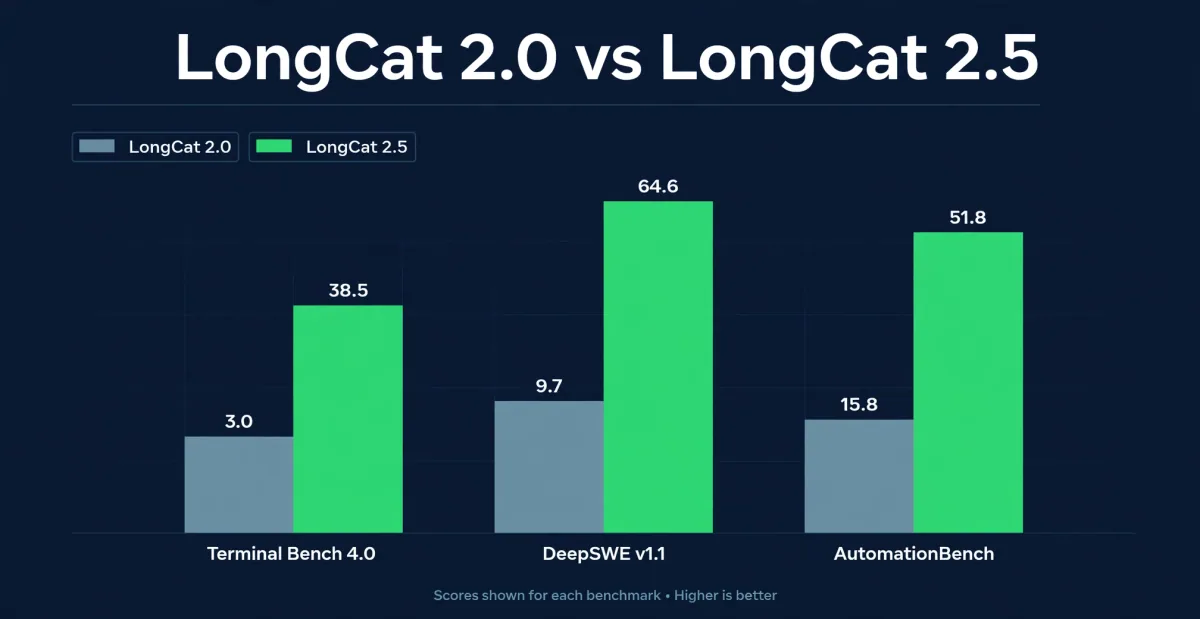
| Benchmark | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| 3DCodeBench tekst naar 3D | 55.4 | Niet gerapporteerd | 53.4 | 49.3 | 54.3 |
| Vision2Web | 78.6 | Niet gerapporteerd | Niet gerapporteerd | 79.0 | 80.2 |
Bron: Meituan LongCat 2.5 tech blog evaluatietabel De scores voor andere modellen zijn een mix van Meituans eigen runs en cijfers uit openbare rapporten, waarvan Meituan zegt dat ze alleen indicatief zijn. Verschillende benchmarks gebruiken verschillende harnasjes, dus vergelijk scores tussen benchmarks niet alsof het één ranking is.
Leest eenvoudig: LongCat 2.5 leidt zijn prijsconcurrent op Terminal Bench 4.0 (38,5 tegenover 31,2), BrowseComp (91,9 tegenover 91,5) en 3DCodeBench Text naar 3D (55,4 tegenover 53,4). DeepSeek V4.1 Flash leidt op Terminal Bench v2.1, DeepSWE v1.1, NL2Repo, MCP Atlas en AutomationBench (54,8 tegenover 51,8). LongCat 2.5 is een van de twee met gepubliceerde videoscores, en de resultaten van BrowseComp en 3D passen bij de vision-first pitch.
De vergelijkingsset is ook het vermelden waard. De kopgrafieken van Meituan vergelijken met Claude Opus 5, GPT-5.6-Sol, Claude Opus 4.8 en GPT-5.5. Ze bevatten niet Claude Opus 5.5, GPT-6.1 Sol of Kimi K3.1 Pro. Voor het nieuwste frontierbeeld, zie onze eerdere berichten over Claude Opus 5.5 en GPT-6 Astra, en onze BNPX-benchmarkanalyse, waarbij Opus 5.5 aan de leiding staat met 12,0%.
Prijs: goedkoop, maar met korting en tijdelijk
| Model | Invoer per 1M tokens | Gecachte invoer per 1M tokens | Output per 1M tokens |
|---|---|---|---|
| LongCat 2.5, tijdelijke korting | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, hoogtepunt | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, buiten de piek | $0.15 | $0.003 | $0.60 |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 |
| Kimi K3.1 Pro | $2.00 | $0.20 | $10.00 |
| Kimi K3 | $3.00 | $0.30 | $15.00 |
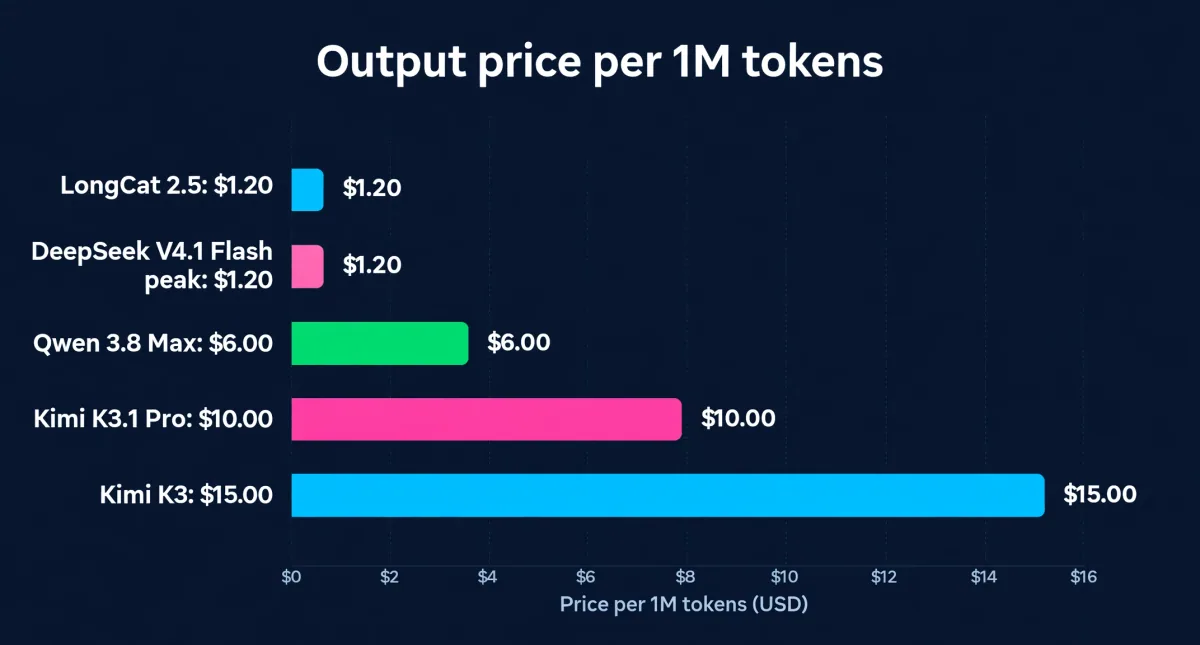
Twee details maken de prijs nuttiger dan de kop. Gecachte invoer kost slechts 2% van de niet-gecachte invoer, wat belangrijk is voor codeeragenten die elke beurt dezelfde bestanden opnieuw verzenden. En er is geen toeslag voor contextlengte, dus een lange aanvraag kost per token hetzelfde als een korte.
Een eenvoudige rekening helpt. Een taak met 800.000 niet-gecachete inputtokens en 200.000 outputtokens kost $0,48 op LongCat 2.5: 0,8 keer $0,30 plus 0,2 keer $1,20. Meituans eigen uitgewerkte voorbeeld, 600.000 niet-gecachete inputtokens, 400.000 gecachte inputtokens en 500.000 outputtokens, kost $0,7824.
Het risico zit in het kortingslabel. Elke LongCat 2.5-prijs draagt de woorden "limited-time discount", zonder vermeldingsprijs en zonder publicatiedatum. Een oudere LongCat 2.0-pagina toonde een lijstprijs van $0,75 input, $0,015 gecachet en $2,95 output naast dezelfde korting. Meituan heeft niet gezegd dat LongCat 2.5 naar die listprijs zal gaan, maar budgetteer alleen op het gereduceerde tarief als je een stijging kunt accepteren.
Welke kies je
Probeer LongCat 2.5 als je coding agents met een beperkt budget gebruikt en er een wilt die screenshots of schermopnames kan lezen. Voor $0,30 / $1,20 met 2% gecachede input kost een middag testen op je eigen repo een paar dollar. Vergelijk het direct met DeepSeek V4.1 Flash tegen dezelfde prijs, op je eigen taken, niet op launchcharts.
Kies in plaats daarvan voor DeepSeek V4.1 Flash als long-horizon coding het hele werk is. Op Meituans eigen tabel leidt het op meer codeerrijen en halveert het de prijs buiten de piek. Het heeft ook een langere maximale output in vergelijkingen met derden, namelijk 384.000 tokens tegenover de geplande 128.000 van LongCat 2.5.
Wacht maar als je open gewichten, een licentie of zelfhosting nodig hebt. LongCat 2.5 is voorlopig alleen API, en zelfs als gewichten arriveren, heeft een 1.6T-model een multi-GPU setup nodig. LongCat 2.0 blijft de downloadbare optie.
Sla het voorlopig over als je prompts klant- of gereguleerde data bevatten. De LongCat-FAQ- en facturatiepagina's zeggen niets over hoe lang prompts worden bewaard of of API-verkeer wordt gebruikt voor training. Die stilte is de beslissing, ongeacht de prijs.
Als je agenten bouwt voor klanten in plaats van modellen zelf te testen, is het model slechts één onderdeel van het systeem. Onze AI-agentontwikkelingsdiensten en AI-automatiseringsbureaus behandelen het omliggende werk: tools, controles, escalatieregels en implementatie.
Vangsten om te kennen vóór je eerste run
- Verwarring over de outputlimiet. De modelparameters-pagina staat maximaal 262.144 tokens toe, maar de quick start, FAQ en Meituan's eigen Claude Code-configuratie wijzen allemaal op 128.000. Plan rond de 128.000 en beschouw alles daarboven als een bonus om te testen.
- Temperatuur is vast. Het is 1,0 met denken aan en 0,7 met denken uit, en andere waarden worden stilletjes overschreven in plaats van verworpen. Als je evaluatie-harnas de temperatuur overneemt, doet het niet wat jij denkt.
- Snelheidslimieten zijn niet gepubliceerd. Limieten zijn per API-sleutel en geven een 429 terug met een hint van 60 seconden voor het opnieuw proberen, maar er wordt geen aantal verzoeken per minuut of tokens per minuut gepubliceerd.
- Oude model-ID's kunnen verdwijnen. LongCat 2.0 en 2.5-Preview zijn uit de tabellen voor ondersteunde modellen verdwenen zonder gedateerde pensioenmelding. Als je een oude ID hebt vastgepind, test die dan vandaag nog.
- Nog geen onafhankelijke scores. Artificial Analysis vermeldt alleen LongCat 2.0, en OpenRouter geeft alleen LongCat 2.0 terug. Een onafhankelijke preview-test rapporteerde een heel ander Terminal Bench 2.1-resultaat dan Meituan's 88.4, op een ander kabelboom. Doe je eigen test voordat je je committeert.
FAQ
Wat is LongCat 2.5?
LongCat 2.5 is Meituan's nieuwste grote taalmodel, algemeen beschikbaar op het LongCat API-platform sinds 2 november 2026. Het neemt tekst, afbeeldingen en video als input, is afgestemd op langlopende codeeragenten en volgt de open-weight LongCat 2.0 op.
Hoeveel kost LongCat 2.5?
LongCat 2.5 kost $0,30 per miljoen ongecachede inputtokens, $0,006 per miljoen gecachte inputtokens en $1,20 per miljoen output tokens. Meituan labelt alle drie als een tijdelijke korting en publiceert geen lijstprijs of einddatum, dus de prijs kan stijgen. Dat is hetzelfde tarief als DeepSeek V4.1 Flash tijdens piekuren.
Is LongCat 2.5 open source?
Nog niet. Meituan's launchblog markeert de GitHub- en Hugging Face-links als "binnenkort" en per 3 november 2026 was er geen LongCat 2.5-repository of licentie verschenen, dus het is voorlopig alleen API. LongCat 2.0 blijft het nieuwste LongCat-model met open MIT-gewichten.
Kan ik LongCat 2.5 gebruiken in Claude Code of Codex?
Ja. De documentatie van Meituan laat zien hoe je Claude Code naar het Anthropic-formaat eindpunt kunt richten met het model ingesteld op LongCat-2.5, en er is een bijpassende gids voor Codex die de Responses API gebruikt. Verwacht eigenaardigheden: de temperatuur wordt vastgesteld door het platform en de output is beperkt tot 128.000 tokens in de documentatie.
Hoe verhoudt LongCat 2.5 zich tot DeepSeek V4.1 Flash?
Qua prijs komen ze overeen op piek: $0,30 in en $1,20 uit per miljoen tokens. Op Meituan's eigen benchmarktabel leidt LongCat 2.5 op Terminal Bench 4.0, BrowseComp en 3DCodeBench Text naar 3D, terwijl DeepSeek V4.1 Flash leidt op meer long-horizon codeerrijen en goedkoper is buiten pieken. LongCat 2.5 voegt video-invoer toe, wat DeepSeek V4.1 Flash in deze vergelijking niet evenaard.
Is LongCat 2.5 goed voor klantenservice?
Niet als eerste keuze vandaag. De documentatie van LongCat zegt niets over databehoud of training op API-data, wat belangrijk is als prompts klantgegevens bevatten. Voor supportwerk is een geteste helpdeskmedewerker met duidelijke dataverwerking de veiligere weg dan een ruwe model in een wachtrij te plaatsen.
Kortomvattende zaak
LongCat 2.5 is een echte upgrade ten opzichte van 2.0, met visie die ingebouwd is in plaats van eraan vastgeschroefd, tegen een prijs die niet is verschoven. Het is alleen niet de voor de hand liggende keuze voor puur coderen, en de eigen benchmarktabel is waar je dat kunt zien. Test het op vision-intensief agentwerk, vergelijk het met DeepSeek V4.1 Flash in je eigen repository, en houd klantgegevens buiten totdat Meituan een duidelijk databeleid publiceert.
- LongCat 2.5
- Meituan
- AI coding agents
- multimodal AI
- DeepSeek
- AI benchmarks