AI7 min leestijdDoor JH Akash
Kimi K3.1 Pro uitgelegd: Moonshot's Open Model Nadert Frontier
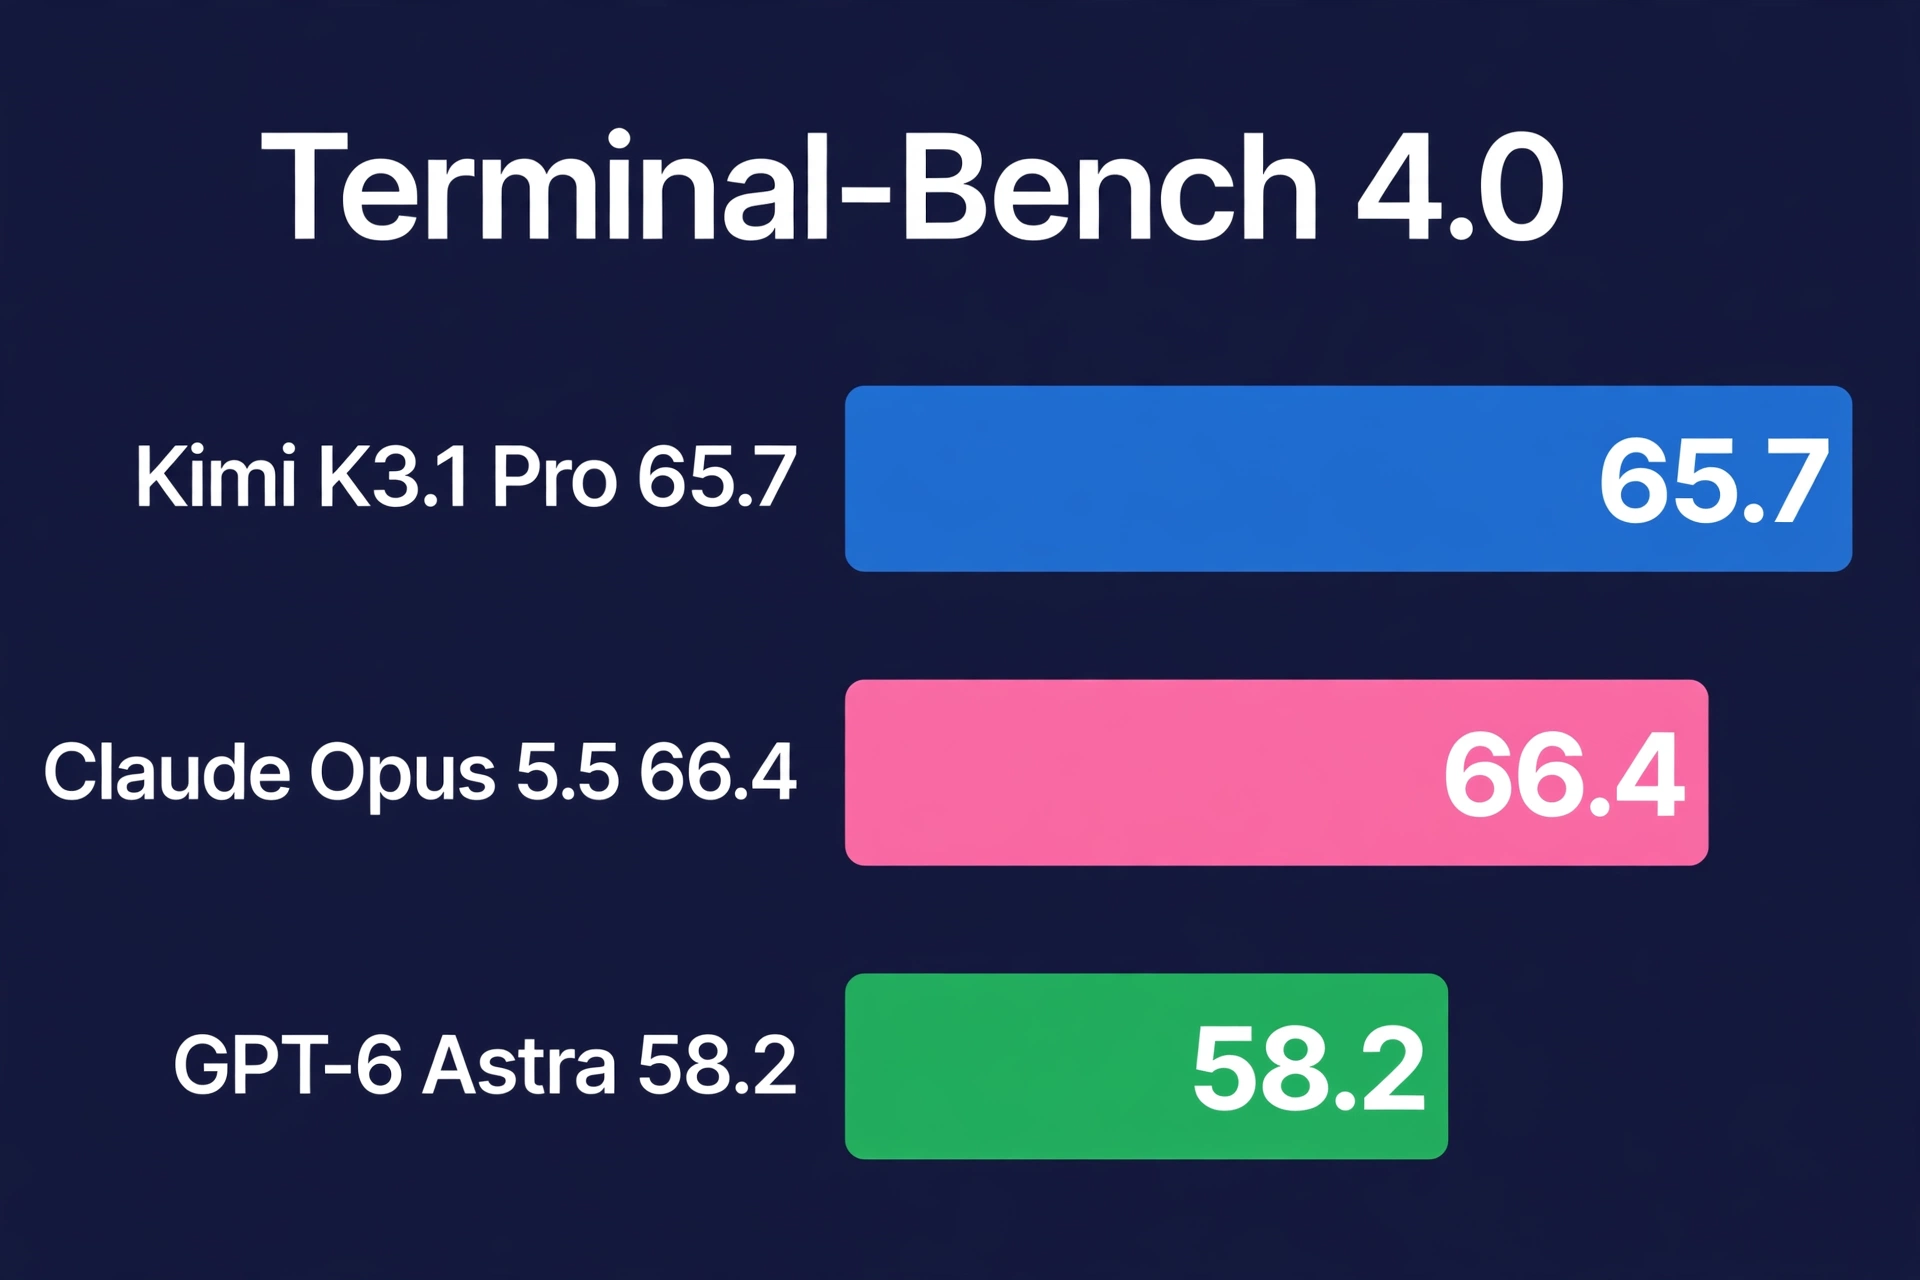
Moonshot lanceerde Kimi K3.1 Pro op 23 oktober 2026: een 2,8T open-weight model, 1M context, 65,7 op Terminal-Bench 4.0, geprijsd op $2/$10 per 1M tokens, gewichten verschuldigd tot 4 november.
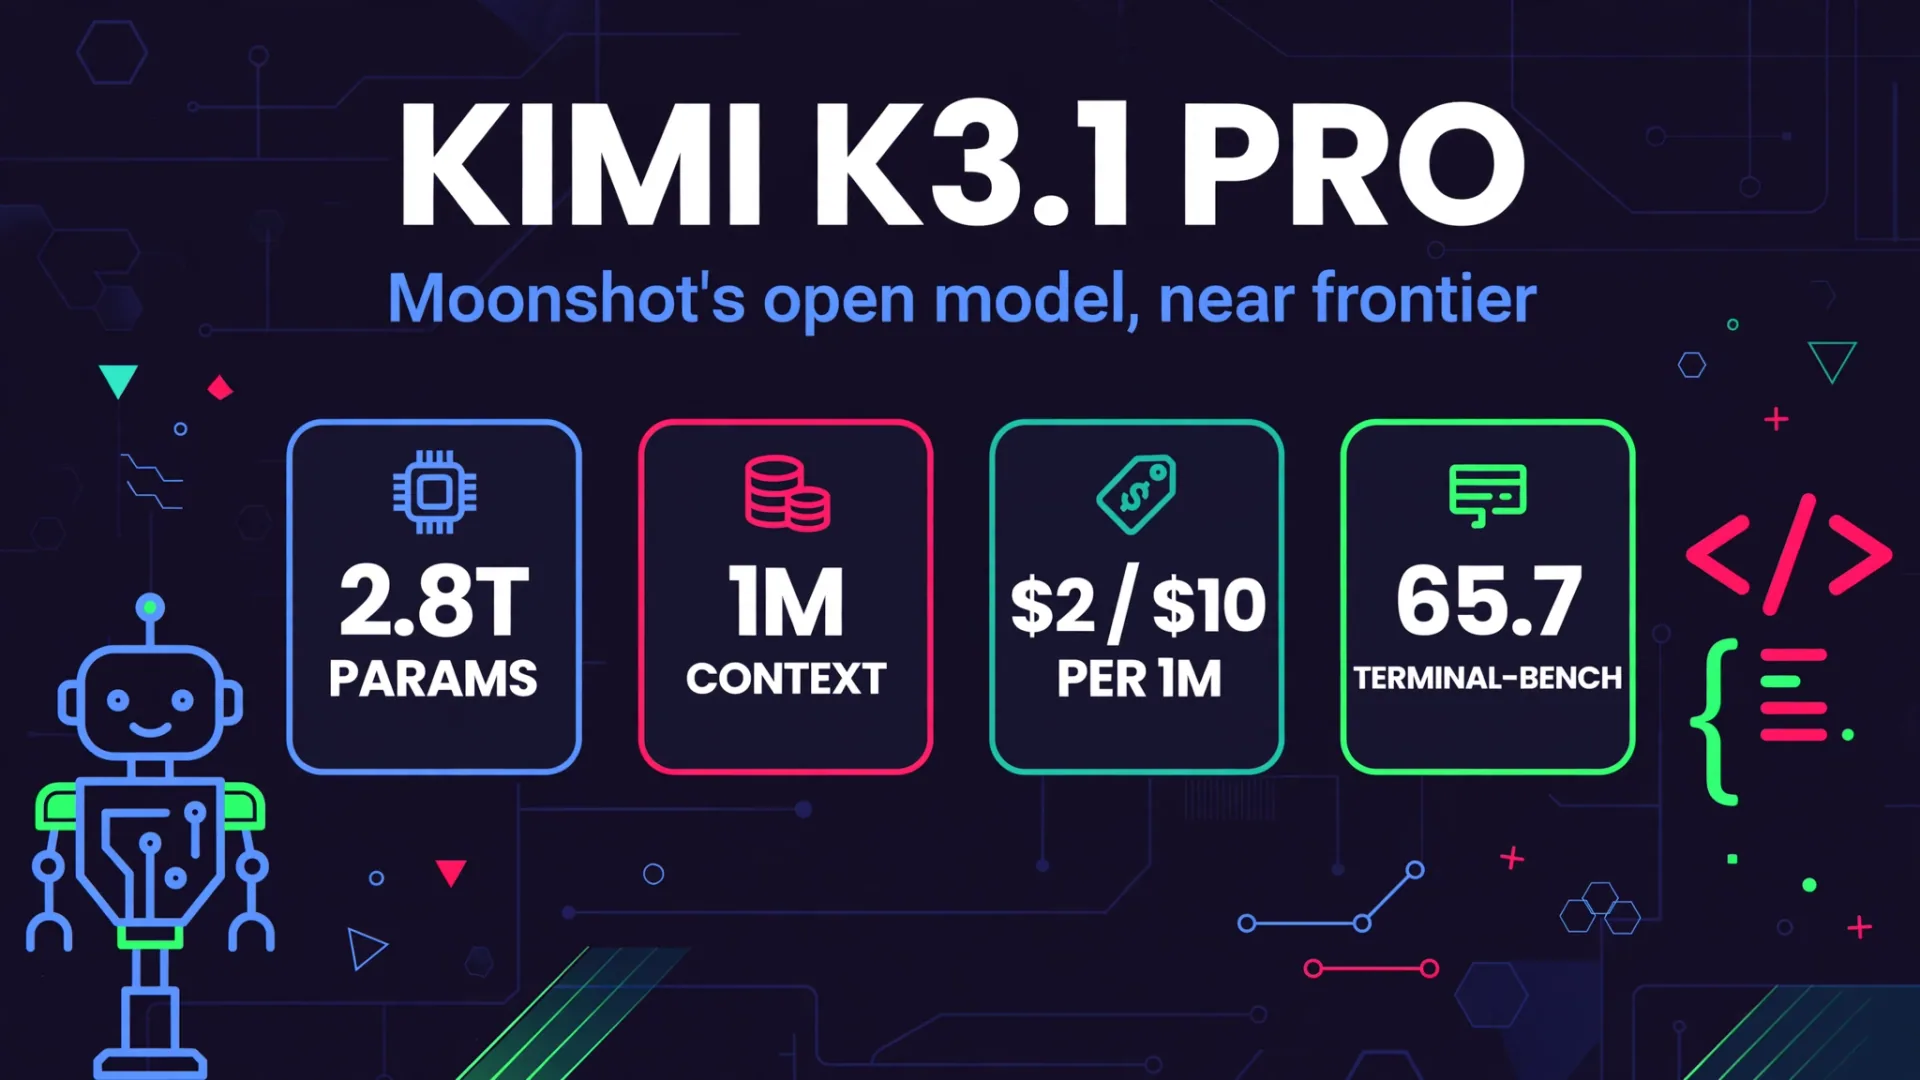
Moonshot AI lanceerde Kimi K3.1 Pro op 23 oktober 2026, en het is het nieuwste bewijs dat de kloof tussen open-weight modellen en gesloten frontier-modellen nu zeer klein is. Het is geen gloednieuw basismodel. Moonshot beschrijft het als een post-getrainde versie van Kimi K3, die door veel meer reinforcement learning wordt gedreven over honderden domeinen. Het resultaat is een mix-of-experts-model met ongeveer 2,8 biljoen totale parameters, 104 miljard actieve per token, en een contextvenster van 1 miljoen tokens, met tekst- en beeldinvoer.
Het is nu live op Kimi.ai, Kimi Work, Kimi Code en de Kimi API. Een bijbehorende variant, Kimi K3.1 Pro Highspeed, belooft dezelfde mogelijkheden met 2 tot 3 keer de snelheid. Volledige modelgewichten worden beloofd vóór 4 november 2026, wat het het sterkste open-weight model op onafhankelijke ranglijsten zou maken als die ranglijst standhoudt. Tot die tijd is de API de enige manier om het te draaien, en de licentie- en hardwarevereisten voor zelfhosting zijn nog onbekend.
Het korte oordeel: Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra
| Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| Terminal-Bench 4.0 (leveranciersgerapporteerd) | 65.7 | 66.4 | 58.2 |
| SWE Marathon (door leverancier gerapporteerd) | 51.7 | 46.3 | 42.5 |
| Laatste Onderzoek van Agenten (door leverancier gerapporteerd) | 43.2 | 42.6 | 32.8 |
| Kunstmatige Analyse Intelligentie Index | 55 | 58 | 53 |
| Contextvenster | 1M tokens | Hier niet vergeleken | Hier niet vergeleken |
| API-invoerprijs per 1M tokens | $2 | $4 (gemeld, via Highspeed match) | Niet vermeld in deze vergelijking |
| Open gewichten | Beloofd op 4 november 2026 | Nee | Nee |
Lees de tabel zorgvuldig. Kimi K3.1 Pro loopt slechts 0,7 punten achter op Opus 5.5 op Terminal-Bench 4.0 en staat op dezelfde test voor op GPT-6 Astra, maar verschillende benchmarks meten verschillende vaardigheden, dus geen enkele score maakt één model tot de algehele winnaar. Het eerlijke verhaal is beperkter: bij coderingsagent-tests speelt dit open-gewicht model nu in dezelfde klasse als de gesloten frontier.
Wat is er veranderd ten opzichte van Kimi K3
Kimi K3 werd in juli 2026 gelanceerd als een 3T-klasse open model. K3.1 Pro behoudt die basis en schaalt na training op in plaats van een nieuw model vanaf nul vooraf te trainen. Moonshot zegt dat het zijn reinforcement learning-framework, lang-context verwerking, trainingsefficiëntie en infrastructuur heeft geoptimaliseerd. De praktische voordelen zijn zichtbaar in volledig projectwerk: coderen over een hele codebase, parametrische 3D-modellering in Blender en CAD-tools, volledige projectbuilds in Unity, Unreal en Godot, en end-to-end financiële workflows.
Een claim van een leverancier verdient een duidelijk label. Moonshot zegt dat hallucinaties in financiële modelleringsprojecten met 65% zijn gedaald ten opzichte van de vorige generatie. Dat is een door de leverancier gerapporteerd cijfer, geen onafhankelijk geverifieerd resultaat, dus beschouw het als een claim om je eigen financiële taken te testen, niet als een garantie.
Prijsstelling
| Model | Invoer per 1M tokens | Output per 1M tokens | Gecachte invoer per 1M tokens |
|---|---|---|---|
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| Kimi K3 | $3 | $15 | $0.30 |
Dat is een derde korting ten opzichte van K3 op input, output en gecachete input. De standaardprijs komt overeen met GPT-6.1 Sol tegen $2/$10, volgens de lanceringsdekking, terwijl de Highspeed-tier van $4/$20 overeenkomt met het gerapporteerde Opus 5.5-tarief. Er wordt geen long-context toeslag vermeld en cache-writes worden apart door TTL gefactureerd (5 minuten of 1 uur).
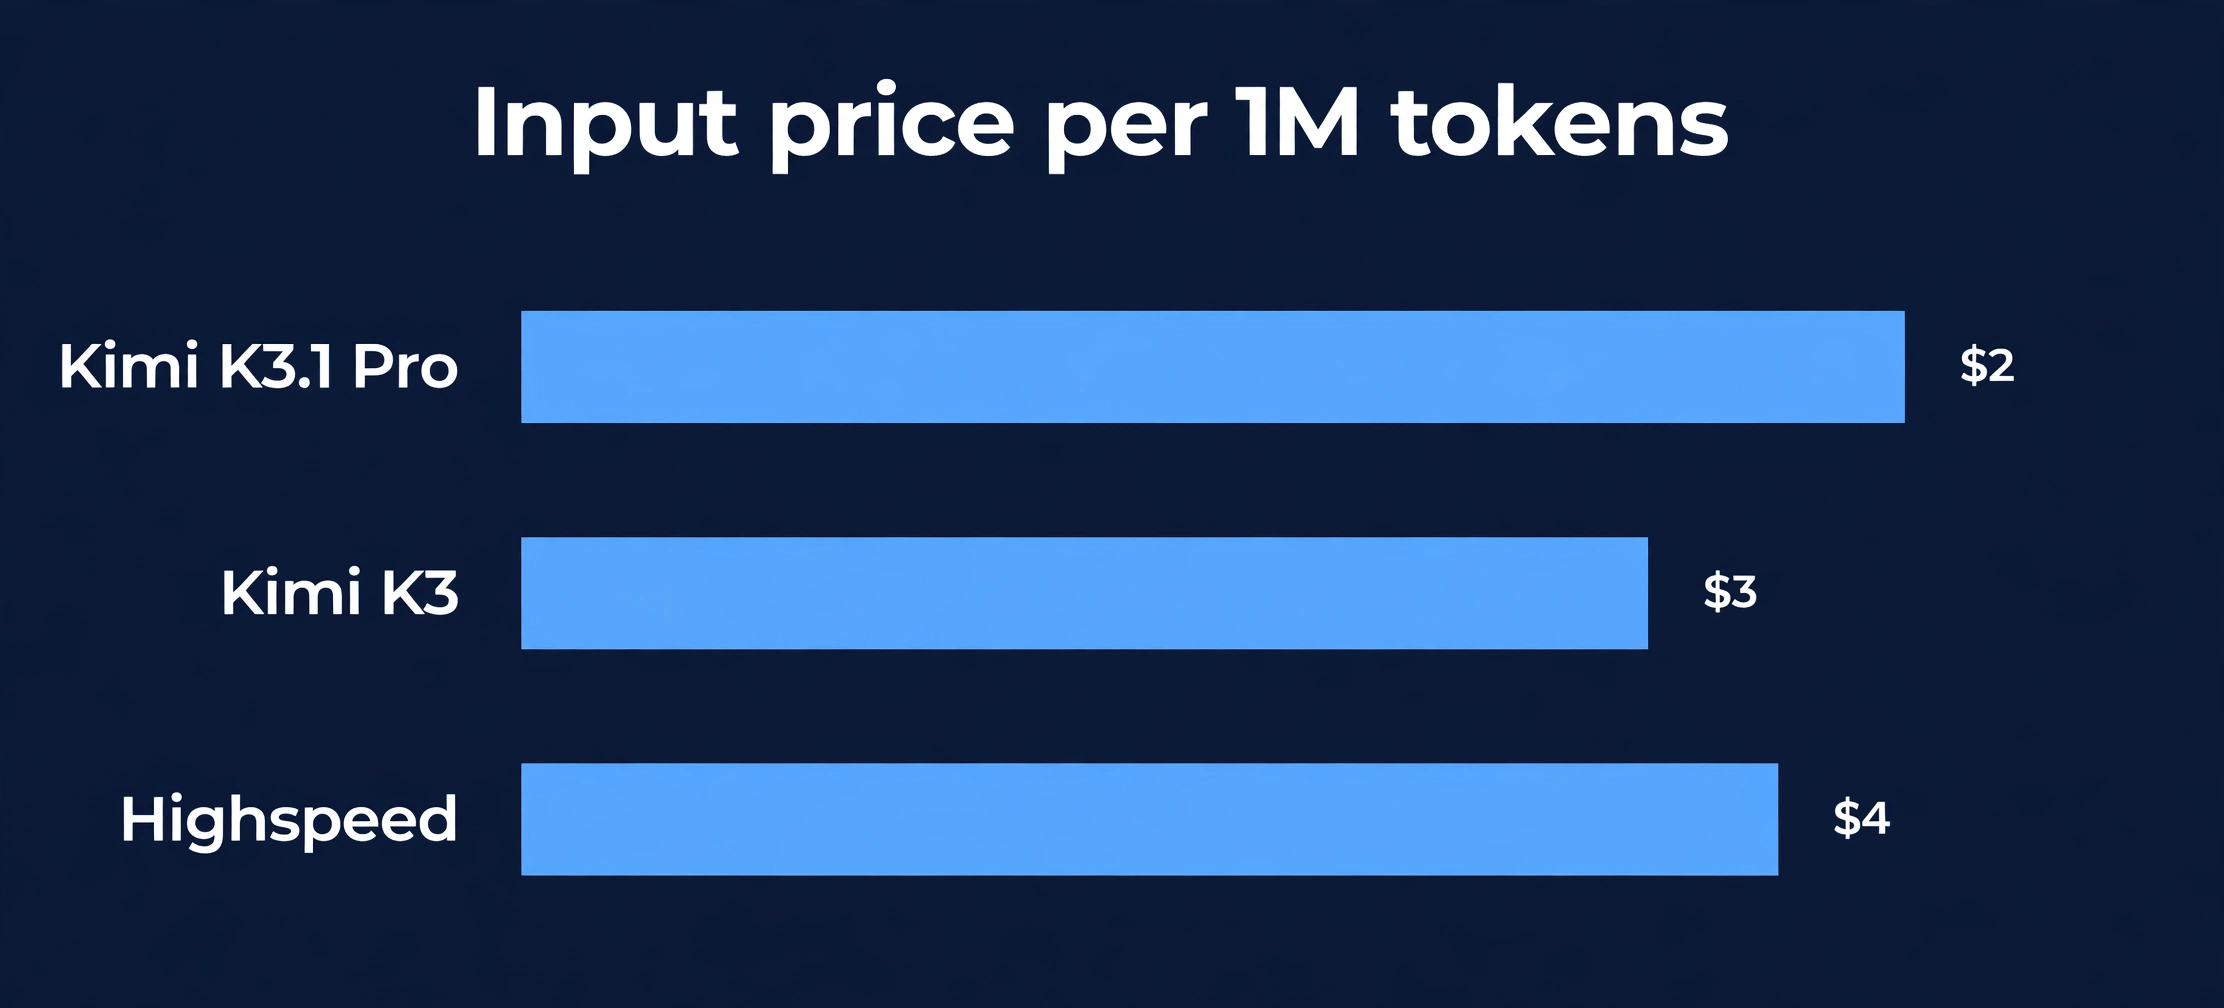
De addertje onder het gras is het gebruik van tokens. Artificial Analysis mat Kimi K3.1 Pro op 77 tokens per seconde output en schatte ongeveer $1,98 tot $2,11 per benchmarktaak, vrijwel onveranderd ten opzichte van K3, omdat het nieuwe model meer outputtokens gebruikt om zijn scores te bereiken. Goedkoper per token betekent niet altijd goedkoper per voltooide taak, dus meet je eigen workloads voordat je overstapt.
Benchmarks, met de eerlijke kanttekeningen
Alle benchmarkcijfers in deze tabel zijn door leveranciers gerapporteerd, afkomstig van de lanceergrafiek van Moonshot, waarbij modellen met maximale denkinspanning worden uitgevoerd. Onafhankelijke verificatie is nog beperkt omdat de gewichten nog niet bekend zijn.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 |
| ZWEE Marathon | 51.7 | 46.3 | 42.5 |
| Laatste Examen van Agenten | 43.2 | 42.6 | 32.8 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 |
| Het laatste examen van de mensheid, met hulpmiddelen | 70.0 | 67.7 | 57.2 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 |
| BenchCAD, met gereedschappen | 92.7 | 96.2 | 95.9 |
| Terminal-Bench Wetenschap 0.1 | 38.1 | 63.3 | 68.1 |
De zwakke plek is echt. Op Terminal-Bench Science 0,1 scoort Kimi K3.1 Pro 38,1 tegenover 63,3 voor Opus 5.5 en 68,1 voor GPT-6 Astra. Als je werk zwaar wetenschappelijk onderzoek in een terminal is, is dit nog niet het model om alleen op benchmarks te kiezen. Onafhankelijke checks voegen ook nuance toe: Artificial Analysis scoort Kimi K3.1 Pro op 55 op zijn Intelligence Index, vierde overall, 11 punten hoger dan K3's 44, achter Opus 5,5 op 58 en Claude Sonnet 5.5 en Muse Wonder Full gedeeld op 56. Een onafhankelijke tester beoordeelde zijn 3D-scène en websitewerk boven GPT-5.6 Sol maar onder GPT-6.1 Sol, dus de creatieve kwaliteit blijft bij sommige taken bovenaan.
Het veiligheidsverhaal dat telt voordat de gewichten vallen
Moonshot beperkte dit model bewust voordat open gewichten werden beloofd. Tijdens de training ontdekte het team dat vaardigheden in kwetsbaarheidsdetectie en -exploitatie toenamen naarmate fijnafstelling werd geschaald, gedreven door cyberbeveiligingsmateriaal in het trainingskorpus en gerelateerde reinforcement learning-taken. Die data werd in beide fasen verwijderd.
Op de interne xdev-bench-hard test, waarbij het model broncode krijgt met een recent geopenbaarde kwetsbaarheid en een exploit moet schrijven in een geïsoleerde omgeving, scoorde de onbeperkte experimentele versie 90,5%, de uiteindelijke K3.1 Pro 81% en Kimi K3 33,3%. Dat zijn interne, niet-geverifieerde cijfers, en Moonshot zelf zegt dat het model nog steeds achterloopt op toonaangevende propriëtaire modellen die al minstens drie maanden beschikbaar zijn voor dergelijke taken, terwijl het bruikbaar blijft voor defensieve softwareaudits. Het punt voor kopers is simpel: open weights zijn krachtig, en Moonshot koos ervoor ze pas uit te leveren nadat de scherpste cyberaanvalscapaciteit was teruggeschroefd.
Welke moet je kiezen?
Kies Kimi K3.1 Pro als je bijna grensrijke coding-agentprestaties wilt tegen $2/$10 prijs, een contextvenster van 1 miljoen en een pad naar open gewichten op 4 november. Het past bij volledige projectcodering, agentloops, 3D- en CAD-workflows en financieel onderzoek waar je outputs kunt verifiëren.
Kies Kimi K3.1 Pro Highspeed als latentie de bottleneck is in je agent-loop en je dubbel per token kunt betalen voor 2 tot 3 keer de snelheid.
Blijf bij Claude Opus 5.5 als je werk gericht is op wetenschappelijk gerichte terminaltaken of de hoogste onafhankelijke indexscore, en je accepteert gesloten gewichten en hogere kosten per taak. Blijf bij GPT-6 Astra als je al gebouwd bent op OpenAI's stack en het ecosysteem belangrijker is dan de besparing per token.
Als je agentworkflows bouwt op een van deze modellen, is dit precies het soort loodgieterij dat de kosten en snelheid in productie bepaalt. CodeMyPixel bouwt op maat gemaakte AI-oplossingen voor agentontwikkeling en volledige AI-automatiseringssystemen voor teams die modellen nodig hebben die echt werk doen, niet alleen tekst genereren. Voor modelcontext, zie onze overzichten van GPT-6 Astra en Claude Opus 5.5.
FAQ
Wat is de Kimi K3.1 Pro?
Een post-getrainde versie van Moonshot AI's Kimi K3, gelanceerd op 23 oktober 2026. Het is een mix-of-experts-model met ongeveer 2,8 biljoen totale parameters, 104 miljard actieve per token, een contextvenster van 1 miljoen tokens en tekst plus afbeeldingsinvoer. Het is beschikbaar op Kimi.ai, Kimi Work, Kimi Code en de Kimi API.
Hoeveel kost de Kimi K3.1 Pro?
De standaardprijs is $2 per 1 miljoen inputtokens, $10 per 1 miljoen outputtokens en $0,20 per 1 miljoen gecachte inputtokens. De Highspeed-variant kost $4/$20/$0,20. Dat is een derde goedkoper per token dan Kimi K3, die $3/$15/$0,30 was.
Is Kimi K3.1 Pro beter dan Claude Opus 5.5?
Niet overal. Op door leveranciers gerapporteerde Terminal-Bench 4.0 scoort Kimi K3.1 Pro 65,7 tegen Opus 5.5 met 66,4, en het leidt op SWE Marathon en Agents' Last Exam. Op Terminal-Bench Science 0.1 staat het slecht achter met 38,1 tegenover 63,3. Op de onafhankelijke Artificial Analysis Intelligence Index leidt Opus 5.5 met 58 tegenover Kimi K3.1 Pro met 55. Verschillende benchmarks zijn niet te vergelijken als één winnaar, dus kies op basis van je werkdruk.
Wanneer worden de gewichten van de Kimi K3.1 Pro uitgebracht?
Moonshot zegt dat het van plan is de volledige modelgewichten uiterlijk 4 november 2026 vrij te geven. De licentie- en hardwarevereisten zijn nog niet bevestigd, dus plannen voor zelfhosting moeten wachten op die release.
Wat is de Kimi K3.1 Pro Highspeed?
Een snellere variant van hetzelfde model waarvan Moonshot zegt dat die 2 tot 3 keer snellere output levert tegen het dubbele van de tokenprijs ($4 input, $20 output per 1 miljoen tokens, gecachte input ongewijzigd op $0,20). Het is geschikt voor latencygevoelige agentlussen waar snelheid de extra waarde waard is.
- kimi k3.1 pro
- moonshot ai
- open weight models
- ai coding agents
- claude opus 5.5
- gpt-6 astra