IA9 min di letturaDi JH Akash
Spiegata una regola robots.txt di non partecipare all'addestramento AI
Il 30 ottobre 2026, OpenAI, Google, Microsoft e Anthropic sostenuto un token robots.txt per non partecipare all'addestramento con l'IA. Date, limiti e il codice esatto.
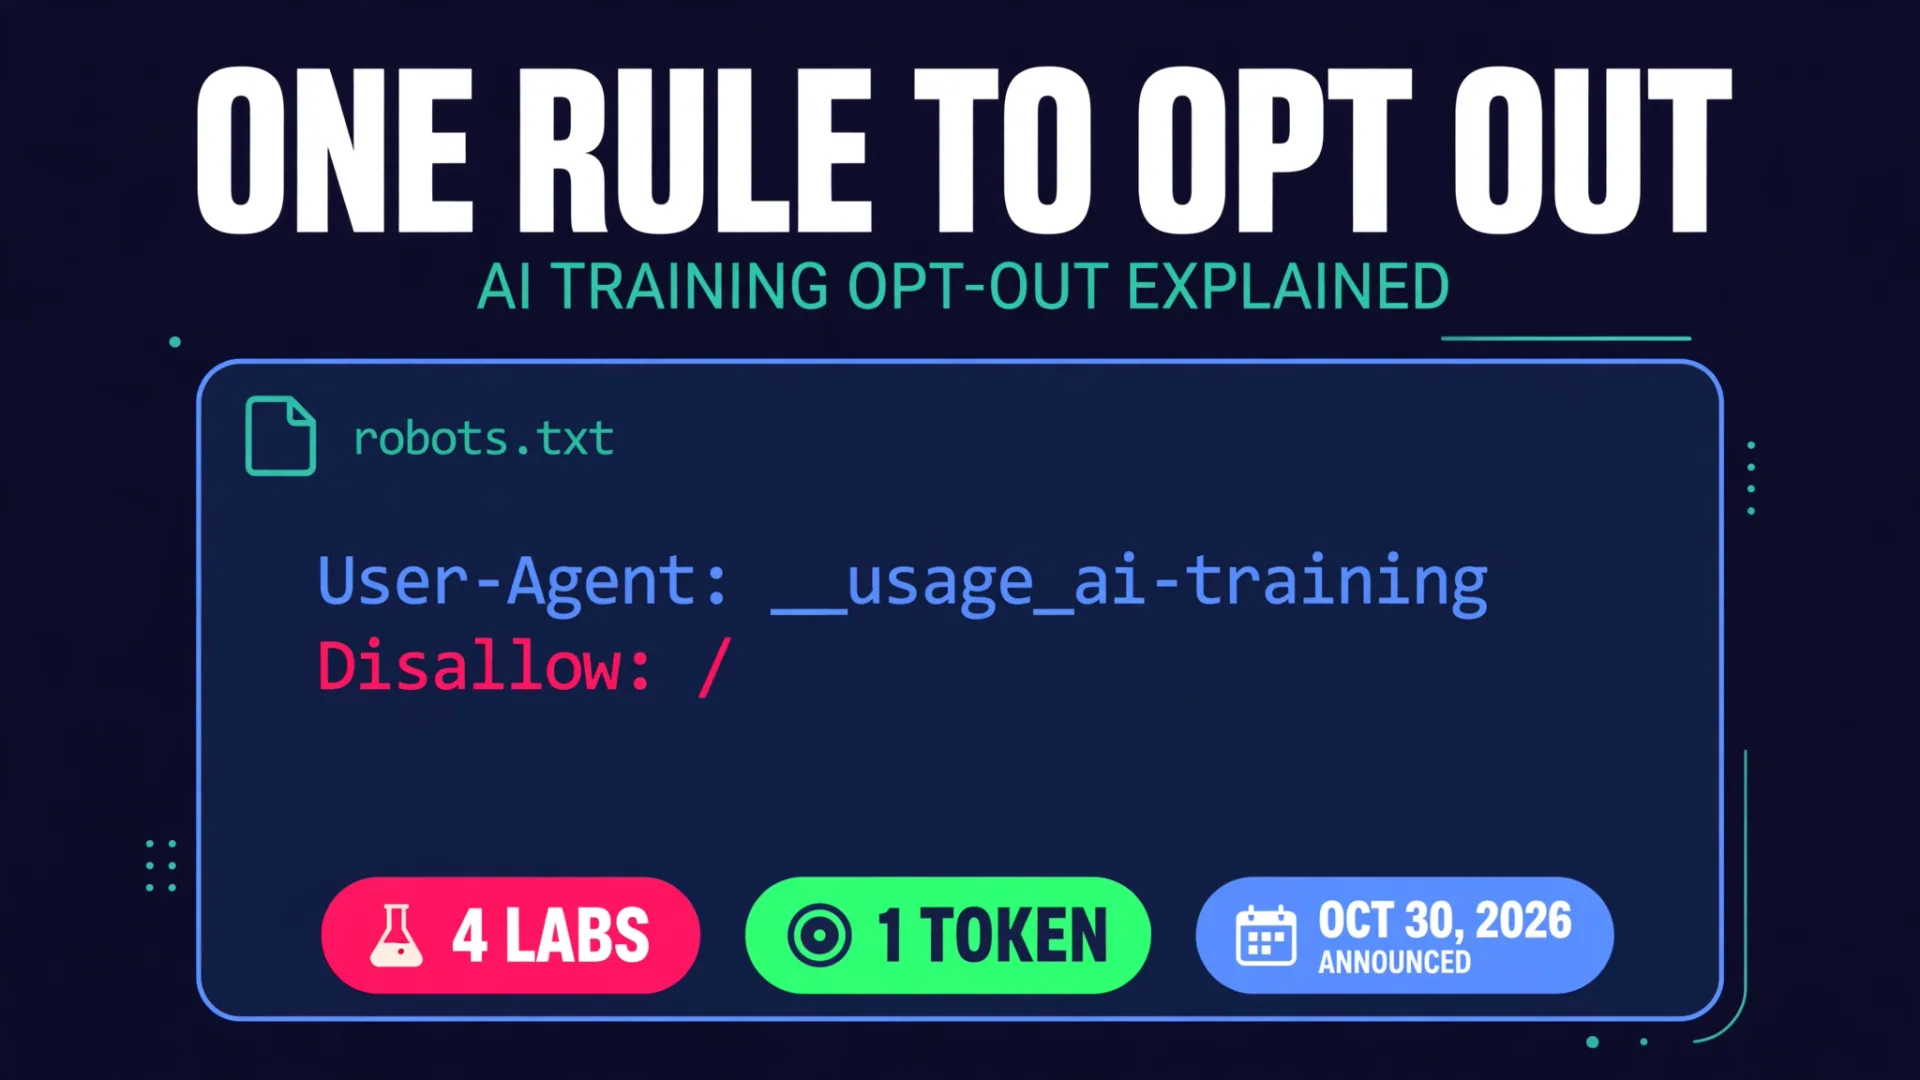
Il 30 ottobre 2026, quattro dei più grandi laboratori di IA hanno fatto qualcosa di insolito: hanno concordato la stessa regola. OpenAI, Google, Microsoft e Anthropic hanno tutti dichiarato che onoreranno un token robots.txt condiviso, _usageai-training, che permette a un sito web di rinunciare all'addestramento AI in un solo passo. Fino ad ora, un publisher che voleva uscire doveva bloccare ogni crawler aziendale per nome, GPTBot, Google-Extended, ClaudeBot e una lista crescente di altre. Questo annuncio riduce quel compito in un'unica voce.
Il problema sta nel tempismo e nelle clausole in piccolo. Solo Anthropic dice di aver già iniziato a implementare il supporto. Microsoft inizia il 1° febbraio 2027. Google punta al 2027. OpenAI dice "nei prossimi mesi" senza una data. E il segnale è volontario, copre solo la formazione e non fa nulla riguardo ai contenuti già raccolti o addestrati. Quindi questo è un vero passo di coordinamento, non un interruttore di spegnimento istantaneo.
Il verdetto rapido
| Domanda | Risposta |
|---|---|
| Cosa è stato annunciato? | Un robots.txt ha condiviso un token di policy, _usageai-training, per rinunciare all'addestramento AI |
| Annunciato | 30 ottobre 2026 |
| Supportato da | OpenAI, Google, Microsoft e Anthropic |
| Il codice | User-Agent: _usageai-training, poi Disallow: / |
| Bozza dietro di essa | IETF Internet-Draft "Machine-Readable Training Preference Signal", di Kevin Kelley di Anthropic, datato 30 ottobre 2026 |
| Stato del draft | Una bozza individuale, non approvata dall'IETF, senza validità formale, con scadenza il 3 maggio 2027 salvo aggiornamento |
| Cosa copre | Solo addestramento IA, non crawling, ricerca o risposte IA |
| Cosa non fa | Rimuovi i contenuti già raccolti o addestrati in un modello |
| Chi può usarlo | Qualsiasi proprietario di sito web, aggiungendo il token a robots.txt |
| Cosa tenere per ora | Le regole esistenti per ogni azienda, come Google Extended, perché il token condiviso non è ancora attivo |
Il codice esatto
Aggiungi questo blocco al tuo robots.txt se vuoi rinunciare alla formazione su tutto il sito:
User-Agent: __usage_ai-training
Disallow: /
Per rinunciare a tutto tranne una cartella, l'esempio della bozza aggiunge una riga di Permesso:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Due dettagli contano. Primo, il token deve corrispondere esattamente, a parte la lettera maiuscola. Un gruppo di User-Agent: * generico non conta, e se nessun gruppo nomina il token, il sito non ha espresso alcuna preferenza. In secondo luogo, puoi rinunciare solo a alcune cartelle invece che all'intero sito, usando Disallow sui percorsi che vuoi proteggere.
Chi la onora, e quando
| Azienda | Cosa dice | Tempistica |
|---|---|---|
| Anthropic | Ha iniziato a implementare il supporto per il token condiviso, insieme ai suoi controlli esistenti | Già iniziato, il lancio tra i servizi richiede tempo |
| OpenAI | Rispetterò un segnale robots.txt condiviso per l'addestramento di base dell'AI generativa, i controlli crawler esistenti continueranno a funzionare | Nei prossimi mesi, nessuna data indicata |
| Microsoft | Rispetterà la preferenza di addestramento, più una preferenza separata per l'AI Grounding e controlli a livello di pagina | 1 febbraio 2027, mentre le pagine vengono riesplorate |
| Piani per trattare un opt-out come se l'editore avesse vietato Google-Extended, a meno che Google-Extended non sia impostato direttamente | Obiettivi per il 2027 |
Microsoft va oltre il livello di pagina. Sta aggiungendo un'impostazione di addestramento a livello di pagina e un'impostazione di grounding separata, che decide se una pagina può fornire risposte AI live su Bing, Copilot e Microsoft 365. Una terza opzione, DisallowExtended, consente il grounding nei prodotti Microsoft ma non nei servizi di grounding che vende ad altre aziende. Microsoft afferma anche che una pagina può portare un meta tag Bingbot, ai-training:disallow o un'intestazione X-Robots-Tag, che sovrascrive robots.txt. I siti che si basano sui vecchi tag NoArchive e NoCache di Bing dovrebbero passare alle nuove preferenze entro il 1° marzo 2027, dopo di che i vecchi tag non saranno più letti come preferenza di formazione o grounding.
I dettagli di Google meritano di essere letti attentamente. Se usi il token condiviso per disattivarti e non menzioni Google-Extended, Google prevede di trattare questo come blocco di Google-Extended. Ma se permetti esplicitamente Google-Extended, Google afferma che quel sito rimane idoneo a presentarsi e guadagnare clic tramite grounding nelle risposte dell'app Gemini. In altre parole, la scelta di disattivazione e quella di visibilità sono collegate, quindi impostate entrambe deliberatamente.
Date chiave, contate dall'annuncio
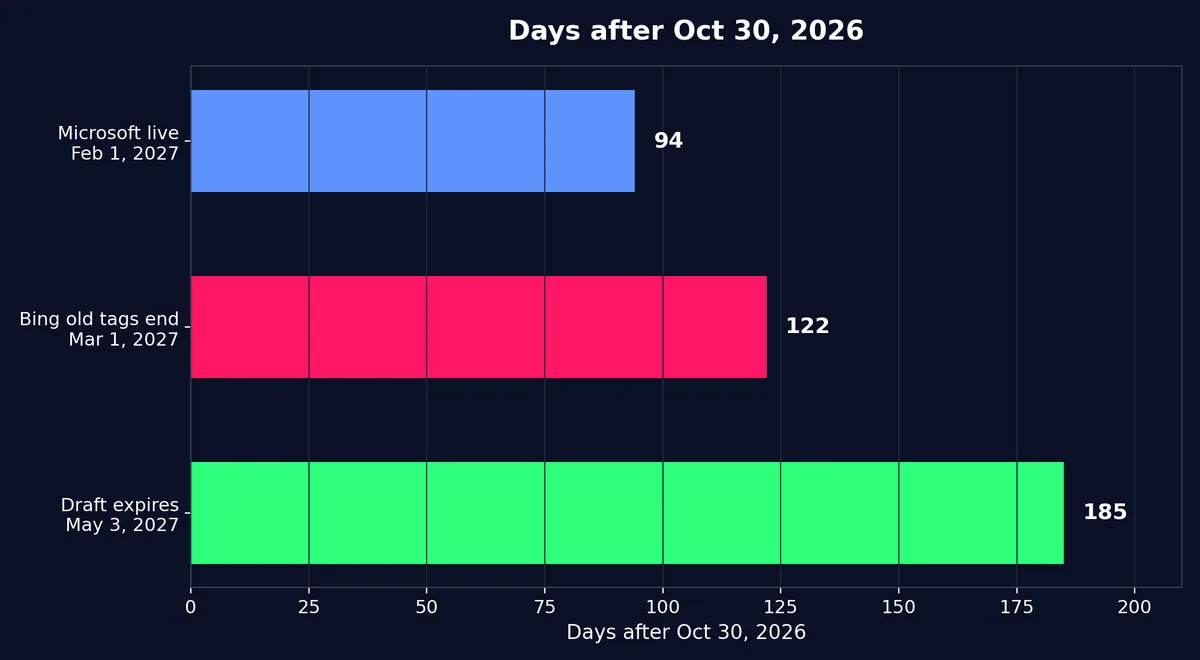
| Data | Cosa succede | Giorni dopo il 30 ottobre 2026 |
|---|---|---|
| 30 ottobre 2026 | Token condiviso annunciato da tutti e quattro i laboratori | 0 |
| 1 febbraio 2027 | Microsoft inizia a rispettare le nuove preferenze | 94 |
| 1 marzo 2027 | Bing smette di leggere i vecchi tag NoArchive e NoCache come preferenze di addestramento o di grounding | 122 |
| 3 maggio 2027 | La bozza dell'IETF scade a meno che non venga aggiornata | 185 |
| 2027, nessun mese indicato | Google mira a supportare il token | Non ancora datato |
| Mesi a venire, data non indicata | OpenAI mira a implementare il segnale | Non ancora datato |
I conteggi dei giorni sono semplici aritmetiche di calendario dal 30 ottobre 2026, non affermazioni dei fornitori. I due elementi senza data, Google e OpenAI, sono il motivo per cui gli editori non dovrebbero considerare l'annuncio come copertura in diretta oggi.
Cosa controlla e cosa non controlla
| Domanda | Risposta |
|---|---|
| Blocca l'addestramento AI sui miei contenuti? | Questo è il suo scopo, una volta che ogni laboratorio lo implementa |
| Smette di strisciare? | No. La bozza dice che il token non è una direttiva per il comportamento di crawling, quindi i bot possono comunque recuperare una pagina |
| Blocca l'indicizzazione delle ricerche? | No. Microsoft afferma che rinunciare alla formazione non influisce sull'idoneità ai risultati regolari di Bing |
| Impedisce alle risposte dell'IA di citare le mie pagine? | No, tranne tramite il controllo separato di messa a terra di Microsoft. Addestramento e messa a terra sono usi diversi |
| Cancella i dati di addestramento passati? | No. Riguarda solo le future sessioni di allenamento, non i contenuti già raccolti o già in pesi per il modello |
| Lega i raschietti che lo ignorano? | No. È volontario, senza potere di esecuzione, quindi i raschiatori non conformi possono ignorarlo |
Quest'ultimo limite è quello che i publisher continuano a incontrare. Il token è un meccanismo di coordinamento, non un controllo di sicurezza. Funziona solo con le aziende che scelgono di seguirlo, e la bozza stessa non ha alcuna validità formale per l'IETF. Questo non la rende inutile, ma significa che dovresti continuare a monitorare la conformità crawler per crawler e mantenere i controlli esistenti finché il token condiviso non viene effettivamente rispettato.
Cosa fare ora
Aggiungi il token ora, non costa nulla. Il blocco a due righe è già pubblicato, e aggiungerlo in anticipo significa che sei coperto quando arriva il supporto, senza aspettare la data di lancio di ogni laboratorio.
Mantieni le tue regole esistenti. Google-Extended, GPTBot, ClaudeBot e le altre regole per azienda restano funzionanti. Non eliminarle a favore di un token che per lo più non è ancora attivo.
Decidi separatamente l'addestramento e il grounding. Se usi i prodotti Microsoft, imposta la preferenza per l'addestramento e la preferenza per il grounding come due scelte, non una sola. Se ti interessa la visibilità dell'app Gemini, decidi esplicitamente su Google-Extended invece di lasciare che sia il token condiviso a deciderlo di default.
Controlla i tag Bing prima del 1° marzo 2027. Se il tuo sito si basa su NoArchive o NoCache, sposta alle nuove preferenze Microsoft prima di quella scadenza.
Aspettatevi una bozza di follow-up. La bozza attuale scade il 3 maggio 2027 a meno che non venga aggiornata, e il gruppo di lavoro include Meta, Cloudflare, la Common Crawl Foundation, News Corp, il Financial Times, la BBC, l'Electronic Frontier Foundation e Creative Commons. Lo standard potrebbe cambiare man mano che i partecipanti si esprimeranno, quindi considerate la formulazione di oggi come punto di partenza, non come legge definitiva.
Per i team che sviluppano prodotti di IA, la lezione è più ampia di un solo file robots.txt. Le preferenze di addestramento, le preferenze di grounding e la visibilità nella ricerca sono ora tre leve separate, e combinarle costa o controllo dati o traffico. CodeMyPixel costruisce servizi di sviluppo di agenti IA e aiuta le aziende ad assumere un'agenzia di automazione AI per inserire l'IA in flussi di lavoro reali con le barriere e la valutazione che un modello grezzo o una singola linea di robots.txt non forniscono. Se stai valutando modelli aperti contro quelli chiusi, la nostra analisi dei pesi aperti Mistral Large 4 e la nostra spiegazione Gemini 4 Carbon mostrano come accesso, licenze e controllo differiscano nella pratica.
Quale scegliere
Scegli il token condiviso più le tue vecchie regole se vuoi la massima copertura oggi. Il token ti prepara per il 2027, le vecchie regole ti proteggono ora.
Scegli l'opzione di allenamento solo se vuoi che i tuoi contenuti vengano eliminati dal modello futuro ma vuoi comunque traffico di ricerca e visibilità delle risposte IA. Ricorda che questo token da solo non blocca le risposte IA.
Scegli la formazione più l'opzione di grounding su Microsoft se vuoi anche che le tue pagine siano eliminate dalle risposte AI live su Bing, Copilot e Microsoft 365. Questa è un'impostazione Microsoft separata, non parte del token condiviso in sé.
Scegli 'no opt-out ' se la tua azienda beneficia dell'esposizione all'addestramento con l'IA, o se vuoi rimanere idoneo per il grounding e i click dell'app Gemini, e ti senti a tuo agio con l'uso dei tuoi contenuti per l'allenamento. Questa è una scelta aziendale, non predefinita, quindi fallo deliberatamente.
Cos'è il token condiviso per l'addestramento AI per l'addestramento?
Si tratta di un token di politica robots.txt, _usageai-training, annunciato il 30 ottobre 2026, che OpenAI, Google, Microsoft e Anthropic dichiarano di rispettare. Un proprietario di sito web aggiunge User-Agent: _usageai-training seguito da Disallow: / per non partecipare all'addestramento AI, invece di bloccare il crawler di ciascuna azienda per nome.
Rinunciare impedisce a Google o Bing di indicizzare il mio sito?
No. Il token copre solo l'addestramento tramite IA, non la scansione o la ricerca. Microsoft afferma che non partecipare all'addestramento non influisce sull'idoneità ai risultati regolari di Bing, e la bozza afferma che il token non è una direttiva per il comportamento di crawling.
Quando entra effettivamente in vigore il token condiviso?
Anthropic ha già iniziato a implementarlo. Microsoft inizia il 1° febbraio 2027. Google punta al 2027 senza alcun mese indicato. OpenAI afferma che implementerà il segnale nei prossimi mesi senza data indicata. Fino ad allora, le regole esistenti per azienda sono ciò che funziona oggi.
Il token rimuove i miei contenuti dai modelli già addestrati su di esso?
No. Aggiornare robots.txt non rimuove contenuti già raccolti nei dataset o già addestrati nei pesi del modello. Il token copre solo futuri addestramenti.
È uno standard web formale?
No, non ancora. Si tratta di una bozza IETF individuale Internet-Draft, "Machine-Readable Training Preference Signal", di Kevin Kelley di Anthropic, inviata al gruppo di lavoro IETF AI Preferences. Il datatracker IETF indica che una bozza individuale non è approvata dall'IETF e non ha validità formale, e la bozza scade il 3 maggio 2027 a meno che non venga aggiornata.
La mia azienda dovrebbe rinunciare all'addestramento all'IA?
Rinuncia se controllare l'uso futuro dell'addestramento conta più di qualsiasi esposizione che l'allenamento possa portare, e mantieni le tue vecchie regole del crawler finché il token condiviso non sarà attivo. Rimani iscritto, o imposta un permesso esplicito di Google-Extended, se vuoi rimanere idoneo per il grounding e i click dell'app Gemini. Decidi separatamente formazione e grounding, e rivedi la scelta quando arriverà la data di Microsoft del 1° febbraio 2027.
- robots.txt
- ai training opt-out
- openai
- microsoft
- anthropic
- ai policy