IA10 min di letturaDi JH Akash
Spiegazione di LongCat 2.5: Modello di Codifica Multimodale 1.6T di Meituan
Il LongCat 2.5 di Meituan è stato lanciato il 2 novembre 2026: parametri 1,6T, contesto 1M, ingresso nativo immagine e video, a 0,30$/$1,20 per milione di token. Benchmark, prezzo e le condizioni da conoscere prima di cambiare.
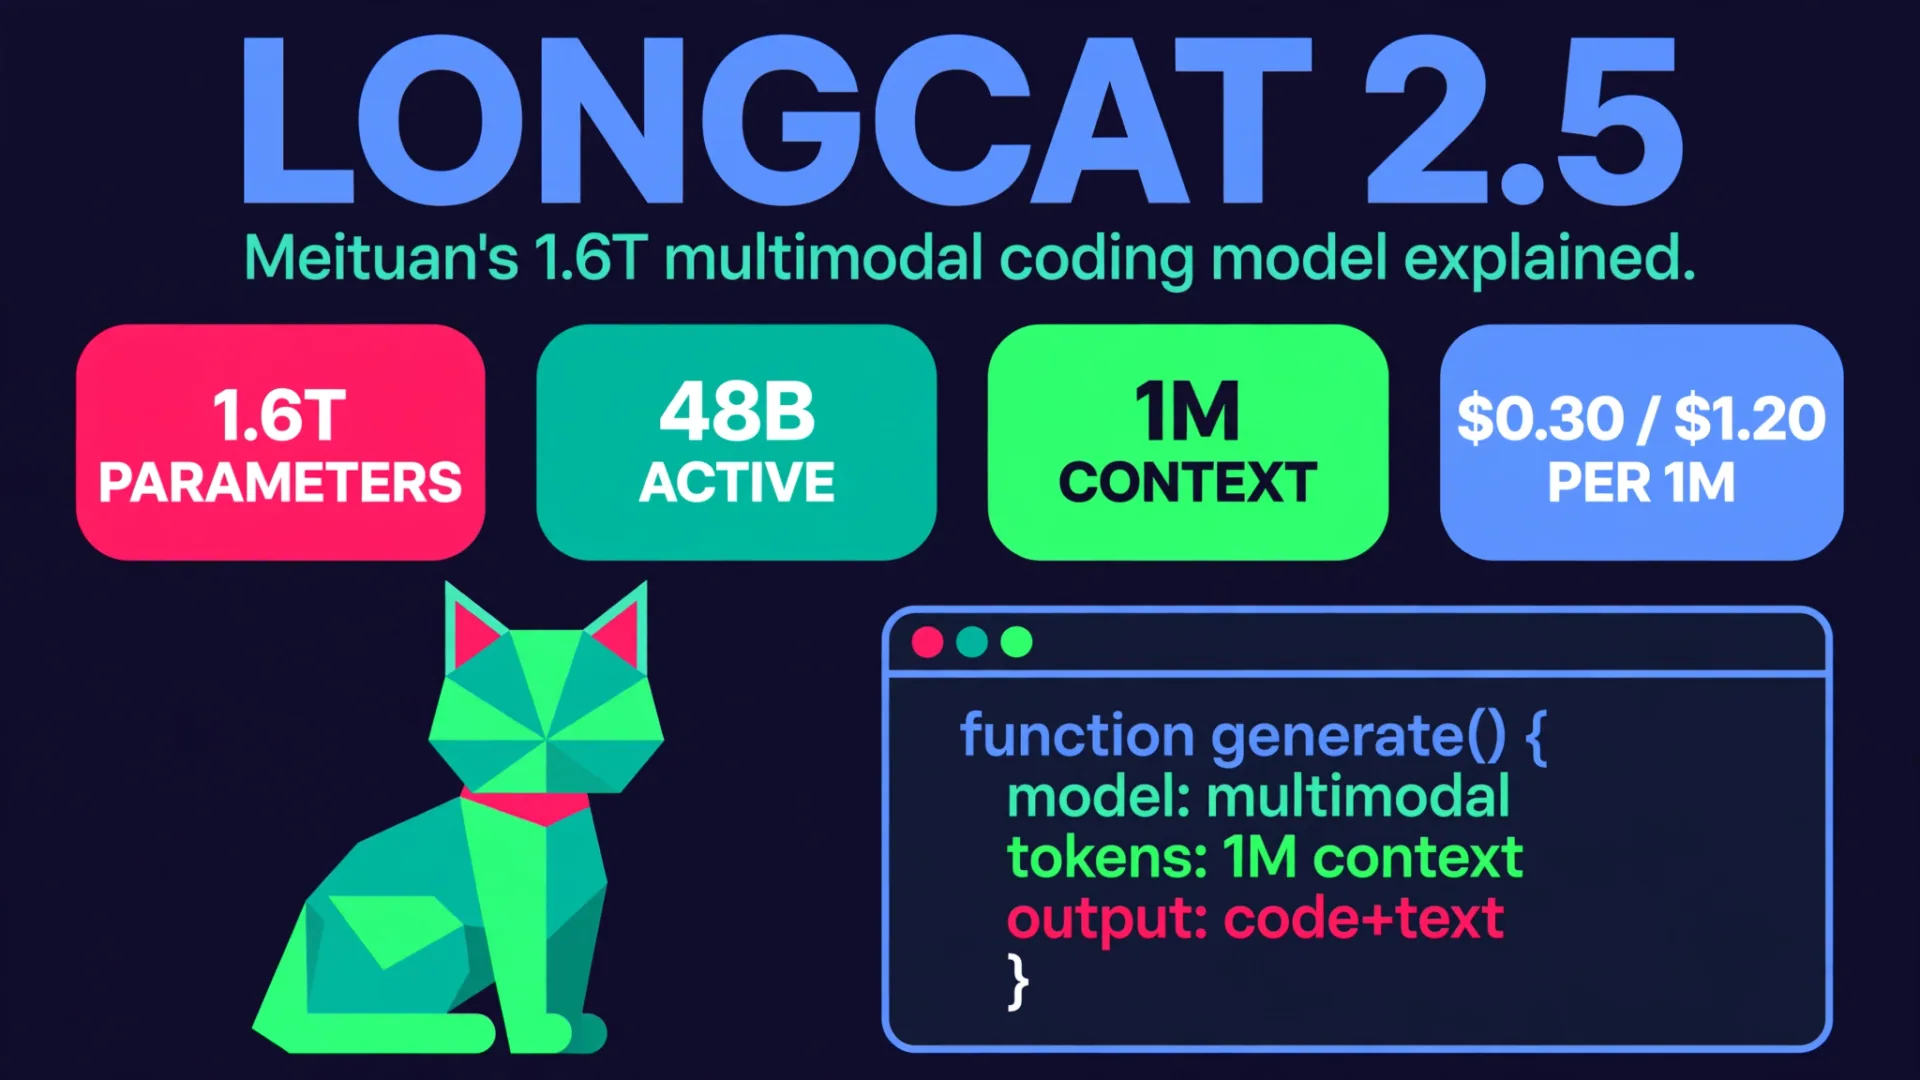
Il team LongCat di Meituan ha spostato LongCat 2.5 il 2 novembre 2026, e la proposta è facile da capire: un modello che può leggere testo, immagini e video, eseguire lunghi lavori di agente di codifica e farlo a 0,30 dollari per milione di token di input e 1,20 dollari per milione di token di output. I numeri sotto quella presentazione sono più interessanti del titolo. LongCat 2.5 rappresenta un grande salto rispetto a LongCat 2.0, eguaglia DeepSeek V4.1 Flash per prezzo, e la sua tabella di riferimento mostra dove un rivale più economico guida ancora per puro programming.
Questo non è un modello nuovo e più grande. LongCat 2.5 si basa su LongCat 2.0, un modello di 1,6 trilioni di parametri con una miscela di esperti e circa 48 miliardi di parametri attivi per token. Il cambiamento riguarda ciò che il modello può vedere e quanto addestramento degli agenti ha ricevuto. Tutti i punteggi dei benchmark in questo post sono riportati dai fornitori da Meituan salvo diversa indicazione, e al momento della stesura non aveva mai ottenuto un punteggio indipendente di LongCat 2.5.
Verdetto rapido
| Voce | LongCat 2.5 |
|---|---|
| Rilasciato | 2 novembre 2026, disponibilità generale sulla piattaforma API di LongCat |
| Dimensioni | 1,6 trilioni di parametri totali, circa 48 miliardi attivi per token |
| Input | Testo, immagini e video. L'output è solo testo |
| Contesto | 1 milione di token. Pianifica circa 128.000 token di output massimo |
| Prezzo | 0,30 dollari per milione di token di ingresso non memorizzato, 0,006 dollari per milione di token di ingresso memorizzati nella cache, 1,20 dollari per milione di token di output, tutti con sconto a tempo limitato |
| Pesi | Non rilasciato. GitHub e Hugging Face sono contrassegnati come "in arrivo" |
| Il meglio per | Agenti di codifica di budget che devono leggere screenshot o registrazioni dello schermo |
| Attenzione a | Nessun prezzo di listino, nessuna politica pubblicata di conservazione dei dati e nessun punteggio indipendente per ora |
Cosa è cambiato rispetto a LongCat 2.0
LongCat 2.0 era solo testo e a peso aperto, rilasciato con licenza MIT e pesi su Hugging Face. LongCat 2.5 mantiene lo stesso scheletro 1.6T / 48B e aggiunge visione nativa più addestramento per agenti a lungo orizzonte. L'anteprima è arrivata il 25 settembre 2026 e la disponibilità generale è seguita il 2 novembre 2026, aggiungendo input video e supporto Codex.
La visione è la caratteristica di copertura. LongCat 2.5 trasforma le immagini in token discreti nello stesso flusso delle parole, invece di aggiungere un encoder di immagini a un modello di testo. In pratica, ciò significa risoluzione nativa: uno screenshot alto diventa più token invece di una miniatura schiacciata. La documentazione consente fino a 50 immagini per richiesta a un massimo di 10 MB ciascuna, e fino a 10 video fino a 100 MB ciascuno e meno di 3.600 secondi. Non esiste una linea di prezzo separata per immagini o video. Paghi per i token in cui si trasformano.
Sul lato agente, Meituan descrive il reinforcement learning su larga scala a lungo orizzonte su task costruite da pull request GitHub filtrate, con penalità per ragionamento ripetitivo e chiamate ripetute di strumenti. Questo è importante perché il looping su compiti lunghi è stato il reclamo più forte degli utenti di anteprima. Se la disponibilità generale abbia risolto il problema è la prima cosa da testare sul proprio repository.
LongCat 2.5 funziona anche tra i cablaggi agenti, con guide per Claude Code, Codex, OpenCode, Cline, Kilo Code e Hermes Agent, tra gli altri. Supporta endpoint compatibili con OpenAI e compatibili Anthropic, quindi il cambio di harness è principalmente un cambio di URL base e nome modello: LongCat-2.5.
Benchmark: un vero salto, con un cattivo
La tabella di Meituan mostra un grande salto rispetto a LongCat 2.0 nei compiti degli agenti. Questi sono punteggi riportati dai fornitori, eseguiti con il pensiero abilitato.
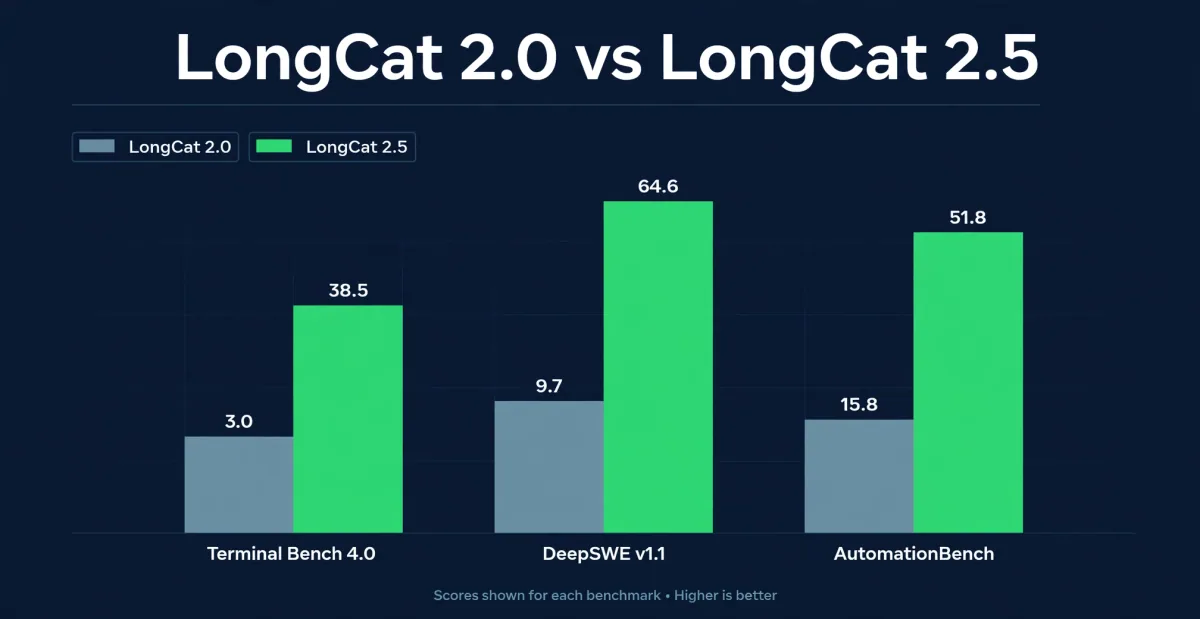
| Benchmark | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| 3DCodeBench Testo in 3D | 55.4 | Non riportato | 53.4 | 49.3 | 54.3 |
| Vision2Web | 78.6 | Non riportato | Non riportato | 79.0 | 80.2 |
Fonte: tabella di valutazione del blog tecnologico Meituan LongCat 2.5. I punteggi per altri modelli sono un mix delle proprie edizioni di Meituan e dati dei rapporti pubblici, che secondo Meituan sono solo indicativi. Benchmark diversi usano mezzi di riferimento differenti, quindi non confrontare i punteggi tra benchmark come se fossero un unico ranking di classifica.
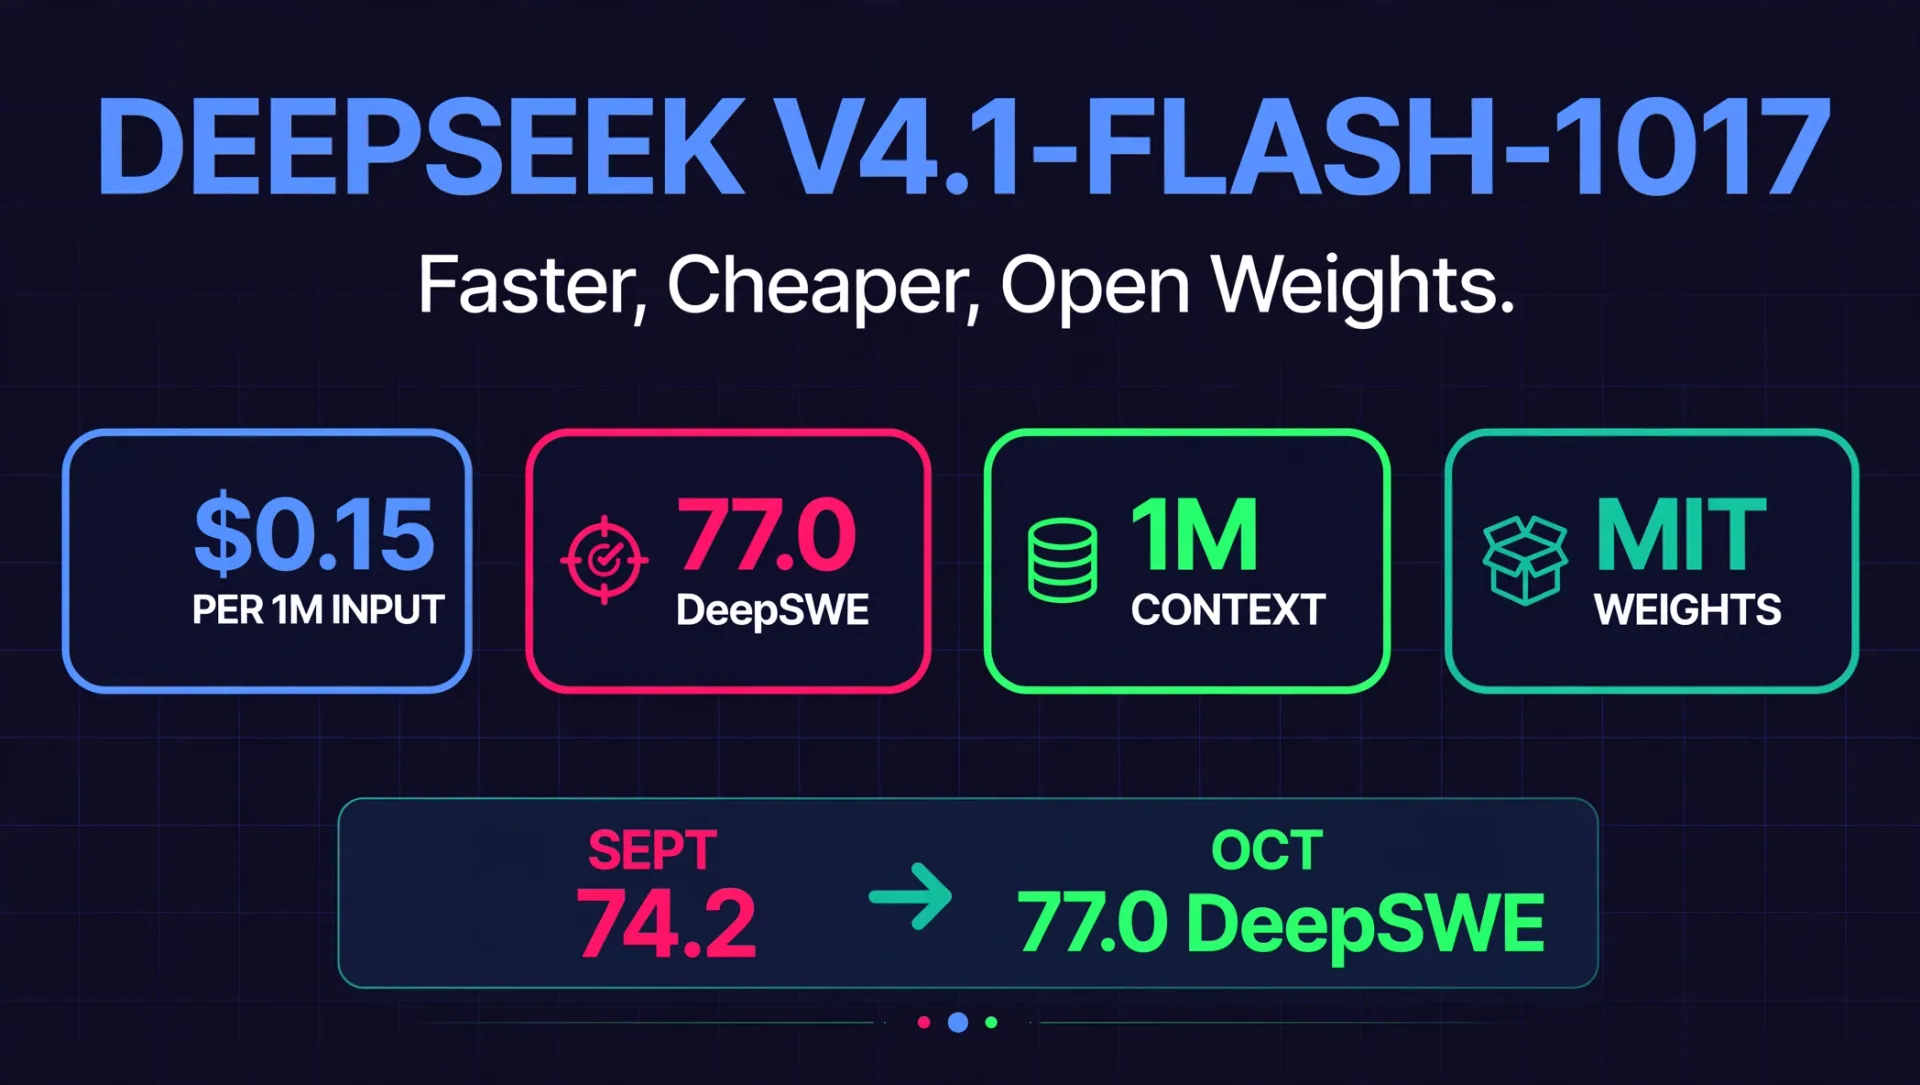
Detto in modo chiaro, LongCat 2.5 guida il suo rivale di prezzo su Terminal Bench 4.0 (38,5 contro 31,2), BrowseComp (91,9 contro 91,5) e 3DCodeBench Text to 3D (55,4 contro 53,4). DeepSeek v4.1 Flash guida Terminal Bench v2.1, DeepSWE v1.1, NL2Repo, MCP Atlas e AutomationBench (54,8 contro 51,8). LongCat 2.5 è uno dei due con punteggi video pubblicati, e i suoi risultati BrowseComp e 3D si adattano alla sua proposta visionaria.
Vale anche la pena notare il set di confronto. Le classifiche principali di Meituan confrontano con Claude Opus 5, GPT-5.6-Sol, Claude Opus 4.8 e GPT-5.5. Non includono Claude Opus 5.5, GPT-6.1 Sol o Kimi K3.1 Pro. Per l'ultima immagine della frontiera, consulta i nostri precedenti post su Claude Opus 5.5 e GPT-6 Astra, e la nostra suddivisione del benchmark GDPx, dove Opus 5.5 guida al 12,0%.
Prezzi: economici, ma scontati e temporanei
| Modello | Input per 1M di token | Input nella cache per 1M di token | Output per token da 1M |
|---|---|---|---|
| LongCat 2.5, sconto a tempo limitato | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, picco | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, fuori punta | $0.15 | $0.003 | $0.60 |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 |
| Kimi K3.1 Pro | $2.00 | $0.20 | $10.00 |
| Kimi K3 | $3.00 | $0.30 | $15.00 |
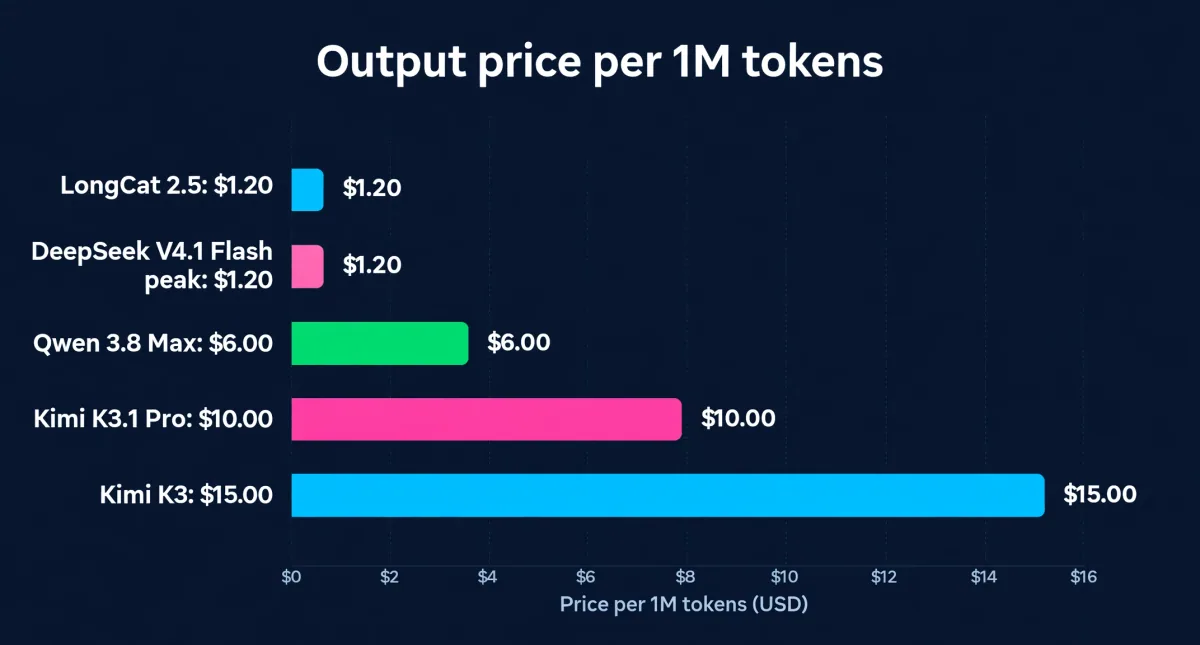
Due dettagli rendono il prezzo più utile del titolo. L'input nella cache costa solo il 2% dell'input non cacheato, il che conta per gli agenti di codifica che inviano gli stessi file ogni turno. E non c'è un sovrapprezzo per lunghezza contestuale, quindi una richiesta lunga costa lo stesso per token di una breve.
Una semplice fattura aiuta. Un compito con 800.000 token di input non cacheati e 200.000 token di output costa 0,48$ su LongCat 2.5: 0,8 volte $0,30 più 0,2 volte $1,20. L'esempio funzionante di Meituan, 600.000 token di input non cache, 400.000 token di input cacheati e 500.000 token di output, costa $0,7824.
Il rischio è l'etichetta di sconto. Ogni prezzo di LongCat 2.5 riporta la scritta "sconto a tempo limitato", senza prezzo di lista né data di scadenza pubblicata. Una pagina più vecchia di LongCat 2.0 mostrava un prezzo di lista di 0,75$ in ingresso, 0,015$ in cache e 2,95$ in uscita accanto allo stesso sconto. Meituan non ha detto che LongCat 2.5 passerà a quel prezzo di listino, ma prevedi il budget solo se riesci a sopportare un aumento.
Quale scegliere
Prova LongCat 2.5 se usi agenti di codifica con un budget limitato e ne vuoi uno che possa leggere screenshot o registrazioni dello schermo. A 0,30$ / 1,20$ con input cacheato al 2%, un pomeriggio di test sul tuo repository costa qualche euro. Confrontalo direttamente con DeepSeek V4.1 Flash allo stesso prezzo, solo sui tuoi compiti, non sui grafici di lancio.
Scegli invece DeepSeek V4.1 Flash se il codice a lungo orizzonte è tutto il compito. Nella tabella di Meituan è in vantaggio su più righe di codifica e dimezza il prezzo fuori punta. Ha anche una produzione massima più lunga nei confronti di terze parti, con 384.000 token contro i 128.000 previsti da LongCat 2.5.
Aspetta se ti servono pesi aperti, una licenza o self-hosting. LongCat 2.5 è solo API per ora, e anche quando arrivano i pesi, un modello 1.6T richiede una configurazione multi-GPU. LongCat 2.0 rimane l'opzione scaricabile.
Per ora salta se i tuoi prompt contengono dati del cliente o regolamentati. Le FAQ e le pagine di fatturazione di LongCat non dicono nulla su quanto tempo vengono mantenuti i prompt o se il traffico API venga usato per la formazione. Quel silenzio spetta alla decisione, qualunque sia il prezzo.
Se stai costruendo agenti per i clienti invece di testare modelli per te stesso, il modello è solo una parte del sistema. I nostri servizi di sviluppo di agenti AI e le posizioni di agenzia di automazione AI coprono il lavoro circostante: strumenti, controlli, regole di escalation e deployment.
Prese da sapere prima della prima corsa
- Confusione sui limiti di uscita. La pagina dei parametri del modello permette fino a 262.144 token massimi, ma l'avvio rapido, le FAQ e la configurazione Claude Code di Meituan puntano tutte a 128.000. Pianifica intorno a 128.000 e considera tutto ciò che è superiore come un bonus da testare.
- La temperatura è fissa. È 1,0 con il pensiero acceso e 0,7 con il pensiero fuori, e altri valori vengono silenziosamente sovrascritti invece che rifiutati. Se il tuo imbracatore di valutazione scorre la temperatura, non sta facendo quello che pensi.
- I limiti di velocità non sono pubblicati. I limiti sono per chiave API e restituiscono un 429 con un suggerimento di ritentazione di 60 secondi, ma non viene pubblicata alcuna cifra di richieste o token per minuto.
- Gli ID dei vecchi modelli potrebbero scomparire. LongCat 2.0 e 2.5-Preview sono usciti dalle tabelle dei modelli supportati senza alcun avviso di pensionamento datato. Se hai fissato un ID vecchio, testalo oggi.
- Nessun punteggio indipendente ancora. Analisi Artificiale elenca solo LongCat 2.0, e OpenRouter restituisce solo LongCat 2.0. Un test di anteprima indipendente ha riportato un risultato molto diverso del Terminal Bench 2.1 rispetto a Meituan 88.4, su un'imbracatura diversa. Esegui il tuo test prima di fare il commit.
Domande frequenti
Cos'è LongCat 2.5?
LongCat 2.5 è il più recente modello di linguaggio di grandi dimensioni di Meituan, generalmente disponibile sulla piattaforma API LongCat dal 2 novembre 2026. Prende testo, immagini e video come input, è ottimizzato per agenti di codifica di lunga durata e succede al LongCat 2.0 a peso aperto.
Quanto costa LongCat 2.5?
LongCat 2.5 costa 0,30 dollari per milione di token di ingresso non memorizzati nella cache, 0,006 dollari per milione di token di ingresso memorizzati e 1,20 dollari per milione di token di output. Meituan etichetta tutti e tre come sconto a tempo limitato e non pubblica alcun prezzo di listino o data di scadenza, quindi il prezzo potrebbe aumentare. È lo stesso tasso di DeepSeek V4.1 Flash nelle ore di punta.
LongCat 2.5 è open source?
Non ancora. Il blog di lancio di Meituan segnala i link di GitHub e Hugging Face come "in arrivo" e, al 3 novembre 2026, non era ancora apparso alcun repository o licenza LongCat 2.5, quindi per ora è solo API. LongCat 2.0 rimane il modello LongCat più recente con pesi MIT aperti.
Posso usare LongCat 2.5 in Claude Code o Codex?
Sì. La documentazione di Meituan mostra come puntare Claude Code verso l'endpoint in formato Anthropic con il modello impostato su LongCat-2.5, e c'è una guida di matching per Codex usando l'API Responses. Aspettati delle stranezze: la temperatura è fissata dalla piattaforma e l'output è limitato a 128.000 token nella documentazione.
Come si confronta LongCat 2.5 con DeepSeek V4.1 Flash?
Sul prezzo si abbinano al picco: 0,30 dollari in ingresso e 1,20 dollari in uscita per milione di token. Nella tabella benchmark di Meituan, LongCat 2.5 guida Terminal Bench 4.0, BrowseComp e 3DCodeBench Text in 3D, mentre DeepSeek V4.1 Flash guida su più righe di codifica a lungo orizzonte ed è più economico fuori punta. LongCat 2.5 aggiunge input video, che DeepSeek V4.1 Flash non corrisponde in questo confronto.
LongCat 2.5 è adatto all'assistenza clienti?
Non come prima scelta oggi. La documentazione di LongCat non dice nulla sulla conservazione dei dati o sull'addestramento sui dati API, che conta quando i prompt contengono dettagli del cliente. Per il lavoro di supporto, un agente helpdesk testato con una gestione chiara dei dati è la strada più sicura rispetto a collegare un modello grezzo in una coda.
In sintesi
LongCat 2.5 è un vero miglioramento rispetto alla 2.0, con una visione integrata invece che imbullonata, a un prezzo che non si è mai cambiato. Non è semplicemente la scelta ovvia al suo prezzo per la pura programmazione, e la sua tabella di riferimento è dove puoi vederlo. Testalo su lavori con agenti molto visivi, confrontalo con DeepSeek V4.1 Flash sul tuo repository e tieni fuori i dati dei clienti finché Meituan non pubblicherà una politica chiara sui dati.
- LongCat 2.5
- Meituan
- AI coding agents
- multimodal AI
- DeepSeek
- AI benchmarks