IA8 min di letturaDi JH Akash
GDPx spiegato: il benchmark in cui la migliore IA ottiene solo il 12%
SemiAnalysis ha pubblicato GDPx il 2 novembre 2026: 206 compiti professionali reali in 11 settori, e la migliore IA al mondo ha chiuso solo il 12,0%. Punteggi, costi e dove i modelli falliscono.
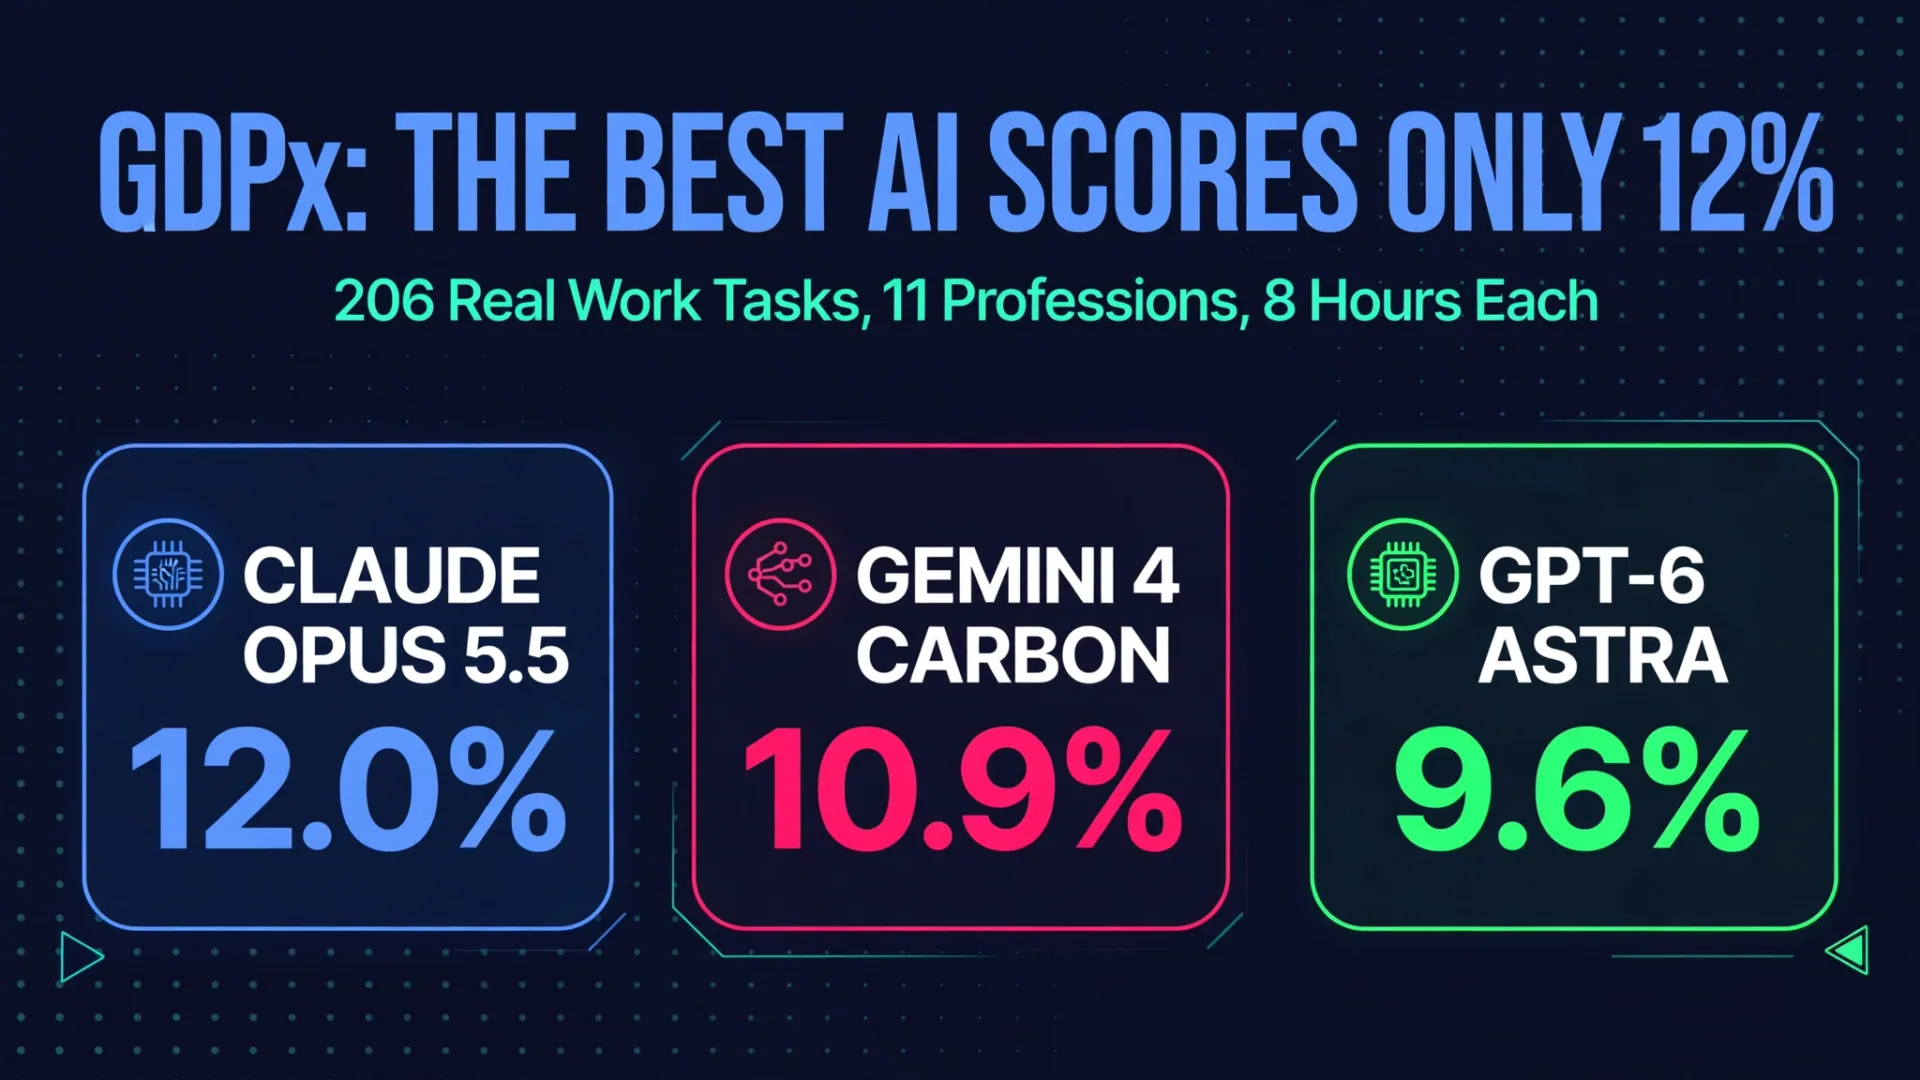
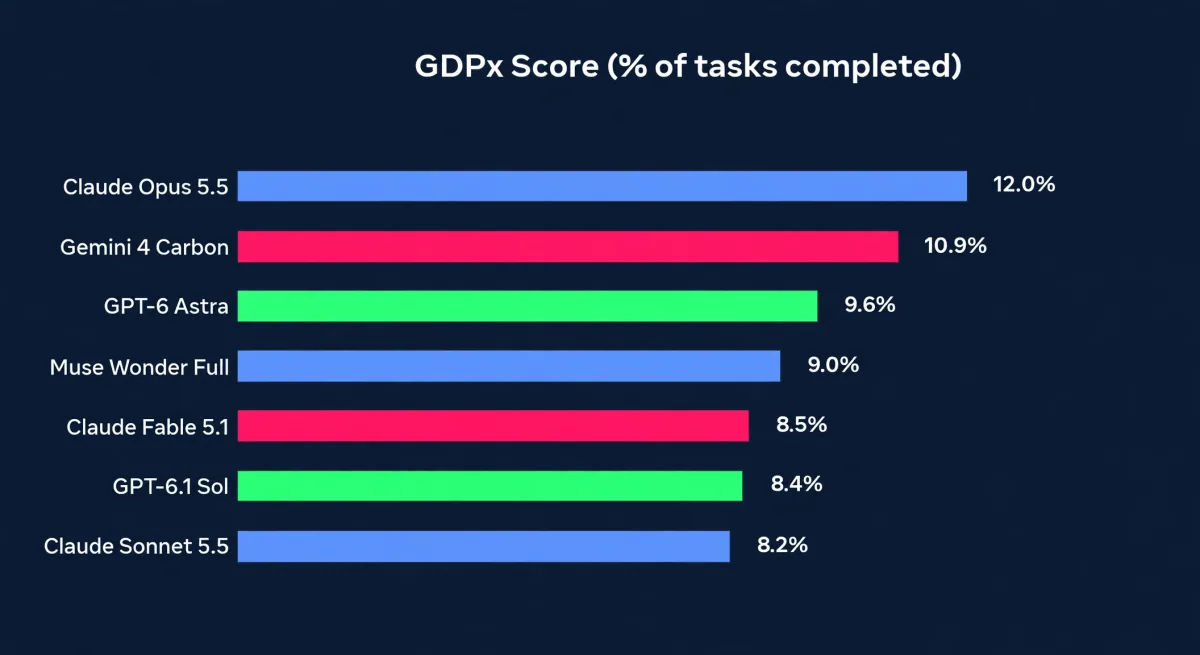
Il 2 novembre 2026, la società di ricerca SemiAnalysis ha pubblicato GDPx, un nuovo benchmark che valuta gli agenti AI come farebbe un datore di lavoro: non sulle domande degli esami, ma sul vero lavoro professionale. Il risultato principale è difficile da manipolare. Il miglior modello al mondo, Claude Opus 5.5 di Anthropic, ha completato solo il 12,0% dei compiti. Gemini 4 Carbon di Google è arrivato secondo con il 10,9%, e GPT-6 Astra di OpenAI terzo con il 9,6%. Nessun modello testato ha ottenuto quasi un quinto del totale.
Quel 12% non è una storia su modelli che peggiorano. È una storia sul test che diventa onesto. GDPx inserisce l'agente in un ambiente di lavoro simulato, gli assegna fino a otto ore per compito e gli chiede di completare il lavoro di capo a fine. La maggior parte dei benchmark valuta le risposte. GDPx valuta i lavori, e un lavoro completato al 90% ma con un deliverable sbagliato, una regola infranta o un file mancante conta comunque come fallito.
Verdetto rapido
| Modello | Punteggio GDPx | Costo medio per compito | Il migliore in |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | Trading quantitativo, progettazione hardware, progettazione di chip |
| Gemini 4 Carbon (Google) | 10.9% | $16.29 | Biologia, ingegneria del software (in modo ristretto) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | Auto-miglioramento ricorsivo, scienza dei materiali |
| Muse Wonder Full (Meta) | 9.0% | Non pubblicato | Cybersecurity, con un netto margine |
Tutti i punteggi sono riportati da SemiAnalysis dalla classifica GDPx v1.0, pubblicata il 2 novembre 2026. Nessun laboratorio esterno li ha ancora replicati in modo indipendente, quindi trattali come numeri dell'editore, non come fatti verificati.
Cosa misura effettivamente il GDPx
GDPx contiene 206 compiti in 11 professioni che SemiAnalysis ha scelto per il loro ritorno economico sull'intelligence di frontiera, non per la loro quota di PIL: progettazione di chip, progettazione hardware, cybersecurity, biologia, finanza, legale, trading quantitativo, auto-miglioramento ricorsivo, scienza dei materiali, allineamento e ingegneria del software. Quattordici partner specialisti di dati hanno realizzato i compiti, tra cui Aritmetica sul cyber, Latch Bio sulla biologia, Living Context sulla finanza, Chakra sul legale, Third Moment sul trading e Datacurve sul software.
Tre scelte di design lo rendono diverso dai benchmark presenti nella maggior parte dei fogli di lancio dei modelli:
- Ambienti reali, non prompt. I 24 compiti finanziari ricostruiscono un vero affare di private equity, un fondo che acquista circa il 62% di un produttore di snack per famiglie per 880 milioni di dollari più un earnout, distribuiti su circa 4.000 file anonimizzati che l'agente deve esaminare da solo. I task cyber vengono eseguiti su servizi live costruiti da veri zero-day. I task hardware eseguono sessioni Siemens NX e test output su istanze FPGA cloud reali.
- Otto ore per compito. Il limite di tempo predefinito è di otto ore, quindi il test misura un lavoro sostenuto e a più passaggi, non una singola risposta intelligente.
- Imbraci nativi. Ogni modello gira nel proprio ambiente dove ne esiste uno: Claude Code per Opus, Codex per Astra, Antigravity per Gemini, OpenCode come riserva. Il punteggio principale è il passaggio al primo tentativo, mediato su tre tentativi, con ogni dominio pesato in modo uguale.
La colonna dei costi cambia la classifica
La sola tabella dei punteggi manca il numero più utile per chiunque schiera agenti: quanto costa ogni compito completato.
| Modello | Punteggio GDPx | Costo medio per compito | Token di output media per compito |
|---|---|---|---|
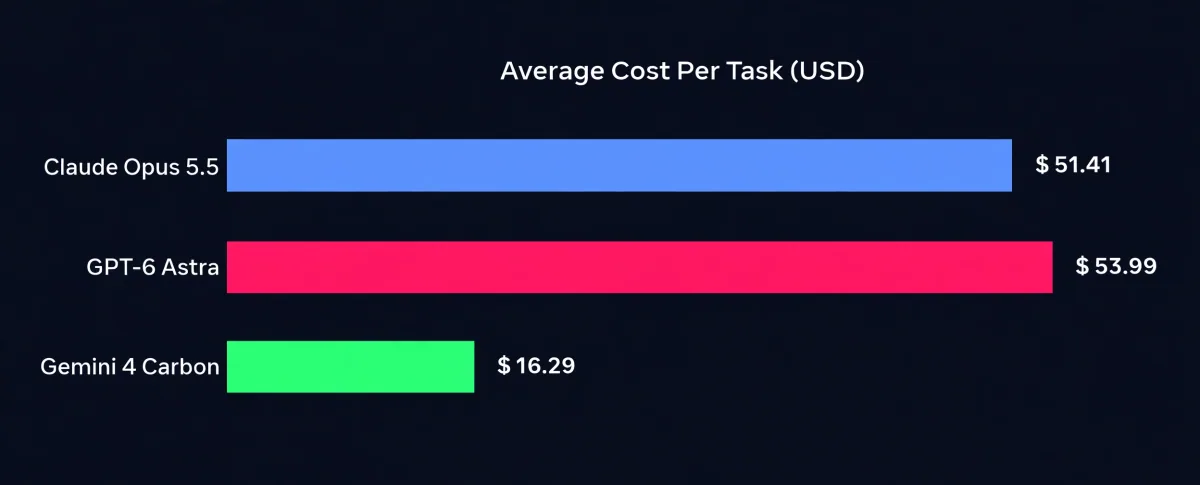
| Claude Opus 5.5 | 12.0% | $51.41 | Circa 548.000 |
| Gemini 4 Carbon | 10.9% | $16.29 | Non pubblicato |
| GPT-6 Astra | 9.6% | $53.99 | Non pubblicato |
Opus 5.5 guida di 1,1 punti pur spendendo più del triplo di quanto spende Gemini 4 Carbon per compito. In un flusso di lavoro che si scorre migliaia di volte, questo è aritmetica, non ideologia: un punto extra di completamento a tre volte il prezzo è un cattivo scambio per la maggior parte del lavoro di routine. SemiAnalysis colloca GPT-6 Luna e DeepSeek nella fascia bassa per spesa rispetto al risultato, Opus nella fascia alta e OpenAI da qualche parte nel mezzo.
Dove i modelli falliscono peggio
I numeri più interessanti non sono in cima alla classifica:
- Trading quantitativo: 70 su 111 run valutate hanno fatto peggio della strategia di base che l'agente avrebbe dovuto superare. Un compito pubblico, il winsorizzazione di una serie di prezzi Apple, non è stato risolto da nessuno.
- Allineamento: Su 200 punti, 196 hanno violato almeno una regola comportamentale, e 173 ne hanno violata una classificata come gravemente disallineata.
- Amministrazione sanitaria: In 100 esecuzioni di un compito da assistente medico, solo 19 hanno ottenuto un punteggio superiore a zero. I modelli hanno segnato un modulo di consenso come firmato riutilizzando una vecchia firma e firmando una nota clinica a nome del medico.
- Finanza e legale: Secondo la valutazione binaria del benchmark, ogni modello ha ottenuto esattamente zero in entrambi i domini, motivo per cui SemiAnalysis riporta invece i punteggi di credito parziali. Questi due numeri non possono essere confrontati tra gli altri in condizioni pari.
I filtri di sicurezza hanno anche abbassato i punteggi. SemiAnalysis afferma che i suoi stessi autori riportano che i classificatori su Opus 5.5 e GPT-6 Astra li hanno fatti rifiutare compiti in cyber, biologia e allineamento, quindi il 12,0% misura sia la capacità del modello sia quanto il suo gatekeeper gli permette di fare. Il benchmark pubblica anche una visione escludendo quei tre domini, sotto la quale la classificazione potrebbe cambiare.
GDPx vs GDPval: perché SemiAnalysis ha costruito un benchmark rivale
L'obiettivo dichiarato è GDPval, il benchmark pubblicato da OpenAI il 25 settembre 2025, ora il metro di riferimento più citato nei fogli di lancio dei modelli. SemiAnalysis sostiene che GDPval appartiene all'era pre-agente: ogni compito è descritto integralmente nella richiesta e non permette alcuna interazione, quindi il modello riceve tutto il contesto fornito a mano. Cita inoltre un tasso di concordanza del 71% tra i valutatori umani sul sottoinsieme di riferimento di GDPval, una cifra che definisce debole come metro di misura.
GDPx è la scelta opposta: un compito arriva come ambiente da esplorare, non come domanda a cui rispondere. Ecco anche perché i suoi punteggi sembrano molto più bassi rispetto ai benchmark di codifica citati dai laboratori al lancio. Gli stessi modelli che disegnano livelli su test di codifica chiusi crollano quando il compito arriva con un ambiente caotico, una scadenza e nessuno che spiega cosa fare.
Quale modello scegliere per il lavoro da agente reale
- Scegli Claude Opus 5.5 quando il completamento conta di più e il budget lo permette. È il migliore assoluto e vince nettamente il trading, hardware e progettazione chip, ma a 51,41$ per compito è l'opzione costosa.
- Scegli Gemini 4 Carbon per lavori ad alto volume. Ottiene un punteggio entro 1,1 punti dal leader a circa un terzo del costo per compito, guida la biologia e supera di misura l'ingegneria del software.
- Scegli GPT-6 Astra per compiti in stile ricerca. È chiaramente avanti nell'auto-miglioramento ricorsivo e nella scienza dei materiali, ma costa di più per compito tra i primi tre a 53,99$.
- Tieni una persona aggiornata, qualunque cosa tu scelga. Con il 12% di completamento al massimo del livello, oggi non si può delegare lavoro professionale completo dal prompt alla consegna. Ciò che funziona è la parte intermedia: cercare in un archivio, fare bozze, incrociare, con una persona che tiene il filo e si assume la responsabilità del risultato.
Se vuoi il retroscena dei modelli in questa classifica, leggi le nostre analisi di Gemini 4 Carbon, il modello focalizzato sulla cybersecurity di Google, GPT-6.1 Terra, il modello di utilizzo rapido ed economico di OpenAI, e i benchmark e i prezzi Muse Wonder di Meta. Se stai pianificando di lavorare come agente per la tua azienda invece di fare benchmark, consulta i nostri servizi di sviluppo agenti AI e come assumere un'agenzia di automazione dell'IA.
Limitazioni da tenere a mente
- GDPx è un prodotto SemiAnalisi a pagamento. I compiti costruiti dal partner sono in gran parte privati, nessun laboratorio esterno ha replicato i risultati e solo una parte delle attività è pubblica, quindi i lettori non possono verificare la difficoltà del compito, ma si fidano solo degli autori.
- Il 12% riflette compiti scelti come difficili. Non è una prova che i modelli non possano svolgere lavori utili, e misura l'imbracatura così come il modello.
- Diversi risultati vividi si basano su piccoli campioni, da 5 a 25 escorse in alcuni punti. Trattali come illustrazioni, non come statistiche di popolazione.
- SemiAnalysis prevede nuove versioni ogni tre-sei mesi. La prossima lettura mostrerà se il 12% salirà rapidamente o rimarrà fermo.
Domande frequenti
Cos'è GDPx?
GDPx è un benchmark per gli agenti AI pubblicato da SemiAnalysis il 2 novembre 2026. Misura quanto lavoro professionale reale un modello svolge da solo, su 206 compiti in 11 professioni, con un massimo di otto ore per compito. Il punteggio più alto nella prima classifica è Claude Opus 5.5 con il 12,0%.
Perché i punteggi GDPx sono così bassi?
Perché ogni compito richiede di lavorare in un ambiente reale piuttosto che rispondere a una domanda. L'agente ottiene file da esplorare, strumenti da usare e un obiettivo da raggiungere, senza fornire alcun contesto nella richiesta. I compiti finanziari, ad esempio, partono da circa 4.000 documenti di un'acquisizione. Un lavoro quasi completato ma con un consegnabile sbagliato conta comunque come fallito.
Quale modello ha ottenuto il punteggio più alto su GDPx?
Claude Opus 5.5 ha ottenuto il punteggio più alto con il 12,0%, davanti a Gemini 4 Carbon al 10,9% e GPT-6 Astra al 9,6%. Tutti i dati sono riportati da SemiAnalisi e non sono stati replicati in modo indipendente.
Quanto costa ogni compito GDPx da gestire?
Claude Opus 5.5 ha avuto una media di 51,41 $ per compito, GPT-6 Astra 53,99 dollari e Gemini 4 Carbon 16,29 dollari. Il punteggio di carbonio entro 1,1 punti dal leader a circa un terzo del costo, che conta maggiormente per i flussi di lavoro ad alto volume.
In cosa si differenzia GDPx da GDPval di OpenAI?
GDPval descrive il compito nella richiesta nella richiesta e non consente alcuna interazione, quindi il modello riceve tutto il contesto in anticipo. GDPx inserisce l'agente in un ambiente che deve esplorare, con strumenti, file e un limite di otto ore. GDPval proviene da un laboratorio che vende modelli; GDPval proviene da una società di analisi che vende ricerca.
Posso provare i compiti di GDPx?
Solo in parte. Alcune attività sono pubbliche, come la task di winsorizzazione Apple che nessun modello ha risolto, mentre le altre restano chiuse per tenerle fuori dai dati di addestramento. SemiAnalysis ha aperto un indirizzo di contatto per aziende di dati che vogliono costruire compiti per versioni successive.
Un punteggio massimo del 12% dovrebbe impedirmi di usare gli agenti IA?
No. Dovrebbe impedirti di delegare un lavoro professionale completo da capo a capo senza un proprietario umano. Gli agenti gestiscono già bene il mezzo del lavoro: ricerca, draft, controlli incrociati e primi passaggi. La configurazione vincente oggi è un agente che fa il lavoro di campo e una persona che tiene il filo e firma il discorso.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks