Notizie IA6 min di letturaDi JH Akash
Claude Fable 5.2: #1 al 65, 20% in meno, 30% più veloce
Anthropic ha lanciato Claude Fable 5.2 il 9 novembre 2026. Arriva in cima all'Artificial Analysis Intelligence Index con il 65°, costa il 20% in meno di Fable 5.1 a $8/$40 per token da 1 milione, e arriva fino al 30% più veloce. Ecco i benchmark, il prezzo e il problema.
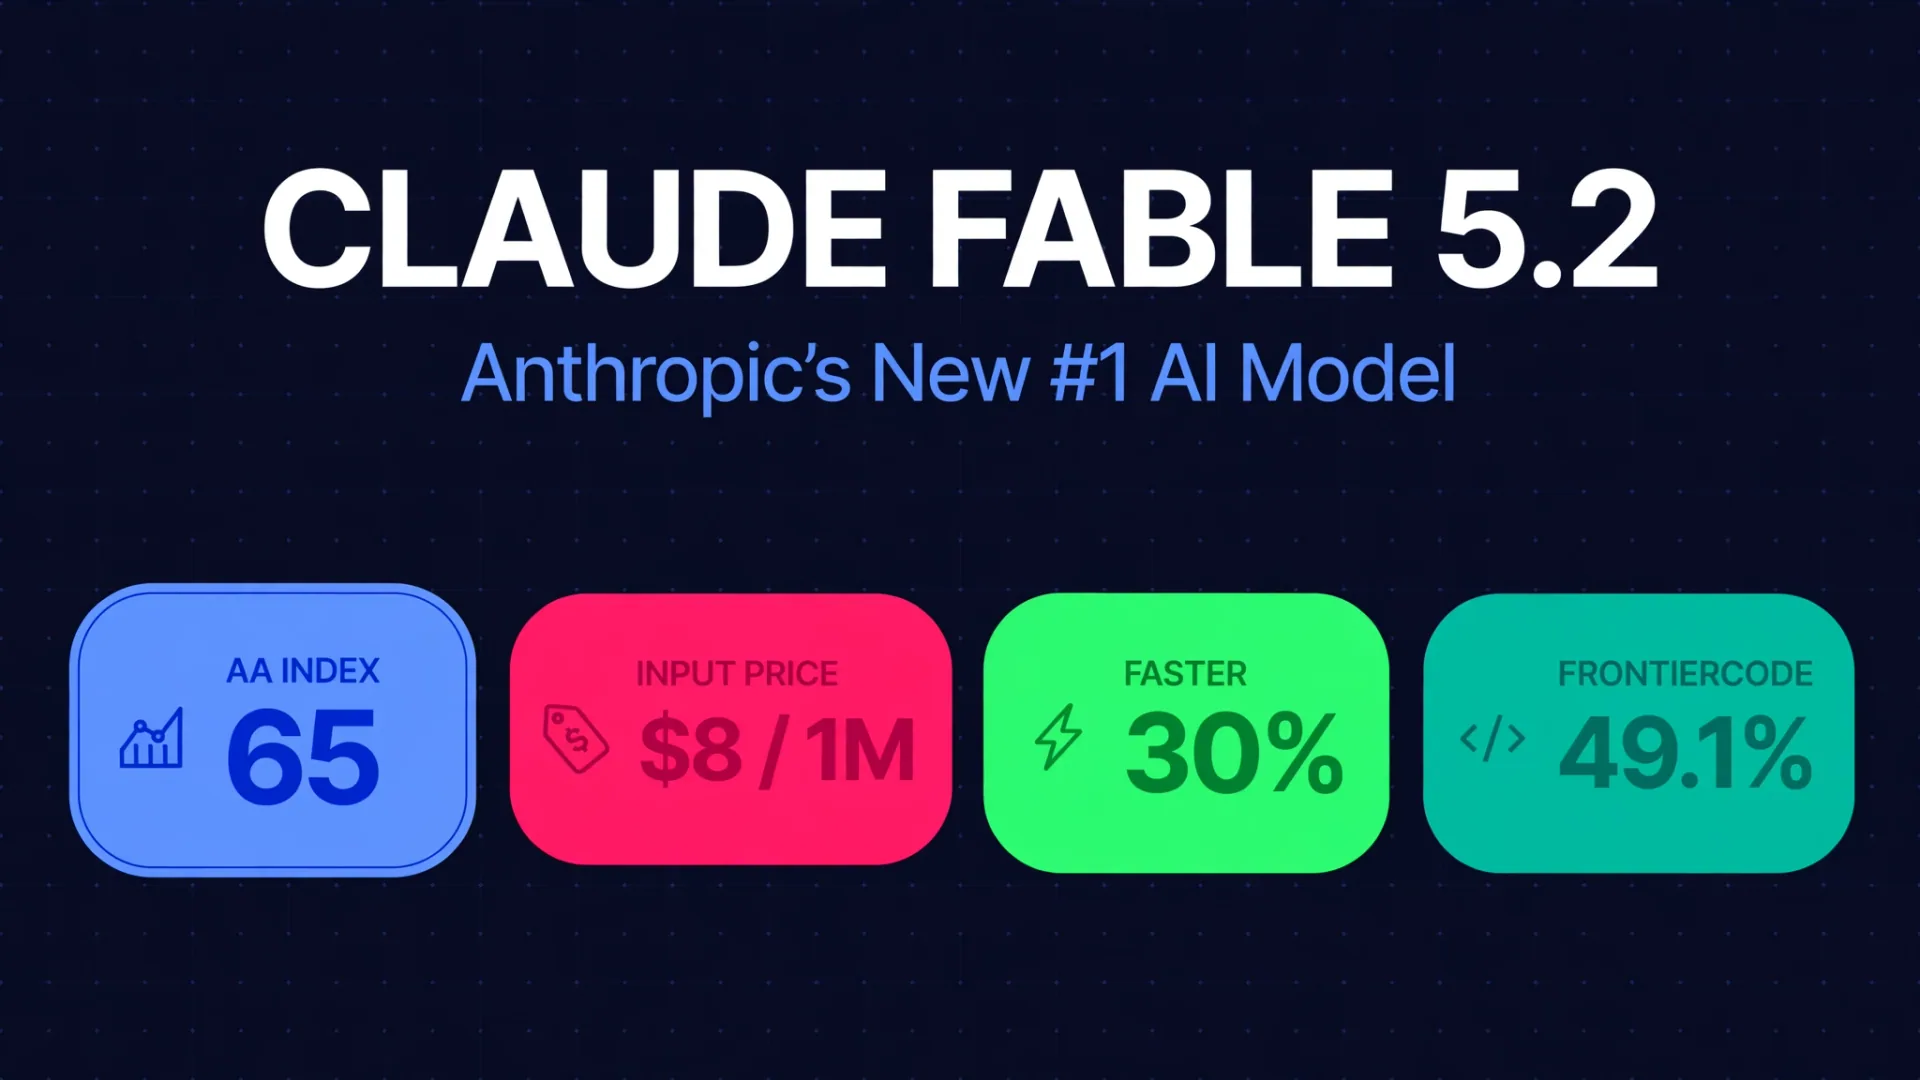
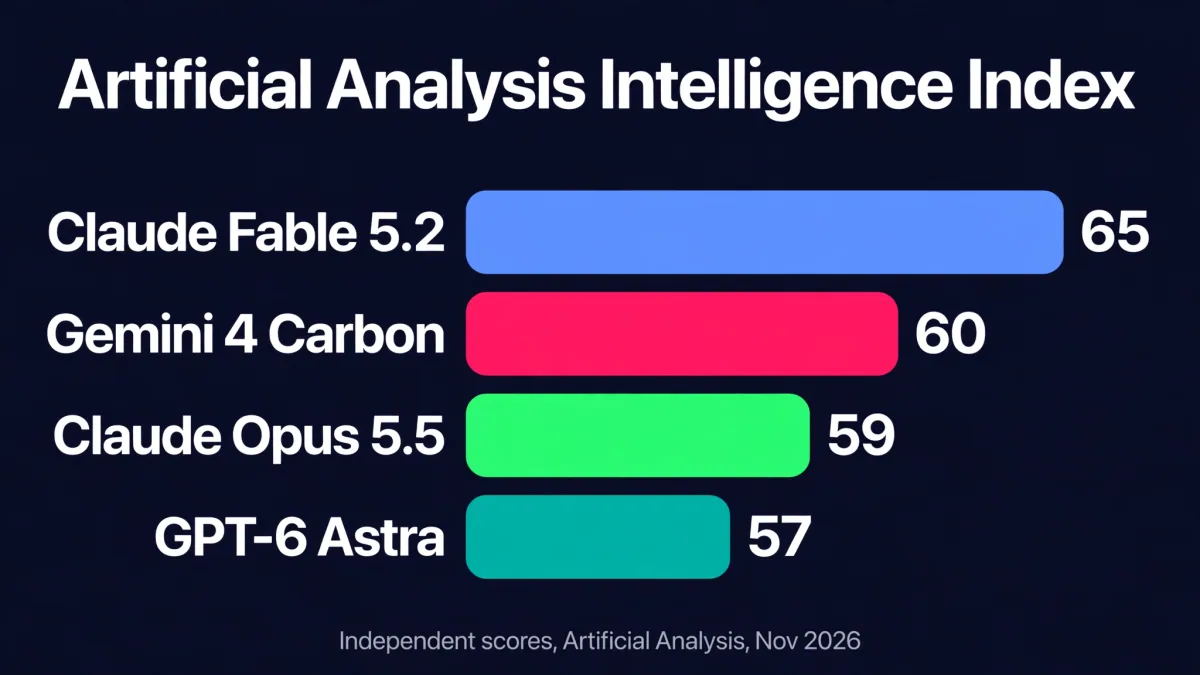
Anthropic ha spostato Claude Fable 5.2 il 9 novembre 2026, e ha fatto qualcosa che nessun modello Claude aveva mai fatto prima: ha conquistato la prima posizione nell'Indice di Intelligenza dell'Analisi Artificiale. Il nuovo modello ha un punteggio di 65, davanti a Gemini 4 Carbon con 60, Claude Opus 5.5 con 59 e GPT-6 Astra a 57. Costa anche il 20% in meno rispetto al modello che sostituisce e gira fino al 30% più veloce.
Questa combinazione, punteggi migliori e prezzo più basso, è rara nei lanci dell'IA. Ma i numeri principali nascondono un problema: al massimo sforzo, Fable 5.2 è uno dei modelli più lenti e costosi per compito. Ecco cosa è cambiato, quanto costa e chi dovrebbe effettivamente utilizzarlo.
Fable 5.2 a colpo d'occhio
| Claude Fable 5.2 | |
|---|---|
| Lancio | 9 novembre 2026 |
| Indice di Intelligenza dell'Analisi Artificiale (indipendente) | 65, 1º posto |
| Prezzo di input | $8 per ogni token da 1M |
| Prezzo di produzione | $40 per ogni token da 1M |
| Velocità | Fino al 30% più veloce di Fable 5.1 |
| Finestra di contesto | 1M di gettoni |
| Taglio della conoscenza | Giugno 2026 |
| ID modello | Claude-Fable-5-2 |
| Disponibile su | Piani a pagamento Claude, Claude Code, Claude Platform, AWS, Google Cloud, Azure |
Cosa è cambiato rispetto a Fable 5.1
L'aggiornamento prevede tre cose contemporaneamente: più economico, più veloce e più forte. Il prezzo dell'input è sceso da 10 a 8 dollari per milione di token e il prezzo dell'output da 50 a 40 dollari, un taglio del 20% su entrambi. La generazione di output è fino al 30% più veloce, e i tester hanno scoperto che il modello comunica più chiaramente rispetto alla versione 5.1.
Una nuova modalità veloce opzionale genera gettoni fino a 2,5 volte più velocemente per il doppio del prezzo, 16 dollari in ingresso e 80 dollari in uscita per milione di token. Fable 5.1 è ora un modello legacy.
Anthropic ha anche lanciato lo stesso giorno un fratello con riserva, Claude Mythos 5.2. È lo stesso modello di base senza alcune tutele cibernetiche e biologiche, e va solo a organizzazioni verificate. Fable 5.2 è la versione che tutti gli altri ricevono.
Prezzo: quanto costa Fable 5.2
| Modello | Input per 1M di token | Output per token da 1M | Lettura della cache per 1M di token |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 |
| Claude Fable 5.2, modalità veloce | $16 | $80 | - |
| Claude Fable 5.1 (eredità) | $10 | $50 | $0.25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Astra | $10 | $50 | - |
Fable 5.2 ora sottovaluta GPT-6 Astra del 20% al prezzo di listino. Ma costa comunque il doppio rispetto a Claude Opus 5.5, motivo per cui Anthropic raccomanda ancora Opus 5.5 per la codifica quotidiana e il lavoro di conoscenza. Fable è per il lavoro tecnico più ambizioso e aperto.
Nei piani Claude, non c'è un livello gratuito per Fable. Pro paga con crediti di utilizzo, e Max e Ultra lo includono fino a metà del limite settimanale durante la settimana di lancio.
Benchmark: dove conduce Fable 5.2
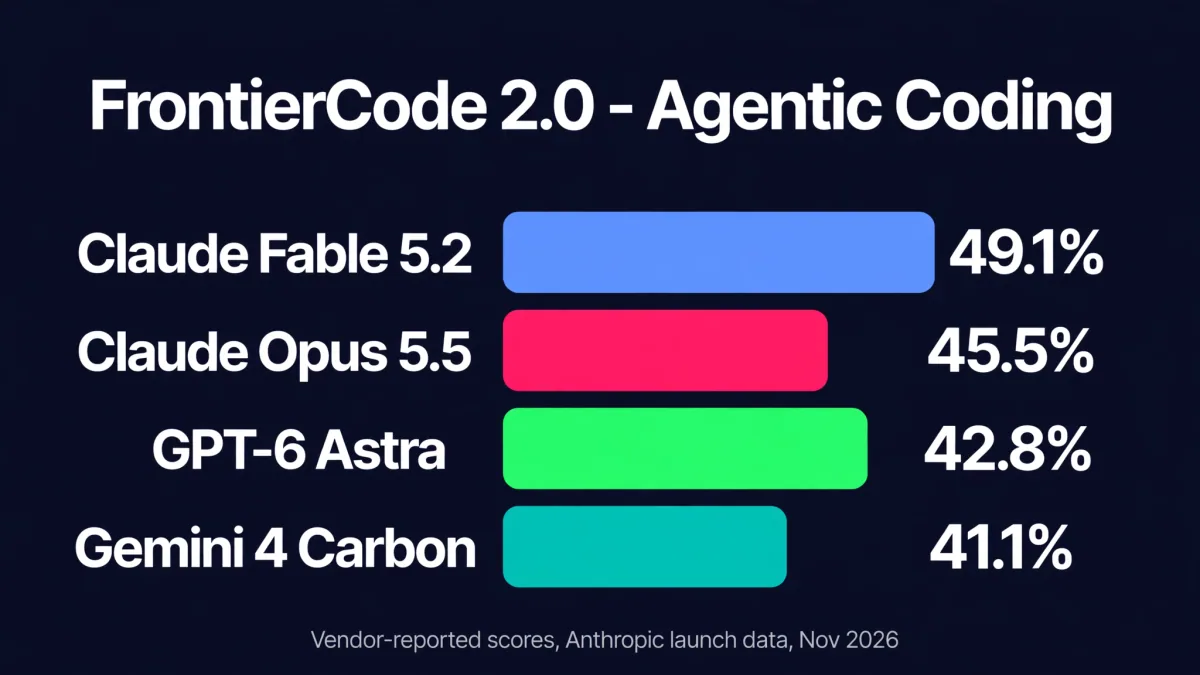
I punteggi qui sotto provengono dalla tabella di lancio di Anthropic, quindi trattali come riportati dal fornitore. Fable 5.2 guida tutti i concorrenti elencati per la codifica agentica, e guida Fable 5.1 in ogni benchmark pubblicato da Anthropic.
| Benchmark (riportato dal fornitore) | Favola 5.2 | Favola 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (codifica agentica) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (codifica agentica) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (flussi di lavoro aziendali) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| WANDR (ricerca agentica) | 82.1% | - | 72.3% | - | - |
Fable 5.2 non vince tutto. Gemini 4 Carbon è in testa su AutomationBench, 53,9% contro 51,4%, e Opus 5.5 mantiene il punteggio più alto AA-Briefcase Elo, 1800 contro 1785. Su Terminal-Bench 4.0, Fable 5.2 ha ottenuto il 60%, pari a Opus 5.5 e dietro Kimi K3.1 Pro, Gemini 4 Carbon e Claude Sonnet 5.5.
I risultati indipendenti sono stati ancora in classifica
Due tester esterni hanno pubblicato i risultati il giorno del lancio. Artificial Analysis, che esegue le sue valutazioni in modo indipendente, posiziona Fable 5.2 al primo posto del suo Intelligence Index con il massimo sforzo. Vals AI lo classifica primo su 36 modelli sull'Indice Vals con il 71,31%.
Ma i dati indipendenti mostrano anche il costo del punteggio più alto. Allo sforzo massimo, eseguire l'indice di Analisi Artificiale costa in media 26,54 dollari per compito, circa 2,6 volte superiore a Opus 5,5, e con circa 45 minuti per compito, Analisi Artificiale valuta Fable 5,2 tra i modelli più lenti testati. Lo stesso rapporto osserva che Fable 5.2 ad Alto Sforzo ha ottenuto un punteggio approssimativamente pari a Opus 5.5 a Massimo Sforzo su FrontierCode 2.0, 45,3% contro 45,5%, per circa la metà del costo per compito. Il livello di sforzo conta quanto il nome del modello.
Il problema: la conservazione dei dati a 30 giorni
A meno che Anthropic non autorizzi un'eccezione, Fable 5.2 richiede la conservazione di prompt e completamenti per 30 giorni. Non è disponibile con la conservazione zero dei dati. I team con politiche dati rigorose dovrebbero verificare questo prima di spostare i carichi di lavoro di produzione su Fable, anche se i benchmark sembrano allettanti.
Quale modello dovresti scegliere?
Scegli Claude Fable 5.2 per il lavoro più duro: lunghi compiti di programmazione autonomi, esecuzioni di agenti a più passaggi e problemi di livello ricerca dove l'accuratezza batte il costo. Eseguilo prima con Sforzo Alto, dato che corrisponde approssimativamente a Opus 5.5 allo sforzo massimo per circa la metà del costo per compito.
Scegli Claude Opus 5.5 per la programmazione quotidiana e il lavoro di conoscenza. Costa la metà per token, è più veloce in pratica, e continua a superare Fable 5.2 nell'elo di conoscenza e lavoro AA-Briefcase. Questo è il valore predefinito che Anthropic stesso consiglia.
Scegli GPT-6 Astra se il tuo stack è già costruito su OpenAI, e Gemini 4 Carbon se l'automazione del flusso di lavoro aziendale è il tuo caso d'uso principale, dato che guida AutomationBench. Leggi la nostra analisi GPT-6 Astra e la nostra copertura Gemini 4 Carbon prima di decidere.
Se vuoi un team che integri il modello giusto nei flussi di lavoro aziendali invece di indovinare, consulta i nostri servizi di sviluppo agenti IA.
Fonti
Annuncio di lancio di Anthropic e pagina dei prezzi, Artificial Analysis Intelligence Index v5, Vals AI Vals Index v2.2 e documentazione di Claude Platform, tutti controllati dal 9 al 10 novembre 2026. I benchmark riportati dai fornitori sono indicati come tali sopra.
Quanto costa Claude Fable 5.2?
8 dollari per milione di token di ingresso e 40 dollari per milione di token di output sull'API, in calo rispetto a 10 e 50 dollari su Fable 5.1. Una modalità veloce opzionale raddoppia questo valore a 16 e 80 dollari e genera token fino a 2,5 volte più velocemente. Le letture della cache costano 0,20 dollari per milione di token.
Claude Fable 5.2 è migliore di GPT-6 Astra?
Nei benchmark pubblicati, sì per la codifica agentica: Fable 5.2 ottiene un punteggio del 49,1% su FrontierCode 2.0 contro il 42,8% di GPT-6 Astra, e del 65% contro il 57 sull'Indice indipendente di Intelligenza dell'Analisi Artificiale. Ha inoltre un costo del 20% in meno. Entrambi i set di punteggi di codifica sono riportati dai fornitori da Anthropic.
Claude Fable 5.2 è disponibile gratuitamente?
No. Non esiste una modalità gratuita per Fable. È disponibile su Claude Pro (crediti di utilizzo), Max e Ultra, in Claude Code, sull'API di Claude Platform e tramite AWS, Google Cloud e Azure.
Cos'è Claude Mythos 5.2?
Mythos 5.2 è lo stesso modello di base di Fable 5.2 senza alcune tutele cyber e biologiche. È disponibile solo per organizzazioni selezionate, inclusi i membri dei Cyber and Life Sciences Verification Programs di Anthropic. Tutti gli altri ricevono Fable 5.2.
Dovrei passare da Claude Opus 5.5 a Fable 5.2?
Solo per i compiti più difficili. Fable 5.2 batte Opus 5.5 nei benchmark di codifica agentica, ma costa il doppio per token ed è più lento al massimo sforzo. Anthropic consiglia ancora Opus 5.5 come modello di uso quotidiano. Usa Fable dove la funzionalità extra vale il prezzo, e Opus ovunque altrove.
- Claude Fable 5.2
- Anthropic
- AI benchmarks
- GPT-6 Astra
- Gemini 4 Carbon