IA10 min de lecturePar JH Akash
LongCat 2.5 Explication : le modèle de codage multimodal 1.6T de Meituan
Le LongCat 2.5 de Meituan est lancé le 2 novembre 2026 : paramètres de 1,6T, contexte de 1M, entrée native image et vidéo, à 0,30 $/1,20 $ par million de tokens. Benchmarks, prix et points à connaître avant de changer.
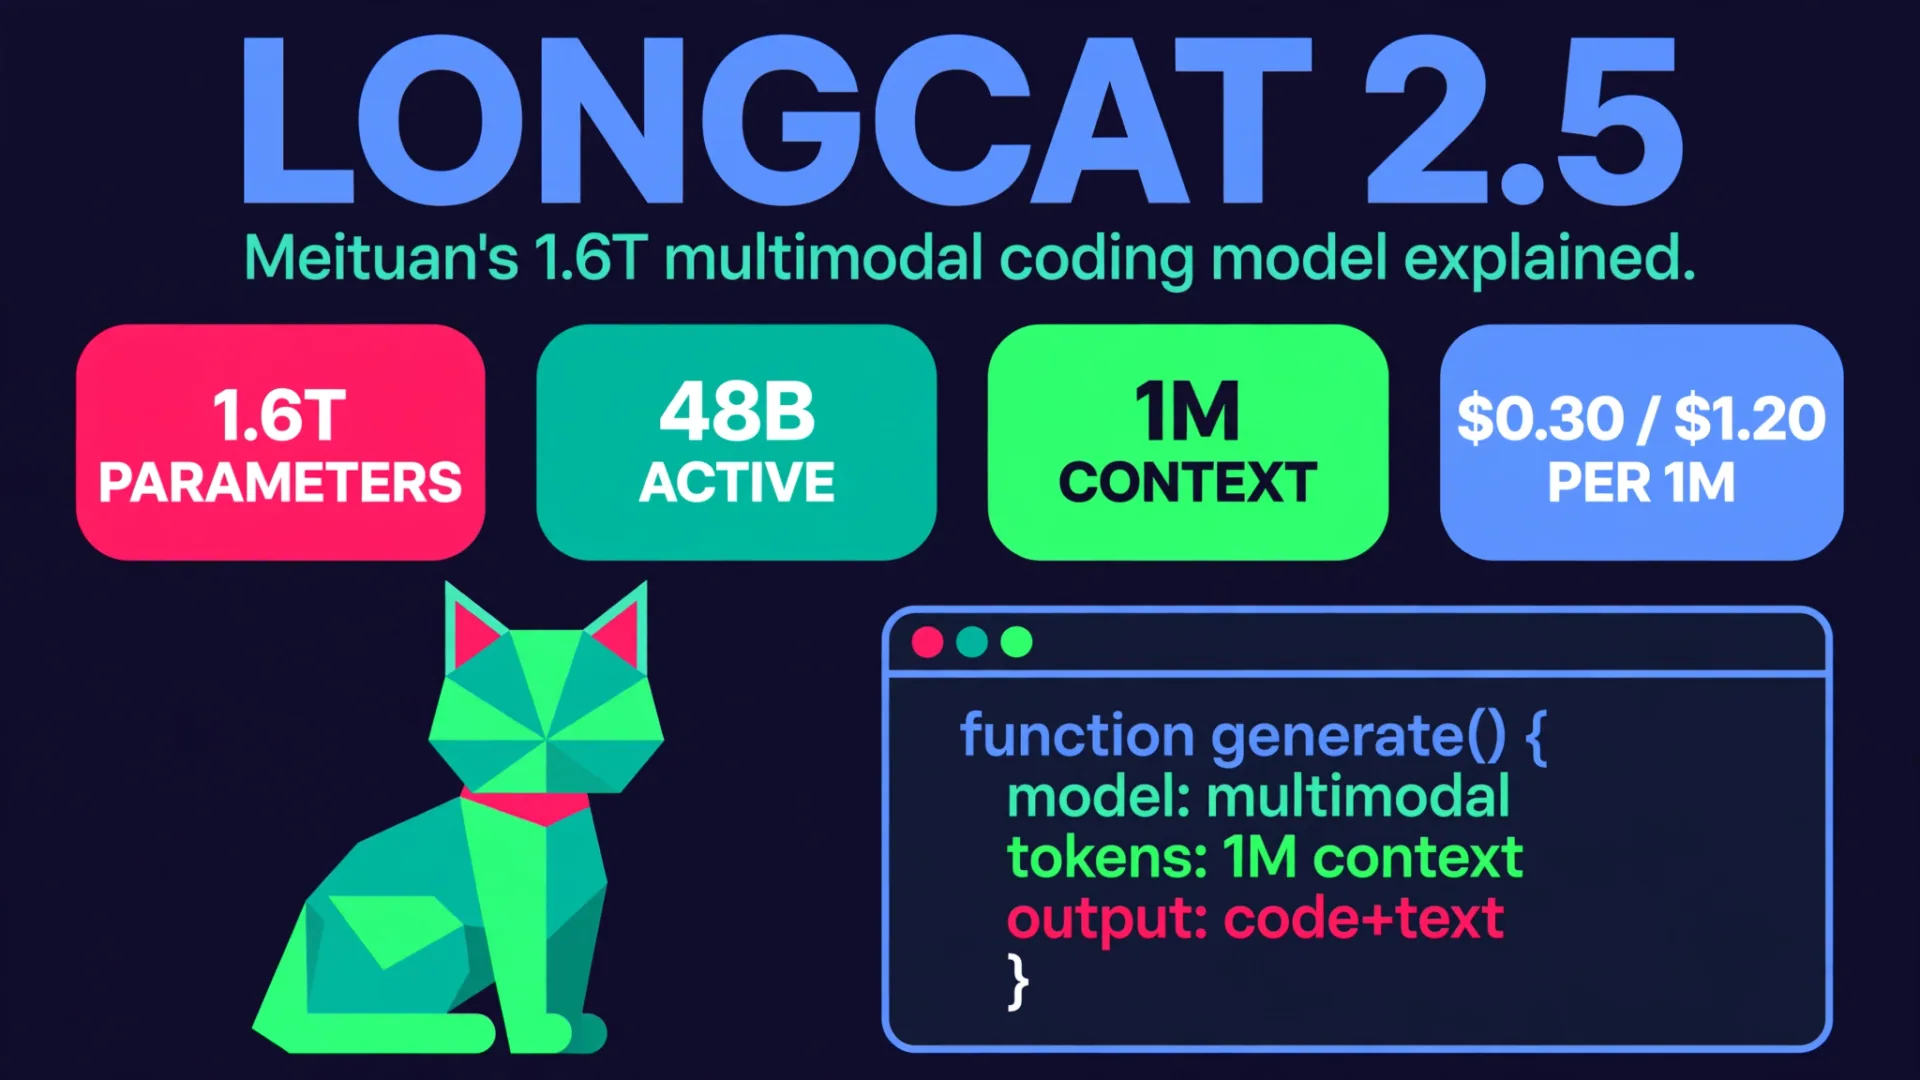
L’équipe LongCat de Meituan a lancé LongCat 2.5 le 2 novembre 2026, et le pitch est facile à comprendre : un modèle capable de lire du texte, des images et des vidéos, exécuter de longs travaux d’agent de code, et le faire à 0,30 $ par million de jetons d’entrée et 1,20 $ par million de jetons de sortie. Les chiffres sous-jacents à cette présentation sont plus intéressants que le titre. LongCat 2.5 représente un grand bond par rapport à LongCat 2.0, il égale DeepSeek V4.1 Flash en termes de prix, et son propre tableau de référence montre où un concurrent moins cher mène encore en codage pur.
Ce n’est pas un modèle nouveau et plus grand. LongCat 2.5 s’appuie sur LongCat 2.0, un modèle mixte d’experts de 1,6 billion de paramètres avec environ 48 milliards de paramètres actifs par jeton. Le changement concerne ce que le modèle peut voir et la quantité d’entraînement des agents qu’il a reçue. Tous les scores de benchmark dans cet article sont rapportés par les fournisseurs par Meituan sauf indication contraire, et aucun classement indépendant n’avait noté LongCat 2,5 au moment de la rédaction.
Verdict rapide
| Objet | LongCat 2.5 |
|---|---|
| Sortie | 2 novembre 2026, disponibilité générale sur la plateforme API LongCat |
| Taille | 1,6 billion de paramètres au total, environ 48 milliards d’actifs par jeton |
| Entrée | Texte, images et vidéo. La sortie est uniquement du texte |
| Contexte | 1 million de jetons. Prévoyez environ 128 000 jetons de production maximale |
| Prix | 0,30 $ par million de jetons d’entrée non cachés, 0,006 $ par million de jetons d’entrée mis en cache, 1,20 $ par million de jetons de sortie, tous classés comme une remise à durée limitée |
| Poids | Non publié. GitHub et Hugging Face sont marqués « bientôt à venir » |
| Le meilleur pour | Agents de codage budgétaire qui doivent lire des captures d’écran ou des enregistrements d’écran |
| Attention à | Pas de prix de liste, pas de politique publiée de conservation des données, et pas encore de scores indépendants |
Qu’est-ce qui a changé par rapport à LongCat 2.0
LongCat 2.0 était uniquement texte et en poids ouvert, publié sous licence MIT avec des poids sur Hugging Face. LongCat 2.5 conserve le même squelette 1.6T / 48B et ajoute la vision native ainsi qu’une formation d’agent à long horizon. La version preview est arrivée le 25 septembre 2026, suivie de la disponibilité générale le 2 novembre 2026, ajoutant la prise en charge de l’entrée vidéo et du Codex.
La vision est la fonctionnalité principale. LongCat 2.5 transforme les images en jetons discrets dans le même flux que les mots, au lieu d’ajouter un encodeur d’image à un modèle de texte. En pratique, cela signifie une résolution native : une capture d’écran haute devient plus des jetons qu’une miniature écrasée. La documentation permet jusqu’à 50 images par demande à 10 Mo chacune, et jusqu’à 10 vidéos à 100 Mo chacune et moins de 3 600 secondes. Il n’y a pas de ligne de prix distincte pour les images ou les vidéos. Vous payez pour les jetons qu’elles deviennent.
Côté agent, Meituan décrit un apprentissage par renforcement à grande échelle à long horizon sur des tâches construites à partir de pull requests filtrées sur GitHub, avec des pénalités pour raisonnement répétitif et appels répétés d’outils. Cela importe car la boucle sur de longues tâches était la plainte la plus forte des utilisateurs de prévisualisation. La première chose à tester sur votre propre dépôt est que la disponibilité générale ait corrigé le problème.
LongCat 2.5 fonctionne également entre les faisceaux d’agents, avec des guides pour Claude Code, Codex, OpenCode, Cline, Kilo Code et Hermes Agent, entre autres. Il prend en charge des terminaux compatibles OpenAI et compatibles Anthropic, donc le changement de faisceau est principalement un changement d’URL de base et de nom de modèle : LongCat-2.5.
Benchmarks : un vrai saut, avec un catch
Le tableau de Meituan montre un bond important par rapport à LongCat 2.0 sur les tâches d’agent. Ce sont des scores rapportés par les fournisseurs, exécutés avec la réflexion activée.
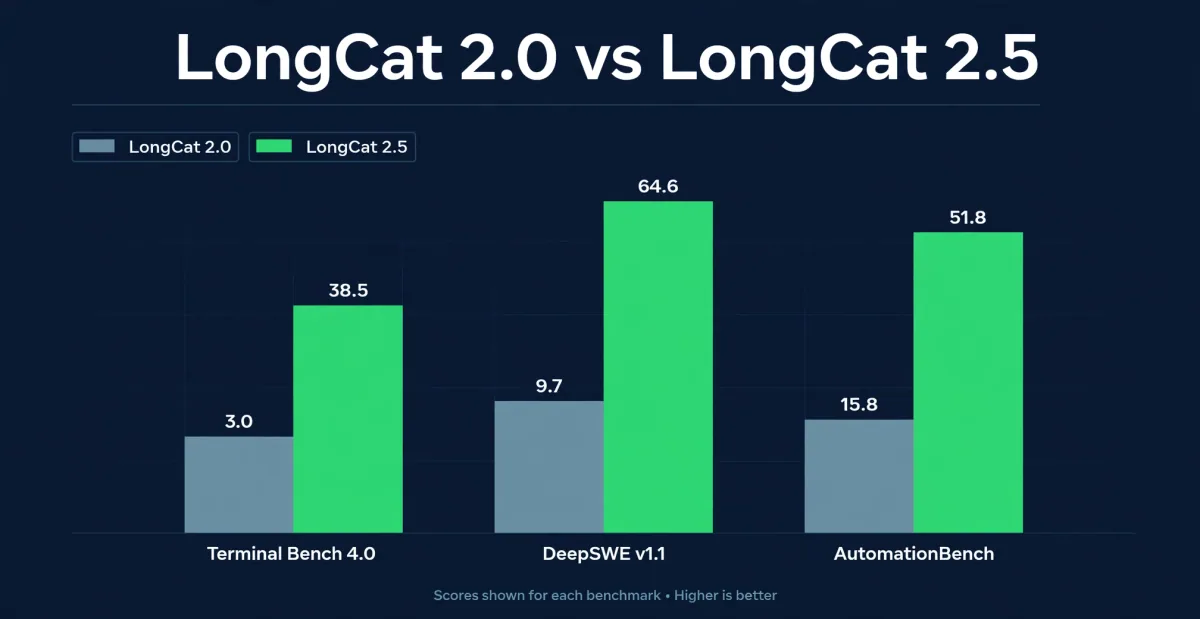
| Référence | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
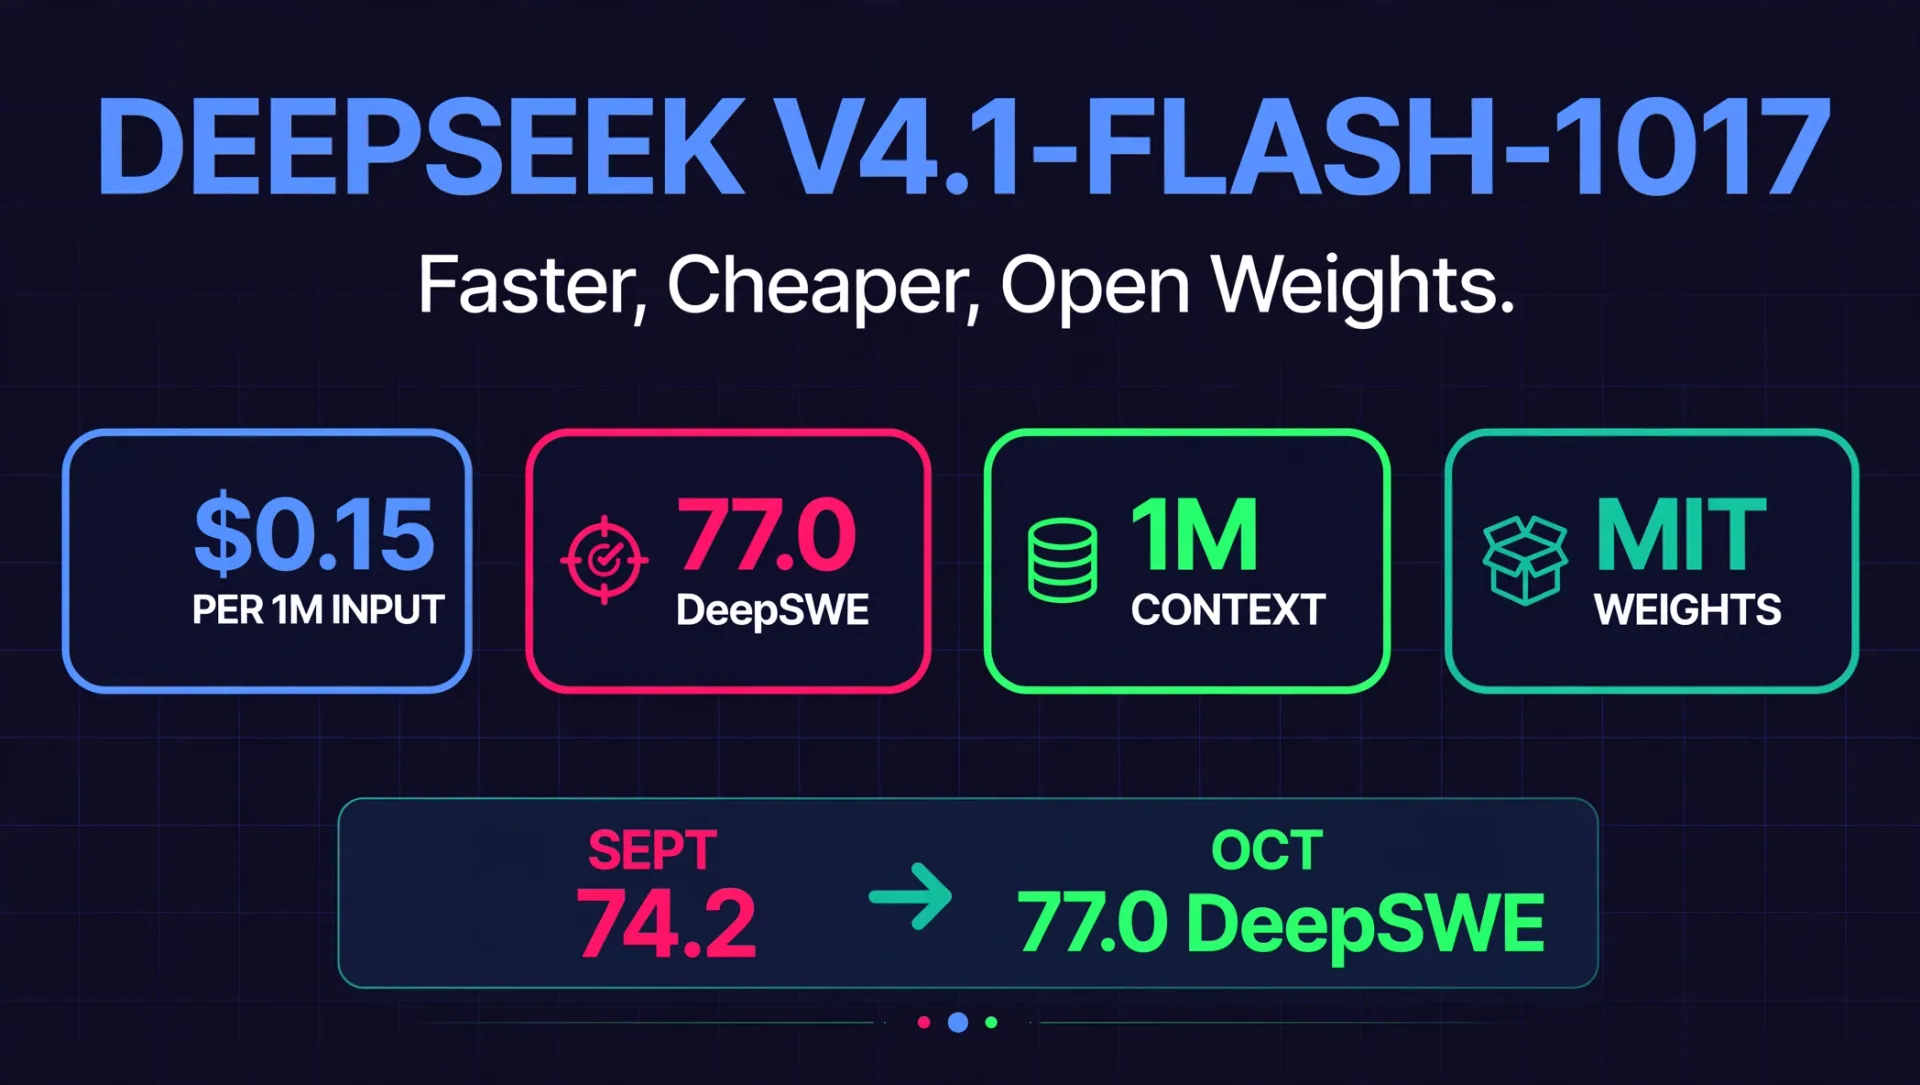
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| 3DCodeBench Texte vers 3D | 55.4 | Non rapporté | 53.4 | 49.3 | 54.3 |
| Vision2Web | 78.6 | Non rapporté | Non rapporté | 79.0 | 80.2 |
Source : tableau d’évaluation du blog technologique Meituan LongCat 2.5. Les scores pour d’autres modèles sont un mélange des propres résultats de Meituan et des chiffres tirés de rapports publics, que Meituan considère comme uniquement indicatifs. Différents benchmarks utilisent des harnais différents, donc ne comparez pas les scores entre benchmarks comme s’il s’agissait d’un seul classement.
À lire simplement, LongCat 2.5 devance son rival de prix sur Terminal Bench 4.0 (38,5 contre 31,2), BrowseComp (91,9 contre 91,5) et 3DCodeBench Text vers 3D (55,4 contre 53,4). DeepSeek V4.1 Flash est en tête sur Terminal Bench v2.1, DeepSWE v1.1, NL2Repo, MCP Atlas et AutomationBench (54,8 contre 51,8). LongCat 2.5 est l’un des deux à avoir des scores vidéo publiés, et ses résultats BrowseComp et 3D correspondent à son pitch visionnaire d’abord.
L’ensemble de comparaison mérite également d’être noté. Les graphiques principaux de Meituan comparent Claude Opus 5, GPT-5.6-Sol, Claude Opus 4.8 et GPT-5.5. Ils n’incluent pas Claude Opus 5.5, GPT-6.1 Sol ni Kimi K3.1 Pro. Pour la dernière image de la frontière, consultez nos articles précédents sur Claude Opus 5.5 et GPT-6 Astra, ainsi que notre répartition des indices de référence du GDPx, où l’Opus 5,5 mène à 12,0 %.
Prix : pas cher, mais à prix réduit et temporaire
| Modèle | Entrée pour 1M de jetons | Entrée mise en cache par 1M de jetons | Sortie par 1M de jetons |
|---|---|---|---|
| LongCat 2.5, réduction à durée limitée | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, sommet | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, hors-pointe | $0.15 | $0.003 | $0.60 |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 |
| Kimi K3.1 Pro | $2.00 | $0.20 | $10.00 |
| Kimi K3 | $3.00 | $0.30 | $15.00 |
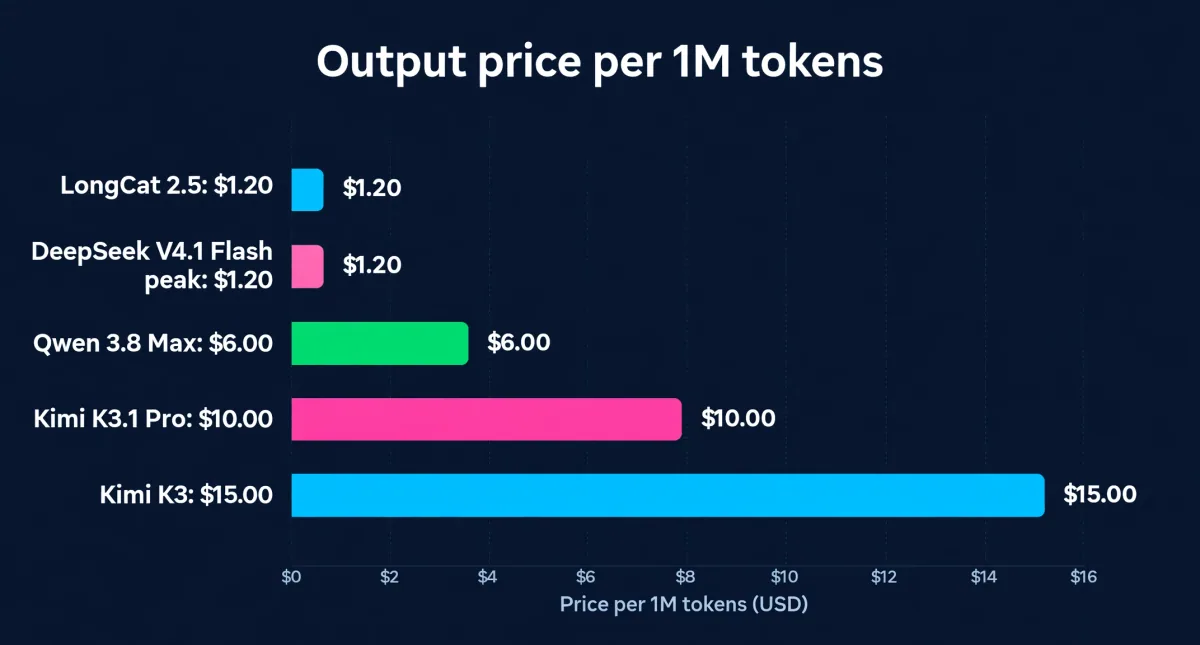
Deux détails rendent le prix plus utile que le titre. L’entrée mise en cache coûte seulement 2 % de l’entrée non mise en cache, ce qui est important pour les agents de codage qui renvoient les mêmes fichiers à chaque tour. Et il n’y a pas de surcharge de longueur contextuelle, donc une requête longue coûte le même par jeton qu’une requête courte.
Une simple facture aide. Une tâche avec 800 000 jetons d’entrée non cachés et 200 000 jetons de sortie coûte 0,48 $ sur LongCat 2.5 : 0,8 fois 0,30 $ plus 0,2 fois 1,20 $. L’exemple résolu de Meituan, 600 000 jetons d’entrée non cachés, 400 000 jetons d’entrée mis en cache et 500 000 jetons de sortie, coûte 0,7824 $.
Le risque vient de l’étiquette de réduction. Chaque prix LongCat 2.5 porte l’expression « remise à durée limitée », sans prix catalogue ni date de fin publiée. Une ancienne page LongCat 2.0 montrait un prix de référence de 0,75 $ en entrée, 0,015 $ en cache et 2,95 $ en sortie à côté de la même réduction. Meituan n’a pas précisé que LongCat 2.5 passerait à ce prix catalogue, mais qu’il ne prévoyait le tarif réduit que si vous pouvez absorber une augmentation.
Lequel choisir
Essayez LongCat 2.5 si vous utilisez des agents de codage avec un budget limité et que vous en voulez un capable de lire des captures d’écran ou des enregistrements d’écran. À 0,30 $ / 1,20 $ avec 2 % d’entrée en cache, un après-midi de tests sur votre propre dépôt coûte quelques euros. Comparez directement avec DeepSeek V4.1 Flash au même prix, mais sur vos propres tâches, pas sur les graphiques de lancement.
Choisissez plutôt DeepSeek V4.1 Flash si le codage à long terme est tout le travail. Sur le tableau de Meituan, il mène sur plus de lignes de codage et réduit de moitié son prix hors pointe. Il offre également une production maximale plus longue dans les comparaisons tierces, avec 384 000 jetons contre 128 000 prévus pour LongCat 2.5.
Attendez si vous avez besoin de poids ouverts, d’une licence ou d’un hébergement autonome. LongCat 2.5 est uniquement API pour l’instant, et même quand les poids arrivent, un modèle 1,6T nécessite une configuration multi-GPU. LongCat 2.0 reste l’option téléchargeable.
Laissez-le passer pour l’instant si vos invites contiennent des données clients ou réglementées. La FAQ LongCat et les pages de facturation ne précisent rien sur la durée de conservation des invites ni sur l’utilisation du trafic API pour la formation. Ce silence appartient à la décision, quel qu’en soit le prix.
Si vous construisez des agents pour les clients plutôt que de tester des modèles vous-même, le modèle n’est qu’une partie du système. Nos services de développement d’agents IA et nos postes d’agence d’automatisation IA couvrent le travail environnant : outils, vérifications, règles d’escalade et déploiement.
Des prises à connaître avant votre première partie
- Confusion sur le cap de sortie. La page des paramètres du modèle permet jusqu’à 262 144 jetons max, mais le démarrage rapide, la FAQ et la configuration Claude Code de Meituan pointent tous vers 128 000. Prévoyez autour de 128 000 et considérez tout ce qui est au-dessus comme un bonus à tester.
- La température est fixe. Elle est de 1,0 avec la réflexion activée et 0,7 avec la pensée déplacée, et d’autres valeurs sont silencieusement écartées plutôt que rejetées. Si votre harnais d’évaluation balaie la température, il ne fait pas ce que vous pensez.
- Les limites de débit ne sont pas publiées. Les limites sont par clé API et donnent un 429 avec un indice de réessai de 60 secondes, mais aucune demande par minute ou chiffre de jetons par minute n’est publiée.
- Les anciens identifiants de modèles peuvent disparaître. LongCat 2.0 et 2.5-Preview ont disparu des tableaux des modèles supportés sans avis de retraite daté. Si vous avez épinglé un ancien ID, testez-le aujourd’hui.
- Pas encore de scores indépendants. Analyse artificielle ne liste que LongCat 2.0, et OpenRouter ne renvoie que LongCat 2.0. Un test d’aperçu indépendant a rapporté un résultat très différent de Terminal Bench 2.1 par rapport à 88.4 de Meituan, sur un autre faisceau. Faites votre propre test avant de vous engager.
FAQ
Qu’est-ce que LongCat 2.5 ?
LongCat 2.5 est le tout nouveau grand modèle de langage de Meituan, généralement disponible sur la plateforme API LongCat depuis le 2 novembre 2026. Il prend du texte, des images et des vidéos en entrée, est ajusté pour des agents de codage de longue durée, et succède au LongCat 2.0 à poids ouvert.
Combien coûte LongCat 2.5 ?
LongCat 2.5 coûte 0,30 $ par million de jetons d’entrée non mis en cache, 0,006 $ par million de jetons d’entrée mis en cache et 1,20 $ par million de tokens de sortie. Meituan étiquete les trois comme une remise à durée limitée et ne publie ni prix de listage ni date de fin, donc le prix pourrait augmenter. C’est le même taux que DeepSeek V4.1 Flash aux heures de pointe.
LongCat 2.5 est-il open source ?
Pas encore. Le blog de lancement de Meituan indique que les liens GitHub et Hugging Face sont « bientôt à venir », et au 3 novembre 2026, aucun dépôt ou licence LongCat 2.5 n’était encore apparu, il n’est donc pour l’instant que l’API est disponible. LongCat 2.0 reste le modèle LongCat le plus récent avec des poids MIT ouverts.
Puis-je utiliser LongCat 2.5 en Claude Code ou Codex ?
Oui. La documentation de Meituan montre comment pointer Claude Code vers le point de terminaison au format Anthropic avec le modèle réglé sur LongCat-2.5, et il existe un guide de correspondance pour Codex utilisant l’API Responses. Attendez-vous à des particularités : la température est fixée par la plateforme et la sortie est plafonnée à 128 000 jetons dans la documentation.
Comment LongCat 2.5 se compare-t-il à DeepSeek V4.1 Flash ?
Sur le prix, ils correspondent au sommet : 0,30 $ d’entrée et 1,20 $ de sortie par million de tokens. Sur le tableau de benchmark de Meituan, LongCat 2.5 mène sur Terminal Bench 4.0, BrowseComp et 3DCodeBench Text vers 3D, tandis que DeepSeek V4.1 Flash est en tête sur des lignes de codage à long horizon et est moins cher hors pointe. LongCat 2.5 ajoute des entrées vidéo, ce que DeepSeek V4.1 Flash ne correspond pas dans cette comparaison.
LongCat 2.5 est-il bon pour le support client ?
Ce n’est plus un premier choix aujourd’hui. La documentation LongCat ne dit rien sur la conservation des données ou la formation sur les données API, ce qui est important lorsque les invites contiennent des informations clients. Pour le support technique, un agent helpdesk testé avec une gestion claire des données est la voie la plus sûre que de brancher un modèle brut dans une file d’attente.
En résumé
LongCat 2.5 est une véritable amélioration par rapport à la 2.0, avec une vision intégrée plutôt que fixée, à un prix qui n’a pas évolué. Ce n’est tout simplement pas le choix évident à son prix pour le codage pur, et c’est sa propre table de référence qui permet de le constater. Testez-le sur un travail axé sur un agent très visionnel, comparez-le avec DeepSeek V4.1 Flash sur votre propre dépôt, et gardez les données clients disponibles jusqu’à ce que Meituan publie une politique claire sur les données.
- LongCat 2.5
- Meituan
- AI coding agents
- multimodal AI
- DeepSeek
- AI benchmarks