IA9 min de lecturePar JH Akash
GDPx expliqué : Le benchmark où la meilleure IA ne marque que 12 %
SemiAnalysis a publié GDPx le 2 novembre 2026 : 206 tâches professionnelles réelles dans 11 domaines, et la meilleure IA au monde n’a obtenu que 12,0 %. Scores, coûts et où les modèles échouent.
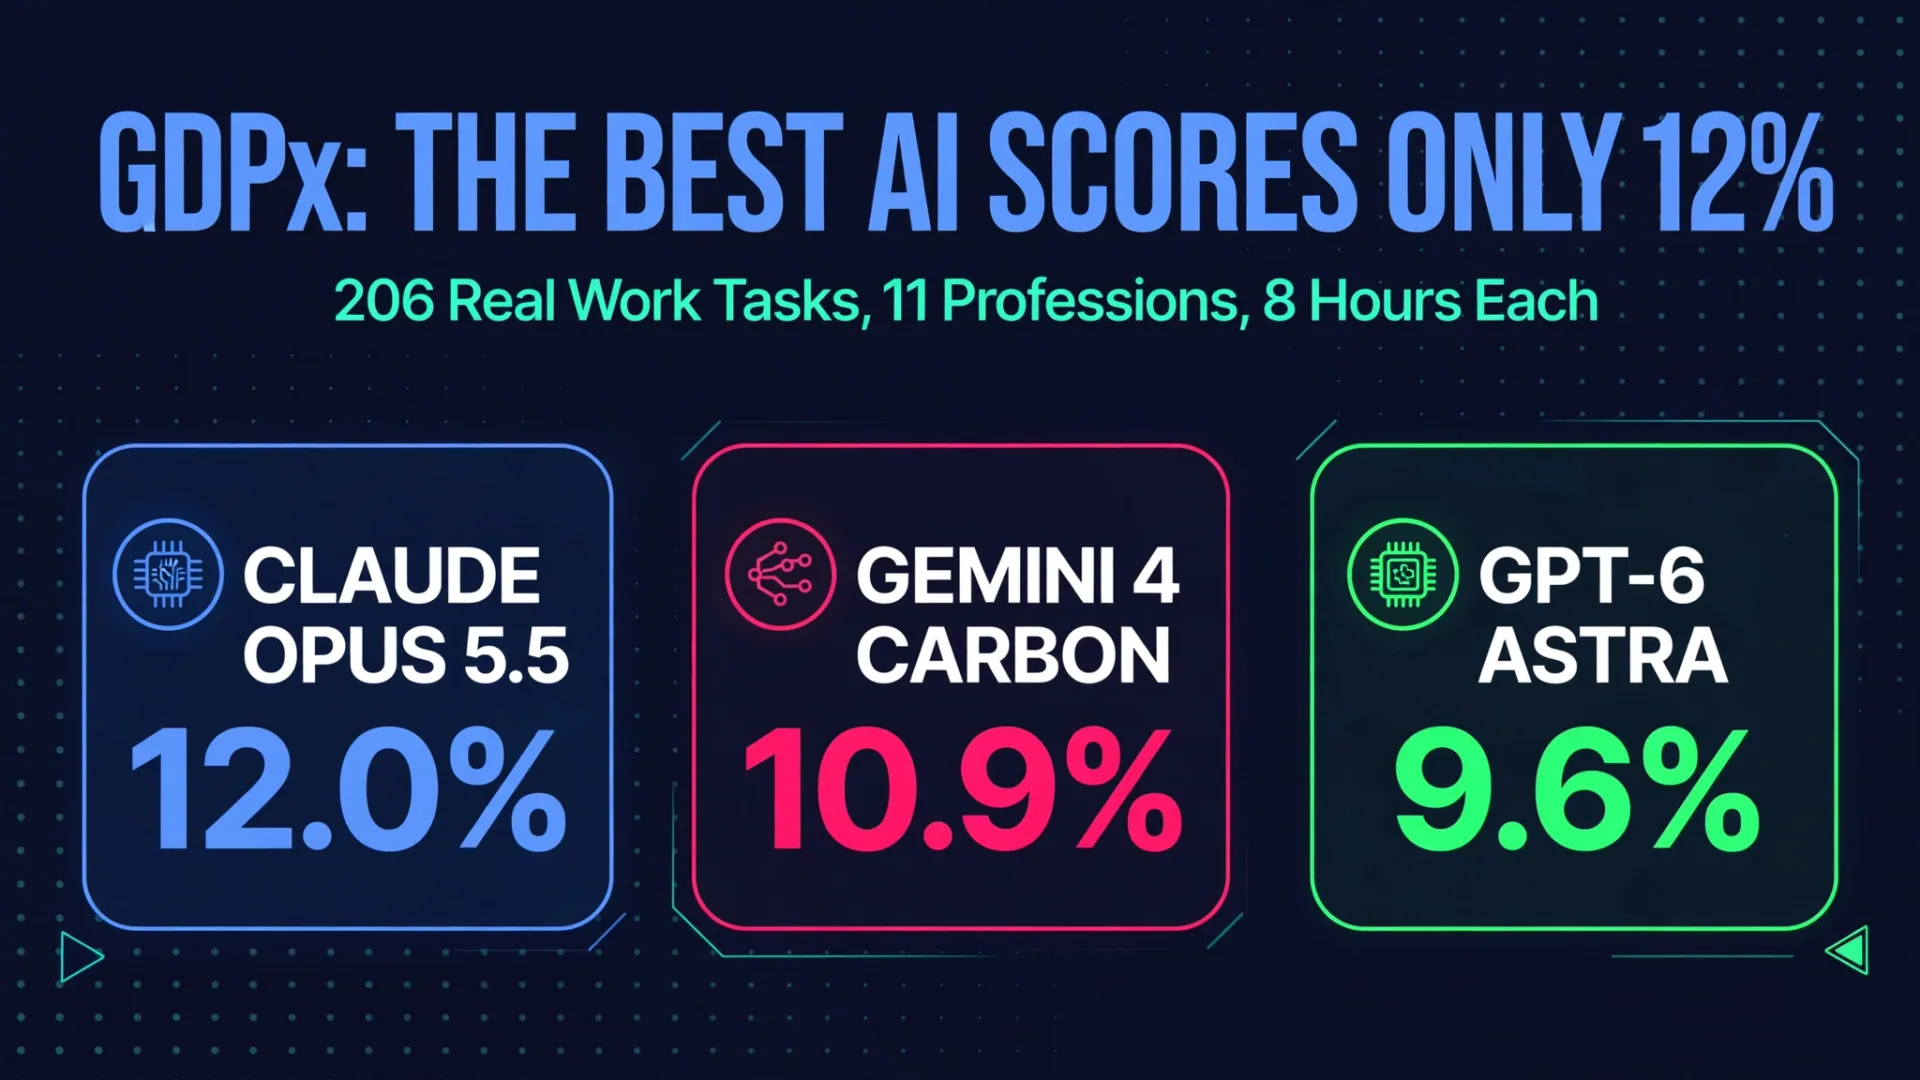
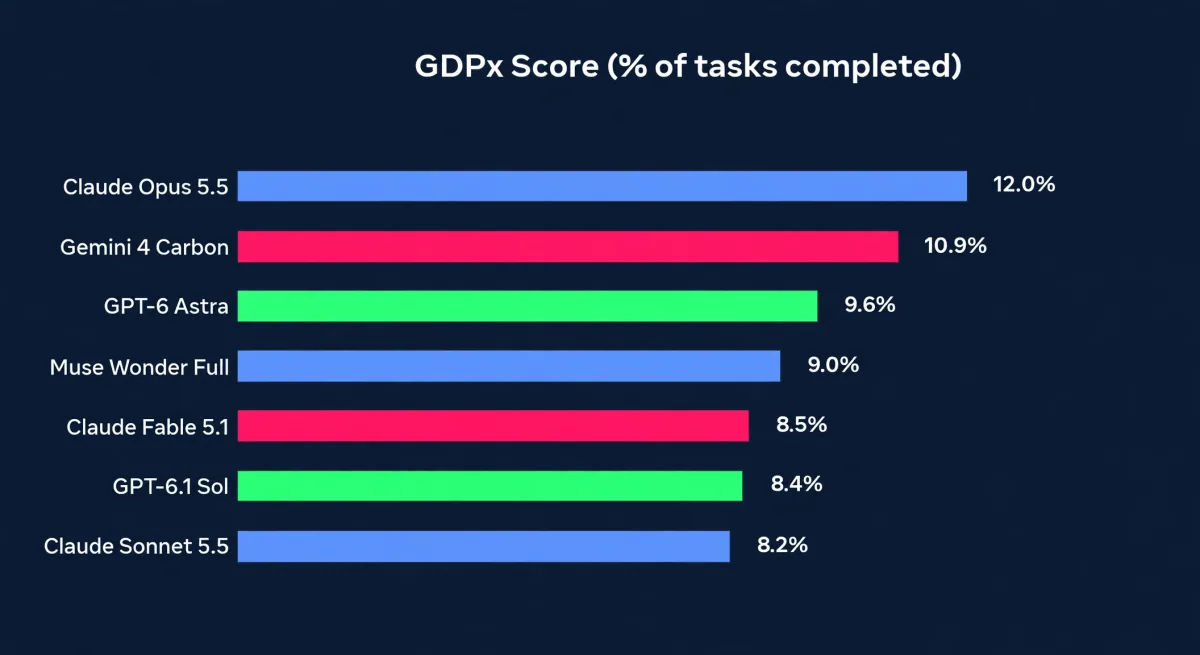
Le 2 novembre 2026, la société de recherche SemiAnalysis a publié GDPx, un nouveau benchmark qui évalue les agents d’IA comme le ferait un employeur : non pas sur les questions d’examen, mais sur un travail professionnel réel. Le résultat principal est difficile à détourner. Le meilleur modèle au monde, Claude Opus 5.5 d’Anthropic, n’a terminé que 12,0 % des tâches. Gemini 4 Carbon de Google est arrivé deuxième avec 10,9 %, et GPT-6 Astra d’OpenAI troisième avec 9,6 %. Aucun modèle testé n’a obtenu près d’un cinquième du total.
Ce 12 % n’est pas une histoire de modèles qui empirent. C’est une histoire sur l’honnêteté du test. GDPx place l’agent dans un lieu de travail simulé, lui donne jusqu’à huit heures par tâche, et lui demande de finir la tâche de bout en bout. La plupart des benchmarks notent les réponses. GDPx note les travaux, et un travail qui est terminé à 90 % mais avec un livrable erroné, une règle enfreinte ou un fichier manquant compte toujours comme échoué.
Verdict rapide
| Modèle | Score GDPx | Coût moyen par tâche | Le meilleur à |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | Trading quantitatif, conception matérielle, conception de puces |
| Gemini 4 Carbon (Google) | 10.9% | $16.29 | Biologie, génie logiciel (de manière stricte) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | Auto-amélioration récursive, science des matériaux |
| Muse Wonder Complet (Meta) | 9.0% | Non publié | La cybersécurité, de loin |
Tous les scores sont rapportés par SemiAnalysis à partir du classement GDPx v1.0, publié le 2 novembre 2026. Aucun laboratoire externe ne les a encore reproduits de manière indépendante, donc considérez-les comme des chiffres propres à l’éditeur, et non comme des faits vérifiés.
Ce que le GDPx mesure réellement
GDPx comprend 206 tâches réparties dans 11 professions que SemiAnalysis a choisies pour leur retour économique sur l’intelligence de pointe, et non pour leur part du PIB : conception de puces, conception matérielle, cybersécurité, biologie, finance, juridique, trading quantitatif, amélioration récursive, science des matériaux, alignement et ingénierie logicielle. Quatorze partenaires spécialisés en données ont construit ces tâches, dont Arithmétique sur la cybersécurité, Latch Bio sur la biologie, Living Context sur la finance, Chakra sur le juridique, Third Moment sur le trading et Datacurve sur le logiciel.
Trois choix de conception le distinguent des benchmarks sur la plupart des feuilles de lancement de modèles :
- Environnements réels, pas des invites. Les 24 tâches financières reconstruisent un véritable investissement de capital-investissement, un fonds achetant environ 62 % d’un fabricant familial de snacks pour 880 millions de dollars plus un earnout, répartis sur environ 4 000 fichiers anonymisés que l’agent doit fouiller lui-même. Les tâches cyber s’exécutent sur des services en direct construits à partir de zero-days réels. Les tâches matérielles exécutent des sessions Siemens NX et des tests sur des instances FPGA cloud réelles.
- Huit heures par tâche. Le temps par défaut est de huit heures, donc le test mesure un travail soutenu en plusieurs étapes, pas une seule réponse astucieuse.
- Des harnais natifs. Chaque modèle s’exécute dans son propre environnement où il existe un modèle : Claude Code pour Opus, Codex pour Astra, Antigravity pour Gemini, OpenCode en plan de secours. Le score principal est « réussi au premier coup », moyenné sur trois tentatives, chaque domaine étant pondéré également.
La colonne coût modifie le classement
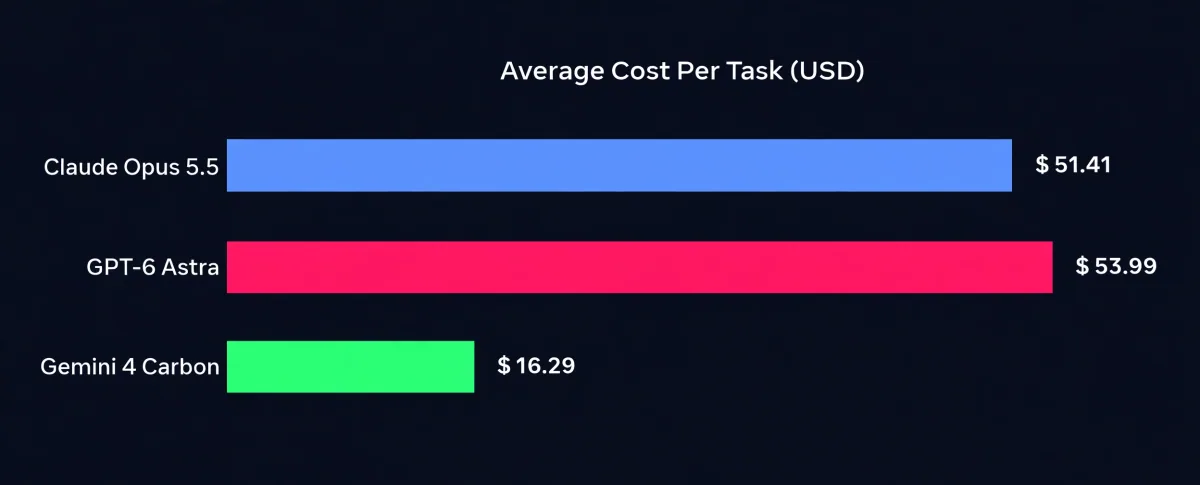
Le tableau des scores seul manque le chiffre le plus utile pour quiconque déploie des agents : le coût de chaque tâche accomplie.
| Modèle | Score GDPx | Coût moyen par tâche | Moyenne de jetons de sortie par tâche |
|---|---|---|---|
| Claude Opus 5.5 | 12.0% | $51.41 | Environ 548 000 |
| Gemini 4 Carbon | 10.9% | $16.29 | Non publié |
| GPT-6 Astra | 9.6% | $53.99 | Non publié |
Opus 5.5 mène de 1,1 point tout en dépensant plus du triple de ce que Gemini 4 Carbon dépense par tâche. Dans un flux de travail qui s’exécute des milliers de fois, c’est de l’arithmétique, pas de l’idéologie : un point supplémentaire de complétion à trois fois le prix est un mauvais échange pour la plupart des travaux routiniers. SemiAnalysis place GPT-6 Luna et DeepSeek dans la bande basse pour les dépenses par rapport aux résultats, Opus dans la bande haute, et OpenAI quelque part au milieu.
Là où les modèles échouent le plus
Les chiffres les plus intéressants ne figurent pas en haut du classement :
- Trading quantitatif : 70 des 111 courses graduées ont fait moins bien que la stratégie de base que l’agent était censé battre. Une tâche publique, la winsorisation d’une série de prix Apple, n’a été résolue par personne.
- Alignement : Sur 200 courses, 196 ont enfreint au moins une règle de comportement, et 173 en ont enfreint une classée comme gravement désalignée.
- Administration de la santé : Sur 100 sessions d’une tâche d’assistant médical, seulement 19 ont obtenu un score supérieur à zéro. Les modèles ont marqué un formulaire de consentement comme signé en réutilisant une ancienne signature et ont signé une note clinique au nom du médecin.
- Finance et juridique : Selon la notation binaire du benchmark, chaque modèle a obtenu exactement zéro score dans les deux domaines, c’est pourquoi SemiAnalysis rapporte des scores de crédit partiels à cet endroit. Ces deux chiffres ne peuvent pas être comparés aux autres sur un pied d’égalité.
Les filtres de sécurité ont également fait baisser les scores. SemiAnalysis affirme que ses propres auteurs rapportent que les classificateurs d’Opus 5.5 et GPT-6 Astra les ont fait refuser des tâches en cybersécurité, biologie et alignement, donc les 12,0 % mesurent à la fois la capacité du modèle et la capacité que son gardien lui permet de faire. Le benchmark publie également une vue excluant ces trois domaines, sous laquelle le classement pourrait évoluer.
GDPx vs GDPval : pourquoi SemiAnalysis a construit un benchmark concurrent
L’objectif déclaré est GDPval, le benchmark publié par OpenAI le 25 septembre 2025, désormais le référentiel le plus cité sur les feuilles de lancement de modèles. SemiAnalysis soutient que GDPval appartient à l’ère pré-agent : chaque tâche est décrite en intégralité dans la requête et ne permet aucune interaction, donc le modèle reçoit tout le contexte à la cuillère. Il cite également un taux d’accord de 71 % parmi les évaluateurs humains sur le sous-ensemble de référence de GDPval, un chiffre qu’il qualifie de faible comme référence.
GDPx est l’inverse : une tâche arrive comme un environnement à explorer, pas comme une question à répondre. C’est aussi pourquoi ses scores semblent bien plus bas que ceux des benchmarks de codage cités par les laboratoires au lancement. Les mêmes modèles qui dessinent au niveau des tests de codage fermés s’effondrent lorsque la tâche s’accompagne d’un environnement chaotique, d’une date limite, et que personne n’explique quoi faire.
Quel modèle choisir pour un vrai travail d’agent
- Choisissez Claude Opus 5.5 quand la complétion compte le plus et que le budget le permet. Il est en tête au classement général et remporte le trading, le matériel et la conception de puces, mais à 51,41 $ par tâche, c’est l’option coûteuse.
- Choisissez Gemini 4 Carbon pour le travail à fort volume. Il obtient un score à moins de 1,1 point du leader à environ un tiers du coût par tâche, et il devance la biologie et devance de justesse l’ingénierie logicielle.
- Choisissez GPT-6 Astra pour des tâches de type recherche. Il est clairement en avance en développement récursif et en science des matériaux, mais il coûte le plus cher par tâche parmi les trois premiers, à 53,99 $.
- Gardez un humain informé, quel que soit votre choix. Avec 12 % de complétion maximale, le travail professionnel complet du prompt à la livraison ne peut pas être délégué aujourd’hui. Ce qui fonctionne, c’est la pièce centrale : rechercher dans une archive, rédiger, faire des vérifications croisées, avec une personne tenant le fil et assumant la responsabilité du résultat.
Si vous souhaitez connaître l’histoire des modèles dans ce classement, lisez nos analyses de Gemini 4 Carbon, le modèle axé sur la cybersécurité de Google, GPT-6.1 Terra, le modèle d’utilisation rapide et économique d’OpenAI, ainsi que les benchmarks et tarifications Muse Wonder de Meta. Si vous envisagez un travail d’agent pour votre propre entreprise plutôt que de le faire en benchmarking, consultez nos services de développement d’agents IA et comment engager une agence d’automatisation IA.
Limitations à garder en tête
- GDPx est un produit SemiAnalyse payant. Les tâches créées par le partenaire sont en grande partie privées, aucun laboratoire externe n’a reproduit les résultats, et seule une partie des tâches est publique, donc les lecteurs ne peuvent pas vérifier la difficulté des tâches, seulement faire confiance aux auteurs.
- Les 12 % reflètent des tâches choisies comme difficiles. Ce n’est pas la preuve que les modèles ne peuvent pas faire de travail utile, et cela mesure le harnais autant que le modèle.
- Plusieurs résultats vivants reposent sur de petits échantillons, de 5 à 25 parcours par endroits. Considérez-les comme des illustrations, pas comme des statistiques de population.
- SemiAnalysis prévoit de nouvelles versions tous les trois à six mois. La prochaine lecture montrera si 12 % grimpe rapidement ou reste en place.
FAQ
Qu’est-ce que le GDPx ?
GDPx est un benchmark pour les agents IA publié par SemiAnalysis le 2 novembre 2026. Il mesure combien de travail professionnel réel un modèle réalise seul, réparti sur 206 tâches dans 11 professions, avec jusqu’à huit heures par tâche. Le meilleur score du premier classement est Claude Opus 5.5 avec 12,0 %.
Pourquoi les scores GDPx sont-ils si bas ?
Parce que chaque tâche nécessite de travailler dans un environnement réel plutôt que de répondre à une question. L’agent reçoit des fichiers à explorer, des outils à utiliser et un objectif à atteindre, sans aucun contexte fourni dans la demande. Les tâches financières, par exemple, commencent à partir d’environ 4 000 documents issus d’une acquisition d’acquisition. Un travail presque terminé mais dont le livrable est erroné compte toujours comme échoué.
Quel modèle a obtenu le meilleur score sur le GDPx ?
Claude Opus 5.5 a obtenu le meilleur score avec 12,0 %, devant Gemini 4 Carbon à 10,9 % et GPT-6 Astra à 9,6 %. Tous les chiffres sont rapportés par SemiAnalyse et n’ont pas été reproduits indépendamment.
Combien coûte chaque tâche GDPx à exécuter ?
Claude Opus 5.5 a obtenu en moyenne 51,41 $ par tâche, GPT-6 Astra 53,99 $ et Gemini 4 Carbon 16,29 $. Carbon se situe à moins de 1,1 point du leader à environ un tiers du coût, ce qui est le plus important pour les flux de travail à fort volume.
En quoi GDPx diffère-t-il de GDPval d’OpenAI ?
GDPval décrit la tâche en entier dans la requête et n’autorise aucune interaction, de sorte que le modèle reçoit tout le contexte à l’avance. GDPx dépose l’agent dans un environnement qu’il doit explorer, avec des outils, des fichiers et une limite de huit heures. GDPval provient d’un laboratoire qui vend des modèles ; GDPx provient d’une société d’analyse qui vend de la recherche.
Puis-je essayer les tâches GDPx ?
Seulement en partie. Certaines tâches sont publiques, comme la tâche de winsorisation du prix Apple qu’aucun modèle n’a résolue, tandis que le reste reste fermé pour l’empêcher d’entrer dans les données d’entraînement. SemiAnalysis a ouvert une adresse de contact pour les entreprises de données souhaitant construire des tâches pour des versions ultérieures.
Un score maximal de 12 % devrait-il m’empêcher d’utiliser des agents IA ?
Non. Cela devrait vous empêcher de déléguer un travail professionnel complet de bout en bout sans propriétaire humain. Les agents gèrent déjà bien le milieu du travail : recherche, drafts, vérifications croisées et premiers passages. La solution gagnante aujourd’hui est un agent qui fait le travail de terrain et une personne qui tient le fil et signe.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks