Actualités IA6 min de lecturePar JH Akash
Edge0-145B : 145B AI fonctionne sur une RTX 5090
Edge0-145B regroupe 145B de paramètres sur une seule RTX 5090, avec un score de 86,5 sur Terminal-Bench 2.1. Voici les références, la vitesse, le prix et les défauts.
Edge0-145B : 145B AI fonctionne sur une RTX 5090
Le 12 novembre 2026, Edge0 a lancé Edge0-145B, un modèle d’IA de 145 milliards de paramètres fonctionnant sur une seule carte graphique grand public. Les poids ont été adoptés sur Hugging Face le 11 novembre, l’article officiel du blog a suivi le 12 novembre, et au 14 novembre, le modèle avait déjà dépassé les 61 000 téléchargements, avec 11 379 étoiles sur GitHub.
L’affirmation principale est simple : une IA de classe frontière, sur votre propre ordinateur, sans facture cloud. Voici ce qu’est réellement le modèle, ce que disent les chiffres, et où se cachent les petits caractères.
Ce qu’est Edge0-145B
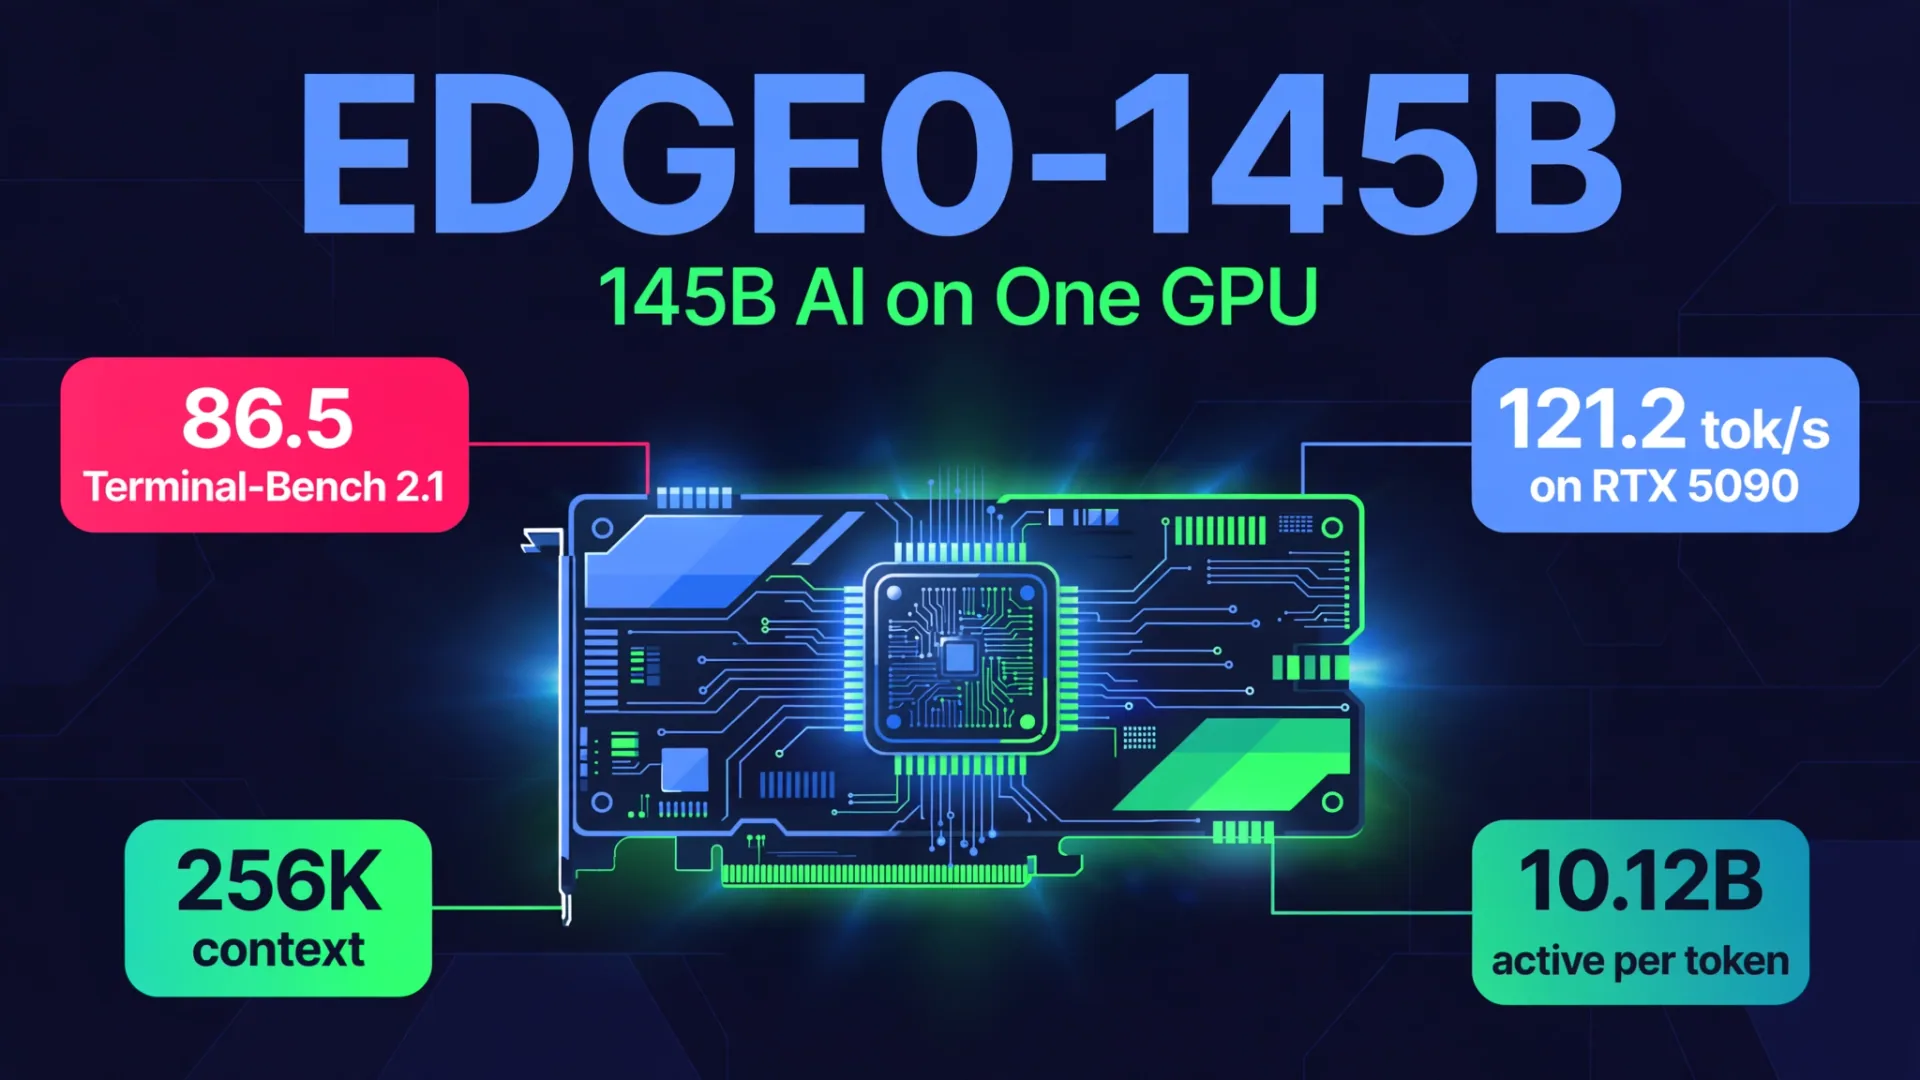
Edge0-145B est un modèle latent et clairsemé de mélange d’experts. Il possède 145 milliards de paramètres au total, mais seulement 10,12 milliards sont actifs pour chaque jeton, ce qui explique pourquoi il tient sur un seul GPU. L’architecture utilise 48 couches et 512 experts par couche, avec 10 experts routés plus 1 expert actif partagé par jeton. Elle a été entraînée nativement à une précision de 4 bits et livrée avec une fenêtre de contexte de 256 000 jetons.
| Spec | Edge0-145B |
|---|---|
| Paramètres totaux | 145B |
| Actif par jeton | 10.12B |
| Architecture | MoE latent clairsemé, 48 couches, 512 experts |
| Fenêtre de contexte | 256K jetons |
| Précision d’entraînement | 4 bits natifs |
| Poids | Q3_K 40,81 GiB, NVFP4 47,79 GiB |
| Modèle de base | Qwen3.8-Flash-Next (selon les métadonnées Hugging Face) |
| Licence | Licence Modèle Communautaire Edge0 1.0 |
| Sortie | 12 novembre 2026 |
Un petit frère sœur, Edge0-120B, a été lancé le même jour avec 120 milliards de paramètres totaux et 8,64 milliards actifs par jeton.
Les chiffres de vitesse
Edge0 rapporte ces vitesses de décodage à partir de ses propres tests, donc considérez-les comme déclarées par le fournisseur jusqu’à ce qu’il existe des exécutions indépendantes.
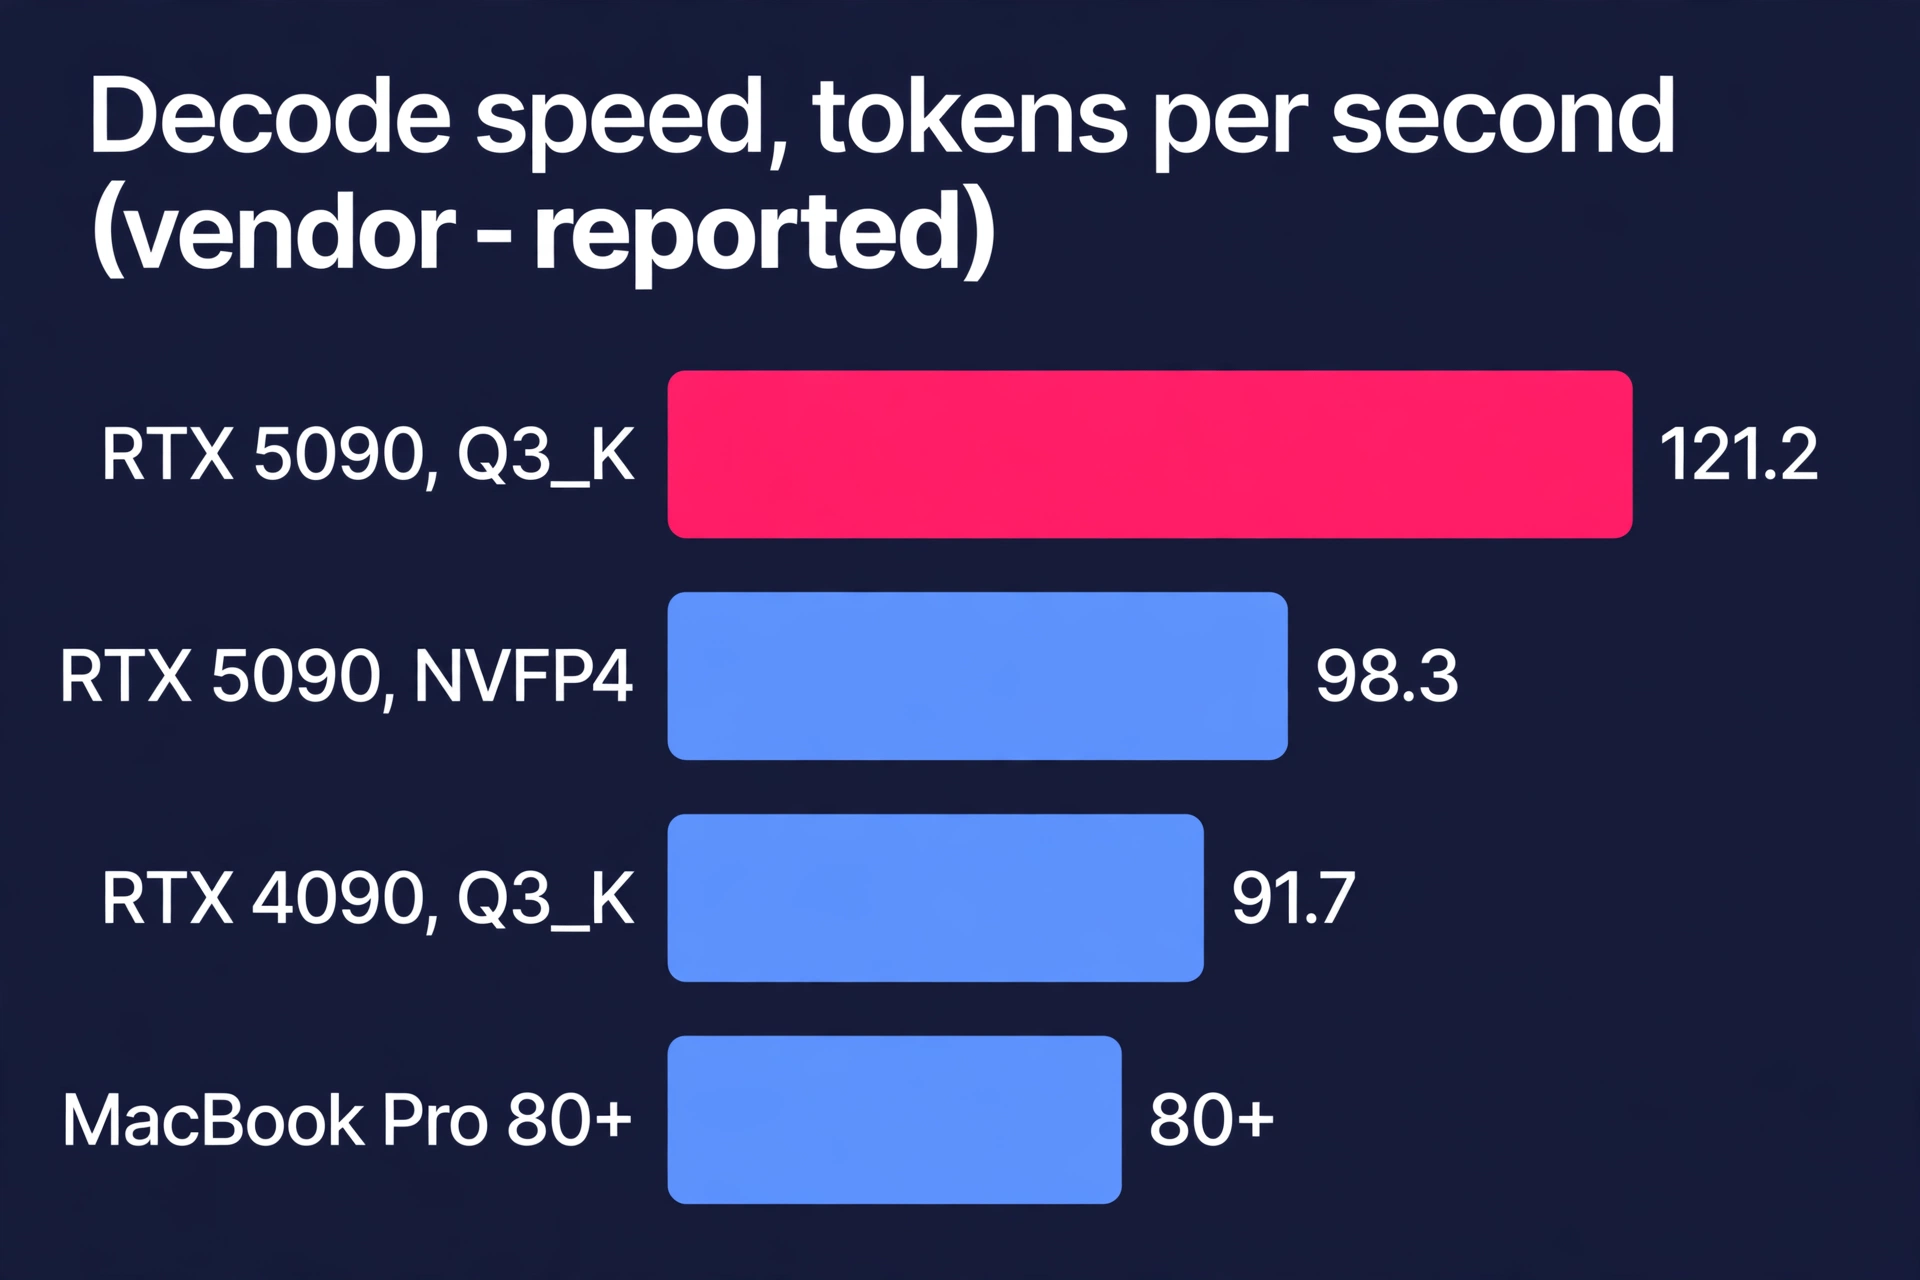
Sur une RTX 5090 D avec 24 Go de mémoire, la version Q3K décode à 121,2 jetons par seconde avec 3 554,9 jetons par seconde sur un préremplissage de 16 000 jetons. La version NVFP4 fonctionne à 98,3 jetons par seconde de décodage et 3 165,7 jetons par seconde de précharge. La même version Q3K atteint 91,7 jetons par seconde sur une RTX 4090. Sur un MacBook Pro, Edge0 rapporte plus de 1 100 jetons par seconde de préremplissage et plus de 80 jetons par seconde de décodage, à environ 120 W de puissance typique, avec un contexte de 128K à 256K à une vitesse presque identique.
Le support du premier jour couvre macOS, Windows et Linux sur les ordinateurs portables Apple M-series ainsi que les GPU RTX Spark, RTX 4090 et RTX 5090.
Les chiffres de référence
Chaque score ci-dessous provient des propres évaluations internes d’Edge0. L’entreprise indique qu’un rapport technique avec les instructions complètes d’installation et de reproduction est encore en attente, donc lisez ces informations comme des réclamations, et non comme des mesures réglées.
| Référence | Edge0-145B | Comparaison la plus proche |
|---|---|---|
| DeepSWE 1.1 | 64.6 | Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4 |
| Terminal Bench 2.1 | 86.52 | Qwen3.8-Flash-Next 83.3, DeepSeek-V4-Flash 82.7, Claude Opus 4.6 Max 78.2 |
| GPQA-Diamond | 90.4 | DeepSeek-V4-Flash 90.8, Claude Opus 4.6 Max 91.3 |
| IFBench | 80.6 | - |
| HLE | 35.4 | - |
| AA-LCR | 79.3 | - |
| Moyenne à six repères | 72.8 | Qwen3.8-Flash-Next 71.7 |
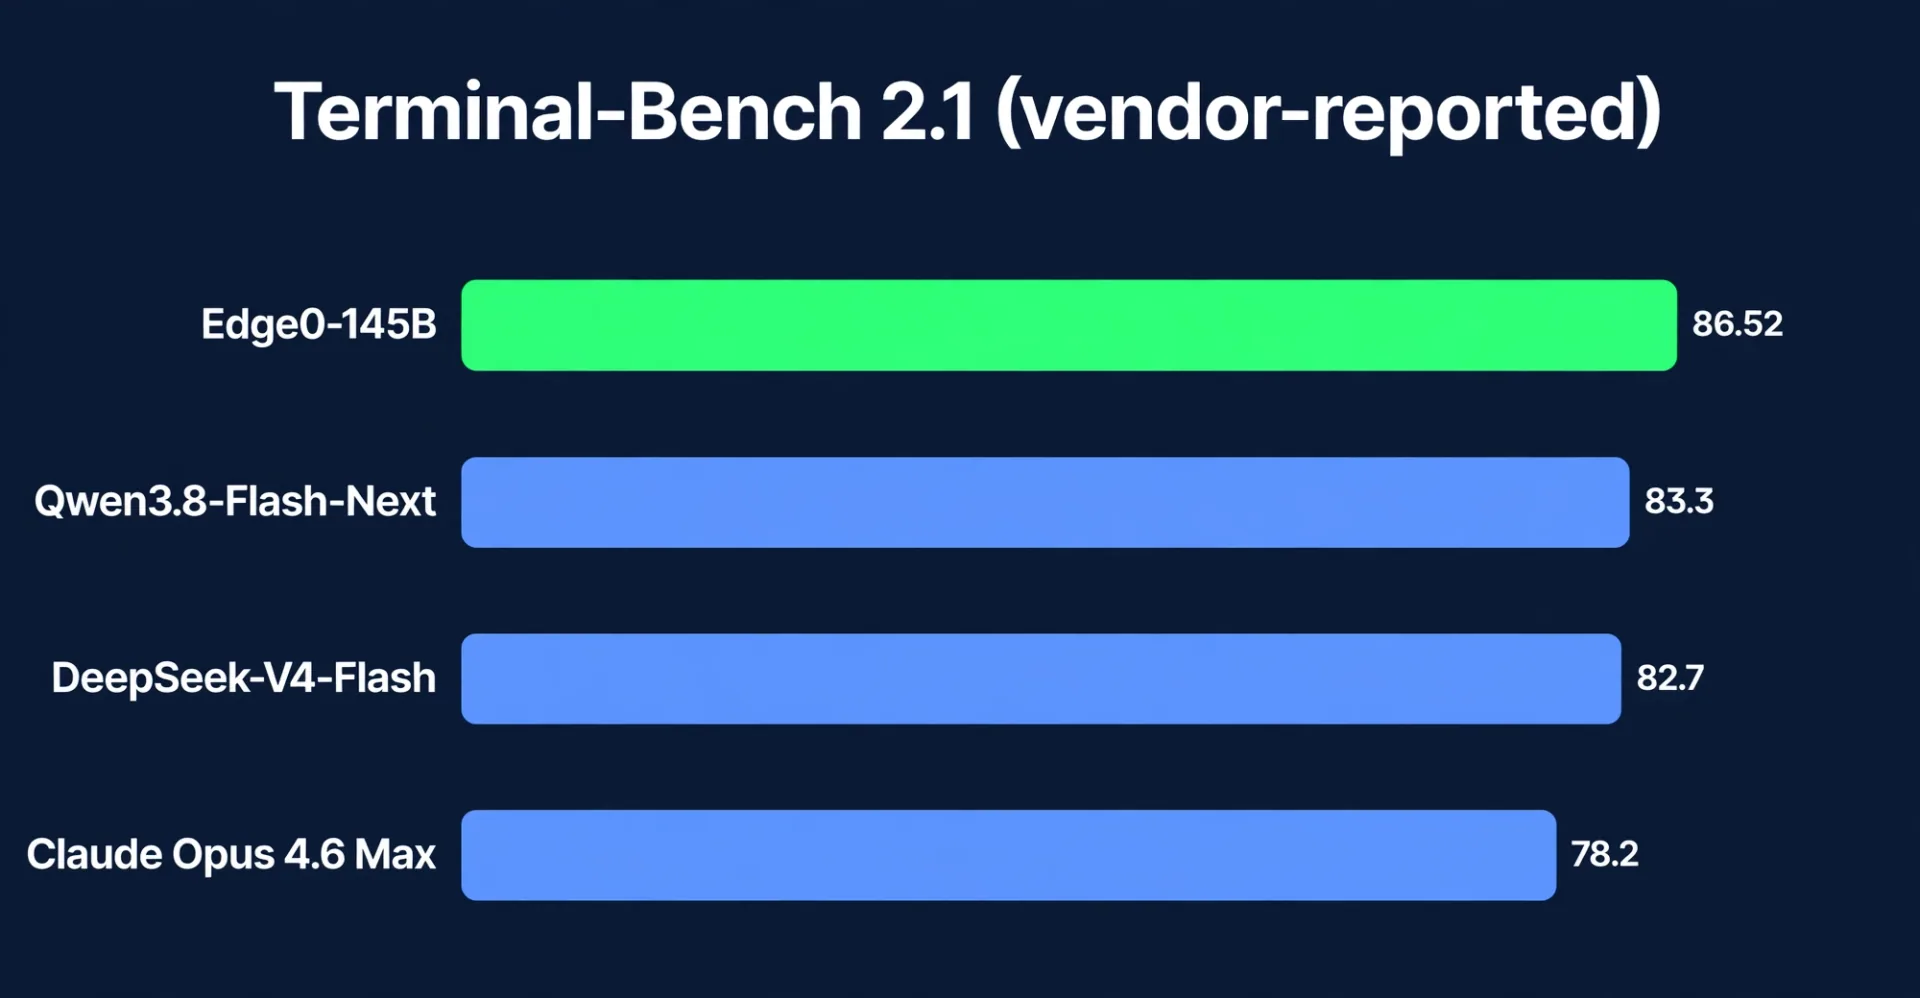
Le résultat du Terminal-Bench 2.1 attire l’œil : 86,52 contre 78,2 pour Claude Opus 4.6 dans sa configuration Max. Mais remarquez la colonne GPQA-Diamond, où Edge0 est derrière DeepSeek-V4-Flash et Claude Opus 4.6. Aucun benchmark unique ne décide d’un modèle, et les « gagnants » du cross-benchmark n’existent pas. Testez-le sur vos propres tâches.
Combien cela coûte
| Option | Prix |
|---|---|
| Poids Edge0-145B | Téléchargement gratuit |
| Cadre d’inférence Edge0 | Apache 2.0, gratuit |
| Votre coût | Un GPU, de l’électricité, et votre temps |
| API hydrogène Gemini 4 | 1,50 $ par 1M de jetons d’entrée |
| API Claude Fable 5.2 | 8 $ par 1M d’entrée, 40 $ par 1M de jetons de sortie |
Il n’y a pas de facture par token avec Edge0-145B. L’échange est différent : vous payez en matériel et en temps de configuration au lieu de frais API, et vos données restent sur votre propre machine. Pour les équipes qui développent l’automatisation sur leur propre matériel, cet échange est tout l’intérêt. Si vous voulez voir comment la tarification cloud se compare, notre analyse Gemini 4 Hydrogen couvre le modèle de 1,50 $ par token 1M de Google, et l’histoire de l’introduction en bourse d’Anthropic montre à quel point les investisseurs valorisent désormais l’entreprise derrière Claude.
Les attrapés
Trois choses à savoir avant de télécharger.
Le chiffre des 29 Go nécessite un contexte. Edge0 indique que le modèle fonctionne avec 29 Go de mémoire de crête sur un ordinateur portable, mais la carte modèle Hugging Face mesure environ 61,5 Go au total pour la version NVFP4 : 23,25 Go de mémoire vidéo plus 38,27 Gio de RAM système. Le chiffre de 29 Go concerne uniquement la mémoire GPU. Assurez-vous que votre machine dispose de la RAM correspondante.
Il est open-weight, pas open source. Les weights sont sous la licence Edge0 Community Model License 1.0, qui réserve certains usages, comme la vente, la location ou la licence des weights et la gestion d’un service modèle, à une licence écrite distincte. Le code du framework d’inférence est Apache 2.0, mais les weights ne le sont pas. Lisez la licence avant de construire un produit commercial dessus.
Il est construit sur Qwen. Les métadonnées de Hugging Face nomment Qwen3.8-Flash-Next d’Alibaba comme modèle de base, et la version est une dérivation de ce modèle. Le blog d’Edge0 ne nomme pas Qwen. Cela importe si vos règles de conformité tiennent compte de la lignée des modèles.
Lequel choisir
Choisissez Edge0-145B si vous avez un GPU de 24 Go ou un ordinateur Apple Silicon puissant, vous voulez que vos données restent locales, et vous exécutez des agents ou des charges de travail de codage là où une facture cloud par jeton serait préjudiciable. Récupérez la version NVFP4 ou Q3_K, exécutez vos flux de travail réels, et comparez avec votre stack actuel la qualité, la latence et le coût en électricité.
Restez avec un modèle cloud si vous avez besoin d’une API gérée, d’une disponibilité garantie ou d’un modèle avec une vérification indépendante des benchmarks. Le rapport technique pour Edge0-145B est toujours en attente, et aucun laboratoire indépendant n’a encore reproduit les scores principaux.
Attendez et observez si vous hésitez entre Edge0-145B et son frère. Edge0-120B est plus petit et moins cher à exploiter, et la première vague de tests indépendants nous dira lequel tient la route. Pour une analyse plus large de la décision build-versus-acheter, voir IA personnalisée vs IA prête à l’emploi : 76 % Acheter d’abord.
FAQ
Edge0-145B est-il vraiment gratuit ?
Les poids sont téléchargeables gratuitement depuis Hugging Face, et le cadre d’inférence est Apache 2.0. Vous payez toujours pour le GPU, l’électricité et le temps de configuration, et certains usages commerciaux nécessitent une licence séparée sous la licence Edge0 Community Model License 1.0.
L’Edge0-145B peut-il fonctionner sur un ordinateur portable ?
Edge0 dit oui : sur un MacBook Pro, il rapporte plus de 80 jetons par seconde de décodage avec 29 Go de mémoire GPU de pic. L’empreinte totale mesurée est d’environ 61,5 Gio en RAM système, donc un ordinateur portable bien équipé est nécessaire.
Quelle est la vitesse de l’Edge0-145B sur une RTX 5090 ?
Edge0 rapporte un décodage de 121,2 jetons par seconde avec la version Q3_K et 98,3 jetons par seconde avec la version NVFP4, deux chiffres rapportés par le fournisseur issus des propres tests de la société.
Est-ce que l’Edge0-145B est meilleur que Claude Opus 4.6 ?
Sur Terminal-Bench 2.1, Edge0 affiche 86,52 contre 78,2 pour Claude Opus 4.6 Max. Sur GPQA-Diamond, Claude mène 91,3 à 90,4. Les scores sont rapportés par les fournisseurs et aucune vérification indépendante n’existe encore, il n’y a donc pas de gagnant défini.
Où puis-je télécharger Edge0-145B ?
Les poids sont sur Hugging Face sous Edge0/Edge0-145B-q3k et Edge0-145B-NVFP4, et le cadre d’inférence ainsi que les outils de déploiement sont sur GitHub sous Edge0-AI/Edge0.
Quelle est la différence entre Edge0-145B et Edge0-120B ?
L’Edge0-145B a 145 milliards de paramètres totaux avec 10,12 milliards actifs par jeton ; l’Edge0-120B en a 120 milliards au total avec 8,64 milliards actifs. Les deux ont été lancés le 12 novembre 2026, et le modèle 120B est l’option plus légère et moins coûteuse à utiliser.
- Edge0-145B
- open source AI
- local AI
- RTX 5090
- AI benchmarks