Actualités IA7 min de lecturePar JH Akash
Muse Ember : le score de 36 de Haiku à un tiers du prix
Muse Ember de Meta égale Claude Haiku 5.5 à 36 sur l’Indice d’Analyse Artificielle pour environ un tiers du coût par tâche. Voici les références, le prix et le piège.
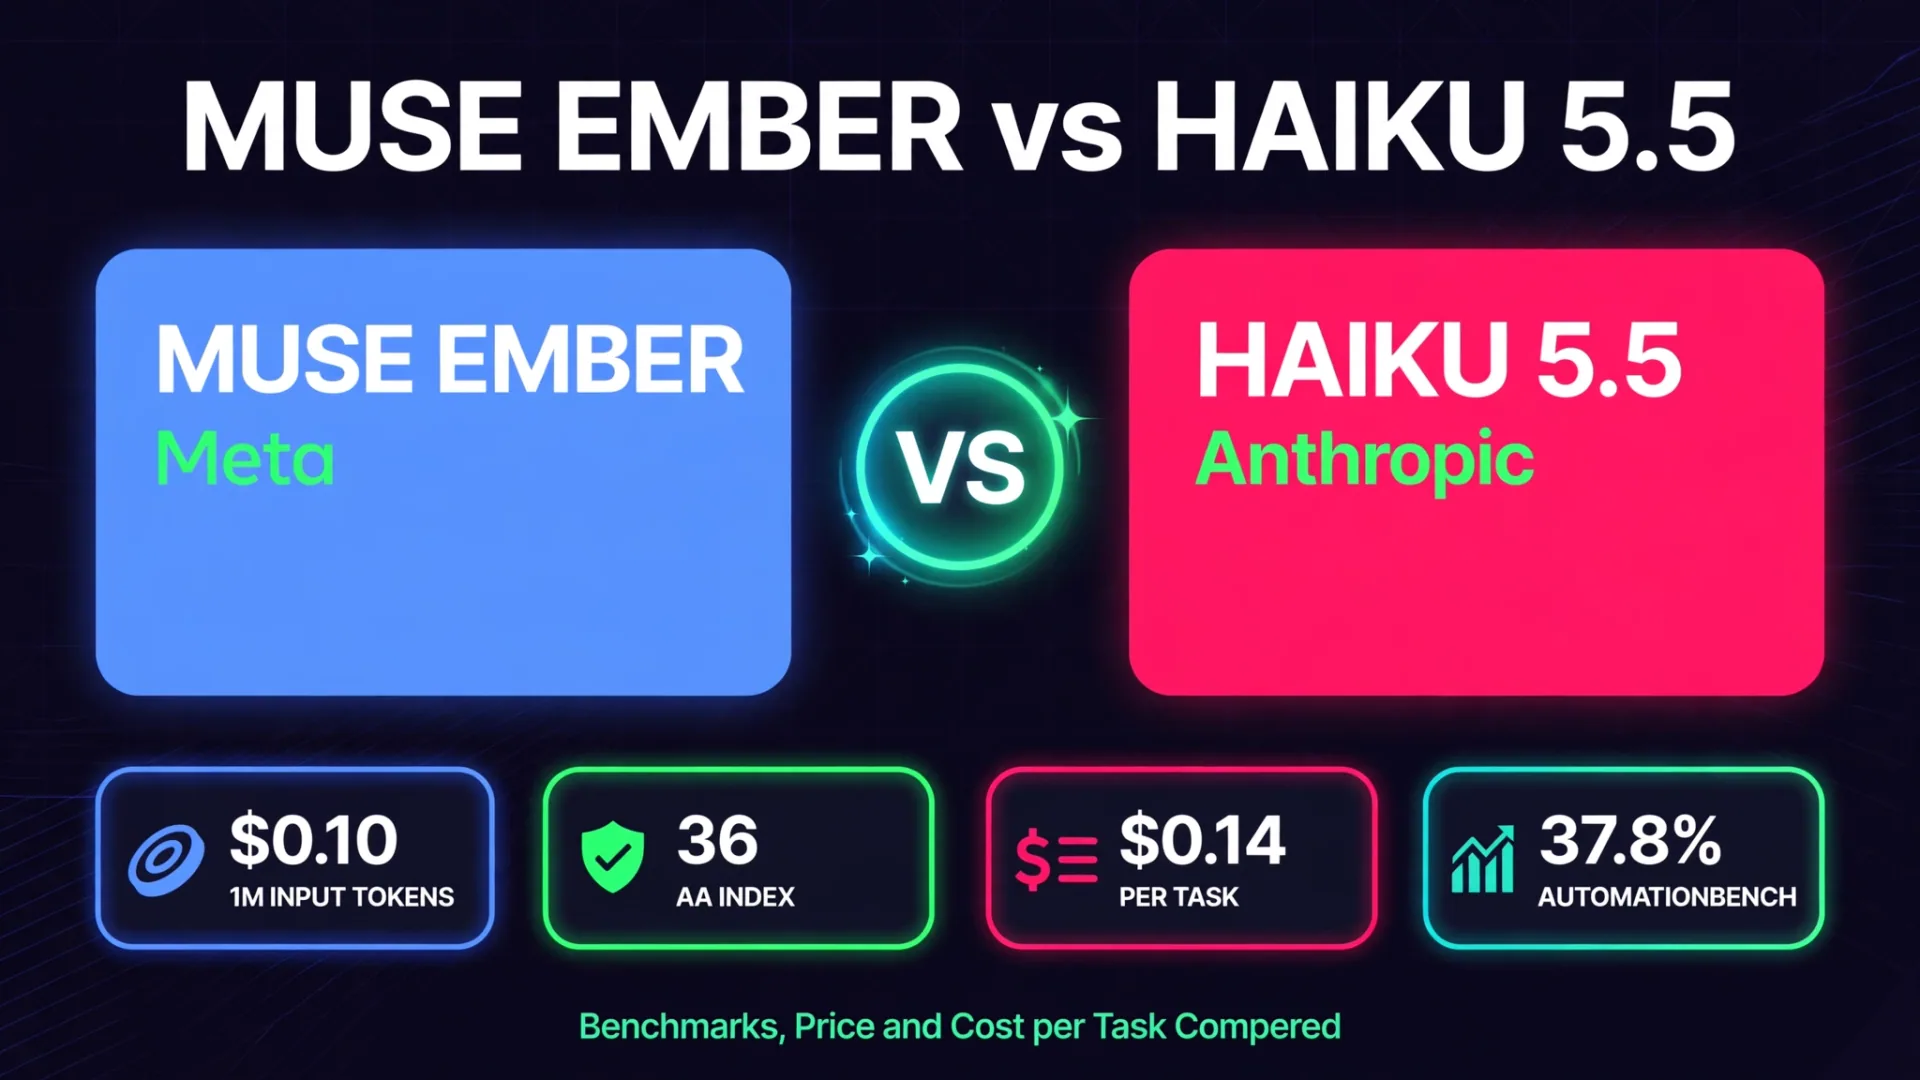
Meta a lancé Muse Ember le 9 novembre 2026, et le chiffre principal est difficile à ignorer : il égale Claude Haiku 5.5 à la 36e place de l’Indice d’Intelligence Analytique Artificielle, tout en coûtant environ un tiers par tâche. Ember est le modèle Muse le plus petit et le moins cher de Meta, conçu pour le travail répétitif que les agents IA accomplissent toute la journée : appels d’outils, sous-tâches de codage, routage, extraction et analyse de documents longs.
Le hic réside dans les petits caractères. Les prix des jetons sont identiques à ceux de Haiku 5.5 et GPT-6 Luna. Ember gagne sur le coût par tâche car il utilise beaucoup moins de jetons de sortie pour atteindre le même score. Et sur un benchmark, celui qui se rapproche le plus d’un code réel fusionnable, Haiku gagne tout de même clairement. Cet article compare les trois modèles en termes de prix, de benchmarks et de charges de travail pour lesquelles chacun est réellement conçu.
Verdict rapide
| Modèle | Indice de renseignement AA | Coût par tâche | Le meilleur pour |
|---|---|---|---|
| Muse Ember | 36 | $0.136 | Travail d’agent à fort volume, flux de travail professionnels |
| Claude Haiku 5.5 | 36 | $0.411 | Code fusionnable, travail de bureau |
| GPT-6 Luna | 28 | $0.152 | Tâches générales bon marché, coût par tâche le plus bas après Ember |
Tous les scores sont à l’effort de raisonnement maximal, selon Meta à partir des données d’Analyse Artificielle datées du 9 novembre 2026. Les benchmarks publiés par un fournisseur sont rapportés par le fournisseur jusqu’à ce qu’ils soient testés indépendamment.
Qu’est-ce que Muse Ember est
Ember est le quatrième modèle de la famille Muse de Meta. Muse Spark est arrivée en avril 2026 en tant que modèle de poids intermédiaire, Glimmer a suivi en août comme bicylindre openweight, et le modèle frontière Muse Wonder a été lancé en octobre. Ember est le plus petit, et Meta le considère comme le modèle le plus efficace de la famille.
C’est un modèle multimodal : il prend texte, images, audio et vidéo en un seul appel, permettant à un agent de lire des captures d’écran, des graphiques, des documents scannés, des notes vocales et des vidéos sans modèle séparé. La fenêtre de contexte est de 1 048 576 jetons (1M), avec jusqu’à 524 288 jetons de sortie (512K) par requête. Cela suffit à alimenter une base de code complète ou un grand document en un seul appel.
Il est disponible désormais en muse-ember-1.0 sur l’API Meta Model et dans Muse Code, ainsi que sur Google Cloud et Oracle Cloud. Les poids sont fermés, donc il s’agit d’un modèle uniquement API, pas d’un téléchargement ouvert. Meta précise également qu’Ember est le premier modèle entraîné avec Muse Wonder Full, son modèle frontière, et que même des modèles moins chers sont déjà en formation. Le même jour, Meta a également mis Muse sur Apple Watch et Wear OS.
Prix : même prix d’affiche, facture très différente
Voici la partie que la plupart des gros titres se trompent. Les prix par jeton d’Ember sont exactement les mêmes que ceux de Haiku 5.5 et GPT-6 Luna. Les économies viennent de l’efficacité, pas d’une grille de taux moins chère.
| Prix par 1M de jetons | Jusqu’à 200K jetons | Au-dessus de 200 000 jetons |
|---|---|---|
| Entrée | $0.10 | $0.30 |
| Entrée mise en cache | $0.004 | $0.012 |
| Production | $0.50 | $1.50 |
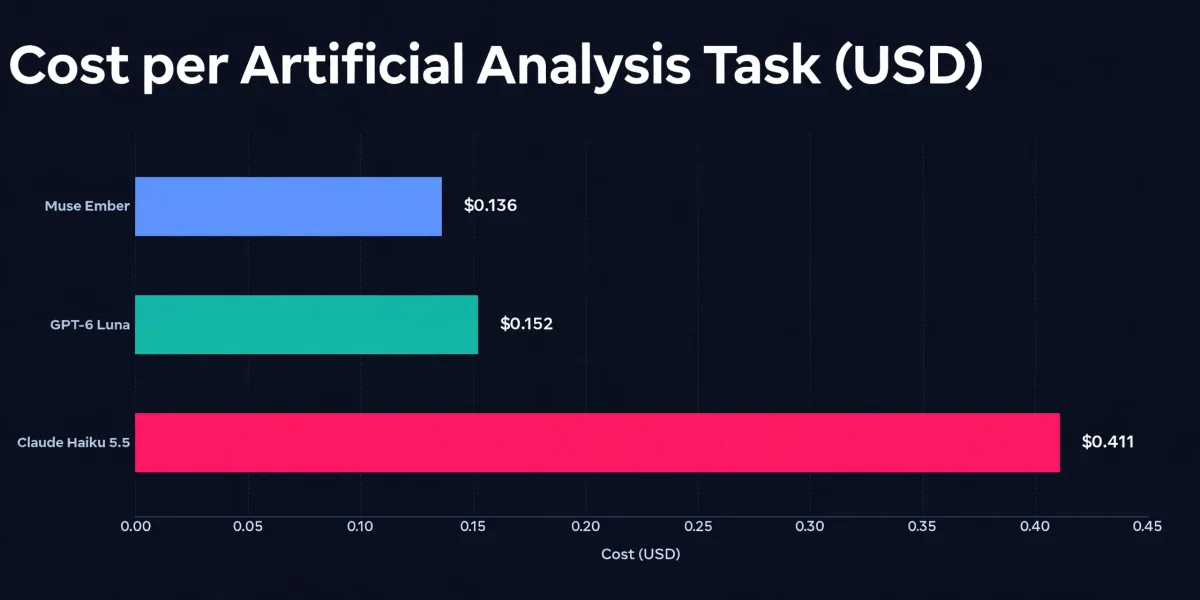
Le niveau supérieur s’applique à l’ensemble de la requête une fois qu’elle dépasse les 200 000 jetons, donc les appels en contexte long coûtent trois fois plus cher par jeton. Le chiffre réel à surveiller est le coût par tâche terminée. Sur les benchmarks d’Analyse Artificielle, Ember rapporte en moyenne environ 0,14 $ par tâche, Haiku 5,5 environ 0,41 $, et GPT-6 Luna environ 0,15 $. Ember atteint le même score que Haiku en utilisant environ un tiers des jetons de sortie, et c’est là que la facture diminue.
Pour l’échelle, le modèle plus grand de Meta, Muse Spark 1.3, obtient un score de 37 sur le même indice, un point au-dessus d’Ember, mais coûte 2,39 $ par tâche, soit environ 17 fois plus cher qu’Ember. L’échange est clair : un point d’indice supplémentaire pour 17 fois le coût de la tâche.
Références : où Ember gagne, et où elle perd
Meta a publié dix comparaisons directes avec un effort de raisonnement maximal. Le plus grand écart concerne les workflows métier, le plus faible sur le code fusionnable.
| Référence | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Indice d’analyse artificielle | 36 | 36 | 28 |
| Coût par tâche AA | $0.136 | $0.411 | $0.152 |
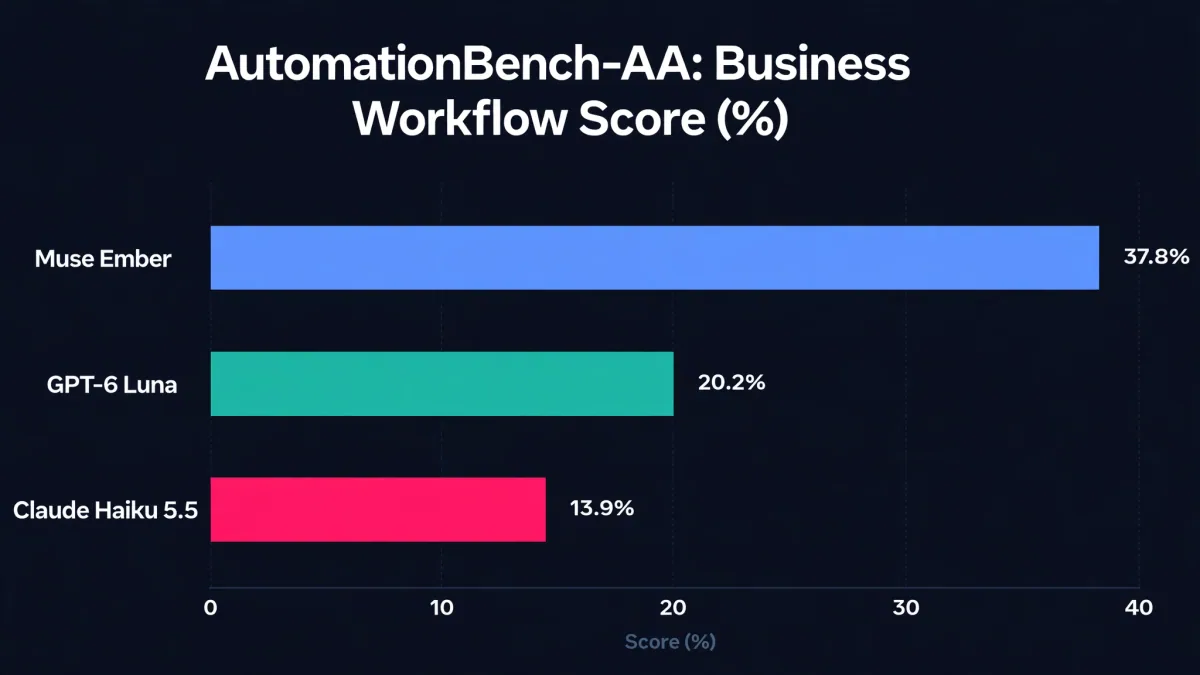
| AutomationBench-AA (flux de travail métier) | 37.8% | 13.9% | 20.2% |
| Dernier examen des agents | 61.6% | 57.0% | 57.1% |
| Terminal-Bench 4.0 (codage agentique) | 40.9% | 39.2% | 16.4% |
| Index d’agent de codage - AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA (code fusionnable) | 27.2% | 34.9% | 25.2% |
| OSWorld 2.1 (utilisation informatique, binaire) | 33.8% | 27.8% | 17.0% |
| GDP.pdf-AA (documents longs) | 22.8% | 20.8% | 22.8% |
| PerceptionBench (visuel, avec outils) | 80.6% | 78.6% | 62.8% |
Lisez le tableau avec attention. Le résultat marquant d’Ember est AutomationBench-AA, qui exécute 657 flux de travail réels pour les entreprises : 37,8 % contre 13,9 % pour Haiku, presque trois fois plus. Il est également en tête pour le codage agent dans Terminal-Bench et sur l’Index d’agents codeurs, qui mesure le modèle à l’intérieur de son véritable harnais de codage.
Mais FrontierCode 2.0-AA, le test le plus proche du code que l’on peut fusionner sans modifications, va dans l’autre sens : Haiku 5.5 obtient 34,9 % contre 27,2 % pour Ember. Et sur l’indice principal lui-même, l’égalité est arrondie : non arrondi, Haiku est à 36,2 et Ember à 35,8. Même score sur le graphique, un petit écart réel en dessous. Meta a également effectué quatre des dix comparaisons elle-même et qualifie les courses concurrentes de meilleures performances, donc considérez les chiffres comme rapportés par les fournisseurs.
Quel modèle choisir
Choisissez Muse Ember si vous exécutez des agents en volume : triage de support, extraction de documents, routage, appels d’outils et sous-tâches de codage répétées. La fenêtre contextuelle de 1M et le coût de 0,14 $ par tâche en font la méthode la moins chère pour exécuter de l’intelligence au niveau Haiku toute la journée. Regardez le palier 200K de tokens, où les prix triplent.
Choisissez Claude Haiku 5.5 si votre agent écrit du code qui doit être fusionné proprement, ou si vous avez besoin d’un accord et d’un écosystème de traitement des données établis. Cela coûte environ trois fois plus cher par tâche pour le même score d’indice, mais il remporte largement le benchmark du code fusionnable.
Choisissez GPT-6 Luna si vous souhaitez l’option économique la plus faible et risquée dans l’écosystème OpenAI. Il est derrière ses deux concurrents sur l’indice à 28, mais son coût par tâche est presque aussi bas que celui d’Ember, et il égale Ember sur les travaux longs documentaires.
Pour les équipes qui développent des agents, la solution pratique est de diviser : Ember pour les étapes répétitives à haut volume, et un modèle plus solide pour le code final ou la décision qui doit être correcte. C’est exactement la charge de travail pour laquelle Ember a été conçu. Si vous prévoyez ce type de configuration, notre guide des services de développement d’agents IA détaille le coût de la construction d’un système d’agents, et vous pouvez aussi engager une agence d’automatisation IA pour le construire pour vous.
Anthropic n’est pas non plus immobile. Son nouveau modèle frontière Claude Fable 5.2 a pris la première place sur le même indice à 65, et le modèle phare d’OpenAI, GPT-6 Astra, est le modèle auquel les grands frères et sœurs d’Ember sont mesurés. La course des petits modèles repose désormais sur le coût par tâche terminée, et non sur le coût par jeton, et Ember vient de fixer ce chiffre à battre : 0,14 $.
FAQ
Qu’est-ce que Meta Muse Ember ?
Muse Ember est le modèle d’IA le plus petit et le plus efficace de Meta, lancé le 9 novembre 2026. Il est conçu pour le travail répétitif que les agents IA accomplissent toute la journée : appels d’outils, sous-tâches de codage, routage, extraction et analyse de documents longs. Il est disponible sous forme muse-ember-1.0 sur l’API Meta Model et le code Muse.
Combien coûte Muse Ember ?
Muse Ember coûte 0,10 $ par million de jetons d’entrée et 0,50 $ par million de tokens de sortie pour des prompts jusqu’à 200 000 tokens, avec une entrée en cache à 0,004 $. Au-delà de 200 000 jetons, les taux montent à 0,30 $ en entrée, 0,012 $ en cache et 1,50 $ en sortie. Sur les benchmarks d’analyse artificielle, il est en moyenne d’environ 0,14 $ par tâche.
Muse Ember est-il meilleur que Claude Haiku 5.5 ?
Sur l’Indice d’Intelligence d’Analyse Artificielle, les deux obtiennent 36 au raisonnement maximal, et Ember coûte environ un tiers par tâche. Ember gagne également largement sur les flux de travail métier (37,8 % contre 13,9 % sur AutomationBench-AA). Haiku 5.5 est plus performant sur le code fusionnable, avec un score de 34,9 % contre 27,2 % pour Ember sur FrontierCode 2.0-AA.
Muse Ember est-il open source ?
Non. Meta n’a pas publié les pondérations. Muse Ember est un modèle uniquement API, disponible via Meta Model API, Muse Code, Google Cloud et Oracle Cloud.
Quelle est la fenêtre contextuelle de Muse Ember ?
Muse Ember dispose d’une fenêtre contextuelle de 1 048 576 jetons (1M) et supporte jusqu’à 524 288 jetons de sortie (512K) par requête. Il accepte le texte, les images, l’audio et la vidéo en entrée.
Sources : Meta AI Research, « Présentation de notre plus petit modèle le plus efficace : Muse Ember », 9 novembre 2026 ; Indice d’intelligence d’analyse artificielle v5, 9 novembre 2026. Les chiffres de référence sont tels que publiés par Meta et rapportés par les fournisseurs.
- Muse Ember
- Meta Muse
- Claude Haiku 5.5
- GPT-6 Luna
- AI benchmarks