KI-News6 Min. LesezeitVon JH Akash
Muse Ember: Haikus 36 punkten zu einem Drittel des Preises
Metas Muse Ember entspricht Claude Haiku 5.5 mit Platz 36 im Artificial Analysis Index für etwa ein Drittel der Kosten pro Aufgabe. Hier sind die Benchmarks, der Preis und der Haken.
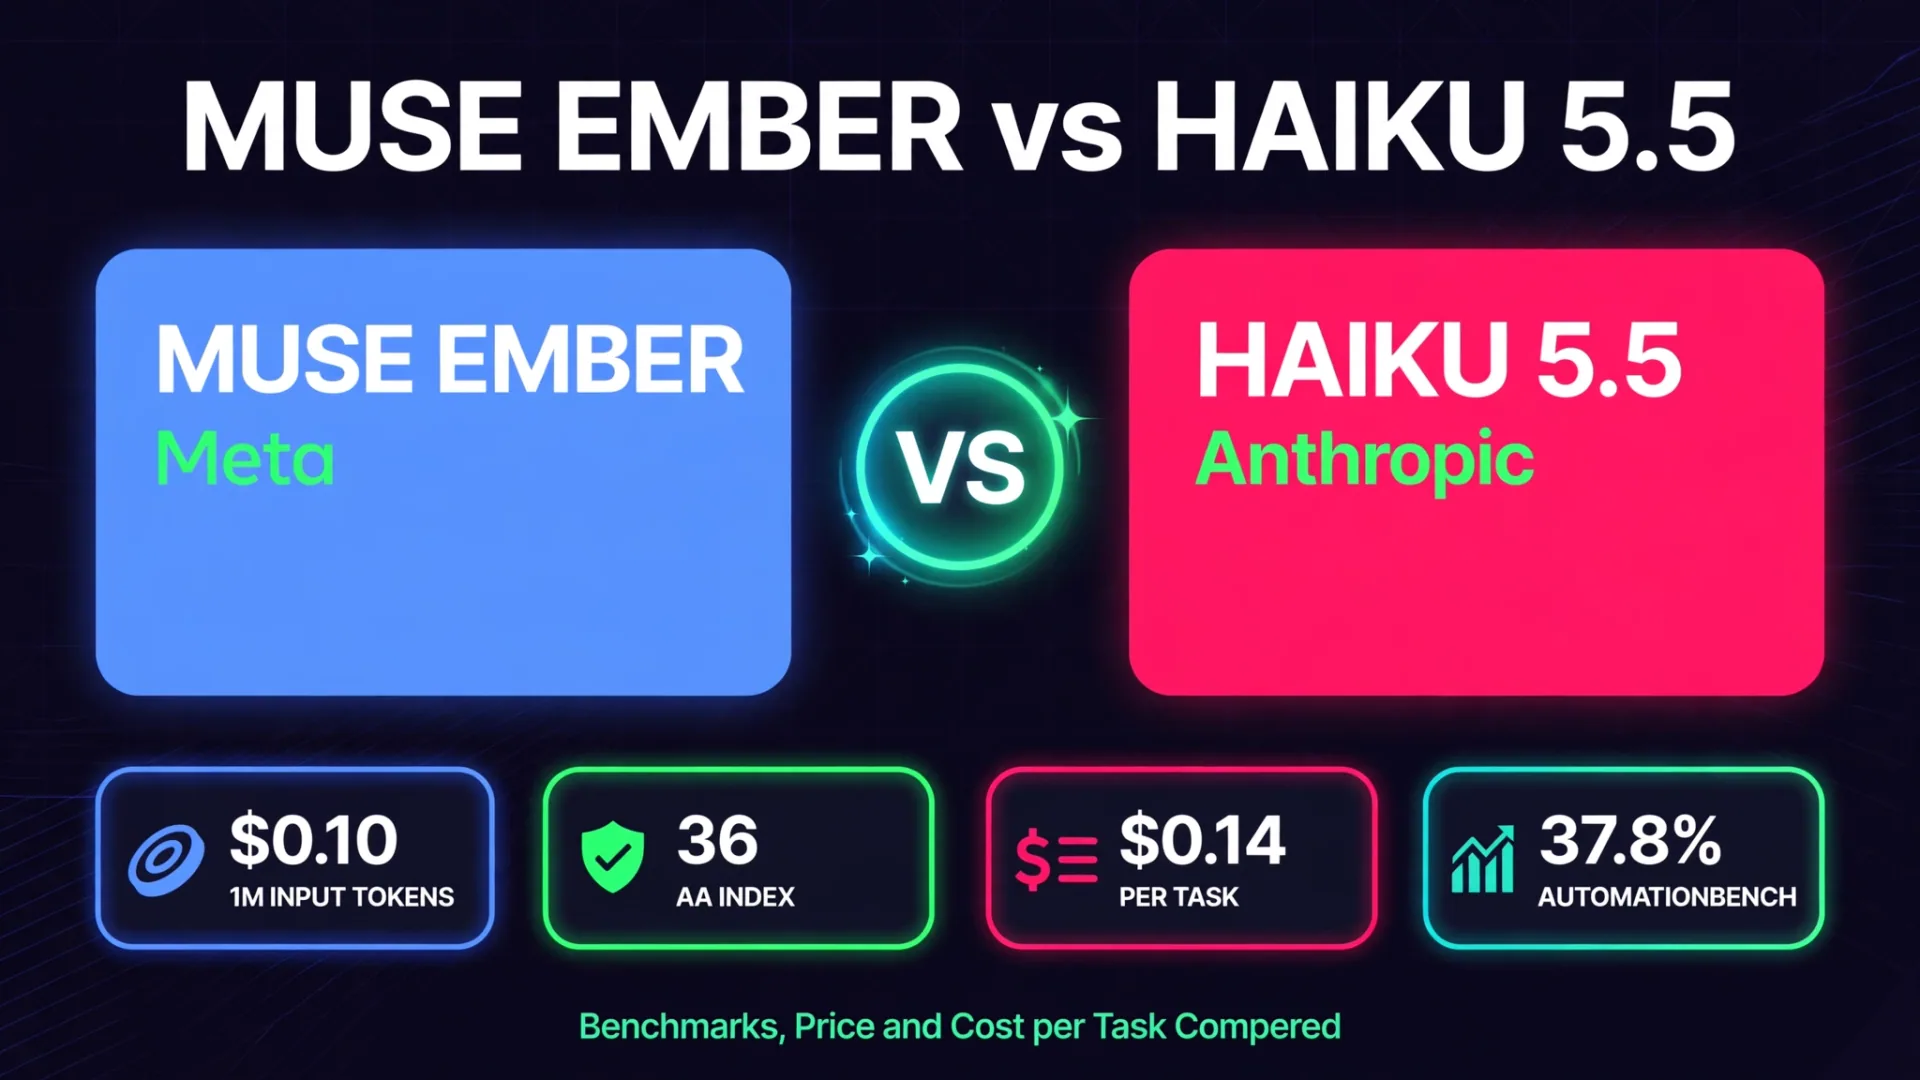
Meta hat Muse Ember am 9. November 2026 gestartet, und die Schlagzeilenzahl ist kaum zu übersehen: Es entspricht Claude Haiku 5.5 mit Platz 36 im Artificial Analysis Intelligence Index, kostet aber etwa ein Drittel pro Aufgabe. Ember ist Metas kleinstes und günstigstes Muse-Modell, entwickelt für die sich wiederholenden Aufgaben, die KI-Agenten den ganzen Tag erledigen: Werkzeugaufrufe, Kodierung von Teilaufgaben, Routing, Extraktion und Langdokument-Parsing.
Der Haken liegt im Kleingedruckten. Die Tokenpreise sind identisch mit denen von Haiku 5.5 und GPT-6 Luna. Ember gewinnt bei den Kosten pro Aufgabe, weil es deutlich weniger Ausgabetoken verwendet, um denselben Wert zu erreichen. Und bei einem Benchmark, dem der echten Mergeable-Code am nächsten kommt, gewinnt Haiku immer noch klar. Dieser Beitrag vergleicht alle drei Modelle hinsichtlich Preis, Benchmarks und der Workloads, für die jedes tatsächlich entwickelt wurde.
Kurzes Urteil
| Modell | AA Intelligenzindex | Kosten pro Aufgabe | Am besten für |
|---|---|---|---|
| Muse Ember | 36 | $0.136 | Arbeiten mit hohem Aufwand bei Agenten, Geschäftsabläufe |
| Claude Haiku 5.5 | 36 | $0.411 | Zusammenführender Code, Büroarbeit |
| GPT-6 Luna | 28 | $0.152 | Günstige allgemeine Aufgaben, die niedrigsten Aufgabenkosten nach Ember |
Alle Werte liegen auf maximalem Schlusskraft, wie von Meta aus Daten von Artificial Analysis vom 9. November 2026 berichtet. Von einem Anbieter veröffentlichte Benchmarks werden vom Anbieter berichtet, bis sie unabhängig erneut getestet werden.
Was Muse Ember ist
Ember ist das vierte Modell in Metas Muse-Familie. Muse Spark kam im April 2026 als mittelschweres Modell auf den Markt, Glimmer folgte im August als offenes Doppelmodell, und das Frontier-Modell Muse Wonder wurde im Oktober eingeführt. Ember ist das kleine, und Meta bezeichnet es als das effizienteste Modell der Familie.
Es handelt sich um ein multimodales Modell: Es nimmt Text, Bilder, Audio und Video in einem einzigen Anruf auf, sodass ein Agent Screenshots, Diagramme, gescannte Dokumente, Sprachmemos und Videos ohne separates Modell lesen kann. Das Kontextfenster umfasst 1.048.576 Token (1M), mit bis zu 524.288 Ausgabetoken (512K) pro Anfrage. Das reicht aus, um einen ganzen Codebase oder ein großes Dokumentenset in einen Anruf zusammenzuführen.
Es ist jetzt als muse-ember-1.0 auf der Meta Model API und in Muse Code sowie auf Google Cloud und Oracle Cloud verfügbar. Die Gewichte sind geschlossen, daher handelt es sich um ein API-reines Modell und nicht um einen offenen Download. Meta sagt außerdem, dass Ember das erste Modell ist, das mit Muse Wonder Full, seinem Frontier-Modell, trainiert wurde, und dass sogar günstigere Modelle bereits in Ausbildung sind. Am selben Tag brachte Meta Muse auch auf die Apple Watch und das Wear-Betriebssystem.
Preis: derselbe Preis, aber eine ganz andere Rechnung
Hier ist der Teil, den die meisten Schlagzeilen falsch verstehen. Die Preise pro Token bei Ember sind genau die gleichen wie bei Haiku 5.5 und GPT-6 Luna. Die Einsparungen kommen durch Effizienz, nicht durch eine günstigere Zinskarte.
| Preis pro 1-Million-Token | Bis zu 200.000 Token | Token über 200.000 |
|---|---|---|
| Eingabe | $0.10 | $0.30 |
| Zwischengespeicherte Eingabe | $0.004 | $0.012 |
| Ausgabe | $0.50 | $1.50 |
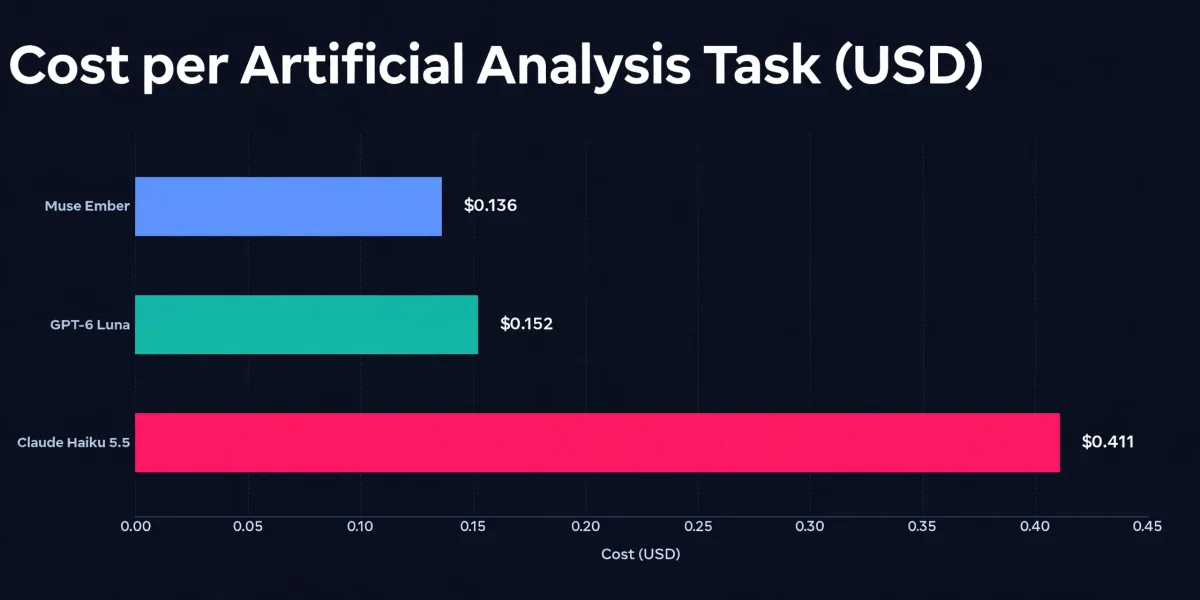
Die höhere Stufe gilt für die gesamte Anfrage, sobald sie 200.000 Token überschreitet, sodass Long-Context-Calls dreimal so viel pro Token kosten. Die eigentliche Zahl, auf die man achten sollte, ist die Kosten pro abgeschlossener Aufgabe. In Artificial Analysis-Benchmarks liegt Ember im Durchschnitt bei etwa 0,14 $ pro Aufgabe, Haiku 5,5 bei etwa 0,41 $ und GPT-6 Luna bei etwa 0,15 $. Ember erreicht denselben Wert wie Haiku, während er etwa ein Drittel der Ausgabetoken verwendet, und dort schrumpft die Rechnung.
Was die Skalierung angeht, erzielt Metas eigenes größeres Modell Muse Spark 1.3 37 im selben Index, einen Punkt über Ember, kostet aber 2,39 Dollar pro Aufgabe, etwa 17-mal mehr als Ember. Der Trade ist klar: ein zusätzlicher Indexpunkt für 17-mal die Aufgabenkosten.
Benchmarks: Wo Ember gewinnt und wo es verliert
Meta veröffentlichte zehn direkte Vergleiche mit maximalem Denkaufwand. Die größte Lücke liegt bei den Geschäfts-Workflows, die kleinste bei Mergeable-Code.
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Künstlicher Analyse-Index | 36 | 36 | 28 |
| Kosten pro AA-Aufgabe | $0.136 | $0.411 | $0.152 |
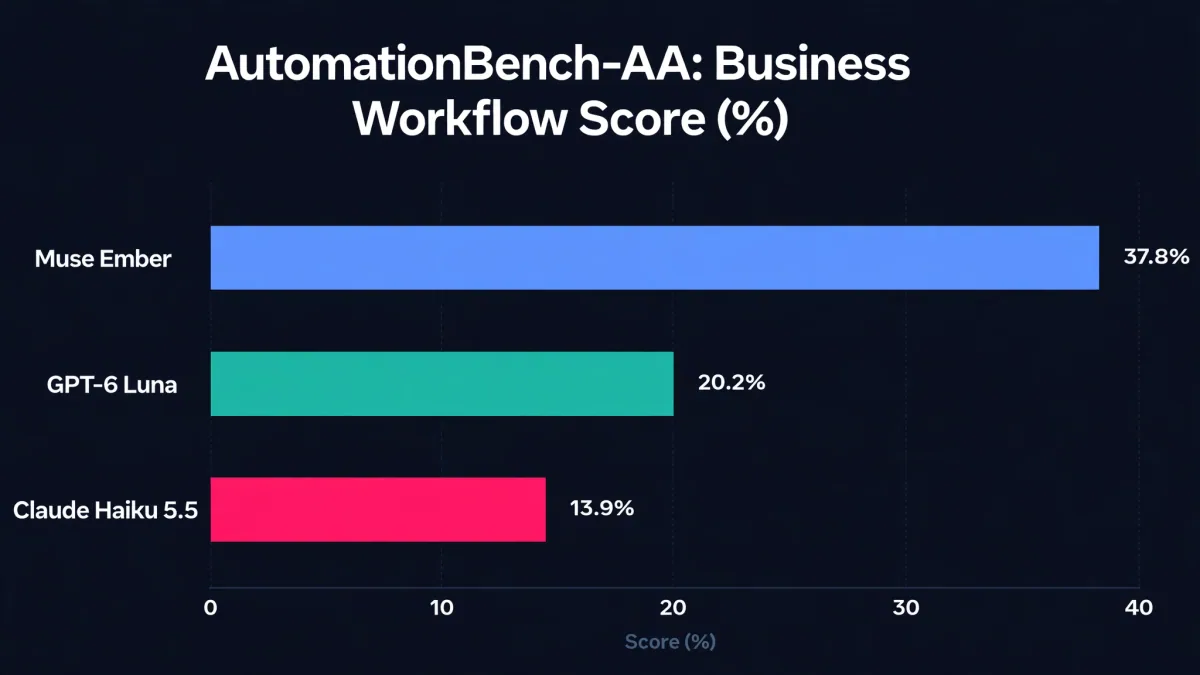
| AutomationBench-AA (Geschäfts-Workflows) | 37.8% | 13.9% | 20.2% |
| Die letzte Prüfung der Agenten | 61.6% | 57.0% | 57.1% |
| Terminal-Bench 4.0 (agentische Codierung) | 40.9% | 39.2% | 16.4% |
| Codierungsagent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA (zusammenführender Code) | 27.2% | 34.9% | 25.2% |
| OSWorld 2.1 (Computernutzung, Binär) | 33.8% | 27.8% | 17.0% |
| GDP.pdf-AA (lange Dokumente) | 22.8% | 20.8% | 22.8% |
| PerceptionBench (visuell, mit Tools) | 80.6% | 78.6% | 62.8% |
Lesen Sie die Tabelle sorgfältig. Embers herausragendes Ergebnis ist AutomationBench-AA, das 657 reale Geschäfts-Workflows ausführt: 37,8 % gegenüber Haikus 13,9 %, fast dreimal so viel. Es führt außerdem bei der agentischen Codierung in Terminal-Bench und beim Coding Agent Index, der das Modell innerhalb seines realen Coding-Harnesss misst.
Aber FrontierCode 2.0-AA, der Test, der dem Code am nächsten kommt, den man ohne Änderungen zusammenführen kann, läuft in die andere Richtung: Haiku 5,5 erreicht 34,9 % gegenüber Embers 27,2 %. Und im Headline-Index selbst ist das Unentschieden abgerundet: Ungerundet liegt Haiku bei 36,2 und Ember bei 35,8. Gleiche Punktzahl im Diagramm, nur eine kleine reale Lücke darunter. Meta hat außerdem vier der zehn Vergleiche selbst durchgeführt und bezeichnet die Konkurrenzläufe als Best-Effort, also behandelt man die Zahlen wie vom Anbieter berichtet.
Welches Modell soll ich wählen
Wählen Sie Muse Ember, wenn Sie Agenten in großem Umfang ausführen: Unterstützung für Triage, Dokumentenextraktion, Routing, Toolaufrufe und wiederholte Coding-Teilaufgaben. Das 1-Millionen-Kontextfenster und die Kosten von 0,14 $ pro Aufgabe machen es zum günstigsten Weg, Haiku-Level-Intelligenz den ganzen Tag zu betreiben. Beobachten Sie die 200K-Token-Kategorie, wo sich die Preise verdreifacht.
Wählen Sie Claude Haiku 5.5, wenn Ihr Agent Code schreibt, der sauber zusammengeführt werden muss, oder wenn Sie eine etablierte Datenverarbeitungsvereinbarung und ein Ökosystem benötigen. Es kostet etwa dreimal so viel pro Aufgabe für denselben Indexwert, gewinnt aber den Mergeable-Code-Benchmark mit großem Vorsprung.
Wählen Sie GPT-6 Luna, wenn Sie die risikoärmste, günstige Option im OpenAI-Ökosystem wollen. Es liegt mit 28 Punkten hinter beiden Konkurrenten im Index, aber die Kosten pro Aufgabe sind fast so niedrig wie die von Ember und gleichziehen sich mit Ember in Sachen Langdokumentenarbeit.
Für Teams, die Agenten aufbauen, ist der praktische Schritt eine Aufteilung: Ember für die hochvolumigen, repetitiven Schritte und ein stärkeres Modell für den endgültigen Code oder die Entscheidung, die richtig sein muss. Genau für diese Arbeitsbelastung wurde Ember entwickelt. Wenn Sie eine solche Einrichtung planen, erklärt unser Leitfaden zu KI-Agentenentwicklungsdiensten , was ein Agentensystem für den Bau kostet, und Sie können auch eine KI-Automatisierungsagentur beauftragen , die es für Sie erstellt.
Auch Anthropic steht nicht still. Das neue Frontier-Modell Claude Fable 5.2 belegte im selben Index mit 65 Platz den ersten Platz, und OpenAI's Flaggschiff GPT-6 Astra ist das Modell, an dem Embers größere Geschwister gemessen werden. Das Rennen um kleine Modelle dreht sich jetzt um Kosten pro abgeschlossene Aufgabe, nicht um Kosten pro Token, und Ember hat gerade die Zahl gesetzt: 0,14 $.
FAQ
Was ist Meta Muse Ember?
Muse Ember ist Metas kleinstes und effizientestes KI-Modell, das am 9. November 2026 eingeführt wurde. Es ist für die sich ständig wiederholenden Aufgaben konzipiert, die KI-Agenten den ganzen Tag verrichten: Toolaufrufe, Kodierung von Unteraufgaben, Routing, Extraktion und Langdokument-Parsing. Es ist als muse-ember-1.0 auf der Meta Model API und im Muse Code verfügbar.
Wie viel kostet Muse Ember?
Muse Ember kostet 0,10 $ pro Million Eingabetoken und 0,50 $ pro Million Ausgabetoken für Prompts bis zu 200.000 Tokens, mit zwischengespeicherten Eingaben bei 0,004 $. Über 200.000 Token steigen die Preise auf 0,30 $ Eingabe, 0,012 $ gecacht und 1,50 $ Ausgabe. Bei Artificial Analysis-Benchmarks liegt es im Durchschnitt bei etwa 0,14 $ pro Aufgabe.
Ist Muse Ember besser als Claude Haiku 5.5?
Auf dem Artificial Analysis Intelligence Index erzielen beide bei maximalem Schließen 36 Punkte, und Ember kostet etwa ein Drittel davon pro Aufgabe. Ember erzielt auch große Leistungen bei Geschäftsworkflows (37,8 % gegenüber 13,9 % bei AutomationBench-AA). Haiku 5.5 ist bei Mergeable-Code stärker und erreicht 34,9 % gegenüber Embers 27,2 % bei FrontierCode 2.0-AA.
Ist Muse Ember Open Source?
Nein. Meta hat die Gewichte nicht veröffentlicht. Muse Ember ist ein API-reines Modell, das über die Meta Model API, Muse Code, Google Cloud und Oracle Cloud verfügbar ist.
Was ist das Kontextfenster von Muse Ember?
Muse Ember verfügt über ein Kontextfenster mit 1.048.576 Token (1M) und unterstützt bis zu 524.288 Ausgabetoken (512K) pro Anfrage. Es akzeptiert Text, Bilder, Audio und Video als Eingabe.
Quellen: Meta AI Research, "Einführung unseres kleinsten, effizientesten Modells: Muse Ember", 9. November 2026; Artificial Analysis Intelligence Index v5, 9. November 2026. Die Benchmark-Zahlen sind von Meta veröffentlicht und von Anbietern berichtet.
- Muse Ember
- Meta Muse
- Claude Haiku 5.5
- GPT-6 Luna
- AI benchmarks