ИИ7 мин чтенияАвтор JH Akash
Объяснение GDPx: Эталон, где лучший ИИ набирает всего 12%
SemiAnalysis опубликовал GDPx 2 ноября 2026 года: 206 реальных профессиональных задач в 11 областях, и лучший ИИ в мире показал всего 12,0%. Оценки, затраты и места неудачи моделей.
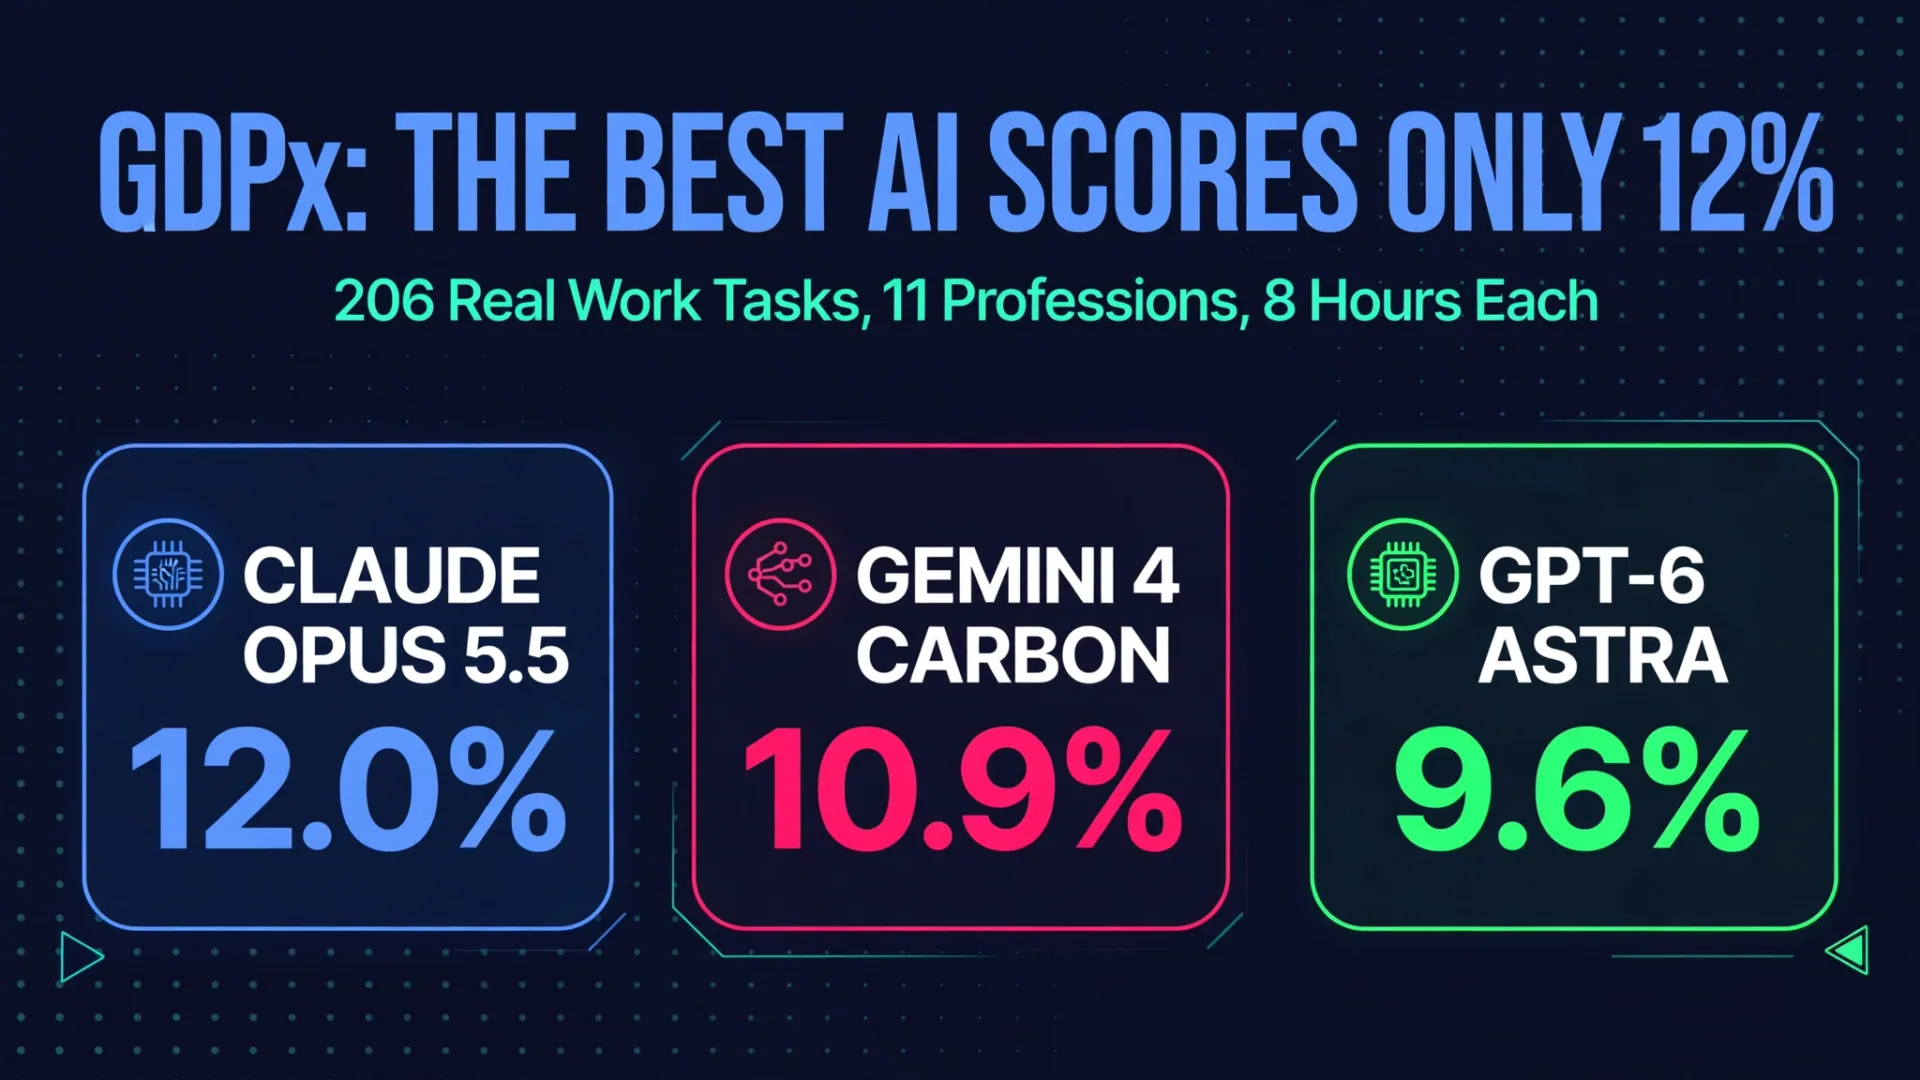
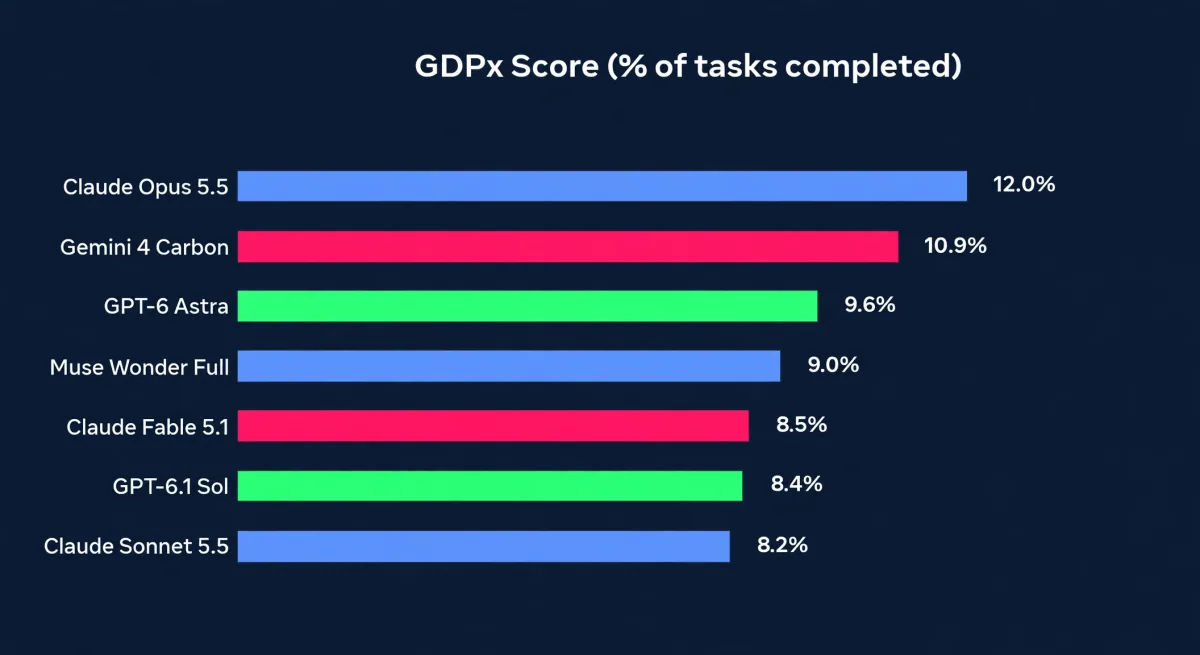
2 ноября 2026 года исследовательская компания SemiAnalysis опубликовала GDPx — новый эталон, который оценивает агентов ИИ так же, как это сделал бы работодатель: не по экзаменационным вопросам, а по реальной профессиональной работе. Заголовок трудно представить. Лучшая модель в мире, Claude Opus 5.5 от Anthropic, выполнила лишь 12,0% заданий. Gemini 4 Carbon от Google заняла второе место с 10,9%, а GPT-6 Astra от OpenAI — третье с 9,6%. Ни одна протестированная модель не набрала ни одной пятой части от общего числа.
Эти 12% — это не история о том, как модели становятся хуже. Это история о том, как тест становится честным. GDPx оставляет агента в симулированном рабочем месте, даёт ему до восьми часов на задачу и просит выполнить задание от начала до конца. Большинство бенчмарков оценивают ответы. GDPx оценивает задания, и работа, выполненная на 90%, но с неправильным результатом, нарушением правила или отсутствующим файлом, всё равно считается провалом.
Быстрый вердикт
| Модель | Оценка GDPx | Средняя стоимость задачи | Лучший в |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | Квантовый трейдинг, дизайн аппаратного обеспечения, дизайн чипов |
| Gemini 4 Carbon (Google) | 10.9% | $16.29 | Биология, программная инженерия (узко) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | Рекурсивное самосовершенствование, материаловедение |
| Muse Wonder Full (Мета) | 9.0% | Не опубликовано | Кибербезопасность — с явным отрывом |
Все оценки представлены SemiAnalysis из таблицы лидеров GDPx v1.0, опубликованной 2 ноября 2026 года. Ни одна из внешних лабораторий пока не воспроизводила их независимо, поэтому рассматривайте их как собственные данные издателя, а не проверенные факты.
Что на самом деле измеряет GDPx
GDPx содержит 206 задач в 11 профессиях, которые SemiAnalysis выбрал для их экономической отдачи от разведки на передовой, а не из-за доли ВВП: разработка чипов, аппаратное обеспечение, кибербезопасность, биология, финансы, юриспруденция, количественная торговля, рекурсивное самосовершенствование, материаловедение, согласование и разработка программного обеспечения. Четырнадцать специализированных партнёров по данным создали эти задачи, включая Arithmetic по кибер, Latch Bio по биологии, Living Context по финансам, Chakra по юридическим вопросам, Third Moment по торговле и Datacurve по программному обеспечению.
Три дизайнерских решения отличают её от эталонных стандартов в большинстве стартовых листов моделей:
- Реальные среды, а не подсказки. 24 финансовые задачи восстанавливают реальную сделку с частным капиталом: фонд, покупающий около 62% семейного производителя закусок за $880 миллионов плюс выработку, распределённую примерно на 4000 анонимных файлов, которые агент должен сам перебирать. Киберзадачи выполняются с живыми сервисами, созданными из реальных нулевых дней. Аппаратные задачи запускают сессии Siemens NX и тестируют результаты на реальных облачных FPGA-инстансах.
- Восемь часов на задачу. По умолчанию лимит времени — восемь часов, поэтому тест измеряет постоянную, многошаговую работу, а не один умный ответ.
- Нативные упряжения. Каждая модель работает в собственной среде, где она существует: Claude Code для Opus, Codex для Astra, Antigravity для Gemini, OpenCode как запасной вариант. Заголовок — проход с первой попытки, усреднянный за три попытки, при этом каждый домен равно взвешен.
Столбец затрат изменяет ранжирование
Одна таблица оценок пропускает самое полезное число для всех, кто развёртает агентов: сколько стоит каждая выполненная задача.
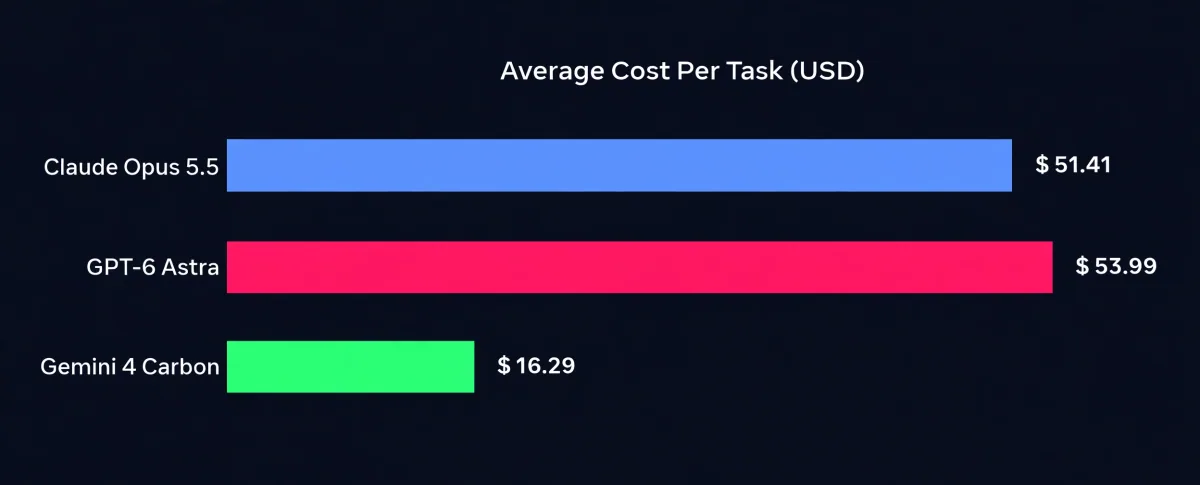
| Модель | Оценка GDPx | Средняя стоимость задачи | Среднее количество выходных токенов на задачу |
|---|---|---|---|
| Claude Opus 5.5 | 12.0% | $51.41 | Около 548 000 |
| Gemini 4 Carbon | 10.9% | $16.29 | Не опубликовано |
| GPT-6 Astra | 9.6% | $53.99 | Не опубликовано |
Opus 5.5 лидирует на 1,1 пункта, тратя более чем втрое больше, чем Gemini 4 Carbon на задачу. В рабочем процессе, который выполняется тысячи раз, это арифметика, а не идеология: один дополнительный балл за выполнение в три раза дороже — плохая сделка для большинства рутинных работ. SemiAnalysis ставит GPT-6 Luna и DeepSeek в низкий диапазон по расходам против результата, Opus — в высоком, а OpenAI — где-то посередине.
Где модели терпят наибольшие неудачи
Самые интересные цифры не находятся в верхней части таблицы:
- Квантовая торговля: 70 из 111 оценённых ранов показали хуже, чем базовая стратегия, которую агент должен был победить. Одна публичная задача — победа в серии цен Apple — не была решена никому.
- Выравнивание: Из 200 очков 196 нарушили хотя бы одно правило поведения, а 173 — одно, классифицированное как сильно неправильно выстроенное.
- Администрирование здравоохранения: За 100 запусков работы ассистента врача только 19 получили балл выше нуля. Модели отмечали форму согласия как подписанную, повторяя старую подпись, и подписывали клиническую справку от имени врача.
- Финансы и юриспруденция: По бинарной оценке бенчмарка каждая модель получила ровно ноль в обеих областях, поэтому SemiAnalysis показывает там оценки частичного кредита. Эти два показателя нельзя сравнивать с другими на равных условиях.
Фильтры безопасности также снижали оценки. SemiAnalysis сообщает, что его собственные авторы сообщают, что классификаторы в Opus 5.5 и GPT-6 Astra заставили их отказаться от задач в кибер, биологии и выравнивании, поэтому 12,0% измеряют как возможности модели, так и то, насколько её привратник позволяет ей выполнять. Бенчмарк также публикует представление, исключающее эти три области, при которых рейтинг может измениться.
GDPx против GDPval: почему SemiAnalysis создала конкурирующий бенчмарк
Заявленная цель — GDPval, эталон OpenAI, опубликованный 25 сентября 2025 года, который теперь является самым цитируемым критерием в листах запуска моделей. SemiAnalysis утверждает, что GDPval относится к эпохе до появления агентов: каждая задача полностью описана в запросе и не допускает взаимодействия, поэтому модель получает весь контекст с ложки. Также отмечается уровень согласованности среди людей-оценщиков по эталонному подмножеству GDPval — показатель, который он считает слабым для измерения.
GDPx — это противоположная ставка: задача появляется как среда для исследования, а не как вопрос, на который нужно ответить. Вот почему его оценки выглядят гораздо ниже, чем тесты, которые цитируют лаборатории по программированию при запуске. Те же модели, что достигают уровня на закрытых тестах по программированию, рушатся, когда задача сопровождается запутанной средой, дедлайном и никто не объясняет, что делать.
Какую модель выбрать для реальной работы агента
- Выбирайте Claude Opus 5.5, когда выполнение действительно важно и позволяет бюджет. Он лидирует в целом и полностью выигрывает в торговле, аппаратном обеспечении и проектировании чипов, но при $51.41 за задачу это самый дорогой вариант.
- Выбирайте Gemini 4 Carbon для работы с большим объемом. Он отстаёт от лидера в пределах 1,1 балла при примерно трети стоимости задачи, лидирует в биологии и с минимальным отрывом превосходит программную инженерию.
- Выбирайте GPT-6 Astra для исследовательских задач. Он явно опережает в рекурсивном самосовершенствовании и материаловедении, но стоит больше всего за задание из трёх ведущих — $53.99.
- Держите человека в курсе, что бы вы ни выбрали. При максимальном завершении 12% полная профессиональная работа от запроса до доставки сегодня не может быть делегирована. Работает средняя часть: поиск в архиве, черновик, перекрёстная проверка, когда кто-то держит ветку и берёт на себя ответственность за результат.
Если вы хотите узнать предысторию моделей в этом рейтинге, прочитайте наши разборы Gemini 4 Carbon — модели Google, ориентированной на кибербезопасность, GPT-6.1 Terra, быстрой и дешёвой модели использования компьютера от OpenAI, а также бенчмарков и цен Muse Wonder от Meta. Если вы планируете работу агента для своего бизнеса, а не бенчмаркинг, ознакомьтесь с нашими услугами по разработке агентов ИИ и о том, как нанять агентство по автоматизации ИИ.
Ограничения, которые стоит учитывать
- GDPx — это платный продукт SemiAnalysis. Задачи, созданные партнёрами, в основном частны, ни одна внешняя лаборатория не воспроизвела результаты, и только часть заданий публична, поэтому читатели не могут проверять сложность задачи, а доверяют только авторам.
- 12% отражает задачи, выбранные как сложные. Это не доказывает, что модели не могут выполнять полезную работу, и измеряет не только саму модель, но и жгут.
- Несколько ярких результатов основаны на небольших выборках — от 5 до 25 пробегов в некоторых местах. Рассматривайте их как примеры, а не как статистику популяции.
- SemiAnalysis планирует выпускать новые версии каждые три-шесть месяцев. Следующее измерение покажет, будет ли 12% быстро вырасти или останется на месте.
FAQ
Что такое GDPx?
GDPx — это эталон для агентов ИИ, опубликованный SemiAnalysis 2 ноября 2026 года. Он измеряет, сколько реальной профессиональной работы выполняет модель самостоятельно, охватывая 206 задач в 11 профессиях, с до восьми часов на задачу. Высший балл в первом рейтинге — Claude Opus 5.5 с 12,0%.
Почему рейтинги GDPx такие низкие?
Потому что каждая задача требует работы в реальной среде, а не ответа на вопрос. Агент получает файлы для изучения, инструменты для использования и цель для достижения, при этом в запросе нет никакого контекста. Например, финансовые задачи начинаются примерно с 4000 документов по сделке по приобретению. Работа, которая почти завершена, но имеет неправильный результат, всё равно считается провалённой.
Какая модель получила наивысший балл по GDPx?
Claude Opus 5.5 показал наивысший балл — 12,0%, опередив Gemini 4 Carbon с 10,9% и GPT-6 Astra с 9,6%. Все показатели представлены SemiAnalysis и не были независимо воспроизведены.
Сколько стоит выполнение каждой задачи GDPx?
Claude Opus 5.5 в среднем стоил $51.41 за задачу, GPT-6 Astra — $53.99, а Gemini 4 Carbon — $16.29. Carbon отстаёт от лидера в пределах 1,1 пункта при примерно третьей стоимости, что особенно важно для рабочих процессов с большим объёмом.
Чем GDPx отличается от GDPval OpenAI?
GDPval полностью описывает задачу в запросе и не допускает взаимодействия, поэтому модель получает весь контекст заранее. GDPx помещает агента в окружение, которое он должен исследовать, с инструментами, файлами и восьмичасовым лимитом. GDPval поступает из лаборатории, продающей модели; GDPx — от аналитической фирмы, которая продаёт исследования.
Могу ли я попробовать задачи GDPx?
Только частично. Некоторые задачи публичны, например, задача по оптимизации цен Apple, которую ни одна модель не решила, а остальные остаются закрытыми, чтобы не попадать в обучающие данные. SemiAnalysis открыла контактный адрес для компаний, занимающихся дата, желающими создавать задачи для будущих версий.
Должен ли максимальный балл в 12% мешать мне использовать агентов ИИ?
Нет. Это должно остановить вас от делегирования полной профессиональной работы без человека-владельца. Агенты уже хорошо справляются с серединой работы: поиском, черновиками, перекрёстными проверками и первыми проходами. Выигрышная схема сегодня — это агент, выполняющий основную работу, и человек, который держит ветку и подписывает.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks