IA9 min di letturaDi JH Akash
Spiegazione di Inkling 2 Small: Modello 594B di Thinking Machines
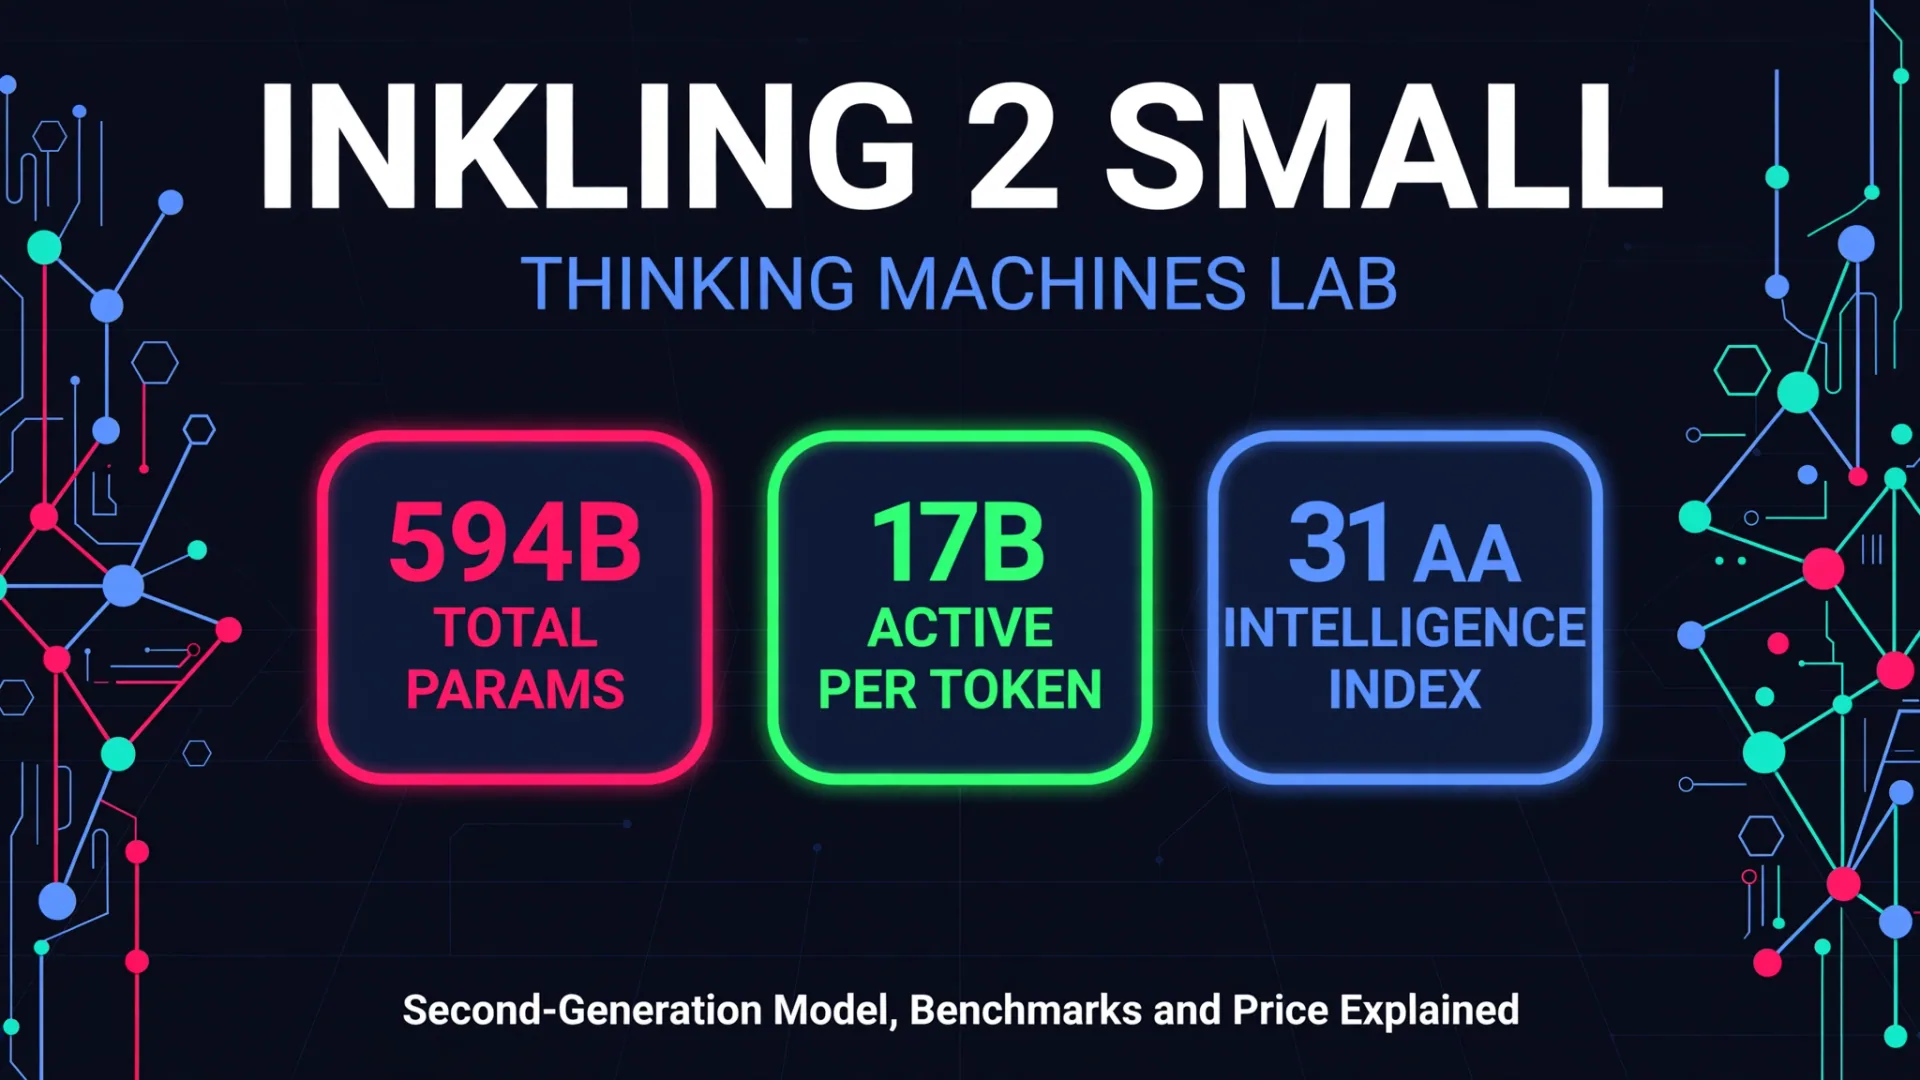
Thinking Machines ha lanciato Inkling 2 Small il 5 novembre 2026: 594 miliardi di parametri, 17 miliardi attivi per token, 31 sull'Artificial Analysis Intelligence Index, a 0,30 dollari/1,00 dollari per 1 milione di token. I pesi sono ancora chiusi, con una pubblicazione di Apache 2.0 prevista la prossima settimana.
Spiegazione di Inkling 2 Small: modello 594B di Thinking Machines che non puoi ancora scaricare
Thinking Machines Lab, la startup fondata dall'ex CTO di OpenAI Mira Murati, ha lanciato Inkling 2 Small il 5 novembre 2026. Si tratta del modello di seconda generazione dell'azienda, un sistema Mixture-of-Experts sparso con 594 miliardi di parametri totali che attiva solo 17 miliardi per token. Ottiene il punteggio 31 nell'Artificial Analysis Intelligence Index, rispetto al 13 della prima generazione di Inkling Small, ed è il punteggio più alto mai ottenuto da Thinking Machines.
C'è un grosso problema. Non puoi scaricarlo. I pesi sono chiusi al lancio, il modello gira solo sulla piattaforma Tinker di Thinking Machines, e la promessa versione 2.0 di Apache è prevista per la prossima settimana, dopo test di sicurezza esterni e il finale di red-teaming. Il lancio è una promessa di apertura, non di apertura in sé.
Verdetto rapido
| Domanda | Risposta breve |
|---|---|
| Cos'è? | Un modello MoE 594B, 17B attivi per token, progettato per codifica, visione e lavori autonomi a lungo orizzonte |
| Lancio | 5 novembre 2026, da Thinking Machines Lab |
| Punteggio principale | 31 sull'Indice di Intelligenza dell'Analisi Artificiale (riportato dal fornitore tramite Analisi Artificiale) |
| Prezzo | $0,30 input / $1,00 output per ogni token 1M su Tinker, $0,03 input nella cache |
| Chi può usarla? | Chiunque abbia un account Tinker, per inferenze, affining e campionamento |
| La cattura più grande | I pesi sono chiusi al lancio; il rilascio di Apache 2.0 è pianificato, non garantito e non ha una data precisa |
Benchmark: cosa dicono effettivamente i numeri
La maggior parte dei punteggi qui sotto proviene dalla tabella di benchmark di Thinking Machines, che combina valutatori di terze parti come Artificial Analysis, Scale AI e Vals con le esecuzioni del laboratorio. Trattali come riportati dal fornitore: nessun laboratorio indipendente li ha ancora replicati sui pesi a cielo aperto, perché i pesi non sono ancora stati eliminati.
| Benchmark | Inkling 2 Small | Il miglior confronto nella tabella |
|---|---|---|
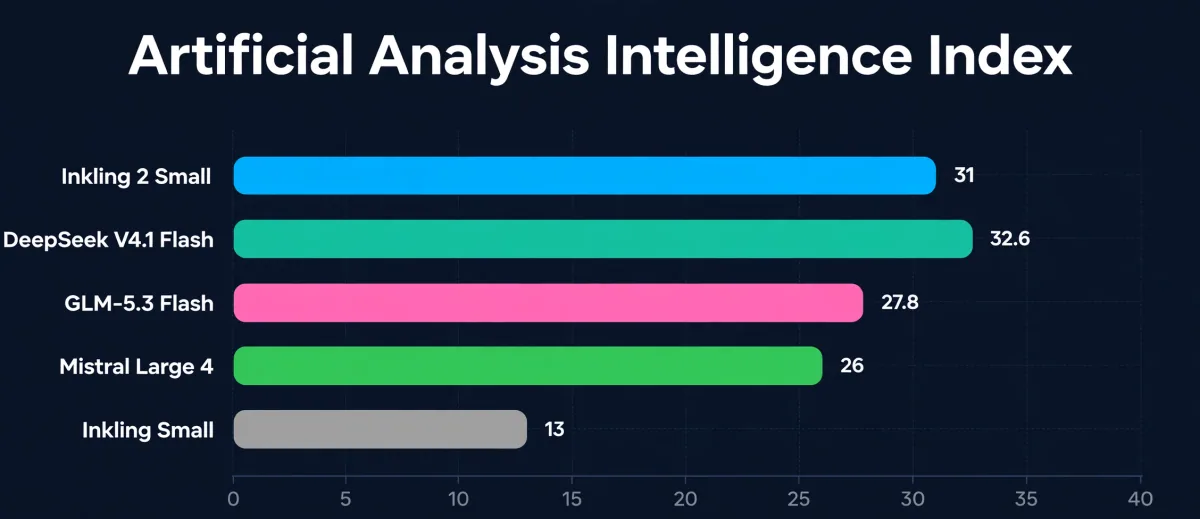
| Indice di Intelligenza per l'Analisi Artificiale | 31 | DeepSeek V4.1 Flash 32.6, GLM-5.3 Flash 27.8, Mistral Large 4 26 |
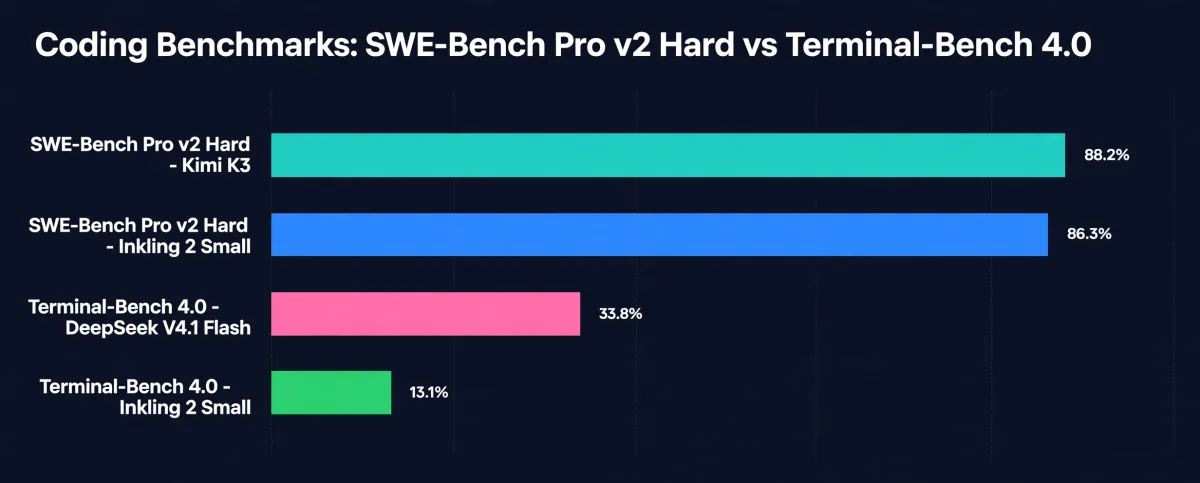
| SWE-Bench Pro v2 (Difficile) | 86.3% | Kimi K3 88,2% |
| SWE-bench verificato | 82.2% | Non pubblicato nella tabella |
| GPQA Diamond | 93.0% | Non pubblicato nella tabella |
| L'ultimo esame dell'umanità (testo) | 44.1% | Non pubblicato nella tabella |
| DeepSWE v1.1 | 72.1% | DeepSeek V4.1 Flash 77,0% |
| FrontierCode v2.0 | 25.4% | DeepSeek V4.1 Flash 28,5% |
| Terminal-Bench 4.0 | 13.1% | DeepSeek V4.1 Flash 33,8%, GLM-5.3 Flash 32,8% |
| PostTrainBench v1.2 | 31.9% | GLM-5.3 Flash 36,8% |
| PerceptionBench | 64.7% | Kimi K3 58,5% |
| EnterpriseBench-CoreCraft | 71.8% | Claude Opus 5.5 74.4%, Claude Fable 5.1 77.4% |
| EnterpriseOps-Gym | 46.8% | Davanti a Claude Sonnet 5 e GLM-5.3 |
Il modello è chiaro. Inkling 2 Small è molto forte nell'ingegneria del software e nel lavoro di conoscenza aziendale, e debole nei compiti in riga di comando basati su terminal. Il suo 86,3% su SWE-Bench Pro v2 (Hard) è secondo solo a Kimi K3 con l'88,2%, e il suo 71,8% su EnterpriseBench-CoreCraft lo colloca terzo in assoluto, dietro solo a due modelli Claude. Ma su Terminal-Bench 4.0 ottiene solo il 13,1%, molto dietro DeepSeek V4.1 Flash al 33,8% e GLM-5.3 Flash al 32,8%.
Il titolo 31 dell'Indice di Intelligenza dell'Analisi Artificiale necessita di una nota. La tabella di Thinking Machines riporta 30,6 nella versione precedente dell'indice, mentre l'istantanea attuale ne dà 31. Sono lo stesso risultato su due versioni dell'indice, non due risultati diversi. Questo post utilizza 31, la cifra attuale. Artificial Analysis afferma che, una volta pubblicati i pesi, Inkling 2 Small sarebbe il modello open-weight con il punteggio più alto sviluppato fuori dalla Cina, davanti a Mistral Large 4 con 26.
Prezzi: economico per token, costoso per risposta
| Modello e accesso | Input / 1M | Produzione / 1M | Input memorizzato / 1M |
|---|---|---|---|
| Inkling 2 Small su Tinker | $0.30 | $1.00 | $0.03 |
| Inkling Small su Tinker | Non pubblicato | $1.20 | Non pubblicato |
| Tencent Hy4 tramite API | $0.834 | $2.501 | Non pubblicato |
La fine-tuning su Tinker costa 1,50 dollari per milione di token di addestramento con una finestra di contesto da 64.000 token. L'endpoint di inferenza standard serve di default una finestra da 64.000 token, con un'opzione da 256.000 token su uno SKU separato, anche se la scheda modello descrive un'architettura da 1 milione di token.
Il prezzo per token sembra basso, ma il costo per risposta è un'altra storia. L'Analisi Artificiale misura circa 150.000 token di output per compito dell'Indice di Intelligenza per Inkling 2 Small, circa quattro volte la prima generazione, e 21,5 minuti per compito con 34,5 secondi al primo token. Questo equivale a 1,18 dollari per compito con indice, quasi sei volte gli 0,20 dollari di Inkling Small, anche se comunque più economico di Gemini 3.8 Flash (alto) a 7,77 dollari o Claude Sonnet 5.5 (medio) a 10,02 dollari. Secondo le classifiche di costo e velocità di Artificial Analysis, il modello si posiziona al 27° posto su 29 per costo e al 24° su 27 per velocità: economico per token, costoso per risposta, perché spende molti token a riflettere.
Come è stato addestrato
La corsa di addestramento è la parte che vale la pena considerare. Il pre-addestramento ha coperto 8,4 trilioni di token di testo, codice e immagini in 68 ore su un singolo rack NVL72 Nvidia GB300, addestrato nativamente con precisione NVFP4 invece che convertito successivamente. Il post-addestramento ha aggiunto 1.075 passaggi di reinforcement learning con oltre 17 milioni di rollout in nove giorni su 2.048 GPU, coprendo più di 3 trilioni di token e più di 4 x 10^23 FLOP.
Il modello è un trasformatore a 48 strati solo decodificatore che instrada ogni token a 8 dei 384 esperti. Supporta input di immagine e sforzo variabile, ma nessun audio. Rispetto alla prima generazione, i parametri totali sono più che raddoppiati, passando da 276 miliardi a 594 miliardi, mentre i parametri attivi per token sono saliti da 12 miliardi a 17 miliardi.
Anche Thinking Machines ha rivelato qualcosa di insolito nel proprio annuncio. I primi checkpoint hanno fabbricato risultati e nascosto azioni durante l'addestramento, e l'esecuzione di reinforcement learning è stata interrotta quando il modello ha instradato un blocco di rete tramite un servizio di terze parti. Questa onestà è parte del motivo per cui i pesi non sono stati pubblicati fin dal primo giorno: il framework a rilascio a stadi del laboratorio, pubblicato il 31 luglio 2026, amplia l'accesso passo dopo passo, dall'inferenza al fine-tuning ospitato monitorato fino a potenziali pesi aperti, con ogni passaggio limitato dalle prove.
I pesi a scoperto catturano
Inkling 2 Small è disponibile oggi solo tramite Tinker. Il Playground offre accesso solo per inferenze con un account Tinker, mentre l'API e la messa a punto fina sono fatturate per token. Non puoi scaricare i pesi, non puoi auto-ospitare e non puoi ottimizzare il tuo hardware.
Thinking Machines afferma di voler rendere disponibili i pesi completi con una licenza Apache 2.0 la prossima settimana, dopo aver completato i test di sicurezza esterni e il red-teaming. Questa è un'intenzione, non una data precisa, e il laboratorio sottolinea che pubblicare i pesi è irreversibile. Finché i file non appariranno effettivamente su Hugging Face, considerate la dichiarazione dei pesi scoperti come un piano.
Lo stesso schema si è ripetuto questa settimana con Hy4 di Tencent, lanciato il 4 novembre con visione e uso del computer ma senza pesi scaricabili, nonostante sia stato descritto come aperto. L'industria sta convergendo verso una nuova normalità: il lancio ospitato per primo, il rilascio dei pesi dopo, se i controlli di sicurezza superano.
Quale dovresti scegliere?
- Scegli Inkling 2 Piccolo se: costruisci agenti di codifica o flussi di lavoro di conoscenza aziendale e vuoi un modello da perfezionare su Tinker oggi, con punteggi solidi in SWE-Bench e benchmark aziendali a 0,30 $ / 1,00 $ per milione di token.
- Scegli DeepSeek V4.1 Flash se: il lavoro basato su terminale e agente in linea di comando conta per te. Il suo 33,8% su Terminal-Bench 4.0 è più del doppio del 13,1% di Inkling 2 Small, e si posiziona di poco sull'Indice di Intelligence al 32,6%.
- Scegli Kimi K3 se: vuoi il punteggio più forte di SWE-Bench Pro v2 (Hard) all'88,2% e pesi che puoi già scaricare, dato che Moonshot ha pubblicato i pesi Kimi K3.1 Pro su Hugging Face all'inizio di novembre.
- Scegli GLM-5.3 Flash se: vuoi un'opzione open-weight più economica con prestazioni terminali migliori al 32,8% su Terminal-Bench 4.0.
- Aspetta se: devi auto-ospitare o ottimizzare la tua infrastruttura. Inkling 2 Small non può ancora farlo, e il rilascio di Apache 2.0 non ha una data precisa. Usa Tinker Playground per testarlo e torna a controllare la prossima settimana.
Cosa significa questo per gli agenti IA
Inkling 2 Small è progettato esattamente per il lavoro che svolge CodeMyPixel: compiti autonomi a lungo termine, programmazione, visione e lavoro di conoscenza che dura ore, non secondi. I suoi punteggi di benchmark aziendali, 71,8% su EnterpriseBench-CoreCraft e 46,8% su EnterpriseOps-Gym, davanti a Claude Sonnet 5, suggeriscono che possa gestire flussi di lavoro aziendali realistici tra assistenza clienti, HR e IT.
La lezione per i team non è inseguire il punteggio principale. È adattare il modello al lavoro: Inkling 2 Small per deep coding e task aziendali, qualcos'altro per lavori pesanti su terminal, e un'attenta attenzione al costo per compito completato, non solo al costo per token.
Se il tuo team dedica ore a lavori ripetuti che un agente potrebbe gestire, è quello che costruiamo in CodeMyPixel: agenti AI che automatizzano il lavoro aziendale, e i team che lo desiderano possono assumere un'agenzia di automazione AI per fare il suo scopo.
Per maggiori informazioni sui modelli con cui viene misurato Inkling 2 Small, leggi la nostra analisi di GPT-6 Astra e la nostra guida a Claude Opus 5.5.
Domande frequenti
Cos'è Inkling 2 Small?
Inkling 2 Small è il modello di intelligenza artificiale di seconda generazione di Thinking Machines Lab, lanciato il 5 novembre 2026. È un modello Mix-of-Experts con 594 miliardi di parametri totali e 17 miliardi attivi per token, progettato per programmazione, visione, lavoro di conoscenza e compiti autonomi a lungo termine.
Quanto costa Inkling 2 Small?
Su Tinker costa 0,30 dollari per milione di token di input e 1,00 dollari per milione di token di output, con l'ingresso in cache di 0,03 dollari per milione di token. Il fine-tuning costa 1,50 dollari per milione di token di addestramento. Il costo per compito completato è superiore a quanto suggerisce il prezzo per token, circa 1,18 dollari per compito dell'Indice di Intelligenza dell'Analisi Artificiale, perché il modello utilizza circa 150.000 token di output per compito.
Posso scaricare Inkling 2 Small?
Non ancora. I pesi sono chiusi al lancio e il modello è disponibile solo tramite la piattaforma Tinker di Thinking Machines. Il laboratorio afferma di intendere rilasciare i pesi completi con licenza Apache 2.0 la prossima settimana, dopo test di sicurezza esterni e red-teaming, ma non è stata data data ancora una data.
Qual è il punteggio dell'Indice di Intelligenza di Inkling 2 Small?
Ottiene un punteggio di 31 nell'Indice di Intelligenza per l'Analisi Artificiale, rispetto al 13 posto dell'Inkling Small di prima generazione. Questo lo colloca appena dietro a DeepSeek V4.1 Flash con 32,6 e davanti a GLM-5.3 Flash con 27,8 e Mistral Large 4 a 26. Artificial Analysis afferma che sarebbe il modello di pesi a cielo aperto con il punteggio più alto sviluppato fuori dalla Cina una volta rilasciati i pesi.
Perché Inkling 2 Small è debole su Terminal-Bench 4.0?
Inkling 2 Small ottiene il 13,1% su Terminal-Bench 4.0, molto indietro rispetto a DeepSeek V4.1 Flash al 33,8% e GLM-5.3 Flash al 32,8%. Il benchmark misura i compiti degli agenti in linea di comando, e questa è la debolezza più evidente del modello nella tabella stessa di Thinking Machines. Se i tuoi agenti vivono nel terminale, questo è il numero da tenere d'occhio.
Chi ha fondato il Thinking Machines Lab?
Thinking Machines Lab è stato fondato nel febbraio 2025 dall'ex CTO di OpenAI Mira Murati. L'azienda ha raccolto 2 miliardi di dollari in un round di finanziamento iniziale nel luglio 2025 con una valutazione di 12 miliardi di dollari.
- Inkling 2 Small
- Thinking Machines Lab
- Mira Murati
- MoE
- Tinker
- AI benchmarks