Notizie IA6 min di letturaDi JH Akash
Edge0-145B: 145B AI gira su una RTX 5090
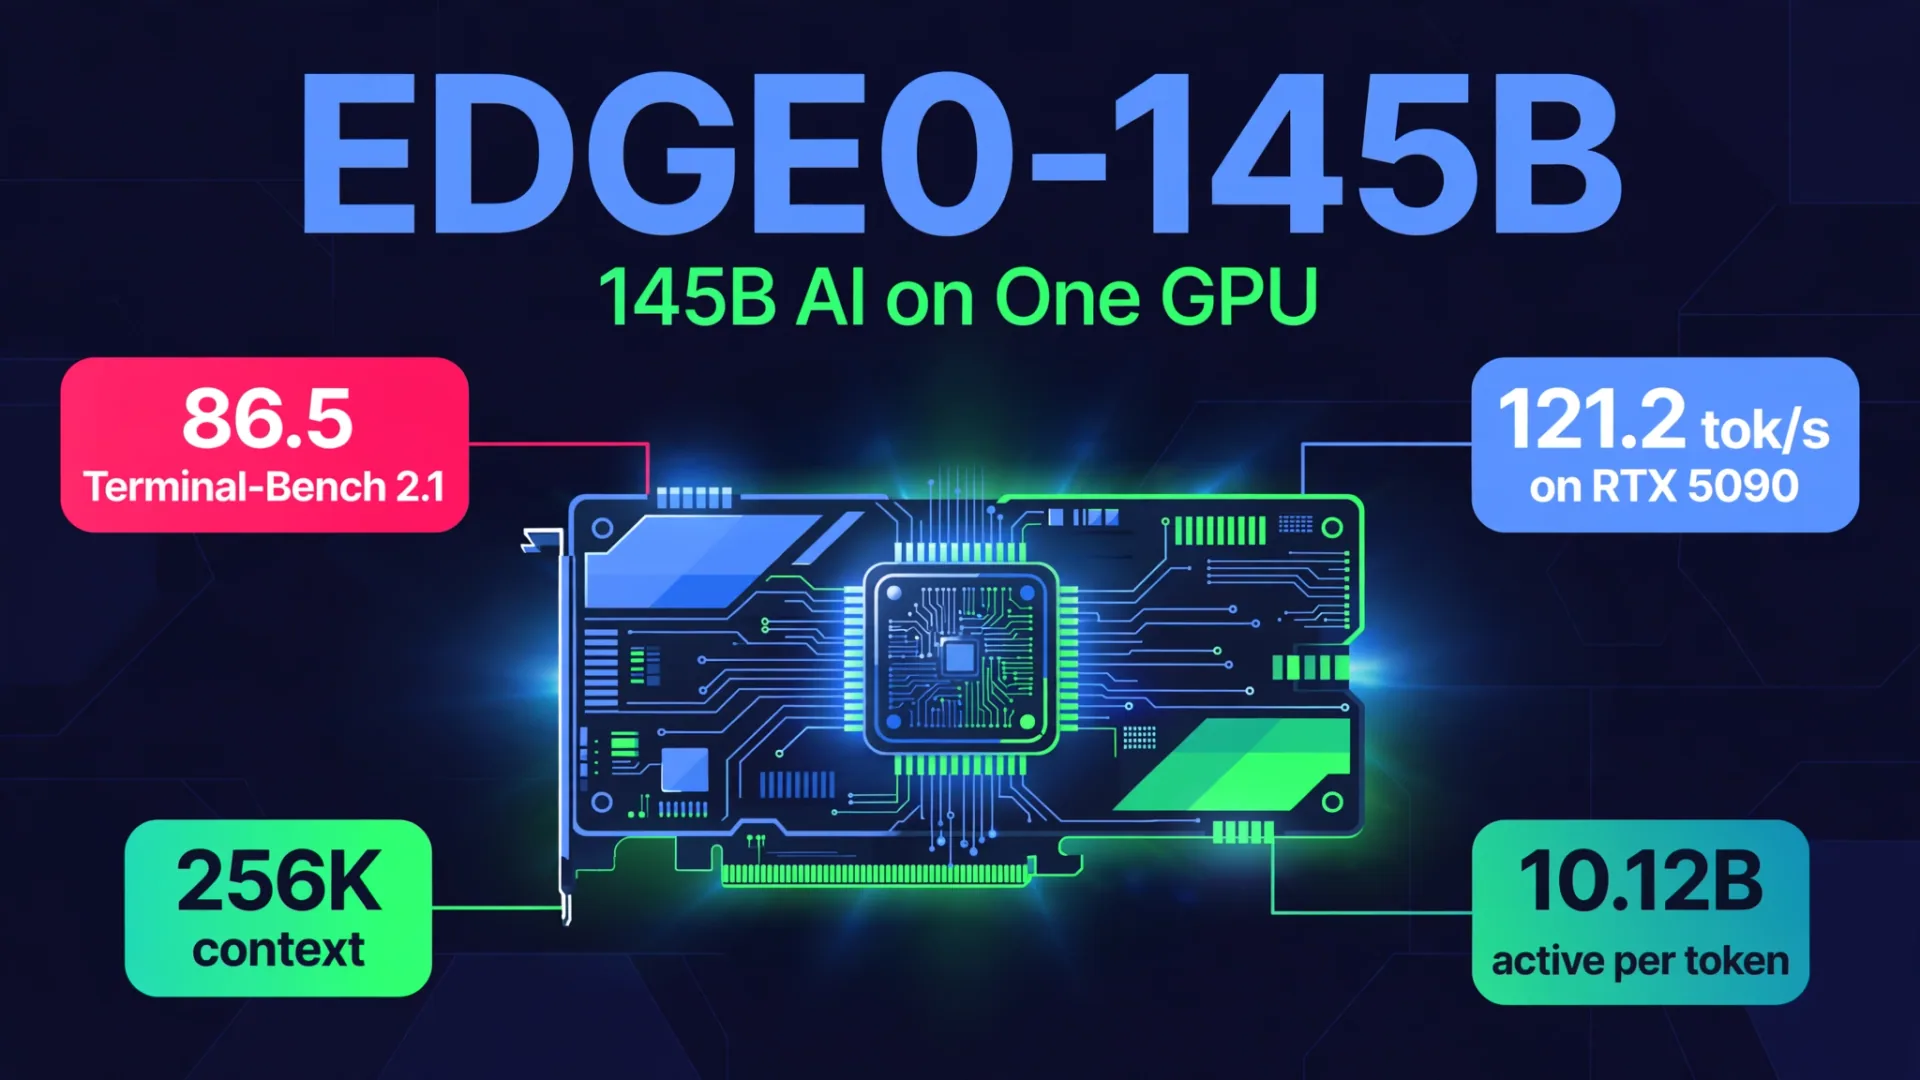
Edge0-145B impacchetta 145B parametri su una singola RTX 5090, ottenendo un punteggio di 86,5 su Terminal-Bench 2.1. Ecco i benchmark, la velocità, il prezzo e i punti di riferimento.
Edge0-145B: 145B AI gira su una RTX 5090
Il 12 novembre 2026, Edge0 ha rilasciato Edge0-145B, un modello di intelligenza artificiale da 145 miliardi di parametri che gira su una singola scheda grafica consumer. I pesi sono arrivati su Hugging Face l'11 novembre, il post ufficiale sul blog è seguito il 12 novembre e il 14 novembre il modello aveva già superato i 61.000 download, con 11.379 stelle su GitHub.
L'affermazione principale è semplice: IA di livello frontiera, sul tuo computer, senza una bolletta cloud. Ecco cosa è effettivamente il modello, cosa dicono i numeri e dove si nascondono le clausole in piccolo.
Cosa sono Edge0-145B
Edge0-145B è un modello latente e sparso di esperti. Ha 145 miliardi di parametri totali, ma solo 10,12 miliardi sono attivi per ogni token, motivo per cui si adatta a una sola GPU. L'architettura utilizza 48 livelli e 512 esperti per livello, con 10 esperti instradati più 1 esperto condiviso attivo per token. È stato addestrato nativamente a precisione a 4 bit e viene fornito con una finestra di contesto di 256K token.
| Specifiche | Edge0-145B |
|---|---|
| Parametri totali | 145B |
| Attivo per token | 10.12B |
| Architettura | MoE latente sparso, 48 strati, 512 esperti |
| Finestra di contesto | 256K gettoni |
| Precisione dell'addestramento | 4 bit nativi |
| Pesi | Q3_K 40,81 GiB, NVFP4 47,79 GiB |
| Modello base | Qwen3.8-Flash-Next (secondo i metadati di Hugging Face) |
| Licenza | Licenza Modello Comunitaria Edge0 1.0 |
| Rilasciato | 12 novembre 2026 |
Un fratello minore, Edge0-120B, è stato lanciato lo stesso giorno con 120B di parametri totali e 8,64B attivi per token.
I numeri di velocità
Edge0 riporta queste velocità di decodifica dai propri test, quindi trattale come riportate dal fornitore finché non esistono run indipendenti.
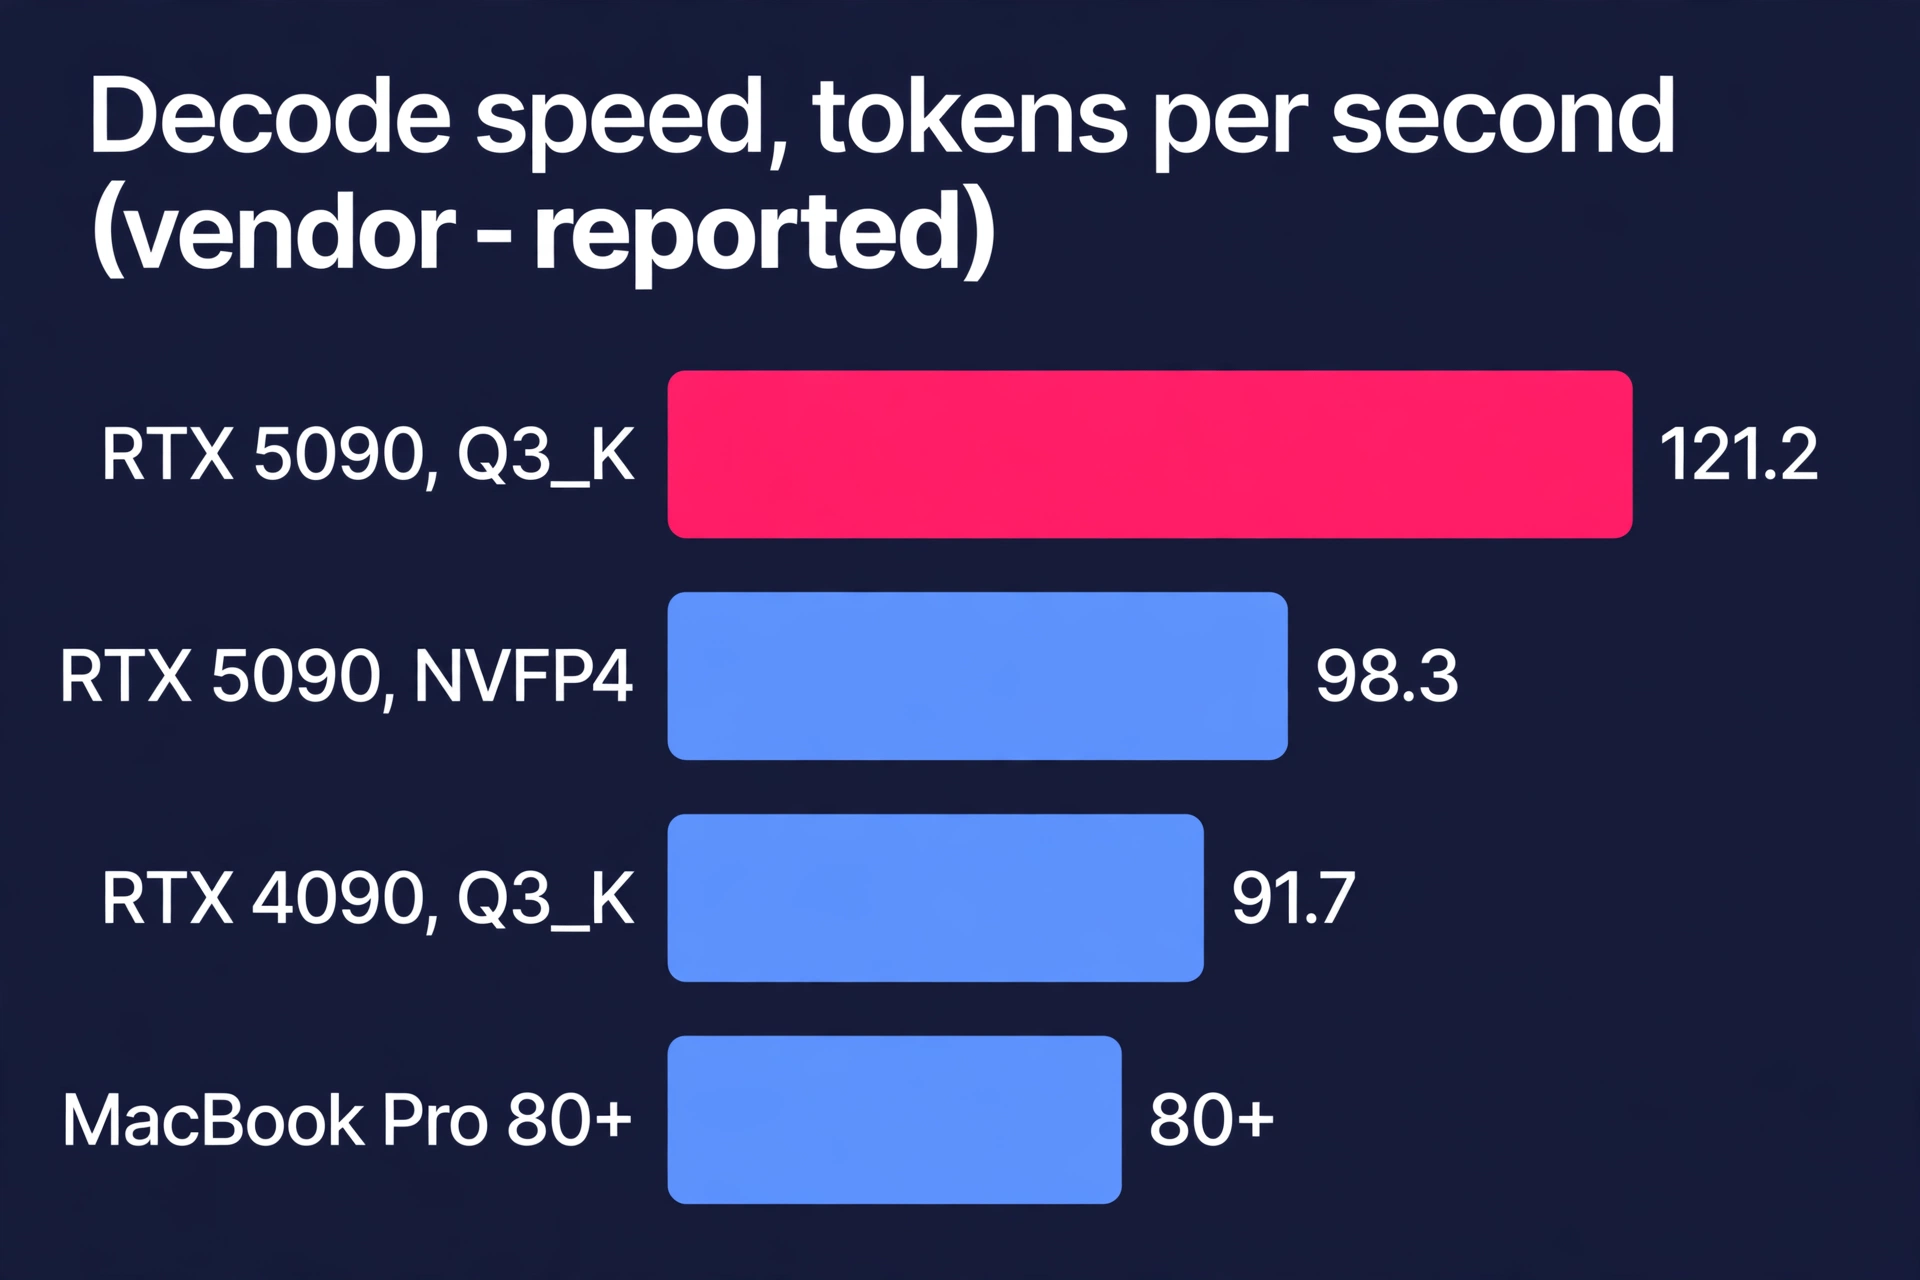
Su una RTX 5090 D con 24 GB di memoria, la build Q3K decodifica a 121,2 token al secondo con 3.554,9 token al secondo su prefill da 16K. La build NVFP4 gira a 98,3 token al secondo di decodifica e 3.165,7 token al secondo di prefill. La stessa build Q3K raggiunge 91,7 token al secondo su una RTX 4090. Su un MacBook Pro, Edge0 riporta oltre 1.100 token al secondo di prefill e più di 80 token al secondo di decodifica, con una potenza tipica di circa 120W, con un contesto da 128K a 256K quasi alla stessa velocità.
Il supporto day-one copre macOS, Windows e Linux su laptop Apple M-series e GPU RTX Spark, RTX 4090 e RTX 5090.
I numeri di riferimento
Ogni punteggio qui sotto proviene dalle valutazioni interne di Edge0. L'azienda afferma che un rapporto tecnico con istruzioni complete per l'installazione e la riproduzione sta ancora arrivando, quindi leggi questi come reclami, non come misurazioni saldate.
| Benchmark | Edge0-145B | Confronto più vicino |
|---|---|---|
| DeepSWE 1.1 | 64.6 | Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4 |
| Terminal-Bench 2.1 | 86.52 | Qwen3.8-Flash-Next 83.3, DeepSeek-V4-Flash 82.7, Claude Opus 4.6 Max 78.2 |
| GPQA-Diamante | 90.4 | DeepSeek-V4-Flash 90.8, Claude Opus 4.6 Max 91.3 |
| IFBench | 80.6 | - |
| HLE | 35.4 | - |
| AA-LCR | 79.3 | - |
| Media a sei parametri di riferimento | 72.8 | Qwen3.8-Flash-Next 71.7 |
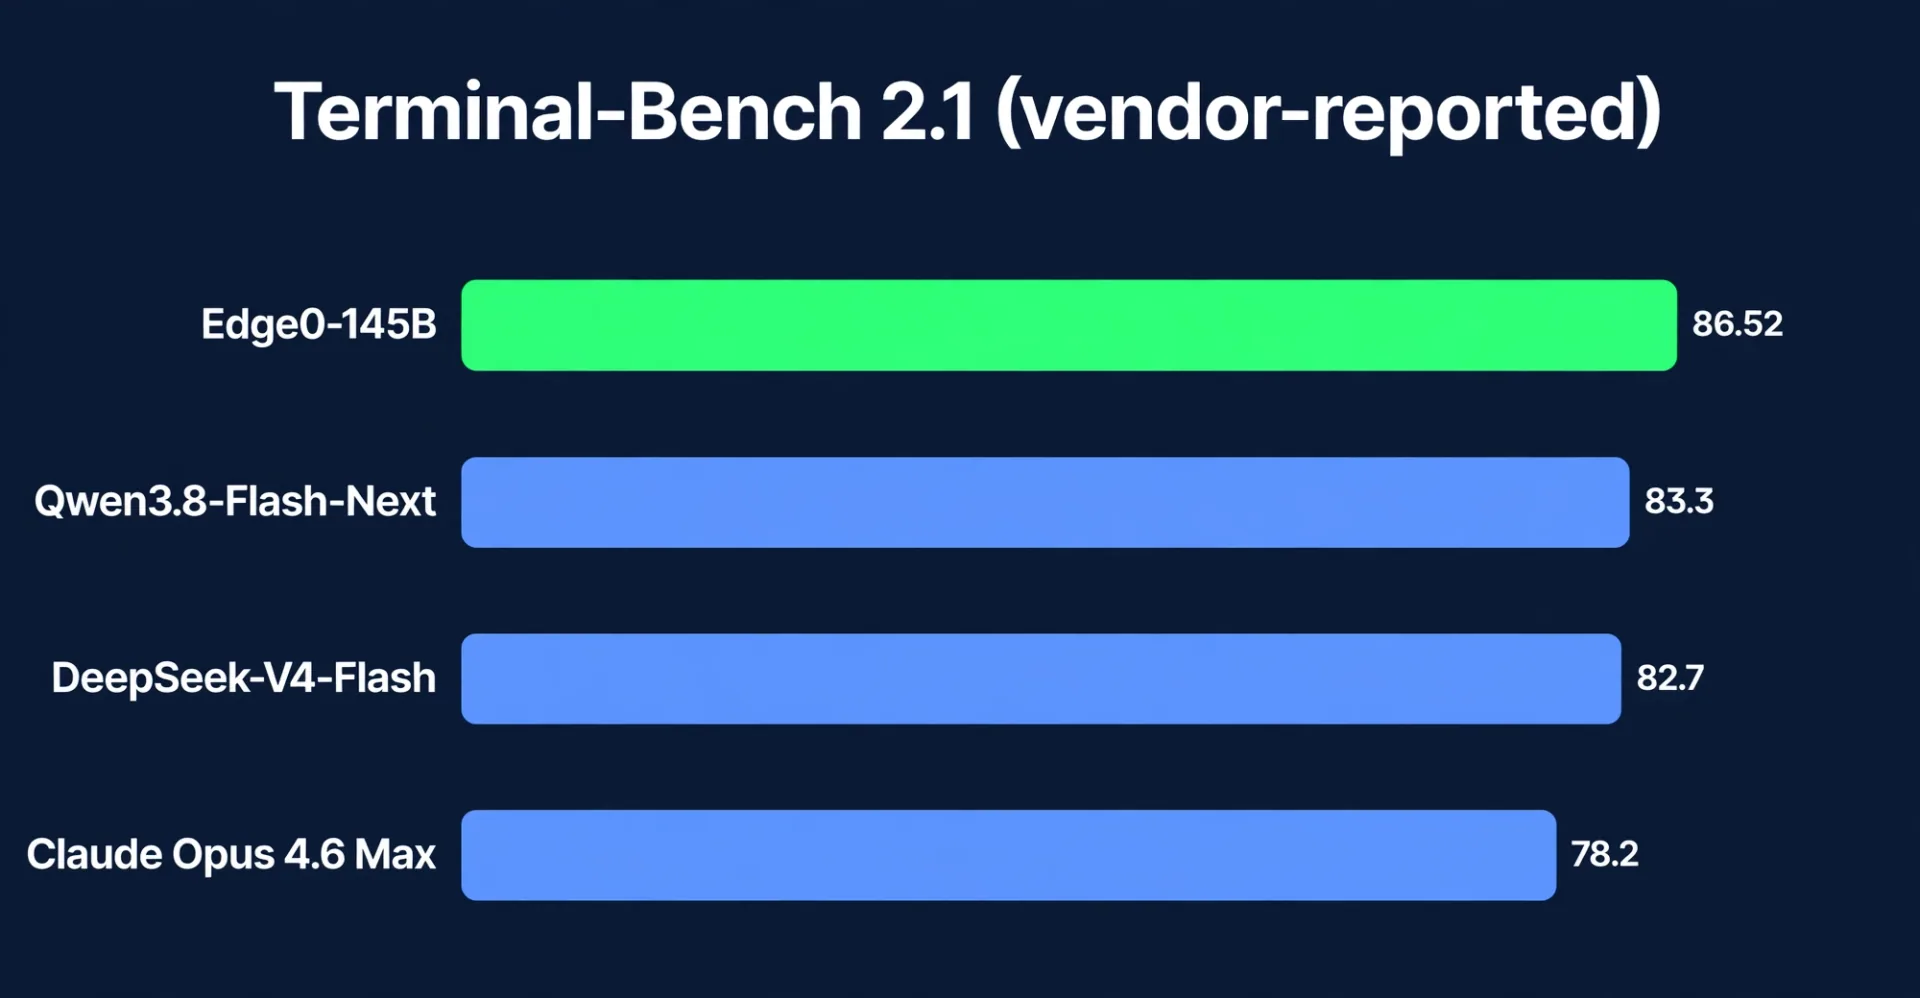
Il risultato di Terminal-Bench 2.1 è il più evidente: 86,52 contro 78,2 per Claude Opus 4.6 nella sua configurazione Max. Ma nota la colonna GPQA-Diamond, dove Edge0 è dietro sia a DeepSeek-V4-Flash che a Claude Opus 4.6. Nessun singolo benchmark decide un modello, e i "vincitori" del cross-benchmark non esistono. Testalo sui tuoi compiti.
Quanto costa
| Opzione | Prezzo |
|---|---|
| Pesi Edge0-145B | Scaricabile gratuitamente |
| Quadro di inferenza Edge0 | Apache 2.0, gratuito |
| Il tuo costo | Una GPU, elettricità e il tuo tempo |
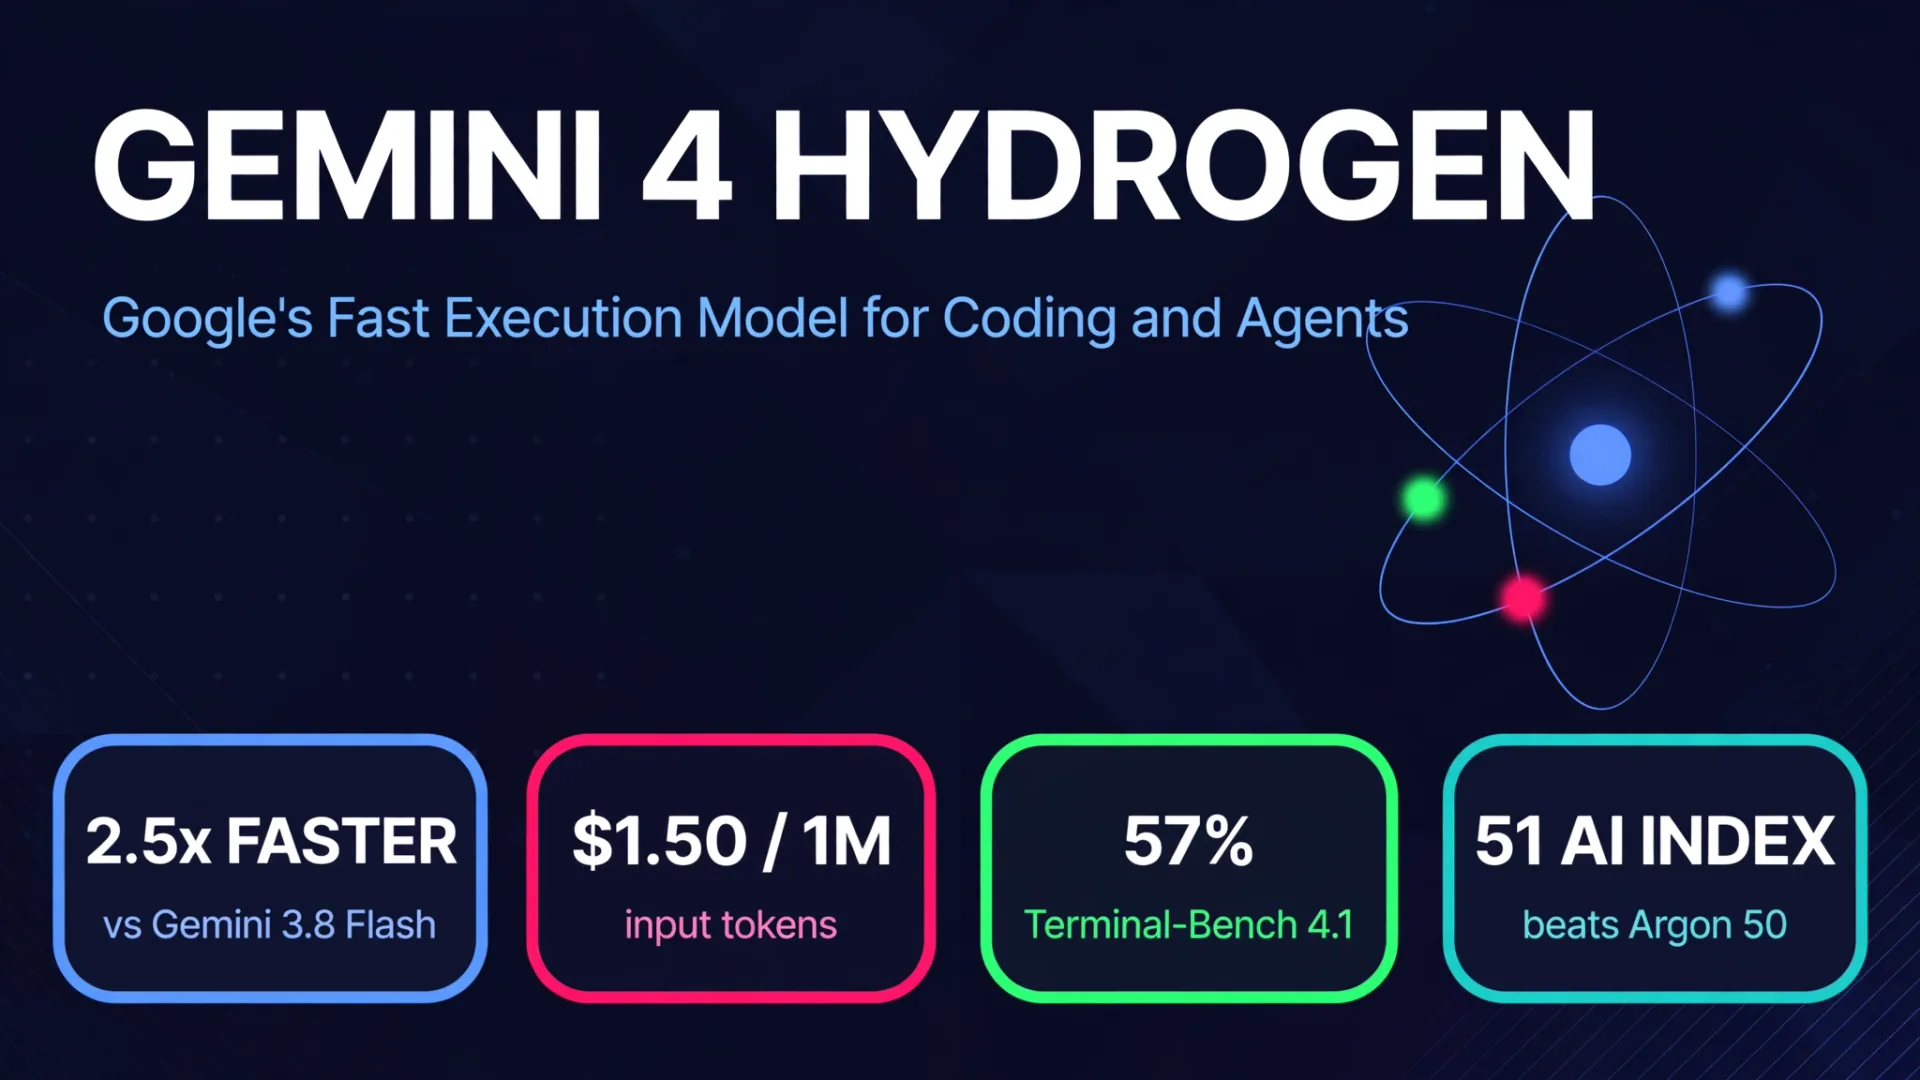
| Gemini 4 Hydrogen API | $1,50 per ogni token di input da 1 milione |
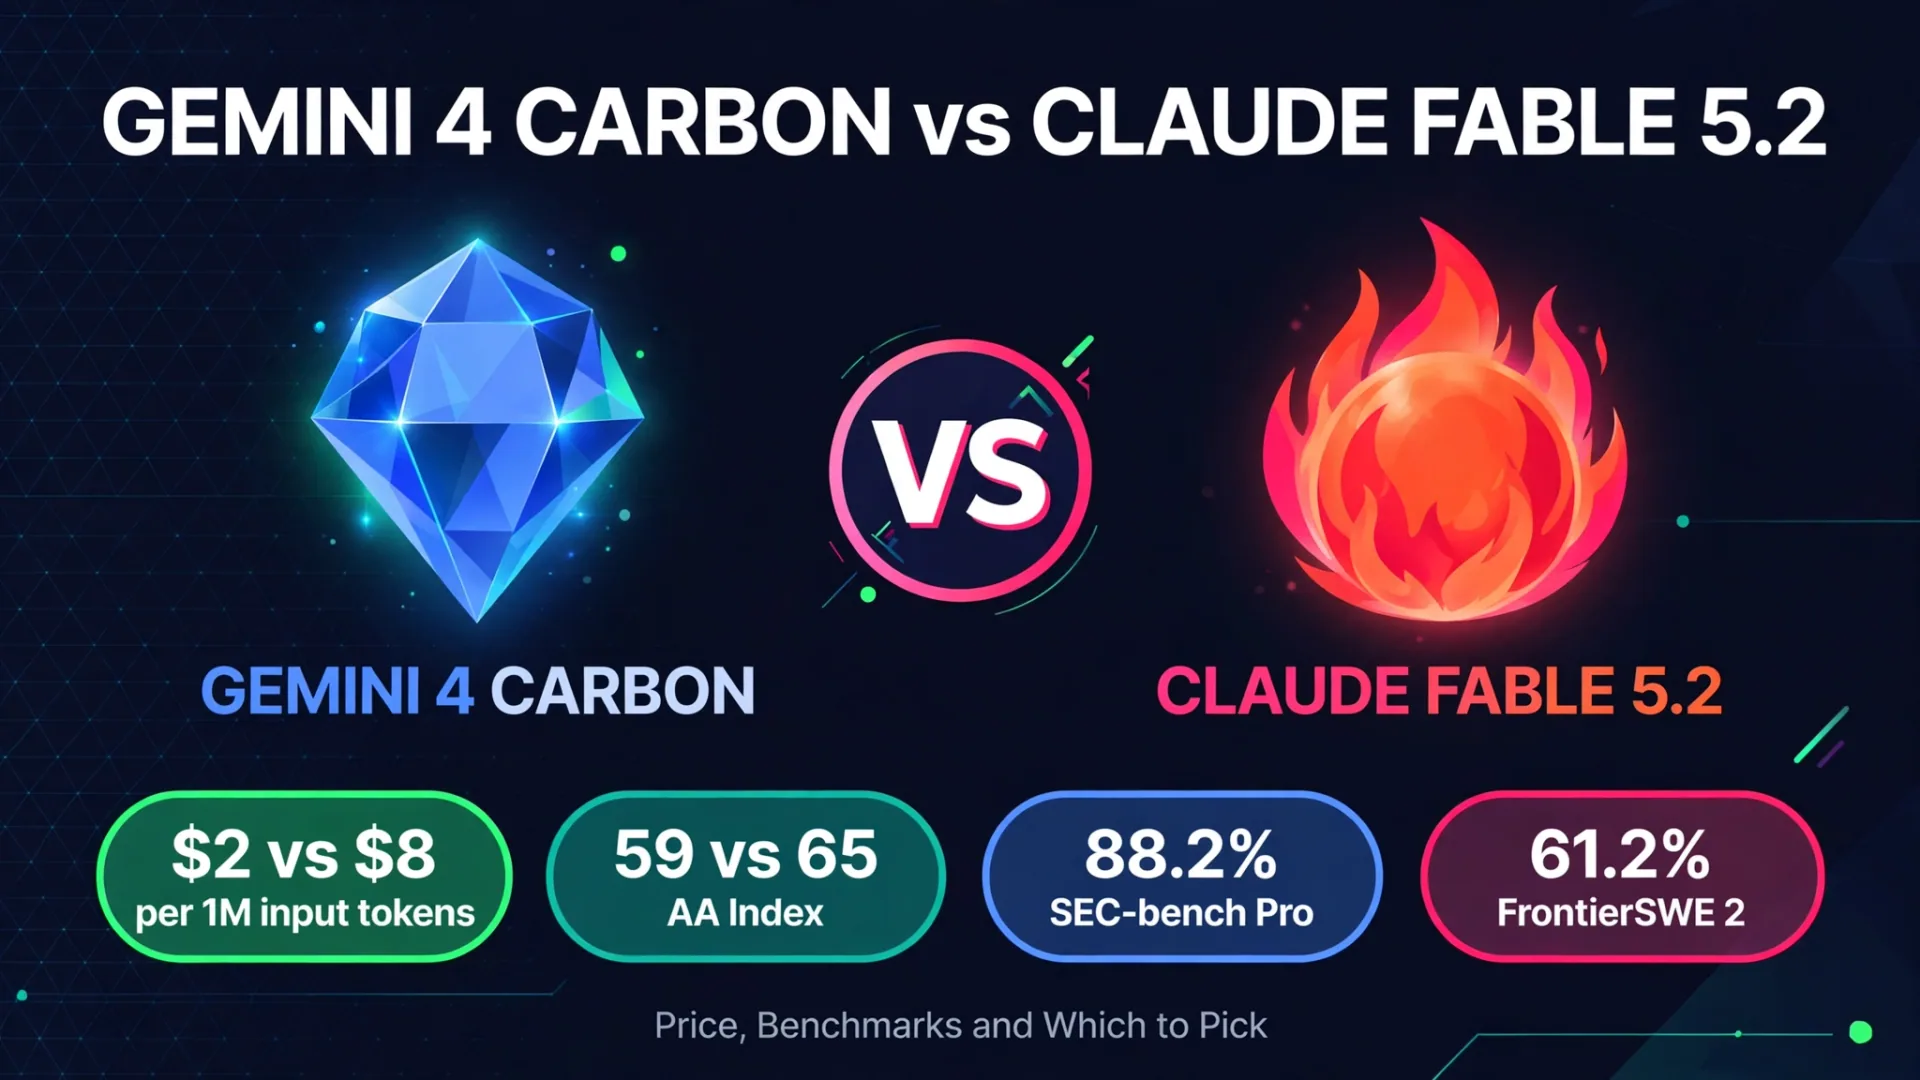
| Claude Fable 5.2 API | $8 per 1M in ingresso, $40 per 1M token di output |
Non c'è una bolletta per token con Edge0-145B. La trade è diversa: paghi in hardware e tempo di setup invece che in commissioni API, e i tuoi dati restano sulla tua macchina. Per i team che costruiscono automazione sul proprio hardware, proprio questo scambio è il punto. Se vuoi vedere come si confronta il prezzo cloud, la nostra analisi Gemini 4 Hydrogen copre il modello di 1,50 dollari per token 1M di Google, e la storia dell'IPO di Anthropic mostra quanto gli investitori ora valorizzino l'azienda dietro Claude.
Le prese
Tre cose da sapere prima di scaricare.
Il titolo dei 29 GB necessita di contesto. Edge0 dice che il modello funziona con 29 GB di memoria di picco su un laptop, ma la scheda modello Hugging Face misura circa 61,5 GiB totali per la configurazione NVFP4: 23,25 GiB di memoria video più 38,27 GiB di RAM di sistema. La cifra di 29 GB è solo per la memoria GPU. Assicurati che la tua macchina abbia la RAM corrispondente.
È open-weight, non open-source. I pesi rientrano nella Community Model License 1.0 di Edge0, che riserva alcuni usi, come vendere, noleggiare o concedere licenze ai pesi e gestire un servizio modello, a una licenza scritta separata. Il codice del framework di inferenza è Apache 2.0, ma i pesi non lo sono. Leggi la licenza prima di costruire un prodotto commerciale su di essa.
È costruito su Qwen. I metadati di Hugging Face indicano Qwen3.8-Flash-Next di Alibaba come modello base, e la release è una derivazione di quel modello. Il blog di Edge0 non nomina Qwen. Questo conta se le tue regole di conformità tengono alla linea di modello.
Quale scegliere
Scegli Edge0-145B se hai una GPU da 24 GB o un portatile Apple Silicon potente, vuoi che i tuoi dati restino locali e gestisci agenti o carichi di lavoro di coding dove una bolletta cloud per token potrebbe essere dannosa. Prendi la build NVFP4 o Q3_K, esegui i tuoi flussi di lavoro reali e confronta con lo stack attuale qualità, latenza e costo elettrico.
Rimani su un modello cloud se hai bisogno di un'API gestita, uptime garantito o di un modello con verifica indipendente dei benchmark. Il rapporto tecnico per Edge0-145B è ancora in attesa e nessun laboratorio indipendente ha ancora riprodotto i punteggi principali.
Aspetta e guarda se stai decidendo tra Edge0-145B e il suo fratello. Edge0-120B è più piccolo ed economico da gestire, e la prima ondata di test indipendenti ci dirà quale dei due regge. Per una panoramica più ampia della decisione build-vs-acquisto, vedi Custom AI vs Off-the-Shelf: 76% Compra Prima.
Domande frequenti
Edge0-145B è davvero gratuito?
I pesi sono scaricabili gratuitamente da Hugging Face, e il framework di inferenza è Apache 2.0. Paghi comunque per la GPU, l'elettricità e il tempo di montaggio, e alcuni usi commerciali richiedono una licenza separata sotto la Edge0 Community Model License 1.0.
Edge0-145B può funzionare su un laptop?
Edge0 dice di sì: su un MacBook Pro riporta più di 80 token al secondo di decodifica con 29 GB di memoria GPU di picco. L'impronta totale misurata è di circa 61,5 GiB inclusa la RAM di sistema, quindi serve un laptop ben specificato.
Quanto è veloce Edge0-145B su una RTX 5090?
Edge0 riporta una decodifica di 121,2 token al secondo con la versione Q3_K e 98,3 token al secondo con la versione NVFP4, entrambi dati riportati dal fornitore dai test dell'azienda.
Edge0-145B è migliore di Claude Opus 4.6?
Su Terminal-Bench 2.1, Edge0 riporta 86,52 contro 78,2 per Claude Opus 4.6 Max. Su GPQA-Diamond, Claude è in vantaggio 91,3 a 90,4. I punteggi sono riportati dai fornitori e non esiste ancora una verifica indipendente, quindi non c'è un vincitore definito.
Dove posso scaricare Edge0-145B?
I pesi sono su Hugging Face sotto Edge0/Edge0-145B-q3k e Edge0-145B-NVFP4, mentre il framework di inferenza e gli strumenti di deployment sono su GitHub sotto Edge0-AI/Edge0.
Qual è la differenza tra Edge0-145B e Edge0-120B?
Edge0-145B ha 145B di parametri totali con 10,12B attivi per token; Edge0-120B ha 120B totali con 8,64B attivi. Entrambi lanciati il 12 novembre 2026 e il modello 120B è l'opzione più leggera ed economica da gestire.
- Edge0-145B
- open source AI
- local AI
- RTX 5090
- AI benchmarks