IA10 min de lecturePar JH Akash
Une règle robots.txt de refuser l’entraînement IA expliquée
Le 30 octobre 2026, OpenAI, Google, Microsoft et Anthropic soutenu un robots.txt jeton pour se désinscrire de l’entraînement IA. Dates, limites et code exact.
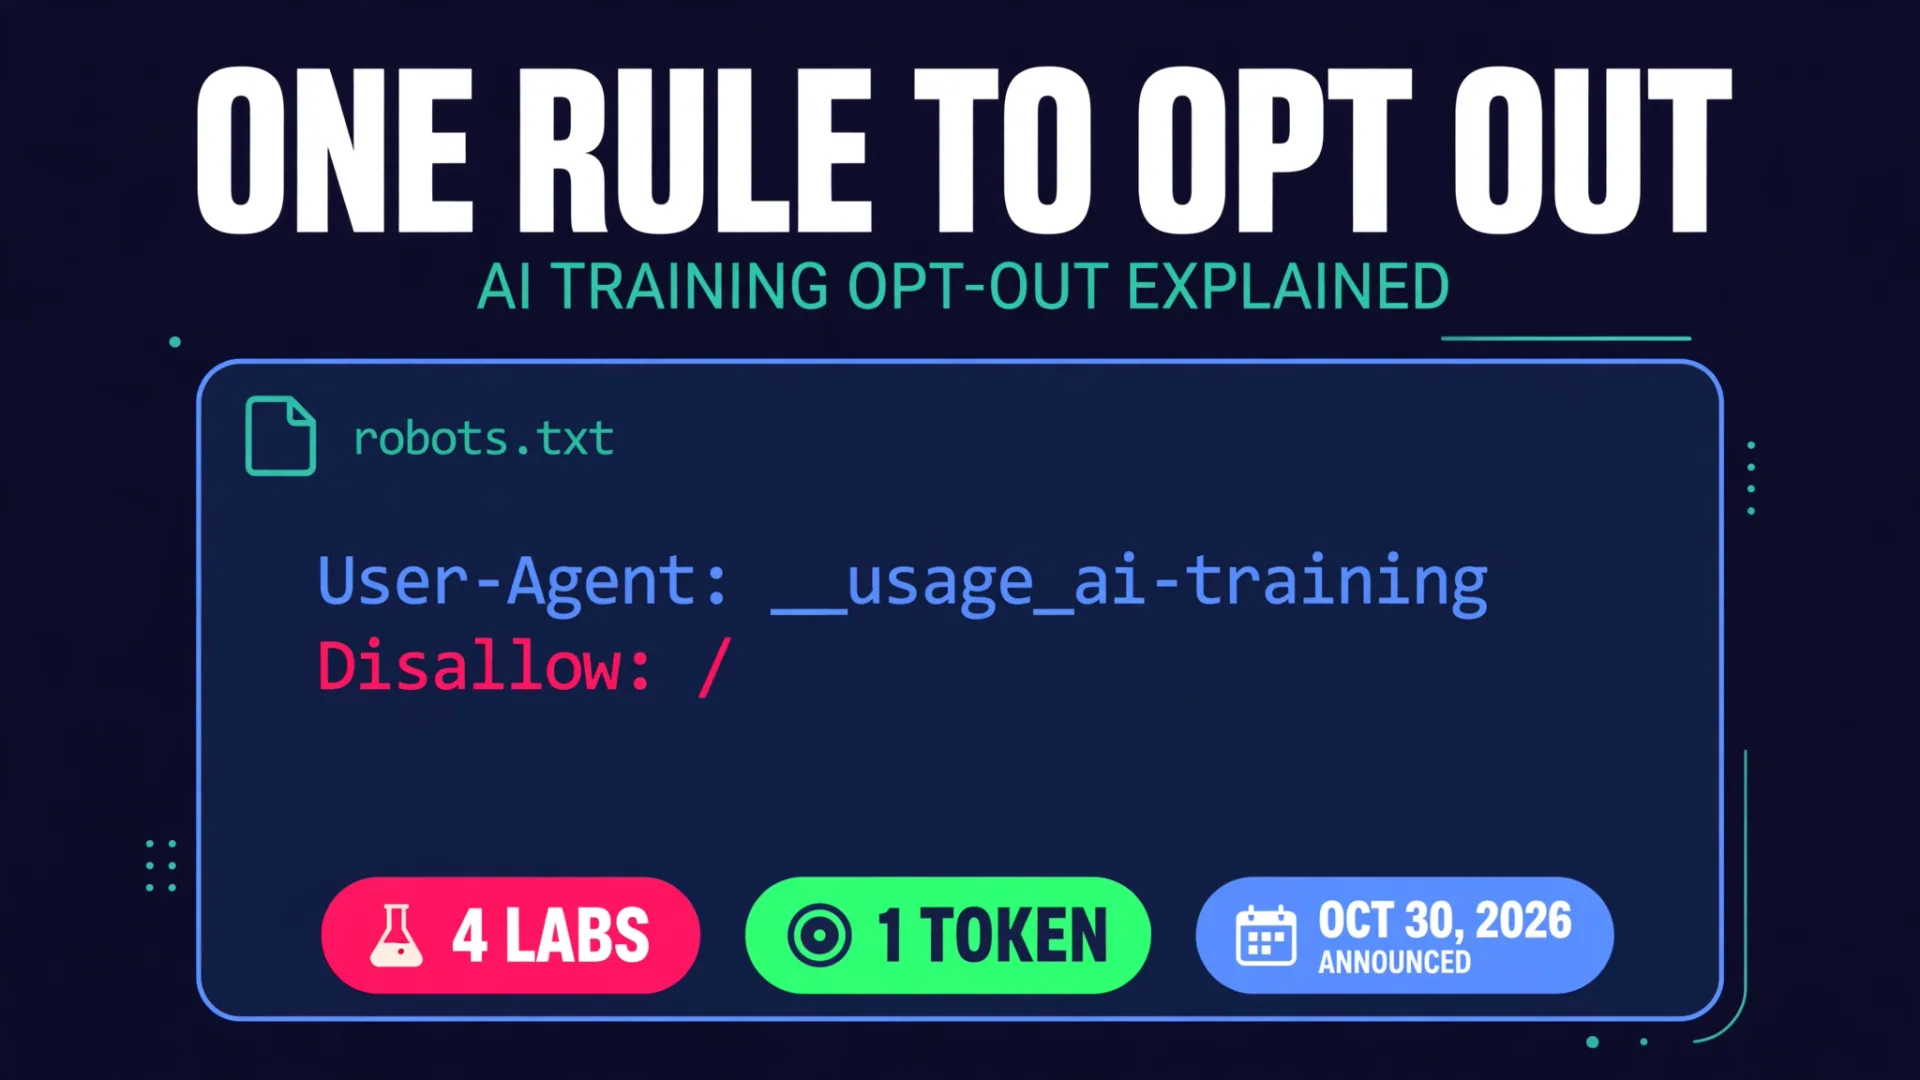
Le 30 octobre 2026, quatre des plus grands laboratoires d’IA ont fait quelque chose d’inhabituel : ils ont adopté la même règle. OpenAI, Google, Microsoft et Anthropic ont tous annoncé qu’ils honoreraient un jeton de robots.txt partagé, _usageai-training, qui permet à un site web de se retirer de l’entraînement IA en une seule étape. Jusqu’à présent, un éditeur qui voulait se retirer devait bloquer chaque robot d’indexation par nom, GPTBot, Google-Extended, ClaudeBot, et une liste croissante d’autres. Cette annonce condense cette corvée en une seule entrée.
Le problème réside dans le timing et les petits caractères. Seul Anthropic indique avoir déjà commencé à mettre en place le support. Microsoft commence le 1er février 2027. Google vise 2027. OpenAI indique « dans les mois à venir » sans date. Et le signal est volontaire, il ne couvre que la formation, et ne fait rien concernant le contenu déjà collecté ou entraîné. C’est donc une vraie étape de coordination, pas un interrupteur d’arrêt instantané.
Le verdict rapide
| Question | Réponse |
|---|---|
| Qu’a-t-il annoncé ? | Un a partagé robots.txt jeton de politique, _useai-training, pour se désister de l’entraînement IA |
| Annonce | 30 octobre 2026 |
| Soutenu par | OpenAI, Google, Microsoft et Anthropic |
| Le code | User-Agent : _usageai-training, puis Disallow : / |
| Un brouillon derrière | IETF Internet-Draft « Machine-Readable Training Preference Signal », par Kevin Kelley d’Anthropic, daté du 30 octobre 2026 |
| Statut de la conscription | Un projet individuel, non approuvé par l’IETF, sans statut officiel, expirant le 3 mai 2027 sauf mise à jour |
| Ce que c’est abordé | Entraînement IA uniquement, pas de crawling, de recherche ou réponses IA |
| Ce qu’il ne fait pas | Supprimer le contenu déjà collecté ou déjà entraîné dans un modèle |
| Qui peut l’utiliser | Tout propriétaire de site web, en ajoutant le jeton à robots.txt |
| Quoi garder pour l’instant | Vos règles existantes par entreprise, comme Google Extended, car le jeton partagé n’est pas encore en grande partie en ligne |
Le code exact
Ajoutez ce bloc à votre robots.txt si vous souhaitez vous retirer de la formation sur l’ensemble de votre site :
User-Agent: __usage_ai-training
Disallow: /
Pour se désinscrire de tout sauf un dossier, l’exemple de brouillon ajoute une ligne d’autorisation :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Deux détails comptent. Premièrement, le jeton doit correspondre exactement, à l’exception de la lettre en majuscule. Un groupe de User-Agent: * générique ne compte pas, et si aucun groupe ne nomme le jeton, le site n’a exprimé aucune préférence. Deuxièmement, vous pouvez vous désinscrire uniquement de certains dossiers au lieu de tout le site, en utilisant Disallow sur les chemins que vous souhaitez protéger.
Qui l’honore, et quand
| Entreprise | Ce qu’il dit | Synchronisation |
|---|---|---|
| Anthropic | A commencé à mettre en place la prise en charge du jeton partagé, en plus de ses contrôles existants | Déjà commencé, le déploiement entre services prend du temps |
| OpenAI | Respecterai un signal robots.txt partagé pour l’entraînement fondamental de l’IA générative, les contrôles de robotisation existants continueront de fonctionner | Dans les mois à venir, aucune date n’est donnée |
| Microsoft | Respectera la préférence d’entraînement, plus une préférence distincte pour l’ancrage IA, et des contrôles au niveau de la page | 1er février 2027, alors que les pages sont recrawlées |
| Prévoit de traiter une dérogation comme si l’éditeur avait interdit Google-Extended, à moins que Google-Extended ne soit activé directement | Objectifs pour 2027 |
Microsoft va plus loin. Elle ajoute un paramètre d’entraînement au niveau de la page et un paramètre de mise à la terre séparé, qui décide si une page peut fournir des réponses IA en direct dans Bing, Copilot et Microsoft 365. Une troisième option, DisallowExtended, permet la mise à la terre dans les propres produits de Microsoft mais pas dans les services de mise à la terre qu’il vend à d’autres entreprises. Microsoft précise également qu’une page peut porter une méta-balise Bingbot, ai-training :disallow, ou un en-tête X-Robots-Tag, qui remplace robots.txt. Les sites qui s’appuient sur les anciennes balises NoArchive et NoCache de Bing devraient passer aux nouvelles préférences d’ici le 1er mars 2027, après quoi les anciennes balises ne seront plus lues comme une préférence d’entraînement ou de mise à la terre.
Les détails de Google méritent d’être lus attentivement. Si vous utilisez le jeton partagé pour vous désinscrire et que vous ne mentionnez pas Google-Extended, Google prévoit de considérer cela comme un blocage de Google-Extended. Mais si vous autorisez explicitement Google-Extended, Google affirme que ce site reste éligible à apparaître et à gagner des clics via le grounding dans les réponses de l’application Gemini. En d’autres termes, le choix de désinscription et celui de visibilité sont liés, donc configurez les deux délibérément.
Dates clés, comptabilisées à partir de l’annonce
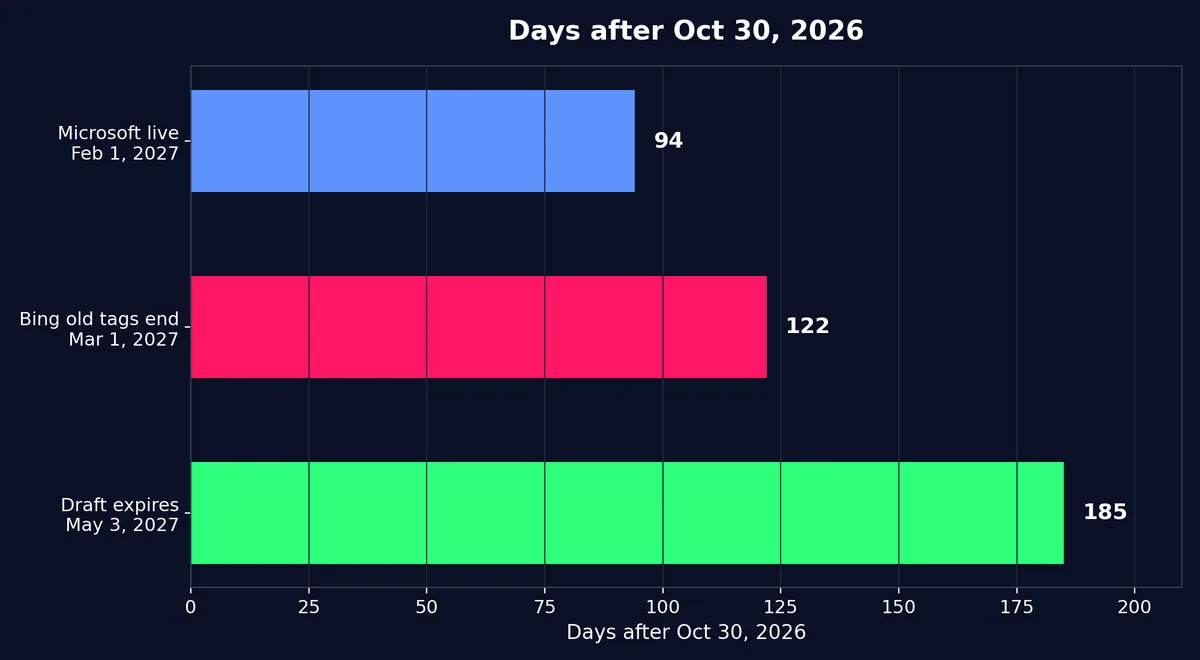
| Date | Que se passe-t-il | Quelques jours après le 30 octobre 2026 |
|---|---|---|
| 30 octobre 2026 | Jeton partagé annoncé par les quatre laboratoires | 0 |
| 1er février 2027 | Microsoft commence à respecter les nouvelles préférences | 94 |
| 1er mars 2027 | Bing cesse de lire les anciennes balises NoArchive et NoCache comme préférences d’entraînement ou de mise à la terre | 122 |
| 3 mai 2027 | Le brouillon de l’IETF expire à moins qu’il ne soit mis à jour | 185 |
| 2027, aucun mois donné | Google vise à prendre en charge ce jeton | Pas encore datant |
| Mois à venir, aucune date donnée | OpenAI vise à implémenter le signal | Pas encore datant |
Les décomptes de jours sont de simples calculs de calendrier à partir du 30 octobre 2026, et non des affirmations de fournisseurs. Les deux éléments non datés, Google et OpenAI, sont la raison pour laquelle les éditeurs ne devraient pas considérer l’annonce comme une couverture en direct aujourd’hui.
Ce qu’il contrôle, et ce qu’il ne contrôle pas
| Question | Réponse |
|---|---|
| Est-ce que cela empêche l’entraînement de l’IA sur mon contenu ? | C’est son but, une fois que chaque laboratoire l’a mis en œuvre |
| Est-ce qu’il arrête de ramper ? | Non. Le brouillon précise que le jeton n’est pas une directive pour le comportement de crawling, donc les bots peuvent toujours récupérer une page |
| Est-ce que cela empêche l’indexation par recherche ? | Non. Microsoft précise que se désinscrire de la formation n’affecte pas l’éligibilité aux résultats réguliers de Bing |
| Est-ce que cela empêche les réponses IA de citer mes pages ? | Non, sauf via le contrôle de mise à la terre séparé de Microsoft. L’entraînement et la mise à la terre sont des usages différents |
| Est-ce que cela supprime les données d’entraînement passées ? | Non. Il ne couvre que les futures séances d’entraînement, pas le contenu déjà collecté ou déjà en poids de modèle |
| Est-ce que ça fixe les grattoirs qui l’ignorent ? | Non. Elle est volontaire, sans pouvoir d’application, donc les racleurs non conformes peuvent l’ignorer |
Cette dernière limite est celle que les éditeurs rencontrent sans cesse. Le jeton est un mécanisme de coordination, pas un contrôle de sécurité. Il ne fonctionne qu’avec les entreprises qui choisissent de le suivre, et le projet lui-même n’a pas de statut formel pour l’IETF. Cela ne le rend pas inutile, mais cela signifie que vous devez continuer à surveiller la conformité crawler par crawler, et maintenir vos contrôles existants en place jusqu’à ce que le token partagé soit effectivement respecté.
Que faire maintenant
Ajoutez le jeton maintenant, cela ne coûte rien. Le bloc à deux lignes est déjà publié, et l’ajouter tôt signifie que vous êtes couvert à l’arrivée du support, sans attendre la date de déploiement de chaque laboratoire.
Conservez vos règles existantes. Google-Extended, GPTBot, ClaudeBot et vos autres règles par entreprise restent ce qui fonctionne aujourd’hui. Ne les supprimez pas au profit d’un jeton qui n’est pas encore en grande partie actif.
Décidez séparément de l’entraînement et de la mise à la terre. Si vous utilisez les produits Microsoft, définissez la préférence d’entraînement et la préférence de mise à la terre comme deux choix, pas une seule. Si la visibilité de l’application Gemini vous intéresse, décidez explicitement de Google-Extended au lieu de laisser le token partagé décider par défaut.
Vérifiez les tags Bing avant le 1er mars 2027. Si votre site dépend de NoArchive ou NoCache, passez aux nouvelles préférences Microsoft avant cette date limite.
Attendez-vous à un brouillon de suivi. Le brouillon actuel expire le 3 mai 2027 sauf s’il est mis à jour, et le groupe de travail comprend Meta, Cloudflare, la Common Crawl Foundation, News Corp, le Financial Times, la BBC, l’Electronic Frontier Foundation et Creative Commons. La norme peut évoluer au fur et à mesure que ces participants se prononcent, considérez donc la formulation d’aujourd’hui comme un point de départ, et non comme une loi finale.
Pour les équipes qui développent des produits d’IA, la leçon est plus large qu’un robots.txt fichier. Les préférences d’entraînement, les préférences de grounding et la visibilité dans la recherche sont désormais trois leviers distincts, et leur alternance coûte soit le contrôle des données, soit le trafic. CodeMyPixel développe des agents IA et aide les entreprises à engager une agence d’automatisation IA pour intégrer l’IA dans de vrais flux de travail, avec les garde-fous et l’évaluation qu’un modèle brut ou une seule ligne de robots.txt ne fournit pas. Si vous comparez les modèles ouverts aux modèles fermés, notre analyse des poids ouverts Mistral Large 4 et notre explication Gemini 4 Carbon montrent comment l’accès, la licence et le contrôle diffèrent en pratique.
Lequel choisir
Choisissez le jeton partagé ainsi que vos anciennes règles si vous voulez une couverture maximale aujourd’hui. Le jeton vous prépare pour 2027, les anciennes règles vous protègent désormais.
Choisissez l’option d’exclusion de l’entraînement uniquement si vous souhaitez que votre contenu soit exclu de l’entraînement futur du modèle, mais que vous souhaitez toujours du trafic de recherche et une visibilité des réponses IA. N’oubliez pas que ce jeton seul ne bloque pas les réponses IA.
Choisissez l’option entraînement et mise à la fin sur Microsoft si vous voulez aussi que vos pages soient retirées des réponses IA en temps réel dans Bing, Copilot et Microsoft 365. C’est un paramètre Microsoft séparé, pas une partie du jeton partagé lui-même.
Choisissez de ne pas opter si votre entreprise bénéficie de l’exposition à l’entraînement IA, ou si vous souhaitez rester éligible à l’ancrage et aux clics de l’application Gemini, et que vous êtes à l’aise avec l’utilisation de votre contenu pour la formation. C’est un choix commercial, pas un défaut, alors faites-le délibérément.
Qu’est-ce que le jeton partagé d’exclusion de l’entraînement IA ?
Il s’agit d’un jeton de politique robots.txt, _usageai-training, annoncé le 30 octobre 2026, que OpenAI, Google, Microsoft et Anthropic déclarent honorer. Un propriétaire de site web ajoute User-Agent : _usageai-training suivi de Disallow : / pour se désinscrire de la formation IA, au lieu de bloquer le robot d’indexation de chaque entreprise par nom.
Est-ce que le fait de se désinscrire empêche Google ou Bing d’indexer mon site ?
Non. Le jeton couvre uniquement l’entraînement par IA, pas l’exploration ou la recherche. Microsoft affirme que se désinscrire de l’entraînement n’affecte pas l’éligibilité aux résultats réguliers de Bing, et le projet précise que le jeton n’est pas une directive pour le comportement d’exploration.
Quand le jeton partagé prend-il effectivement effet ?
Anthropic a déjà commencé à le mettre en œuvre. Microsoft commence le 1er février 2027. Google vise 2027 sans mois précisé. OpenAI annonce qu’il mettra en œuvre le signal dans les mois à venir sans date précisée. D’ici là, vos règles par entreprise actuelles sont ce qui fonctionne aujourd’hui.
Le jeton supprime-t-il mon contenu des modèles déjà entraînés dessus ?
Non. Mettre à jour robots.txt ne supprime pas le contenu déjà collecté dans les ensembles de données ou déjà entraîné dans les poids des modèles. Le jeton ne couvre que les futures sessions d’entraînement.
Est-ce une norme officielle du web ?
Non, pas encore. Il s’agit d’un brouillon Internet individuel de l’IETF, « Machine-Readable Training Preference Signal », par Kevin Kelley d’Anthropic, soumis au groupe de travail sur les préférences IA de l’IETF. Le datatracker de l’IETF note qu’un brouillon individuel n’est pas approuvé par l’IETF et n’a pas de statut formel, et que le brouillon expire le 3 mai 2027 à moins qu’il ne soit mis à jour.
Mon entreprise doit-elle se retirer de la formation en IA ?
Désinscrivez-vous si le contrôle de l’utilisation future de la formation compte plus pour vous que toute exposition que cela pourrait apporter, et conservez vos anciennes règles de robot d’exploration jusqu’à ce que le jeton partagé soit en ligne. Restez inscrit, ou définissez explicitement une autorisation Google Extended, si vous souhaitez rester éligible à la mise à la terre de l’application Gemini et aux clics. Décidez séparément de la formation et de la mise à la terre de l’application, et examinez le choix lorsque la date de Microsoft sera prévue au 1er février 2027.
- robots.txt
- ai training opt-out
- openai
- microsoft
- anthropic
- ai policy