IA6 min de lecturePar JH Akash
API OpenAI Decisions expliquée : ce que signifie l’aviation générale pour les agents d’IA
OpenAI a rendu son API Decisions généralement disponible le 22 octobre 2026. Propulsé par GPT-6 Luna, il restitue des probabilités, des choix et des scores jusqu’à 10 fois plus rapides, à partir de 0,10 $ par 1M de jetons. Prix, benchmarks et quand l’utiliser.
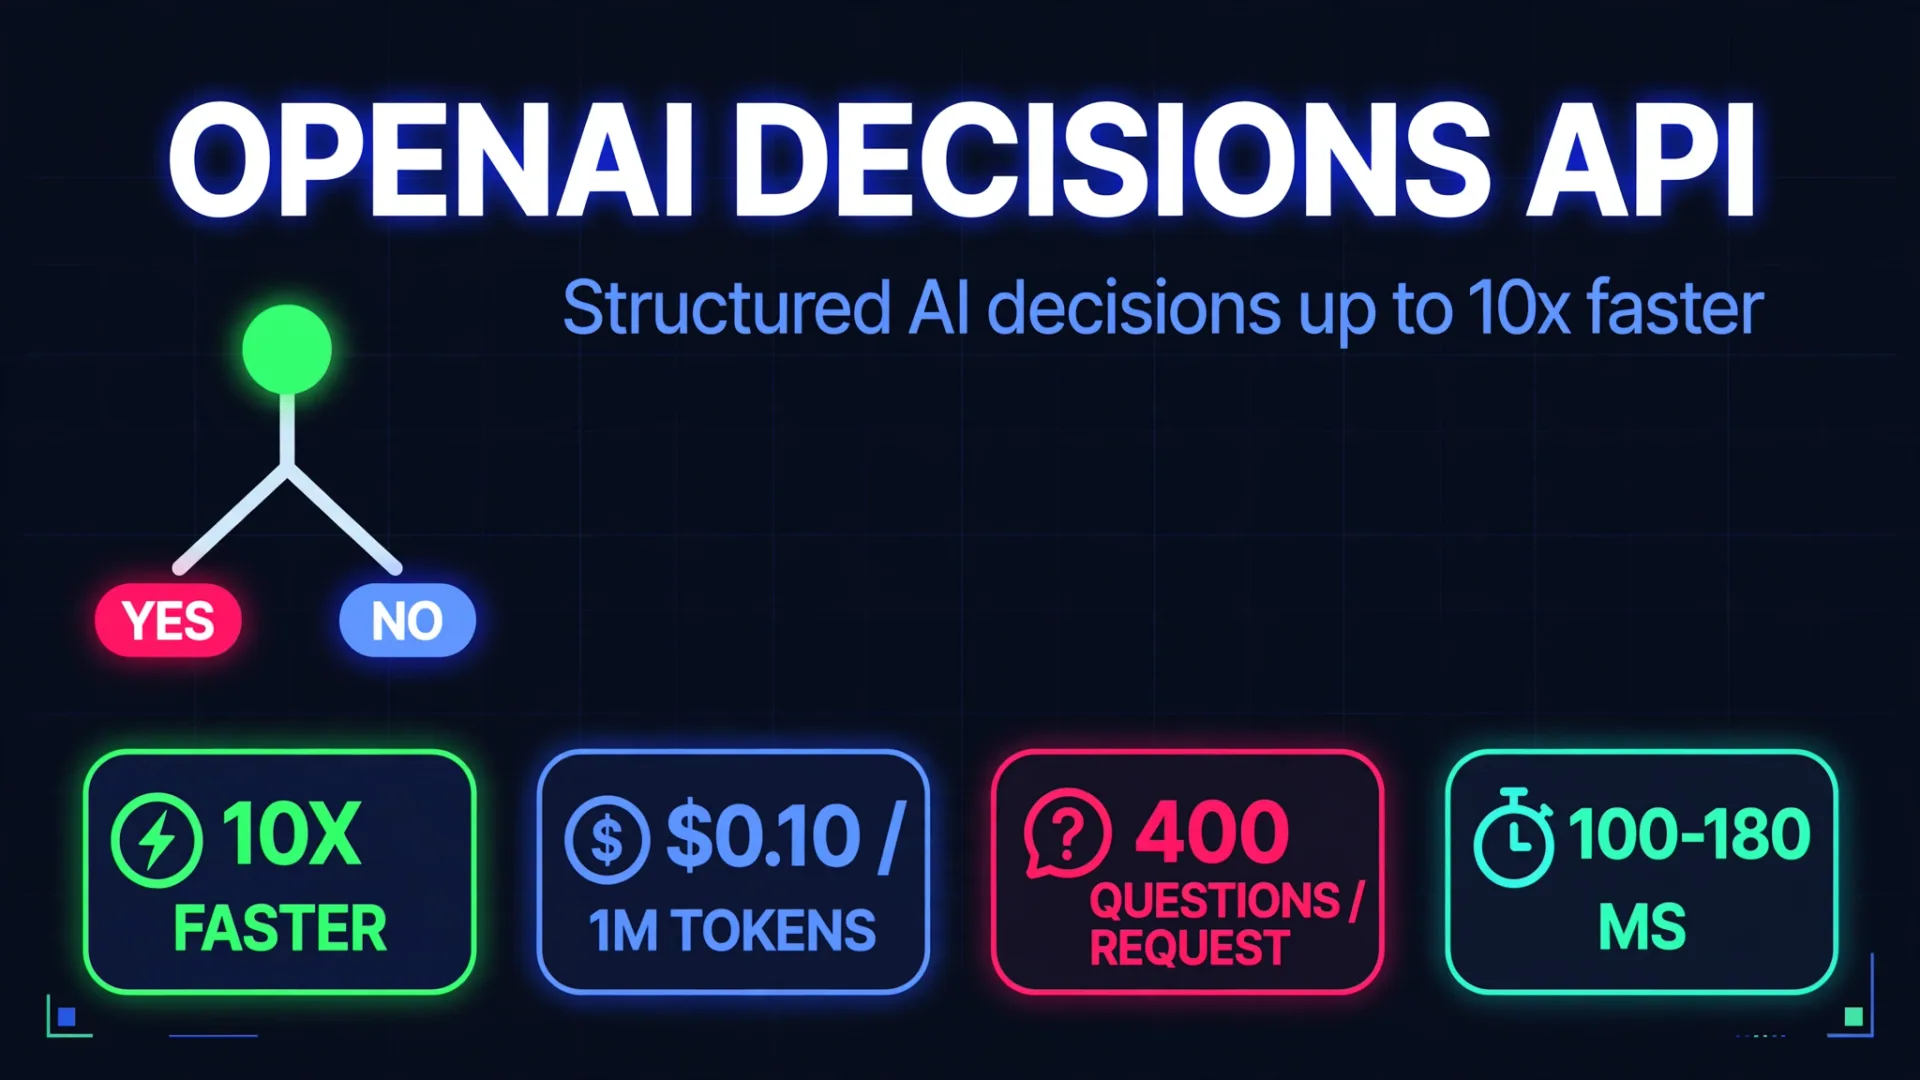
OpenAI a rendu son API Decisions généralement accessible, une interface développeur propulsée par GPT-6 Luna qui restitue des probabilités, des choix et des scores au lieu de paragraphes de texte. OpenAI affirme pouvoir délivrer ces décisions jusqu’à 10 fois plus rapidement que GPT-6 Luna via l’API Responses, avec des prix d’entrée à partir de 0,10 $ pour 1 million de tokens. Voici ce qui a changé lors de la sortie de l’Assemblée Générale du 22 octobre 2026, son coût et la question de savoir si votre application doit l’utiliser.
Le verdict rapide : API Réponses vs API Décisions
| Aspect | API Réponses | Decisions API |
|---|---|---|
| Production | Texte ouvert | Probabilité, choix ou score |
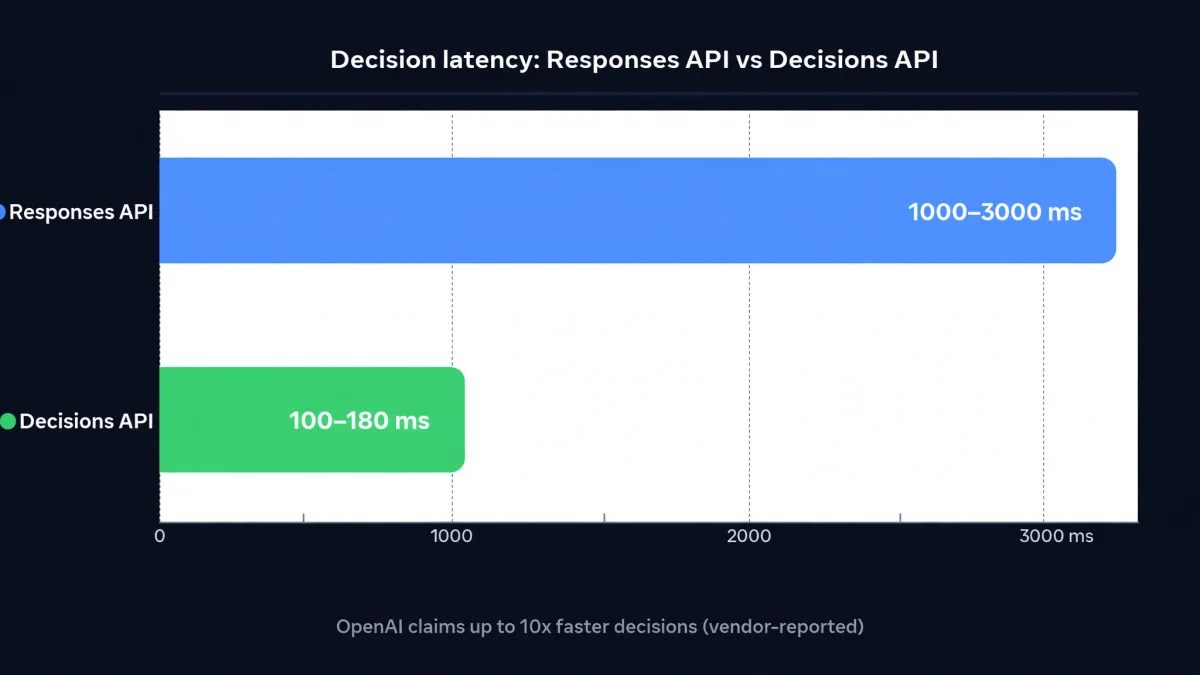
| Latence typique des décisions | 1 à 3 secondes | 100 à 180 ms (rapporté par le fournisseur) |
| Tarification des intrants | Taux Luna standard GPT-6 | 0,10 $ par 1M de jetons d’entrée |
| Le meilleur pour | Raisonnement, explication, utilisation des outils | Classification à haut volume, routage, notation |
Qu’est-ce qui a changé dans la version GA (22 octobre 2026)
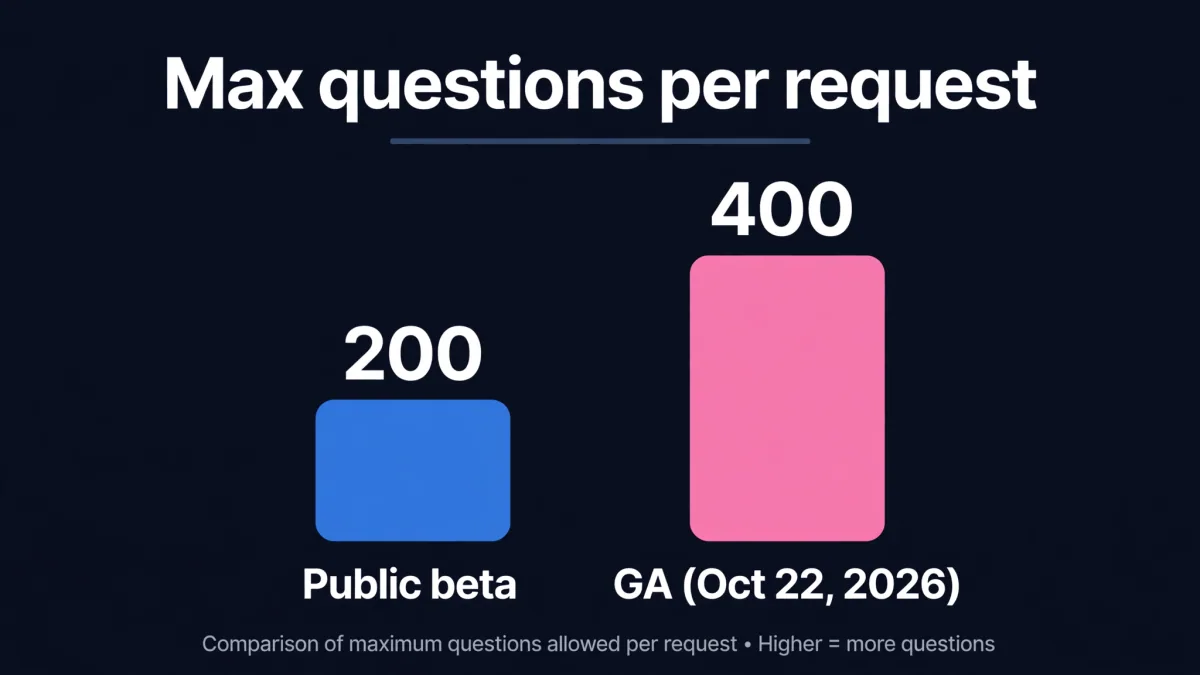
L’API Decisions avait une bêta publique avant l’annonce de la GA, et la version généralement disponible double la limite de clés et ajoute des fonctionnalités de production :
- 400 questions par demande, contre 200 dans la bêta publique
- Cache par prompts, avec une entrée mise en cache au prix de 0,01 $ par 1M de jetons
- Intégration native GPT-Live, permettant aux applications vocales en direct de déclencher des décisions à l’arrivée des transcriptions
- Entrée JSON structurée, plus des images dans le texte instructions ou des instructions individuelles des questions
- Résidence d’inférence aux États-Unis et en Europe, avec une rétention de données zéro disponible pour les clients éligibles
- Un point de terminaison dédié
/v1/decisionset un Terrain de jeu de décision pour expérimenter avant l’intégration
Comment cela fonctionne : les trois types de décision
Les développeurs fournissent trois éléments : les informations à évaluer, les questions à répondre et le format de sortie autorisé. L’API prend en charge trois types de décision.
| Type de décision | Ce qu’il rend | Exemple |
|---|---|---|
| Prédicat | Probabilité qu’une condition soit vraie | Estimez si un colis semble endommagé |
| Choix | Une sélection parmi des options prédéfinies | Acheminez un ticket de support vers la facturation ou le support technique |
| Partition | Score contre les niveaux ordonnés | Classez un problème comme mineur, modéré ou grave |
Pour les questions de choix et de score, l’API renvoie également des informations de probabilité et une mesure de confiance, permettant ainsi aux équipes d’automatiser les cas de confiance et d’envoyer les cas incertains à un évaluateur humain. Une réponse structurée ne garantit pas une décision correcte : OpenAI et ses clients insistent tous deux sur le fait que les développeurs doivent tester leurs questions, mesurer la précision et fixer des seuils raisonnables.
Tarification
| Composant | Prix |
|---|---|
| Entrée non mise en cache | 0,10 $ par 1M de jetons |
| Entrée mise en cache | 0,01 $ par 1M de jetons |
| Jetons de sortie | Pas de charge de jeton de sortie séparé |
Les écritures de cache, les primes de traitement régionales et les règles de tarification à long contexte peuvent influencer la facture finale, donc consultez le guide officiel des prix avant d’estimer les coûts de production.
L’histoire de la vitesse, en chiffres
Le responsable produit API d’OpenAI, Nikunj Handa, a déclaré à TechCrunch que l’entreprise avait réduit les temps de réponse aux décisions d’une à trois secondes à environ 100 à 180 millisecondes. OpenAI affirme que l’API peut être jusqu’à 10 fois plus rapide que GPT-6 Luna via l’API Responses, et estime qu’une optimisation supplémentaire pourrait atteindre environ 60 millisecondes.
Les premiers clients ont publié leurs propres résultats. Considérez ces résultats comme des références rapportées par les clients, et non comme des benchmarks indépendants :
| Entreprise | Résultat rapporté |
|---|---|
| Boîte | Sélection d’itinéraires environ cinq fois plus rapide via 30 certificats d’assurance, avec une précision correspondant à l’approche API de Responses |
| Datadog | Une latence 40 fois plus rapide au 95e percentile pour un flux de travail de notation à risque de commande comparé aux modèles frontières disponibles |
| Parle | Le temps entre les actions de l’IA est passé de 1,4 seconde à 0,13 seconde, soit une amélioration de plus de 90 % |
La concurrence avance aussi
OpenAI n’est pas seul dans la course au modèle décisionnel. TypeSafe, la startup derrière le modèle de décision Jev, a récemment atteint une valorisation d’environ 7,6 milliards de dollars et a développé Jev grâce à un support d’image et une prise de décision conditionnelle. Liquid (D1 Ultra) et Base Lab (Elephant-1) commercialisent également des modèles concurrents. Sur deux benchmarks de décision publique rapportés dans la couverture du lancement, TypeSafe Jev s’est classé 7e et 3e tandis que le modèle de décision d’OpenAI s’est classé 8e et 14e. Les classements évoluent à mesure que les benchmarks se mettent à jour, donc considérez-les comme un instantané, et non comme un verdict final.
Lequel devriez-vous utiliser ?
Utilisez l’API Décisions lorsque votre charge de travail est à grand volume, reproductible et sensible à la latence : classification des transactions, routage des tickets de support, évaluation du risque ou décision de la prochaine action d’un agent IA. Restez avec l’API Réponses lorsque vous avez besoin d’explications, de génération ouverte, de chaînes de raisonnement ou d’utilisation flexible d’outils. De nombreux systèmes de production utilisent les deux, les décisions étant gérées par l’API Décisions et tout le reste sur l’API Réponses.
Si vous construisez des flux de travail d’agents, c’est exactement ce type de plomberie qui compte. CodeMyPixel développe des solutions personnalisées de développement d’agents IA et des systèmes complets d’automatisation IA pour des équipes qui ont besoin que des modèles fassent un vrai travail, pas seulement pour générer du texte. Pour le contexte des modèles, consultez nos analyses de GPT-6 Astra et Claude Opus 5.5.
FAQ
Qu’est-ce que l’API Decisions d’OpenAI ?
Une interface développeur qui utilise GPT-6 Luna pour évaluer le texte, les images et les données structurées, en retournant des probabilités, des choix prédéfinis ou des scores sur lesquels les applications peuvent agir directement.
L’API Decisions est-elle vraiment dix fois plus rapide ?
OpenAI indique qu’il peut être jusqu’à 10 fois plus rapide que GPT-6 Luna via l’API Responses. C’est un maximum rapporté par le fournisseur, pas une garantie. La latence réelle dépend de la taille de l’entrée, de la complexité de la question, des conditions réseau et de la charge de travail. Les résultats rapportés par les clients (Box à 5x, Datadog à 40x p95, Speak qui réduit 1,4s à 0,13s) sont spécifiques à leurs évaluations.
Combien coûte l’API Decisions ?
La tarification de base publiée est de 0,10 $ par 1 million de jetons d’entrée non mis en cache et de 0,01 $ par 1 million de jetons d’entrée mis en cache, sans frais séparés pour les jetons de sortie. Les écritures de cache et les primes régionales peuvent ajouter un coût.
L’API Decisions peut-elle remplacer l’API Responses ?
Ce n’est pas pour toutes les tâches. Elle est conçue pour une classification, une sélection et un notage ciblés. L’API Réponses reste le bon choix pour la génération de texte ouverte, le raisonnement et les flux de travail pilotés par outils.
Quand l’API Decisions est-elle devenue généralement disponible ?
22 octobre 2026, après une bêta publique. La version GA a doublé la limite de questions par requête, passant de 200 à 400, et ajouté la mise en cache par prompts, l’intégration native GPT-Live et une entrée JSON structurée.
- openai decisions api
- gpt-6 luna
- ai agents
- openai api pricing
- llm latency