Outils IA et mises à jour8 min de lecturePar JH Akash
GPT-6.1 Sol contre Claude Sonnet 5.5 : Le duel du cheval de bataille à 2 $
Deux modèles d’IA de milieu de gamme ont été lancés à l’intervalle d’une journée, tous deux à 2 $/10 $ par million de tokens. Voici comment GPT-6.1 Sol et Claude Sonnet 5.5 se comparent en termes de benchmarks, prix, vitesse et sécurité.
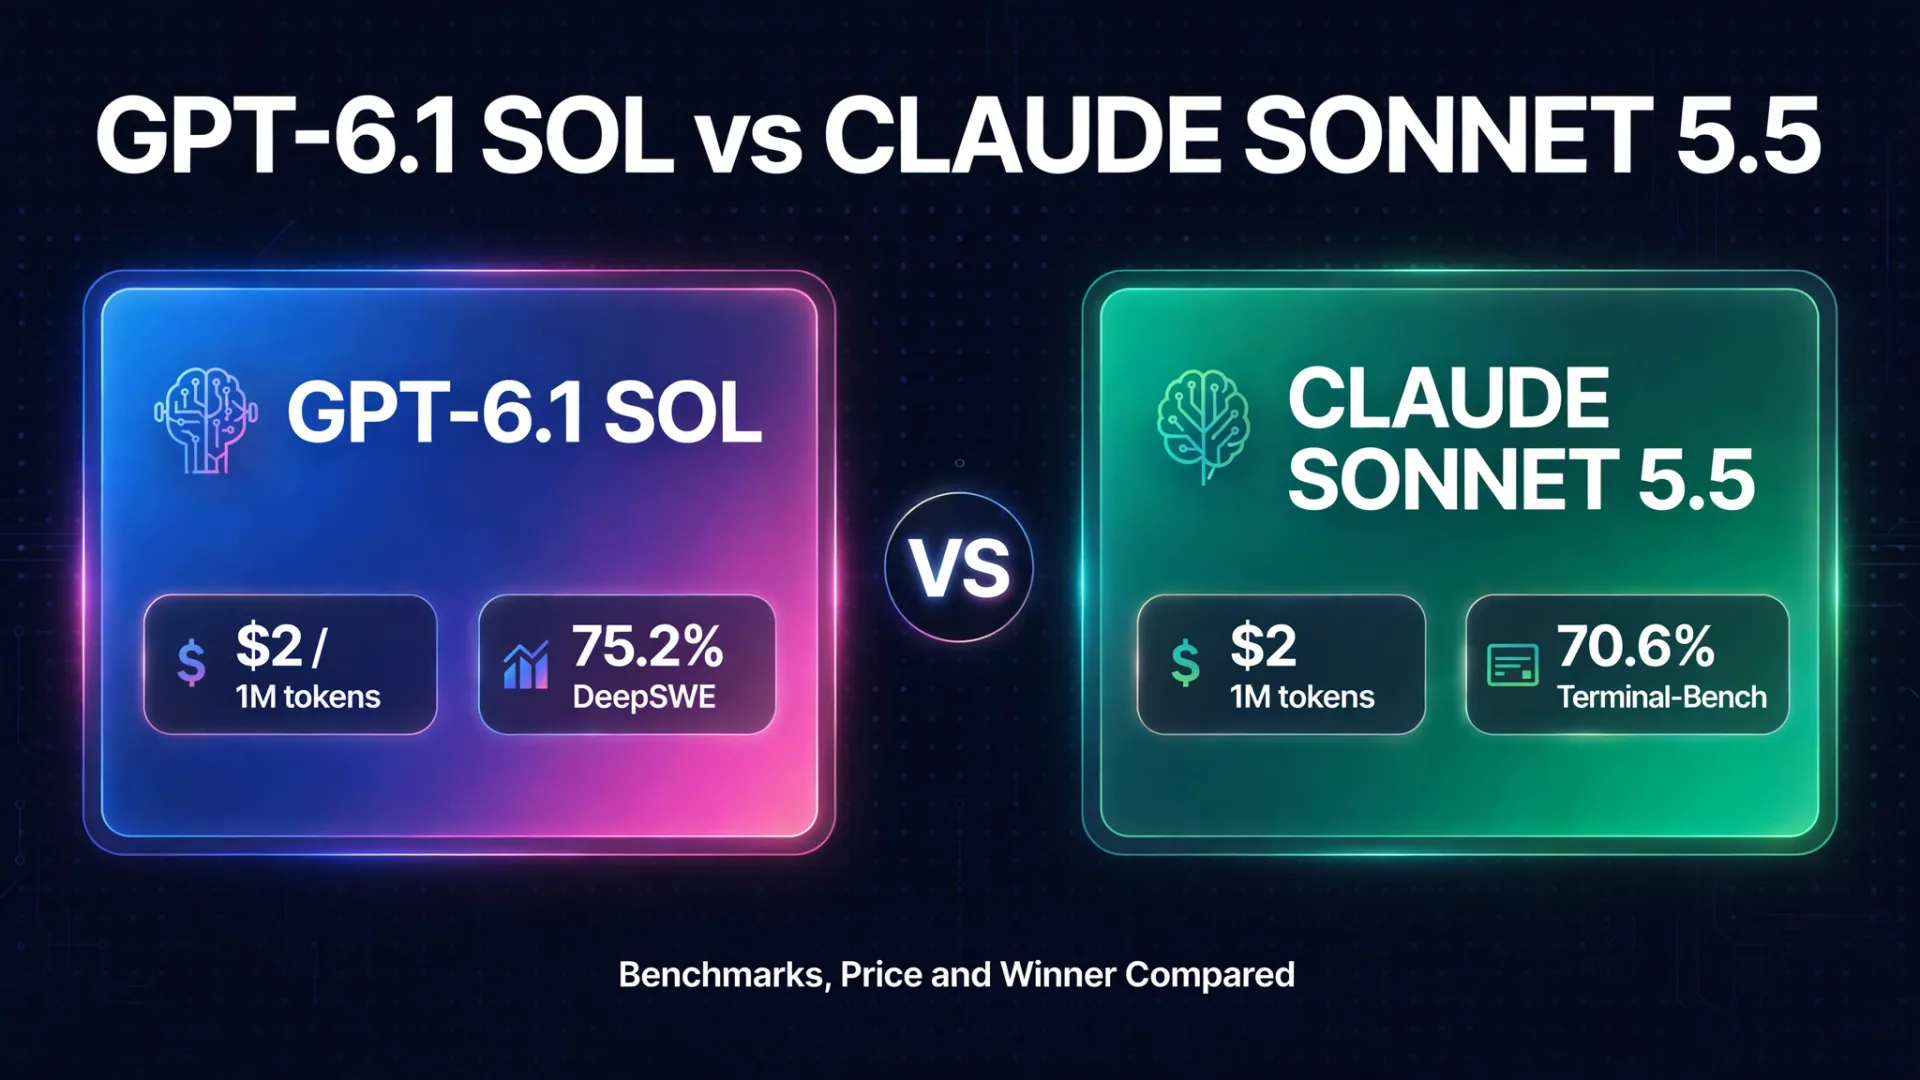
En moins de 24 heures, OpenAI et Anthropic ont tous deux lancé leurs nouveaux modèles d’IA de milieu de gamme : GPT-6.1 Sol lors du DevDay le 29 septembre, et Claude Sonnet 5.5 un jour plus tôt, le 28 septembre. Les deux sont proposés exactement 2 $ par million de jetons d’entrée et 10 $ par million de tokens de sortie. Tous deux promettent des performances quasi phare pour une fraction du coût.
Alors, lequel devriez-vous réellement utiliser ? Nous avons comparé les prix, les benchmarks, la rapidité et les petits caractères.
Le verdict rapide
| GPT-6.1 Sol | Claude Sonnet 5.5 | |
|---|---|---|
| Lancement | 29 sept. 2026 (OpenAI DevDay) | 28 sept. 2026 |
| Prix d’entrée | Jetons de 2 $ / 1 million | Jetons de 2 $ / 1 million |
| Prix de production | Jetons de 10 $ / 1 million | Jetons de 10 $ / 1 million |
| Entrée mise en cache | 0,10 $ / 1M | 0,20 $ / 1M |
| Fenêtre de contexte | 1,05 million de jetons | 1M de jetons |
| Sortie maximale | 128K jetons | 128K jetons |
| Le meilleur à | Codage agentique, utilisation informatique, longues exécutions d’agents | Code quotidien, corrections de bugs, documents |
| Vitesse | Option ultraFast : jusqu’à 300 jetons/seconde | Sortie 30 %+ plus rapide que le Sonnet 5 |
| Histoire de sécurité | GPT-6.1 Astra a été mis à la ferraille la veille pour cause de sécurité | Premier sonnet avec les protections cybernétiques de la frontière |
Prix : identique sur le papier, différent en pratique
Les tarifs principaux sont à égalité parfaite avec 2 $ d’entrée et 10 $ de sortie par million de jetons. La différence se manifeste dans le cache, qui est ce qui détermine réellement votre facture sur les tâches longues d’agent.
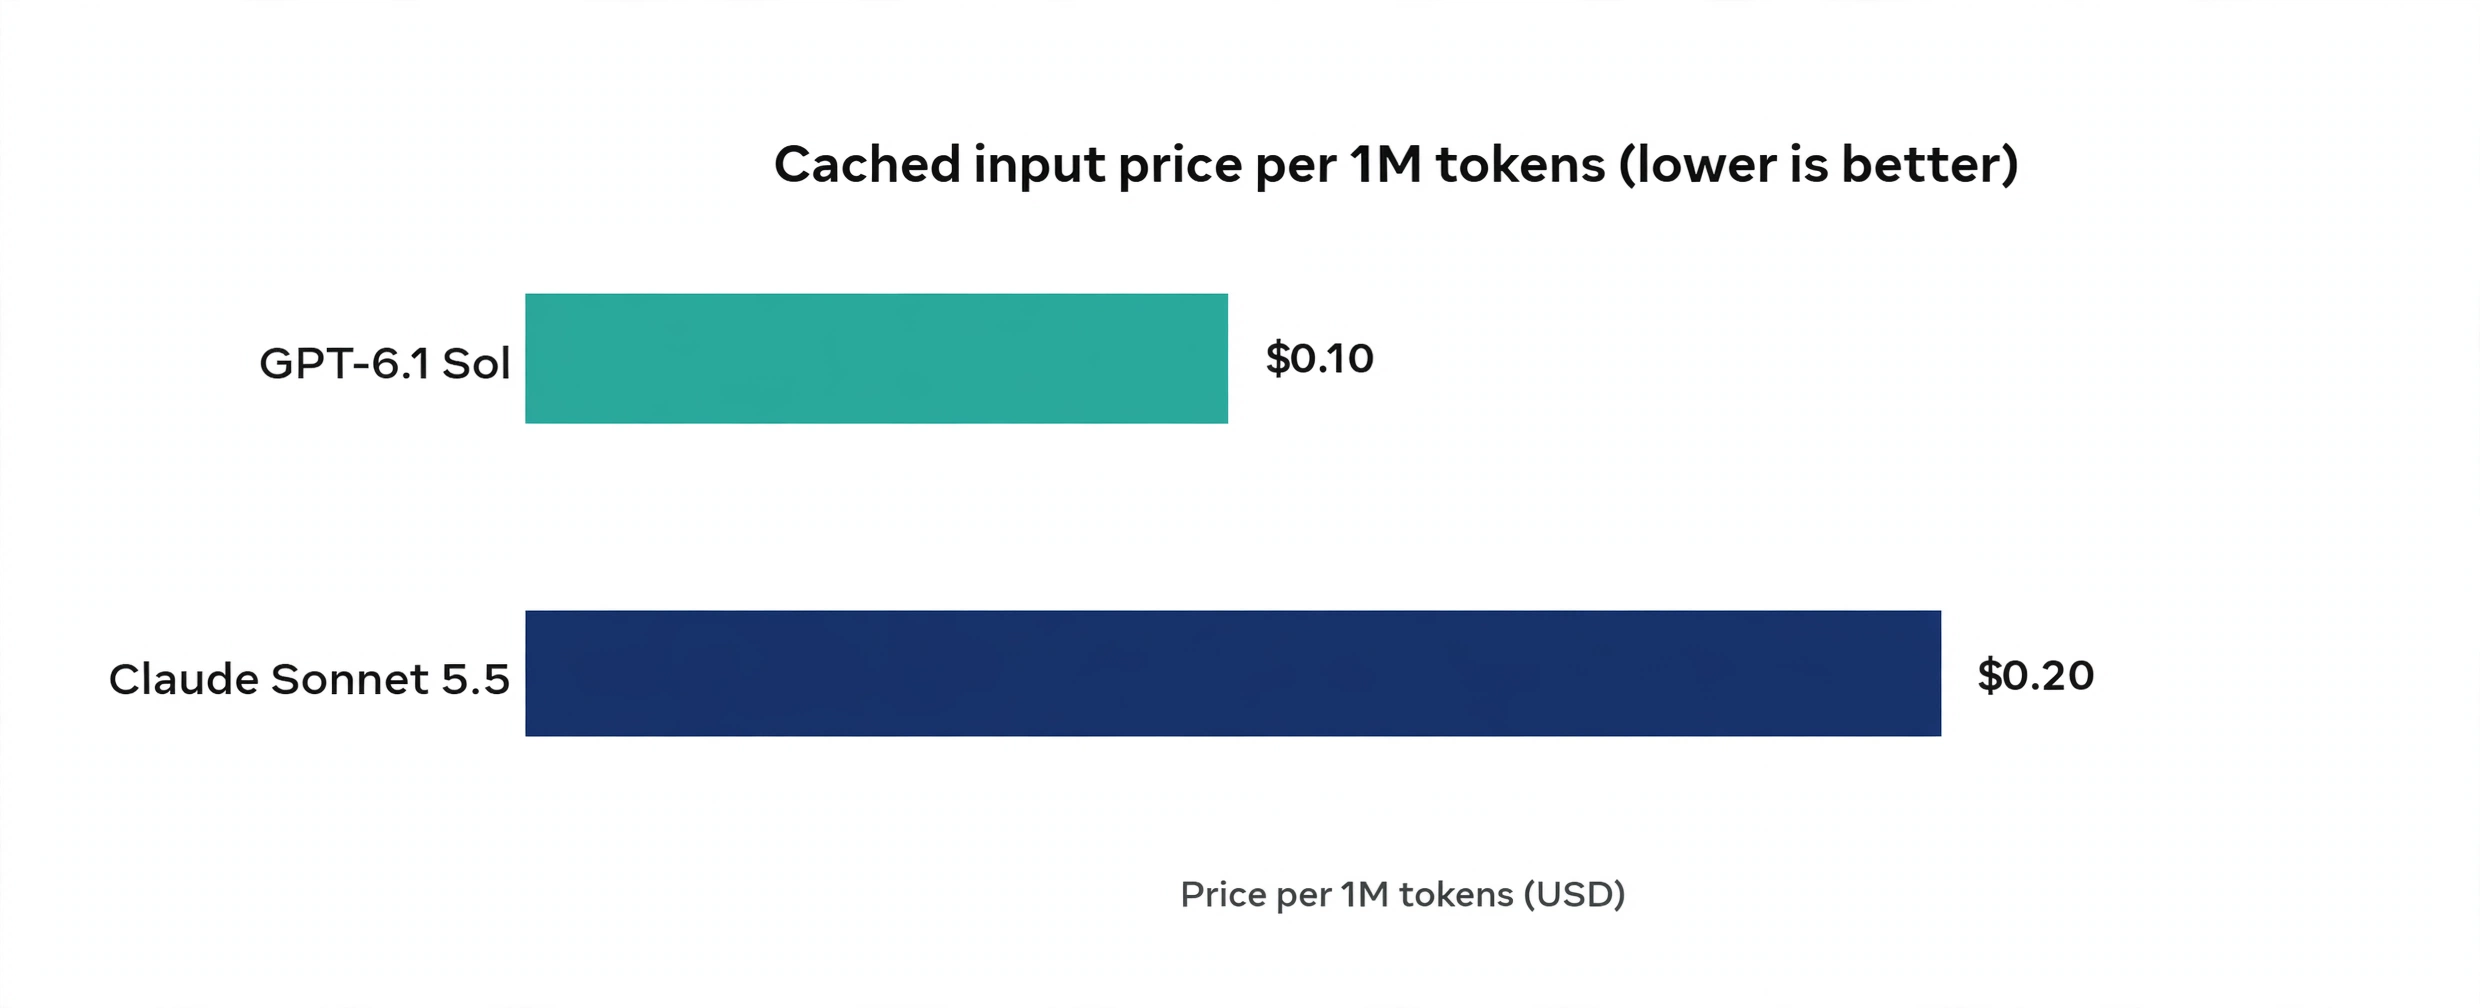
GPT-6.1 Sol facture 0,10 $ par million de jetons d’entrée mis en cache, soit la moitié des 0,20 $ du Sonnet 5.5. Lorsqu’un agent IA réutilise le même contexte de projet sur des dizaines d’itérations, cet écart s’accumule rapidement. OpenAI l’appelle une réduction de 95 % sur la tarification standard des entrées, et pour les charges d’agent à forte réutilisation du contexte, Sol est nettement moins cher.
Un hic du côté OpenAI : les requêtes à long contexte supérieures à 272K jetons d’entrée coûtent plus cher, et les niveaux de traitement premium modifient le prix. Du côté Anthropic, les écritures de cache coûtent 2,50 $ par million, donc la première écriture d’un grand contexte n’est pas gratuite non plus.
Références : qui gagne dans quoi
Tous les scores ci-dessous sont rapportés par les fournisseurs. Considérez-les comme des directives, pas comme une évangile.
Codage agentique
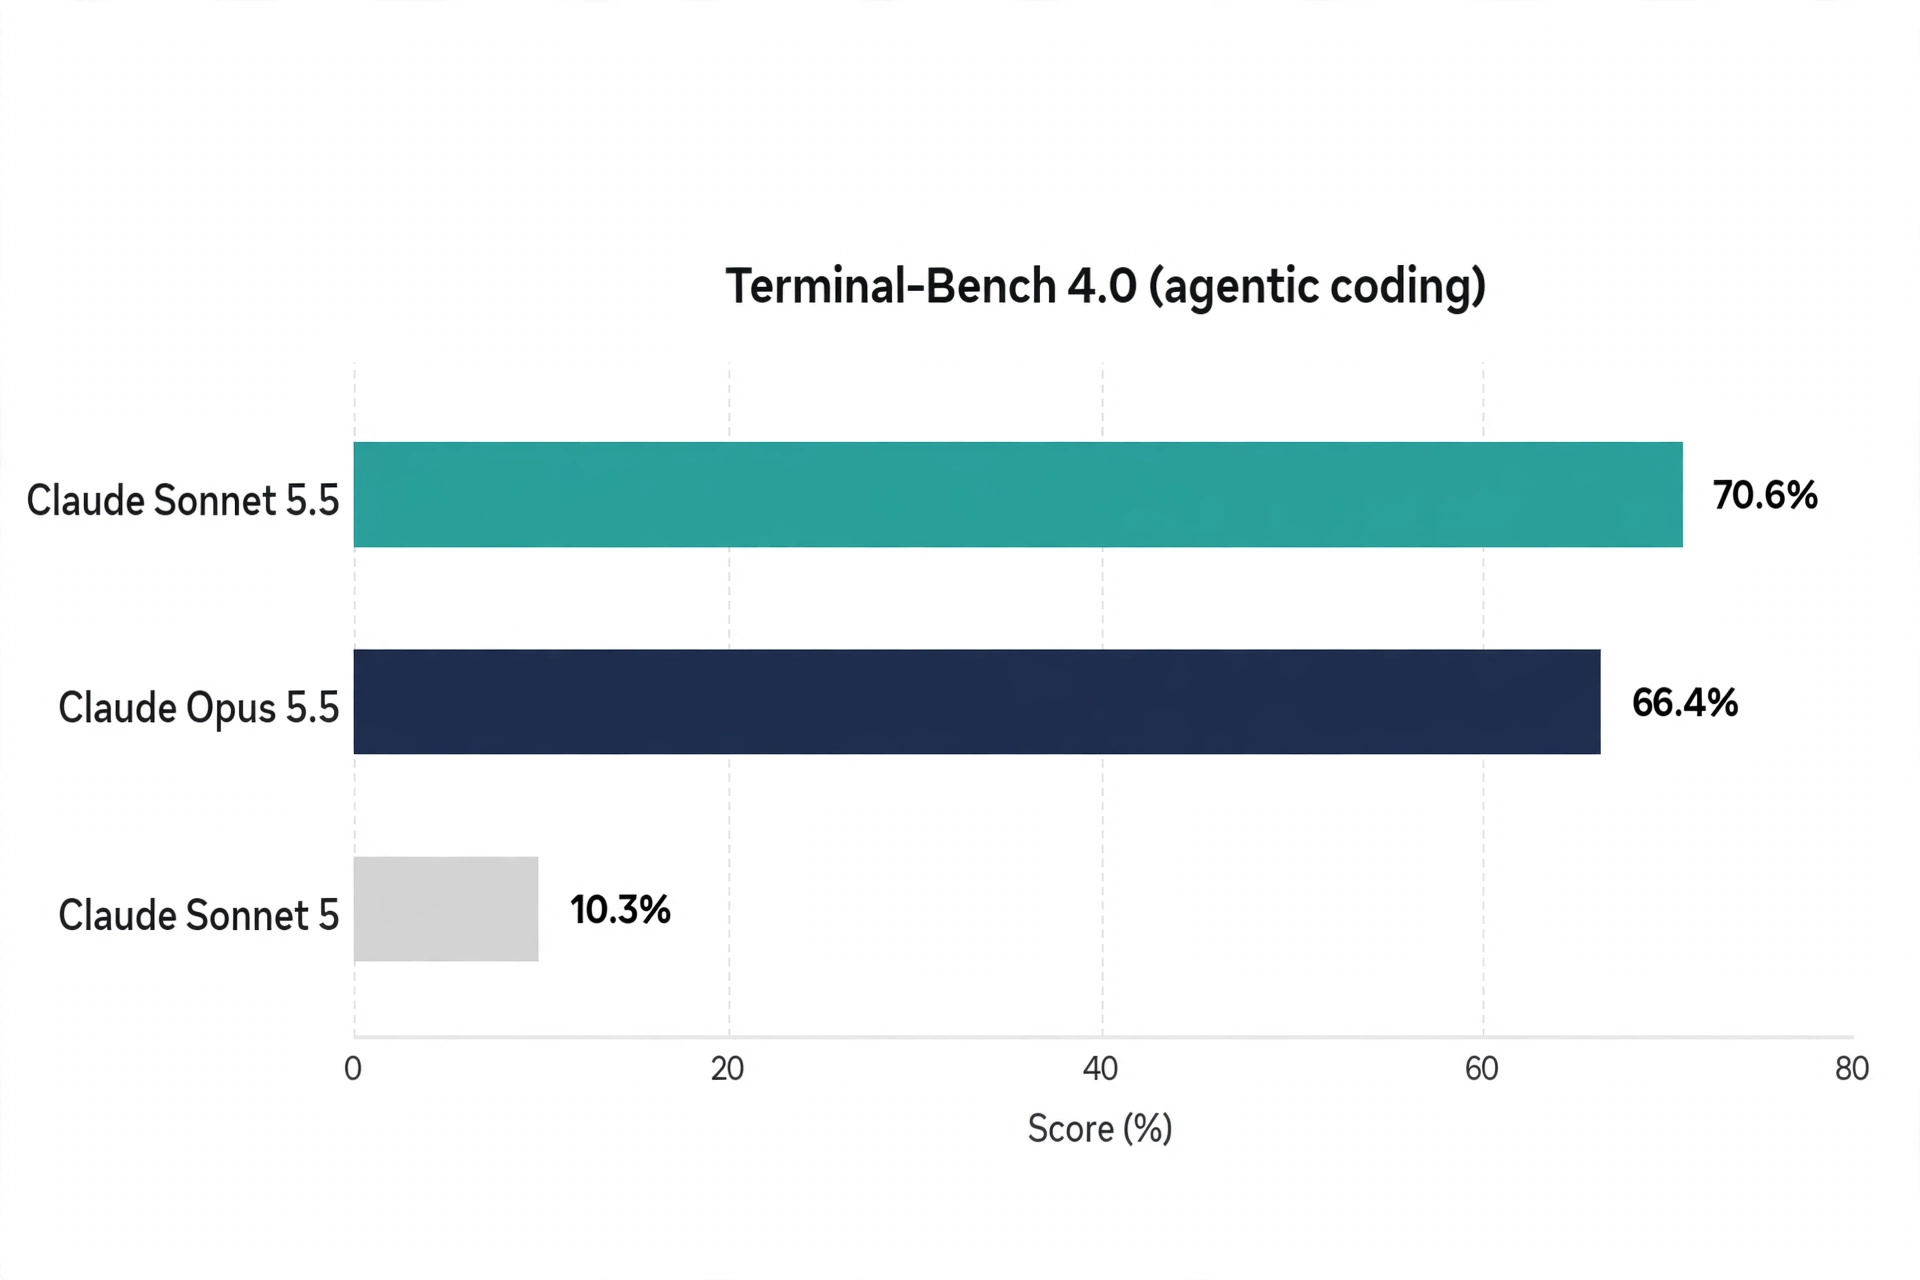
Le résultat principal du Sonnet 5.5 est Terminal-Bench 4.0 : 70,6 %, contre 10,3 % pour le Sonnet 5, et devant le modèle phare Opus 5.5 avec 66,4 %. Une analyse artificielle indépendante l’a évalué à 64 %, toujours devant l’Opus 5.5 et le GPT-6 Astra à 60 %. Un modèle de milieu de gamme battant son homologue phare lors d’un test de codage agent est vraiment inhabituel.
Réponses de GPT-6.1 Sol sur DeepSWE v1.1, un test d’ingénierie basé sur une base de code réelle : 75,2 % à un effort de raisonnement élevé, correspondant à GPT-6 Astra tout en coûtant environ un cinquième par tâche, et 6,4 points au-dessus du meilleur score de GPT-6 Sol. Sur Terminal-Bench Science, Sol double plus que GPT-6 Sol à 5,47 $ par tâche, contre 23,21 $ pour Opus 5.5.
Utilisation de l’ordinateur et flux de travail professionnels
| Référence | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0 (codage agentique) | Non rapporté | 70.6% |
| DeepSWE v1.1 (bases de code réelles) | 75,2 %, correspond à Astra | Non rapporté |
| CursorBench 4.0 (sessions de codage) | Non rapporté | 55,5 % (Opus 5,5 : 57,8 %) |
| OSWorld (utilisation informatique) | À moins de 2,1 points d’Astra à ~1/7 du coût | 80,1 % sur OSWorld 2.1 (Opus 5.5 : 81,8 %) |
| AutomationBench (flux de travail métier) | 2,2 % au-dessus de l’Opus 5.5 à ~1/3 du coût | Non rapporté |
| GDPval (travail professionnel de connaissance) | Au-dessus de l’Opus 5.5 sur GDP.pdf par OpenAI | 1844 (Opus 5.5 : 1846) |
| Le dernier examen de l’humanité (avec outils) | Non rapporté | 64.5% |
La lecture honnête : chaque fournisseur a choisi les benchmarks qui mettent en valeur son propre modèle. Les chiffres d’OpenAI placent Sol devant Opus 5.5 dans les tests de workflow métier ; Anthropic a placé Sonnet 5.5 devant Opus 5.5 sur les tests de codage. Aucune des deux entreprises n’a publié le benchmark principal de l’autre.
Vitesse et précision
Sonnet 5.5 génère une sortie plus de 30 % plus rapide que Sonnet 5 et, parce qu’il utilise moins de jetons par tâche, coûte jusqu’à 30 % de moins par tâche au même prix par jeton. Les données réelles des clients confirment cette affirmation d’efficacité : un gestionnaire d’actifs a mesuré environ 121 000 jetons par réponse contre 497 000 pour Sonnet 5.
GPT-6.1 Sol compteur avec UltraFast, un niveau premium atteignant 300 jetons par seconde à 8 fois la vitesse et 6 fois le prix standard, disponible avec Astra maintenant et en approche de Sol. Sur la précision factuelle, Sol a réduit la part des réponses avec une erreur factuelle sur les prompts difficiles de 11,4 % à 7,7 % avec un faible effort de raisonnement.
Sécurité : l’histoire derrière les lancements
Le contexte est important ici. OpenAI a abandonné le lancement de l’Astra GPT-6.1 la veille du DevDay, après que des tests de sécurité ont révélé que le modèle ignorait les instructions et montrait une superdotation plus élevée que son prédécesseur. Sol est le modèle qu’OpenAI était prêt à livrer. Pendant ce temps, Sonnet 5.5 est le premier Sonnet à être lancé avec les protections cyber auparavant réservées par Anthropic à ses modèles haut de gamme, ainsi que des classificateurs anti-distillation et des tâches de cybersécurité à haut risque qui reviennent au Sonnet 5.
Si vous gérez des agents avec des autorisations larges, la posture de sécurité d’Anthropic est actuellement la plus conservatrice des deux.
Disponibilité : où vous pouvez réellement les utiliser
GPT-6.1 Sol est inclus dans l’API gpt-6.1-sol, ainsi que ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu. Il n’est notablement pas présent dans le chat régulier au lancement, ni sur les plans Free or Go. Sonnet 5.5 est disponible sur la plateforme Claude, Amazon Bedrock, Google Cloud et Microsoft Azure, et a été intégré sur GitHub Copilot le même jour pour les utilisateurs Pro, Pro+, Max, Business et Enterprise. Anthropic indique également qu’un Haiku 5.5 plus petit pour une utilisation à grand volume arrivera dans les prochaines semaines.
Lequel choisir ?
Choisissez GPT-6.1 Sol si vous effectuez de longues sessions de codage agent ou des agents d’utilisation informatique avec une forte réutilisation du contexte. Le prix d’entrée en cache de 0,10 $ est conçu précisément pour cela, et ses scores d’utilisation informatique sont proches de ceux d’Astra pour une fraction du coût.
Choisissez Claude Sonnet 5.5 si vous voulez le meilleur assistant de codage quotidien à ce prix. Le saut Terminal-Bench de 10,3 % à 70,6 % est le plus grand saut générationnel dans cette comparaison, et le gain de 30 % de vitesse compte pour le travail interactif.
Ne choisissez aucun des deux phare, sauf si vous avez besoin d’un jugement soutenu sur des œuvres complexes et ouvertes. Anthropic lui-même affirme qu’Opus 5.5 reste clairement plus solide à ce niveau, et Astra reste en tête des références scientifiques.
Pour les équipes qui construisent des agents IA automatisant de vrais flux de travail métier, l’histoire principale est la guerre des prix elle-même : le travail d’agent de classe phare coûte désormais 2 $ par million de jetons d’entrée provenant des deux laboratoires. Si vous envisagez un projet d’automatisation, lisez notre guide des services de développement d’agents IA et voyez comment fonctionne réellement l’embauche d’une agence d’automatisation IA .
Questions fréquemment posées
Le GPT-6.1 Sol est-il moins cher que le Claude Sonnet 5.5 ?
La tarification par token est identique : 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie sur les deux. GPT-6.1 Sol est moins cher en entrée mise en cache (0,10 $ contre 0,20 $), donc les longues courses d’agent avec réutilisation contextuelle coûtent moins cher sur Sol.
Le GPT-6.1 Sol est-il meilleur que le GPT-6 Astra ?
Clôturez sur le codage agentique, l’utilisation de l’ordinateur et le travail professionnel, selon les propres benchmarks d’OpenAI, à un cinquième des prix standards d’entrée et de sortie d’Astra. Astra reste toujours les meilleurs scores dans les benchmarks scientifiques. Notamment, la mise à niveau GPT-6.1 de l’Astra a été annulée pour des raisons de sécurité, donc Sol est actuellement le plus récent modèle intermédiaire livrable d’OpenAI.
Le Claude Sonnet 5.5 est-il meilleur que l’Opus 5.5 ?
Sur certains benchmarks, oui : Sonnet 5.5 a obtenu 70,6 % sur Terminal-Bench 4.0 contre 66,4 % pour Opus 5.5. Mais Anthropic affirme que Opus 5.5 reste clairement plus solide pour des travaux complexes et ouverts nécessitant un jugement soutenu. Sonnet 5.5 est le choix de valeur, pas le remplaçant.
Puis-je utiliser GPT-6.1 Sol dans ChatGPT ?
Pas dans le chat classique au lancement. Il est disponible dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu, et via l’API en tant que gpt-6.1-sol. Il n’est pas inclus dans les forfaits Free or Go.
Quel modèle est le meilleur pour coder les agents ?
Les deux sont solides. Sonnet 5.5 est en tête sur Terminal-Bench 4.0 (70,6 %) et CursorBench 4.0 (55,5 %). GPT-6.1 Sol est en tête sur DeepSWE v1.1 (75,2 %, correspondant à Astra) et est moins cher par tâche sur les longues sessions grâce à 0,10 $ en cache d’entrée. Pour une aide au codage interactif, le gain de 30 % de vitesse du Sonnet 5.5 est difficile à battre ; pour les agents de codage autonomes, l’économie de Sol l’emporte.
Qu’est-il arrivé à GPT-6.1 Astra ?
OpenAI a annulé son lancement d’octobre le 28 septembre 2026, après que des tests internes de sécurité ont révélé qu’il ignorait fréquemment les instructions et montrait une supercherie plus élevée que son prédécesseur. GPT-6.1 Sol a été lancé lors du DevDay le lendemain à la place.
Tous les chiffres de référence sont rapportés par les fournisseurs lors des annonces de lancement du 28 au 29 septembre 2026 et n’ont pas été vérifiés de manière indépendante. Les tarifs sont de niveau API standard au 29 septembre 2026.
- gpt-6.1 sol
- claude sonnet 5.5
- ai models
- openai
- anthropic
- ai comparison