IA9 min de lecturaPor JH Akash
Explicada una robots.txt regla para no participar en el entrenamiento con IA
El 30 de octubre de 2026, OpenAI, Google, Microsoft y Anthropic respaldaron un token robots.txt para no participar en el entrenamiento de IA. Fechas, límites y el código exacto.
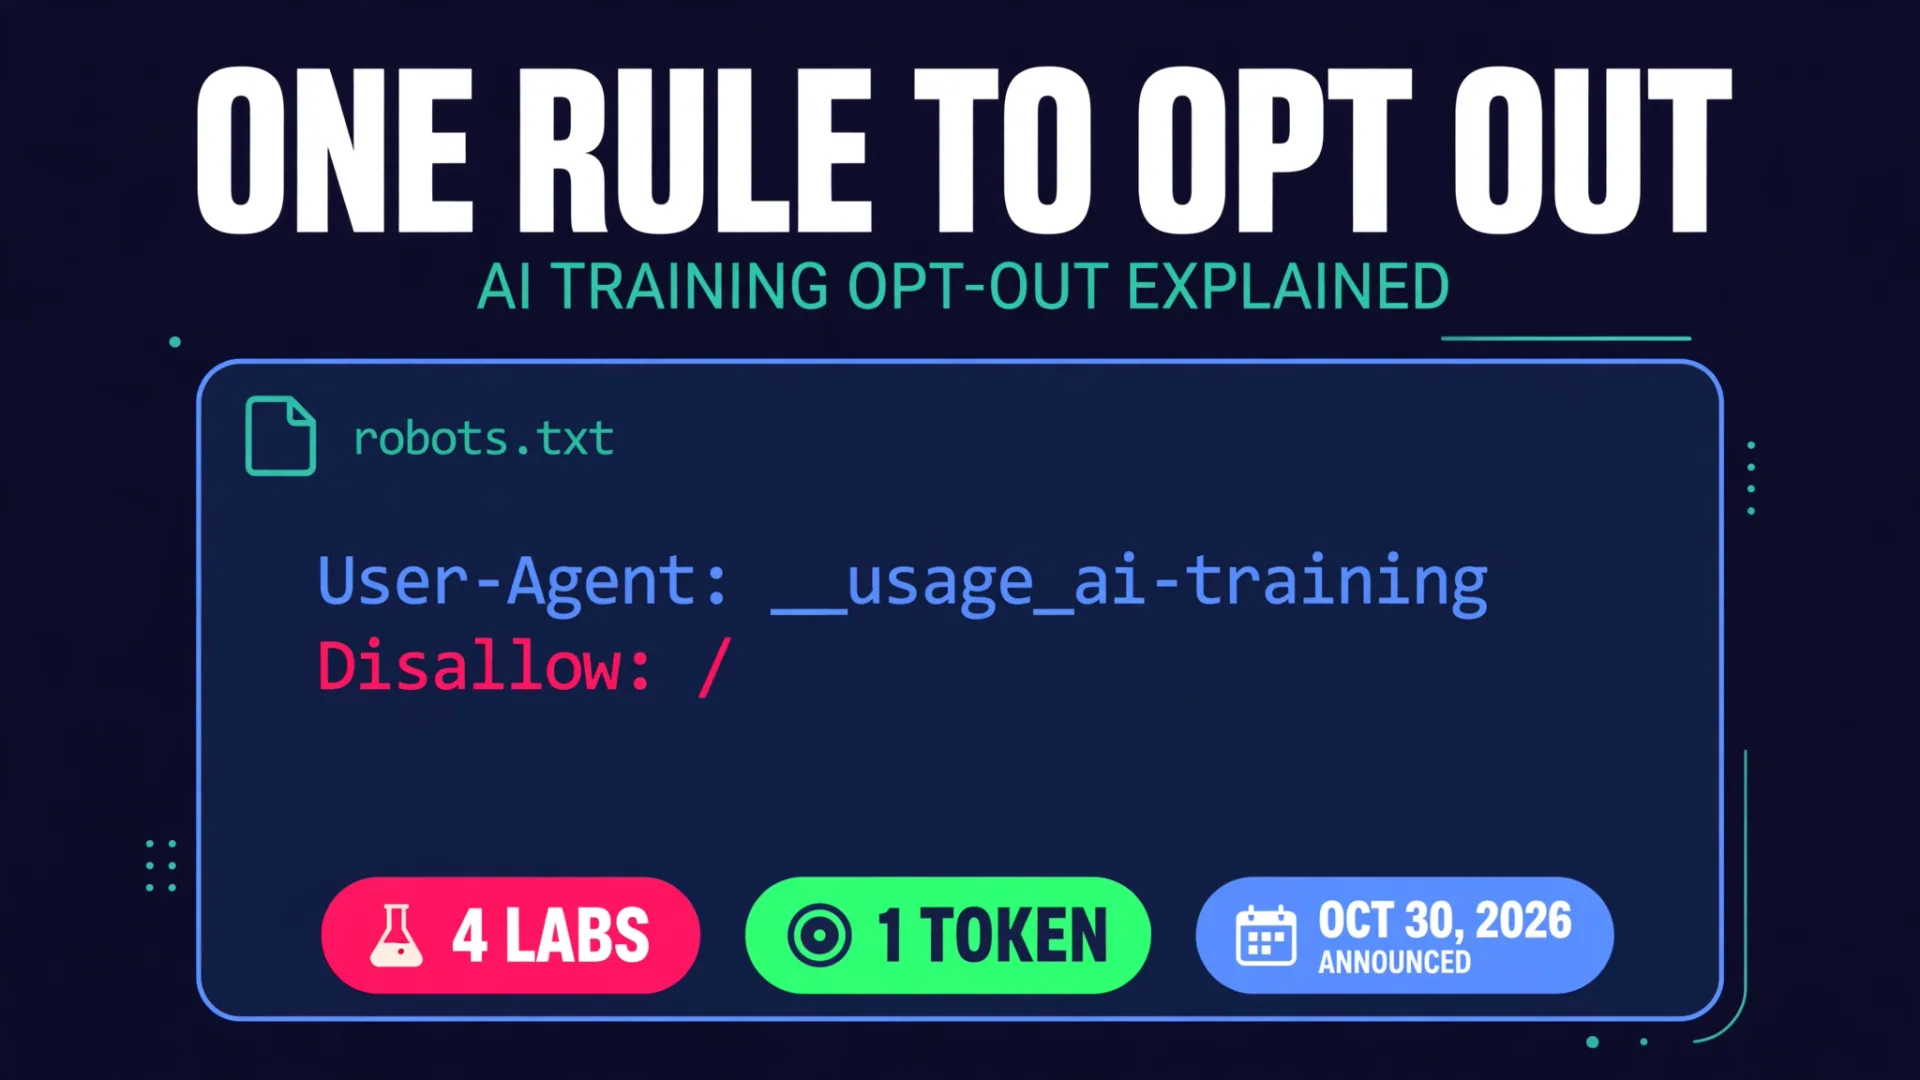
El 30 de octubre de 2026, cuatro de los mayores laboratorios de IA hicieron algo inusual: acordaron la misma regla. OpenAI, Google, Microsoft y Anthropic dijeron que respetarían un token de robots.txt compartido, _usageai-training, que permite a un sitio web optar por no recibir entrenamiento en IA en un solo paso. Hasta ahora, un editor que quería salir tenía que bloquear el rastreador de cada empresa por nombre, GPTBot, Google-Extended, ClaudeBot y una lista creciente de otras. Este anuncio condensa esa tarea en una sola entrada.
El problema está en el momento y en la letra pequeña. Solo Anthropic dice que ya ha empezado a implementar soporte. Microsoft empieza el 1 de febrero de 2027. Google apunta a 2027. OpenAI dice "en los próximos meses" sin fecha. Y la señal es voluntaria, cubre solo la formación y no hace nada respecto al contenido que ya se ha recogido o entrenado. Así que esto es un paso real de coordinación, no un interruptor de apagado instantáneo.
El veredicto rápido
| Pregunta | Respuesta |
|---|---|
| ¿Qué se anunció? | Uno compartió robots.txt token de política, _usageai-training, para optar por no participar en el entrenamiento de IA |
| Anunciado | 30 de octubre de 2026 |
| Respaldado por | OpenAI, Google, Microsoft y Anthropic |
| El código | User-Agent: _usageai-training, luego Disallow: / |
| Borrador detrás de él | Borrador de Internet del IETF "Señal de preferencia de entrenamiento legible por máquina", por Kevin Kelley de Anthropic, fechado el 30 de octubre de 2026 |
| Estado del reclutamiento | Un borrador individual, no respaldado por el IETF, sin legitimidad formal, que expira el 3 de mayo de 2027 salvo que se actualice |
| Lo que cubre | Solo entrenamiento con IA, no rastreo, búsqueda ni respuestas de IA |
| Lo que no hace | Eliminar contenido ya recopilado o ya entrenado en un modelo |
| ¿Quién puede usarla? | Cualquier propietario de sitio web, añadiendo el token a robots.txt |
| Qué guardar por ahora | Tus normas existentes por empresa, como Google Extended, porque el token compartido en su mayoría aún no está activo |
El código exacto
Añade este bloque a tu robots.txt si quieres optar por no recibir formación en toda tu web:
User-Agent: __usage_ai-training
Disallow: /
Para optar por no participar en todo excepto una carpeta, el ejemplo del borrador añade una línea de Permite:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Dos detalles importan. Primero, el token debe coincidir exactamente, salvo en mayúsculas y mayúsculas. Un grupo genérico de User-Agent: * no cuenta, y si ningún grupo nombra el token, el sitio no ha expresado preferencia. Segundo, puedes optar por no participar solo en algunas carpetas en lugar de en todo el sitio, usando Disallow en las rutas que quieres proteger.
Quién lo honra y cuándo
| Compañía | Lo que dice | Sincronización |
|---|---|---|
| Anthropic | Ha empezado a implementar soporte para el token compartido, junto con sus controles existentes | Ya empezado, el despliegue entre servicios lleva tiempo |
| OpenAI | Respetaremos una señal de robots.txt compartida para el entrenamiento básico de IA generativa, los controles existentes del crawler seguirán funcionando | En los próximos meses, no se ha dado fecha |
| Microsoft | Respetará la preferencia de entrenamiento, además de una preferencia separada de Grounding de IA y controles a nivel de página | 1 de febrero de 2027, mientras se vuelven a rastrear las páginas |
| Planes para tratar una opción de exclusión como si el editor hubiera prohibido Google-Extended, a menos que Google-Extended esté configurado directamente | Objetivos para 2027 |
Microsoft va más lejos. Está añadiendo un ajuste de entrenamiento a nivel de página y un ajuste de conexión a tierra separado, que decide si una página puede enviar respuestas en directo con IA en Bing, Copilot y Microsoft 365. Una tercera opción, DisallowExtended, permite la conexión a tierra en los propios productos de Microsoft pero no en los servicios de conexión a tierra que vende a otras empresas. Microsoft también dice que una página puede llevar una meta etiqueta de Bingbot, ai-training:disallow o un encabezado X-Robots-Tag, que anula robots.txt. Los sitios que dependen de las antiguas etiquetas NoArchive y NoCache de Bing deberían cambiar a las nuevas preferencias antes del 1 de marzo de 2027, tras lo cual las antiguas etiquetas ya no se leen como una preferencia de entrenamiento o grounding.
El detalle de Google merece la pena leerlo detenidamente. Si usas el token compartido para no dar de baja y no mencionas Google-Extended, Google planea tratar eso como bloquear Google-Extended. Pero si permites explícitamente Google-Extended, Google dice que ese sitio sigue siendo elegible para aparecer y ganar clics mediante el grounding en las respuestas de la app Gemini. En otras palabras, la opción de exclusión y la opción de visibilidad están vinculadas, así que configura ambas deliberadamente.
Fechas clave, contadas a partir del anuncio
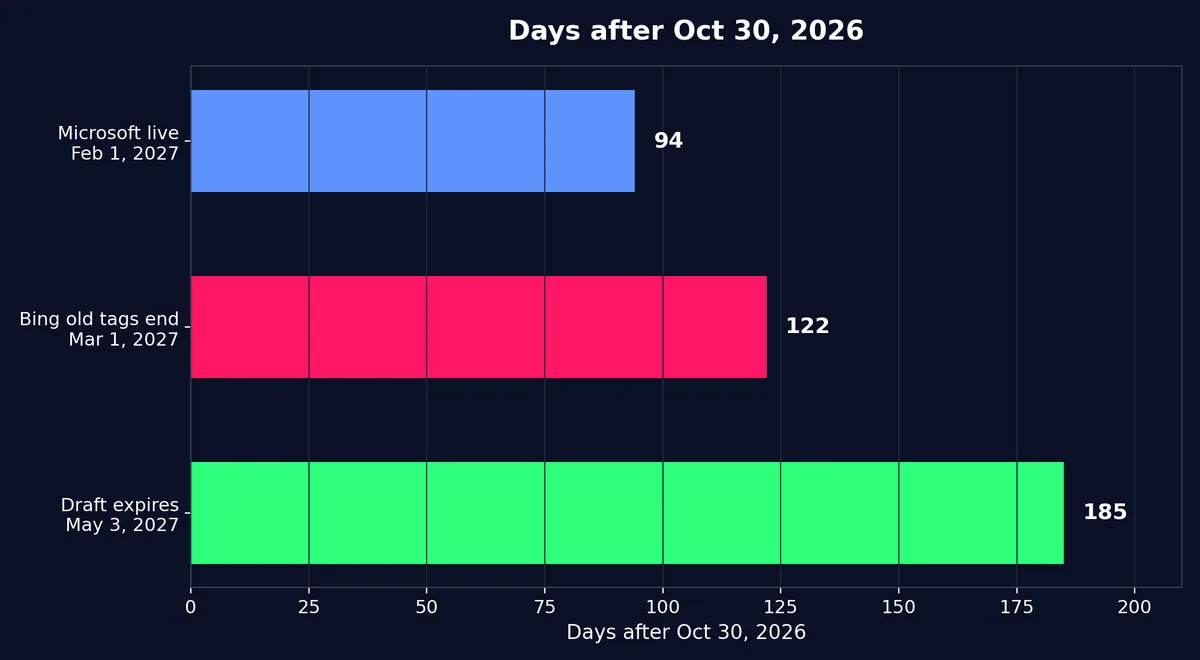
| Fecha | ¿Qué pasa? | Días después del 30 de octubre de 2026 |
|---|---|---|
| 30 de octubre de 2026 | Token compartido anunciado por los cuatro laboratorios | 0 |
| 1 de febrero de 2027 | Microsoft empieza a respetar las nuevas preferencias | 94 |
| 1 de marzo de 2027 | Bing deja de leer etiquetas antiguas de NoArchive y NoCache como preferencias de entrenamiento o de conexión a tierra | 122 |
| 3 de mayo de 2027 | El borrador del IETF expira a menos que se actualice | 185 |
| 2027, sin mes especificado | Google pretende soportar el token | Aún no está fechado |
| Próximos meses, sin fecha indicada | OpenAI pretende implementar la señal | Aún no está fechado |
Los recuentos de días son aritméticos simples del calendario desde el 30 de octubre de 2026, no reclamaciones de proveedores. Los dos elementos sin fecha, Google y OpenAI, son la razón por la que los editores no deberían considerar el anuncio como cobertura en directo hoy.
Lo que controla y lo que no controla
| Pregunta | Respuesta |
|---|---|
| ¿Detiene el entrenamiento de IA en mi contenido? | Ese es su propósito, una vez que cada laboratorio lo implementa |
| ¿Deja de gatear? | No. El borrador dice que el token no es una directiva para el comportamiento de rastreo, por lo que los bots pueden seguir buscando una página |
| ¿Detiene la indexación en las búsquedas? | No. Microsoft afirma que no participar en la formación no afecta la elegibilidad para obtener resultados regulares de Bing |
| ¿Evita que las respuestas de la IA citen mis páginas? | No, salvo a través del control de puesta a tierra separado de Microsoft. El entrenamiento y el arraigo son usos diferentes |
| ¿Borra datos de entrenamiento pasados? | No. Solo cubre futuras sesiones de entrenamiento, no contenido ya recogido o en peso de modelo |
| ¿Bloquea raspadores que lo ignoran? | No. Es voluntario, sin poder de ejecución, por lo que los extractores que no cumplen pueden ignorarlo |
Este último límite es el que los editores siguen encontrando. El token es un mecanismo de coordinación, no un control de seguridad. Solo funciona con empresas que deciden seguirlo, y el borrador en sí no tiene validez formal para el IETF. Eso no lo hace inútil, pero sí significa que debes seguir monitorizando el cumplimiento crawler por crawler y mantener tus controles existentes hasta que el token compartido sea realmente respetado.
¿Qué hacer ahora
Si añades el token ahora, no cuesta nada. El bloque de dos líneas ya está publicado, y añadirlo antes significa que estás cubierto cuando llegue el soporte, sin tener que esperar a la fecha de despliegue de cada laboratorio.
Mantén tus reglas existentes. Google-Extended, GPTBot, ClaudeBot y tus otras normas por empresa siguen funcionando hoy en día. No las elimines en favor de un token que en su mayoría aún no está activo.
Decide el entrenamiento y el grounding por separado. Si usas los productos de Microsoft, establece la preferencia de entrenamiento y la preferencia de grounding como dos opciones, no una sola. Si te importa la visibilidad de la app Gemini, decide explícitamente sobre Google-Extended en lugar de dejar que el token compartido lo decida por defecto.
Revisa las etiquetas de Bing antes del 1 de marzo de 2027. Si tu sitio depende de NoArchive o NoCache, muévete a las nuevas preferencias de Microsoft antes de esa fecha límite.
Espera un borrador de seguimiento. El borrador actual expira el 3 de mayo de 2027 a menos que se actualice, y el grupo de trabajo incluye Meta, Cloudflare, la Common Crawl Foundation, News Corp, el Financial Times, la BBC, la Electronic Frontier Foundation y Creative Commons. El estándar puede cambiar a medida que esos participantes opinen, así que considera la redacción de hoy como punto de partida, no como ley definitiva.
Para los equipos que desarrollan productos de IA, la lección es más amplia que un solo archivo robots.txt. Las preferencias de entrenamiento, las preferencias de grounding y la visibilidad en búsquedas son ahora tres palancas separadas, y mezclarlas cuesta tanto control de datos como tráfico. CodeMyPixel desarrolla servicios de desarrollo de agentes de IA y ayuda a las empresas a contratar una agencia de automatización de IA para integrar la IA en flujos de trabajo reales con las barreras y evaluaciones que un modelo en bruto o una sola línea de robots.txt no ofrece. Si comparas modelos abiertos frente a cerrados, nuestro desglose de pesos abiertos de Mistral Large 4 y nuestro explicador Gemini 4 Carbon muestran cómo el acceso, la licencia y el control difieren en la práctica.
Cuál elegir
Elige el token compartido más tus reglas antiguas si quieres la máxima cobertura hoy. El token te prepara para 2027, las reglas antiguas te protegen ahora.
Elige la opción de exclusión del entrenamiento solo si quieres que tu contenido salga de futuros modelos de entrenamiento, pero aún así quieres tráfico de búsqueda y visibilidad de respuestas de IA. Recuerda que este token por sí solo no bloquea respuestas de IA.
Elige la opción de formación y conexión a tierra en Microsoft si también quieres que tus páginas salgan de respuestas en vivo de IA en Bing, Copilot y Microsoft 365. Eso es una configuración separada de Microsoft, no parte del token compartido en sí.
No eligas la opción de exclusión si tu negocio se beneficia de la exposición al entrenamiento con IA, o si quieres seguir siendo elegible para la conexión a tierra y clics de la app Gemini, y te sientes cómodo con que tu contenido se use para formación. Esta es una decisión empresarial, no un predeterminado, así que hazlo deliberadamente.
¿Qué es el token compartido de exclusión de entrenamiento de IA?
Es un token de política robots.txt, _usageai-training, anunciado el 30 de octubre de 2026, que OpenAI, Google, Microsoft y Anthropic dicen que respetarán. El propietario de un sitio web añade User-Agent: usage_ai-training seguido de Disallow: / para optar por no participar en el entrenamiento de IA, en lugar de bloquear el rastreador de cada empresa por nombre.
¿Excluir Google o Bing impide que indexen mi sitio?
No. El token cubre únicamente el entrenamiento con IA, no el rastreo o la búsqueda. Microsoft dice que optar por no participar en el entrenamiento no afecta la elegibilidad para los resultados regulares de Bing, y el borrador indica que el token no es una directiva para el comportamiento de rastreo.
¿Cuándo entra realmente en vigor el token compartido?
Anthropic ya ha empezado a implementarlo. Microsoft comienza el 1 de febrero de 2027. Google apunta a 2027 sin que se indique un mes. OpenAI dice que implementará la señal en los próximos meses sin data indicada. Hasta entonces, las reglas por empresa que existen son lo que funciona hoy.
¿El token elimina mi contenido de modelos ya entrenados con él?
No. Actualizar robots.txt no elimina contenido ya recogido en conjuntos de datos ni entrenado en pesos de modelo. El token solo cubre futuras ejecuciones de entrenamiento.
¿Es esto un estándar formal de la web?
No, todavía no. Es un borrador individual de Internet del IETF, "Señal de preferencia de entrenamiento legible por máquina", de Kevin Kelley de Anthropic, enviado al grupo de trabajo de Preferencias de IA del IETF. El rastreador de datos del IETF señala que un borrador individual no está respaldado por el IETF y no tiene validez formal, y el borrador expira el 3 de mayo de 2027 a menos que se actualice.
¿Debería mi empresa optar por no recibir entrenamiento con IA?
Dad de baja si controlar el uso futuro de la formación te importa más que cualquier exposición que pueda aportar, y mantén tus antiguas reglas de rastreador hasta que el token compartido esté activo. Sigue optando o establece un permiso explícito de Google-Extendido, si quieres seguir siendo elegible para la conexión a tierra y clics de la app Gemini. Decide la formación y la conexión a tierra por separado, y revisa la elección cuando llegue la fecha de Microsoft el 1 de febrero de 2027.
- robots.txt
- ai training opt-out
- openai
- microsoft
- anthropic
- ai policy