Noticias de IA7 min de lecturaPor JH Akash
Muse Ember: La puntuación de 36 de Haiku a un tercio del coste
Muse Ember de Meta iguala a Claude Haiku 5.5 en el 36 del Índice de Análisis Artificial por aproximadamente un tercio del coste por tarea. Aquí están los puntos de referencia, el precio y la trampa.
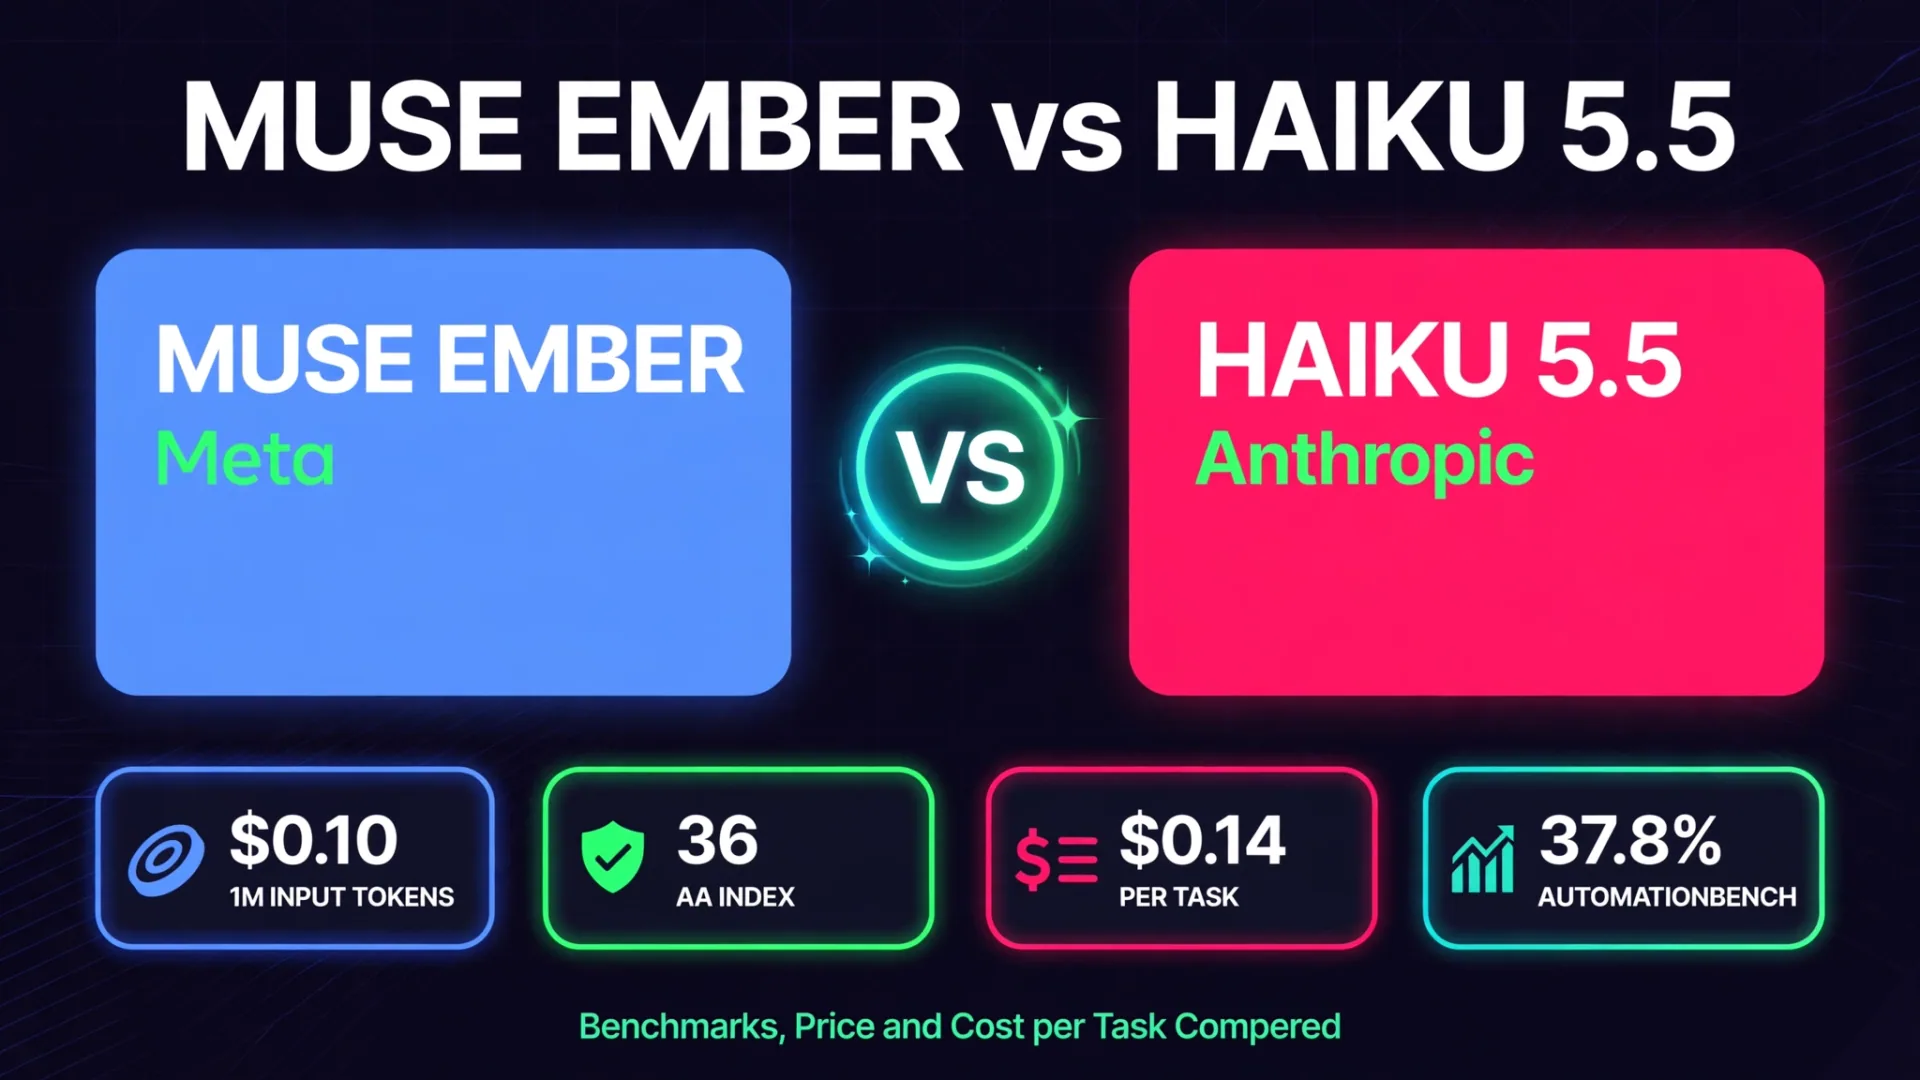
Meta lanzó Muse Ember el 9 de noviembre de 2026, y el número principal es difícil de ignorar: iguala a Claude Haiku 5.5 en el puesto 36 del Índice de Inteligencia de Análisis Artificial, aunque cuesta aproximadamente un tercio por tarea. Ember es el modelo Muse más pequeño y barato de Meta, diseñado para el trabajo repetitivo que los agentes de IA realizan todo el día: llamadas a herramientas, subtareas de codificación, enrutamiento, extracción y análisis de documentos largos.
La trampa está en la letra pequeña. Los precios de los tokens son idénticos a los de Haiku 5.5 y GPT-6 Luna. Ember gana en coste por tarea porque utiliza muchos menos tokens de salida para alcanzar la misma puntuación. Y en un benchmark, el más cercano al código fusionable real, Haiku sigue ganando claramente. Esta publicación compara los tres modelos en precio, benchmarks y las cargas de trabajo para las que cada uno está realmente diseñado.
Veredicto rápido
| Modelo | Índice de Inteligencia de AA | Coste por tarea | Mejor para |
|---|---|---|---|
| Muse Ember | 36 | $0.136 | Trabajo de alto volumen de agentes, flujos de trabajo empresariales |
| Claude Haiku 5.5 | 36 | $0.411 | Código fusionable, trabajo de oficina |
| GPT-6 Luna | 28 | $0.152 | Tareas generales baratas, menor coste por tarea después de Ember |
Todas las puntuaciones están al máximo esfuerzo de razonamiento, según informa Meta a partir de datos de Análisis Artificial fechados el 9 de noviembre de 2026. Los benchmarks publicados por un proveedor se reportan por el proveedor hasta que se vuelven a probar de forma independiente.
Qué es Muse Ember
Ember es el cuarto modelo de la familia Muse de Meta. Muse Spark llegó en abril de 2026 como modelo de peso medio, Glimmer siguió en agosto como su gemela de peso descubierto, y el modelo fronterizo Muse Wonder se lanzó en octubre. Ember es el pequeño, y Meta lo considera el modelo más eficiente de la familia.
Es un modelo multimodal: toma texto, imágenes, audio y vídeo en una sola llamada, de modo que un agente puede leer capturas de pantalla, gráficos, documentos escaneados, notas de voz y vídeo sin un modelo separado. La ventana de contexto es de 1.048.576 tokens (1M), con hasta 524.288 tokens de salida (512K) por solicitud. Eso es suficiente para alimentar toda una base de código o un conjunto de documentos grandes en una sola llamada.
Ahora está disponible como muse-ember-1.0 en la API de Meta Model y en Muse Code, así como en Google Cloud y Oracle Cloud. Los pesos están cerrados, así que este es un modelo solo de API, no una descarga abierta. Meta también afirma que Ember es el primer modelo entrenado con Muse Wonder Full, su modelo frontera, y que incluso modelos más baratos ya están en entrenamiento. Ese mismo día, Meta también puso Muse en Apple Watch y Wear OS.
Precios: el mismo precio de referencia, una factura muy diferente
Aquí está la parte en la que la mayoría de los titulares se equivocan. Los precios por token de Ember son exactamente los mismos que los de Haiku 5.5 y GPT-6 Luna. El ahorro viene de la eficiencia, no de una tarjeta de tarifas más barata.
| Precio por cada 1M de fichas | Hasta 200K tokens | Por encima de 200K tokens |
|---|---|---|
| Entrada | $0.10 | $0.30 |
| Entrada en caché | $0.004 | $0.012 |
| Producción | $0.50 | $1.50 |
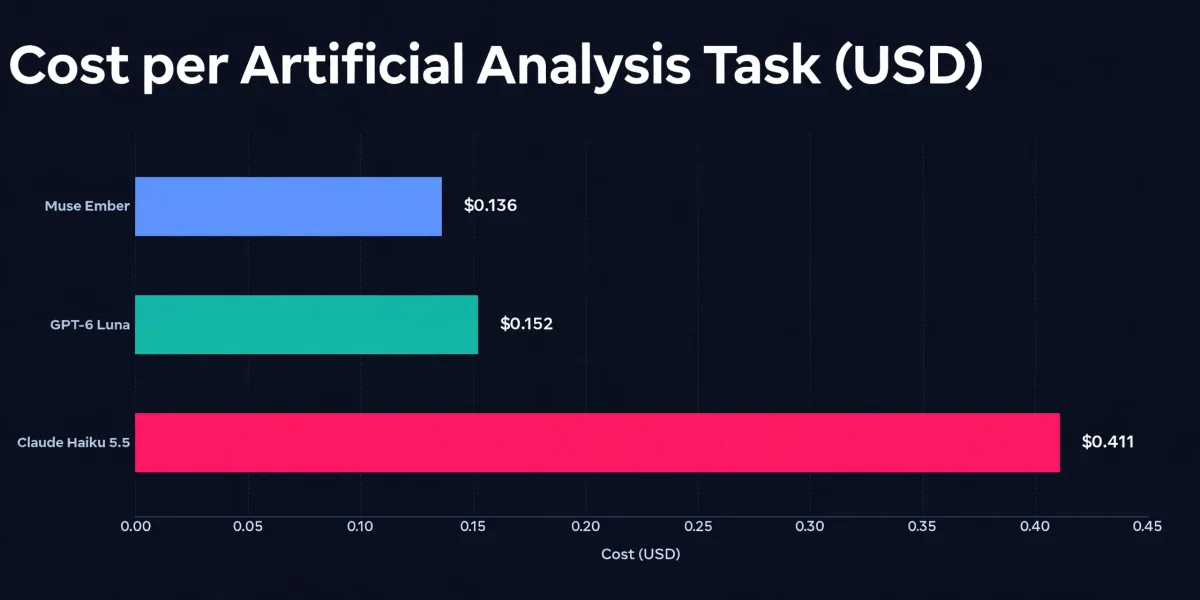
El nivel superior se aplica a toda la solicitud una vez superada los 200.000 tokens, por lo que las llamadas de contexto largo cuestan tres veces más por token. El número real a vigilar es el coste por tarea terminada. En los benchmarks de Análisis Artificial, Ember promedia unos 0,14 $ por tarea, Haiku 5,5 unos 0,41 $ y GPT-6 Luna unos 0,15 $. Ember alcanza la misma puntuación que Haiku usando aproximadamente un tercio de los tokens de salida, y ahí es donde la factura disminuye.
Para cuanto a escala, el modelo más grande de Meta, Muse Spark 1.3, obtiene 37 puntos en el mismo índice, un punto por encima de Ember, pero cuesta 2,39 $ por tarea, unas 17 veces más que Ember. El cambio es claro: un punto extra de índice por 17 veces el coste de la tarea.
Referencias: dónde gana Ember y dónde pierde
Meta publicó diez comparaciones directas con el máximo esfuerzo de razonamiento. La mayor brecha está en los flujos de trabajo empresariales, la menor en el código fusionable.
| Índice de referencia | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Índice de Análisis Artificial | 36 | 36 | 28 |
| Coste por tarea AA | $0.136 | $0.411 | $0.152 |
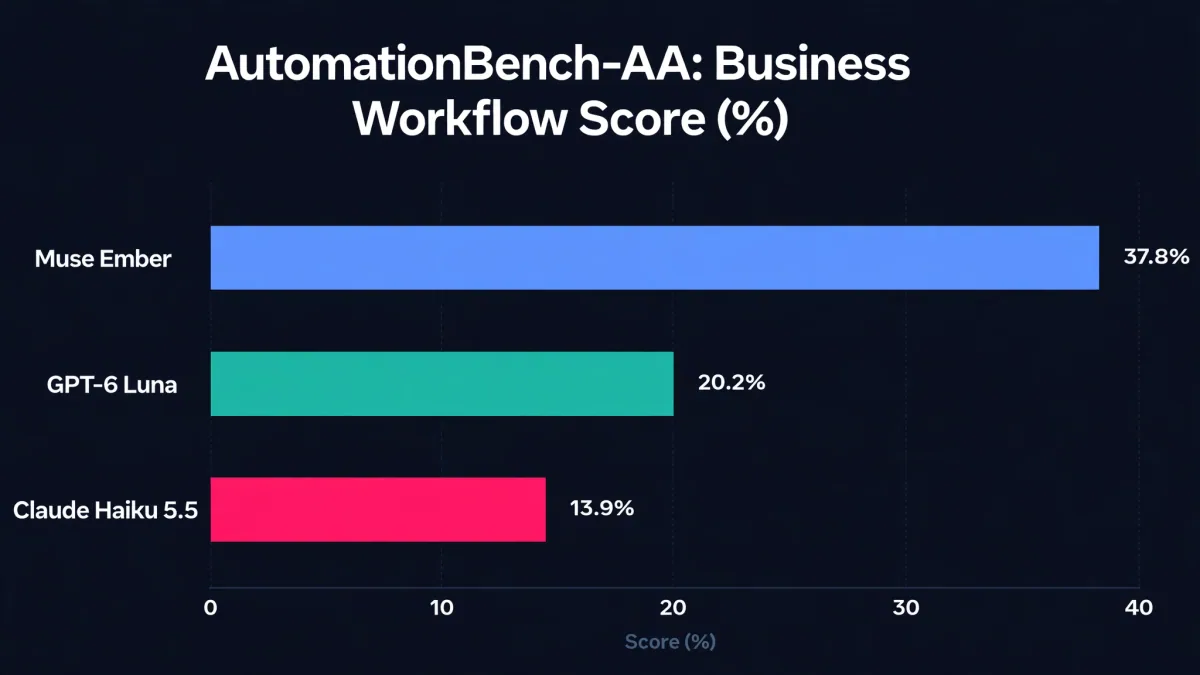
| AutomationBench-AA (flujos de trabajo empresariales) | 37.8% | 13.9% | 20.2% |
| Último examen de los agentes | 61.6% | 57.0% | 57.1% |
| Terminal-Bench 4.0 (codificación agentica) | 40.9% | 39.2% | 16.4% |
| Índice de Agentes de Codificación-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA (código fusionable) | 27.2% | 34.9% | 25.2% |
| OSWorld 2.1 (uso en ordenador, binario) | 33.8% | 27.8% | 17.0% |
| GDP.pdf-AA (documentos largos) | 22.8% | 20.8% | 22.8% |
| PerceptionBench (visual, con herramientas) | 80.6% | 78.6% | 62.8% |
Lee la tabla con atención. El resultado destacado de Ember es AutomationBench-AA, que ejecuta 657 flujos de trabajo empresariales reales: un 37,8% frente al 13,9% de Haiku, casi tres veces más. También lidera en codificación agentica en Terminal-Bench y en el Coding Agent Index, que mide el modelo dentro de su arnés real de codificación.
Pero FrontierCode 2.0-AA, la prueba más cercana al código que puedes fusionar sin editar, va en la dirección contraria: Haiku 5.5 obtiene un 34,9% frente al 27,2% de Ember. Y en el propio índice principal, el empate es redondeado: sin redondear, Haiku es 36,2 y Ember 35,8. Misma puntuación en el gráfico, una pequeña diferencia real debajo. Meta también realizó cuatro de las diez comparaciones y califica las carreras rivales como el mejor esfuerzo, así que trata los números como reportados por el proveedor.
Qué modelo elegir
Elige Muse Ember si ejecutas agentes en volumen: soporte triaje, extracción de documentos, enrutamiento, llamadas a herramientas y subtareas de codificación repetidas. La ventana de contexto de 1M y el coste de 0,14 $ por tarea hacen que sea la forma más barata de ejecutar inteligencia a nivel Haiku todo el día. Mira el nivel de 200K tokens, donde los precios se triplican.
Elige Claude Haiku 5.5 si tu agente escribe código que debe fusionarse limpiamente, o si necesitas un acuerdo y ecosistema de procesamiento de datos establecidos. Cuesta aproximadamente tres veces más por tarea para la misma puntuación de índice, pero gana el benchmark de código fusionable por un amplio margen.
Elige GPT-6 Luna si quieres la opción barata de menor riesgo dentro del ecosistema de OpenAI. Está por detrás de ambos rivales en el índice con 28 puntos, pero su coste por tarea es casi tan bajo como el de Ember, y empata a Ember en el trabajo de documentos largos.
Para los equipos que construyen agentes, la decisión práctica es una división: Ember para los pasos repetitivos de alto volumen, y un modelo más sólido para el código final o la decisión que tiene que ser correcta. Esa es exactamente la carga de trabajo para la que se creó Ember. Si planeas ese tipo de configuración, nuestra guía de servicios de desarrollo de agentes de IA desglosa cuánto cuesta construir un sistema de agentes, y también puedes contratar a una agencia de automatización de IA para que lo desarrolle por ti.
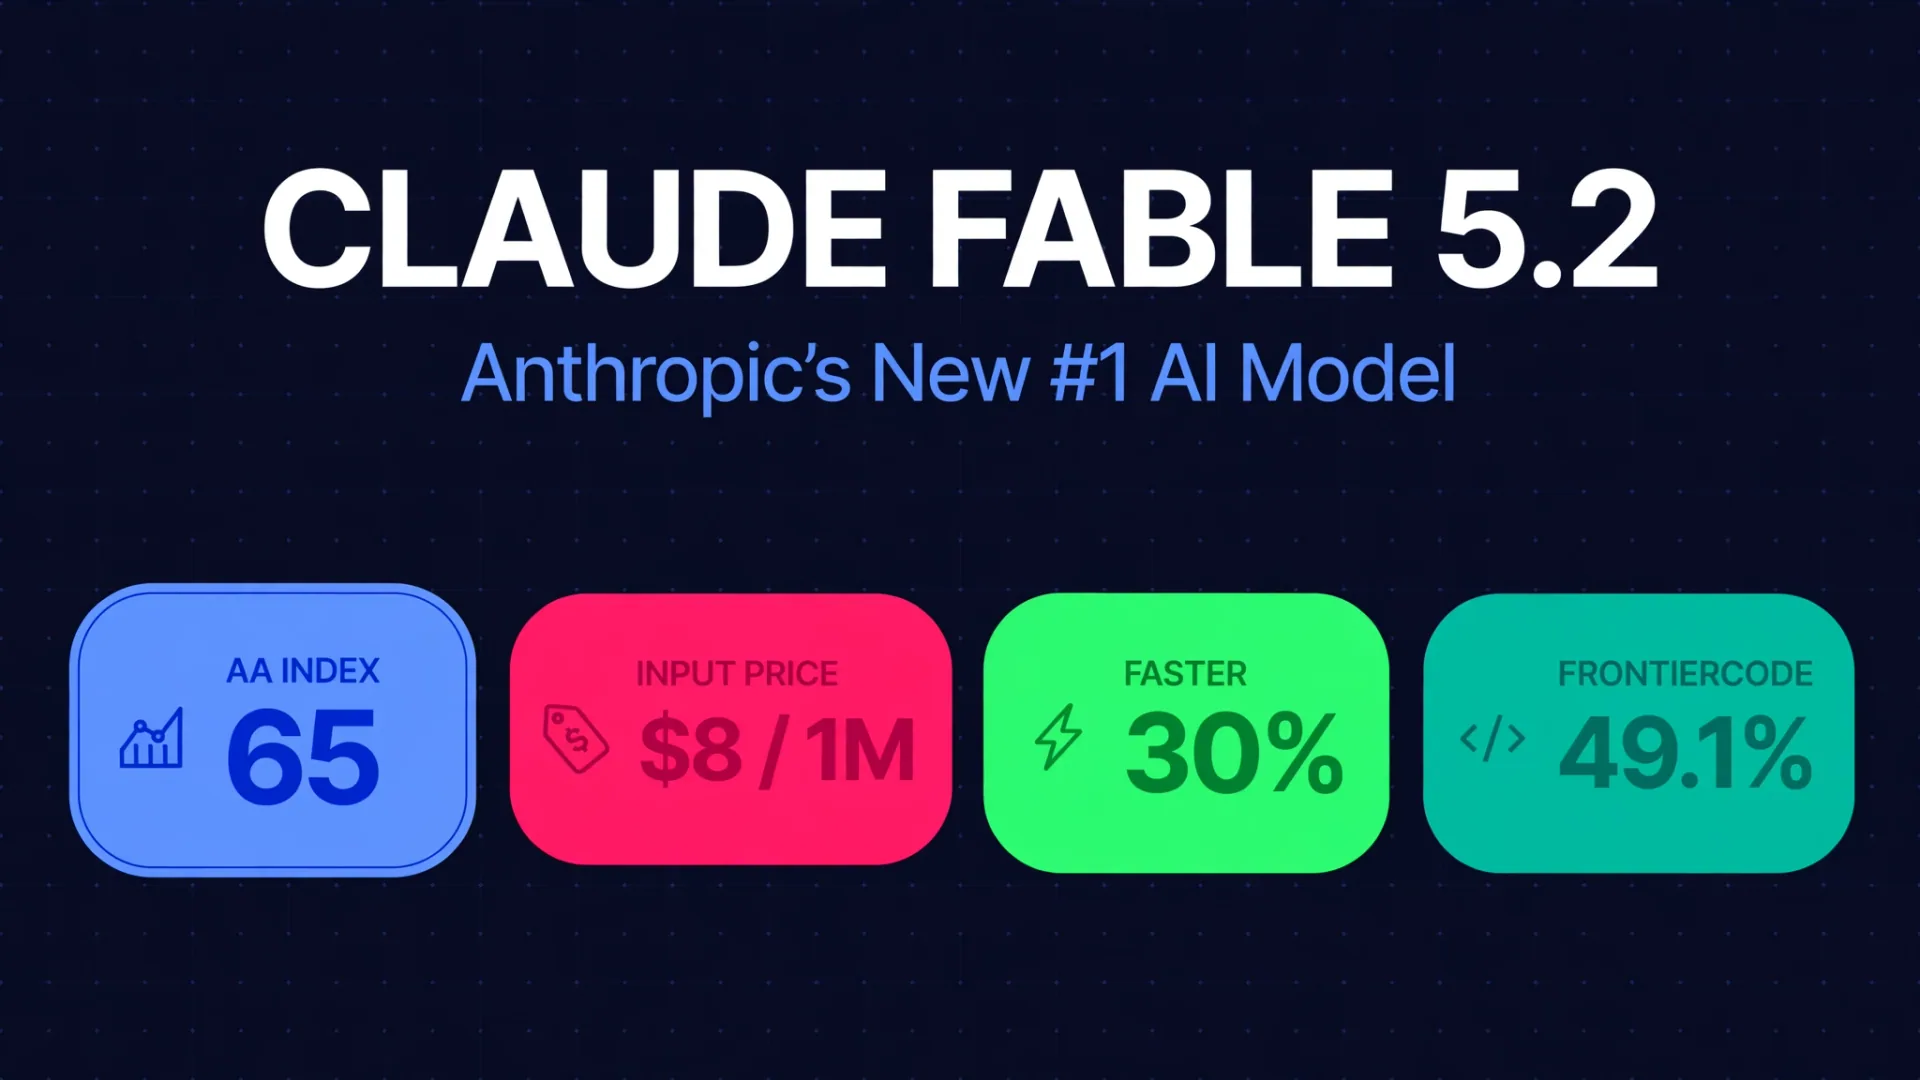
Anthropic tampoco está parada. Su nuevo modelo fronterizo Claude Fable 5.2 obtuvo el primer puesto en el mismo índice con 65, y el modelo insignia GPT-6 Astra de OpenAI es el modelo con el que se miden los hermanos mayores de Ember. La carrera de modelos pequeños ahora se basa en el coste por tarea terminada, no en el coste por ficha, y Ember acaba de marcar el número para superar: 0,14 dólares.
Preguntas frecuentes
¿Qué es Meta Muse Ember?
Muse Ember es el modelo de IA más pequeño y eficiente de Meta, lanzado el 9 de noviembre de 2026. Está diseñado para el trabajo repetitivo que los agentes de IA realizan durante todo el día: llamadas a herramientas, subtareas de codificación, enrutamiento, extracción y análisis de documentos largos. Está disponible como muse-ember-1.0 en la API de Meta Model y en el código de Muse.
¿Cuánto cuesta Muse Ember?
Muse Ember cuesta 0,10 dólares por millón de tokens de entrada y 0,50 $ por millón de tokens de salida para prompts de hasta 200.000 tokens, con entrada en caché en 0,004 $. Por encima de 200.000 tokens, las tarifas suben a 0,30 $ de entrada, 0,012 $ almacenados en caché y 1,50 $ de salida. En los benchmarks de Análisis Artificial promedia unos 0,14 $ por tarea.
¿Es Muse Ember mejor que Claude Haiku 5.5?
En el Índice de Inteligencia de Análisis Artificial, ambos obtienen 36 en razonamiento máximo, y Ember cuesta aproximadamente un tercio por tarea. Ember también gana ampliamente en flujos de trabajo empresariales (37,8% frente al 13,9% en AutomationBench-AA). Haiku 5.5 es más fuerte en código fusionable, con un 34,9% frente al 27,2% de Ember en FrontierCode 2.0-AA.
¿Es Muse Ember de código abierto?
No. Meta no ha publicado los pesos. Muse Ember es un modelo solo de API, disponible a través de Meta Model API, Muse Code, Google Cloud y Oracle Cloud.
¿Cuál es la ventana de contexto de Muse Ember?
Muse Ember tiene una ventana de contexto de 1.048.576 tokens (1M) y soporta hasta 524.288 tokens de salida (512K) por solicitud. Acepta texto, imágenes, audio y vídeo como entrada.
Fuentes: Meta AI Research, "Presentando nuestro modelo más pequeño y eficiente: Muse Ember", 9 de noviembre de 2026; Índice de Inteligencia de Análisis Artificial v5, 9 de noviembre de 2026. Las cifras de los benchmarks son publicadas por Meta y reportadas por los proveedores.
- Muse Ember
- Meta Muse
- Claude Haiku 5.5
- GPT-6 Luna
- AI benchmarks