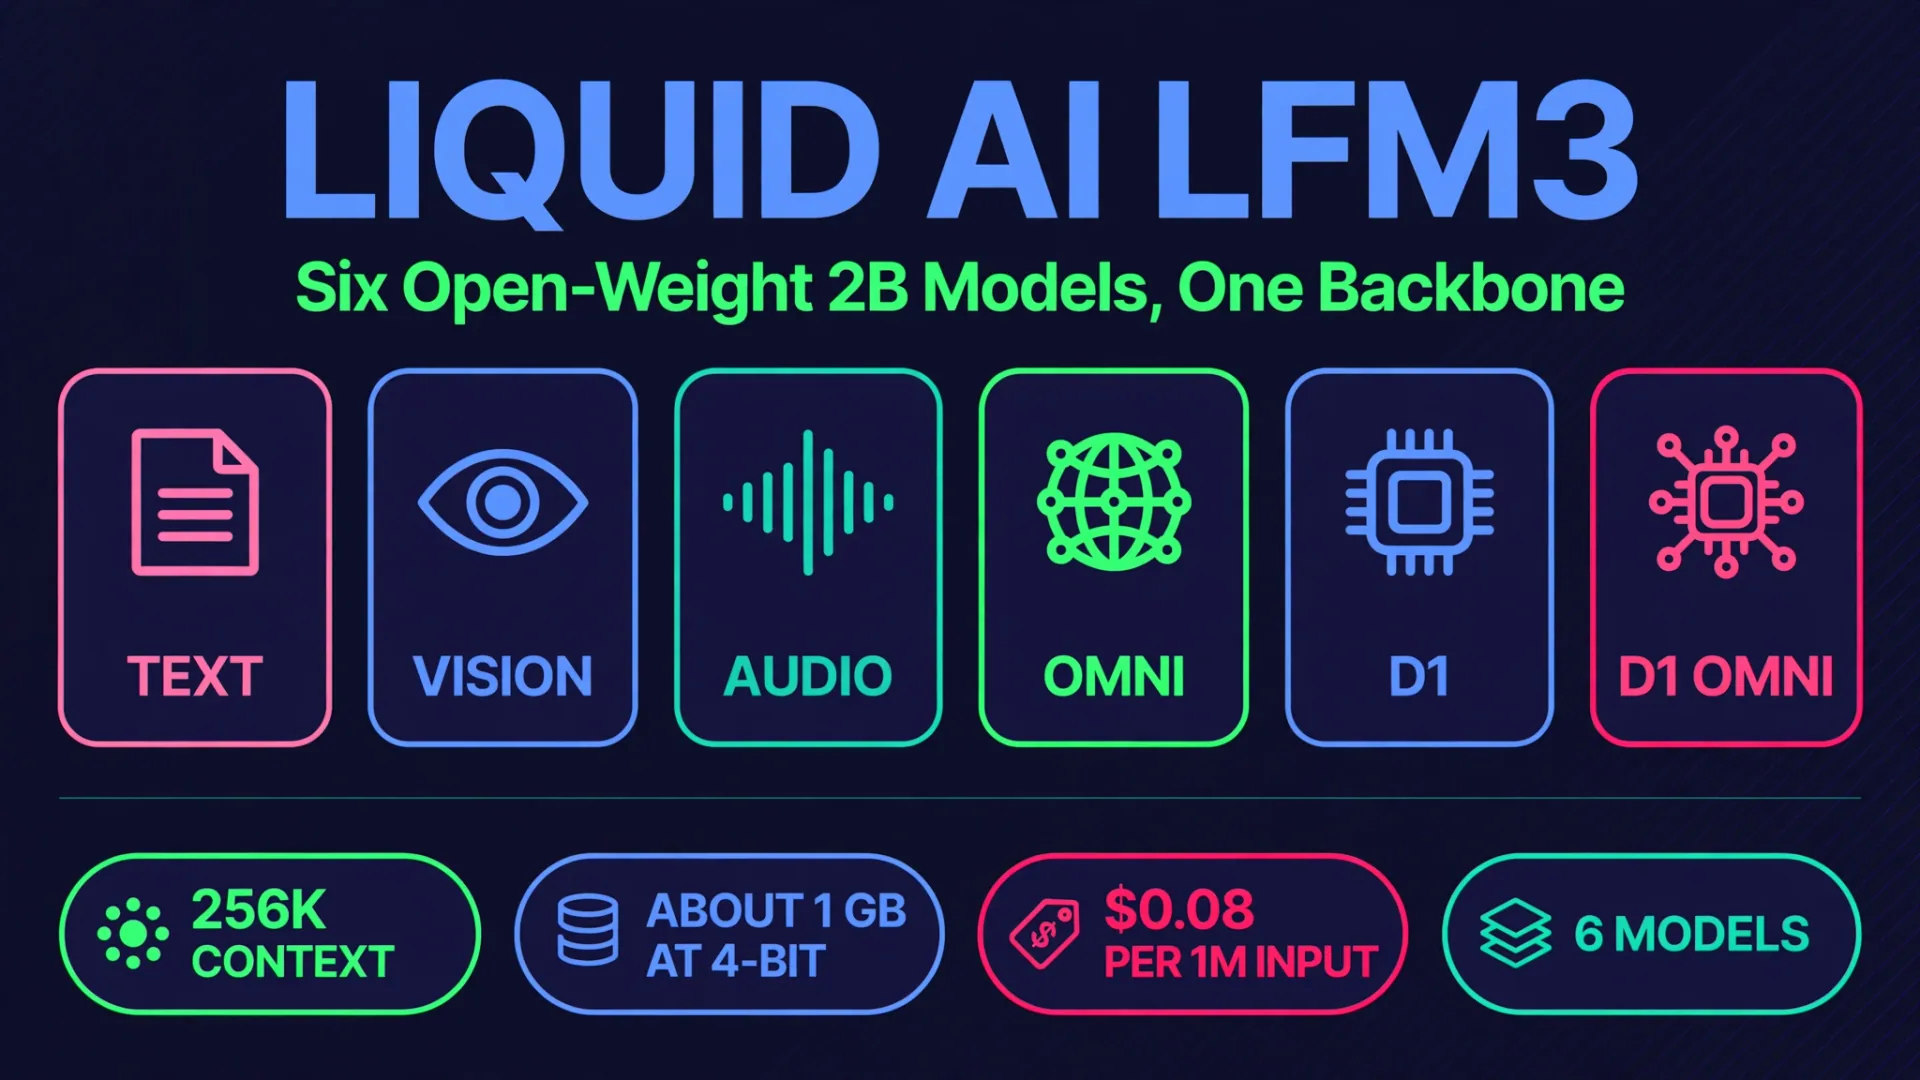
Liquid AI brachte LFM3 am 27. Oktober 2026 auf den Markt: sechs Openweight-2B-Modelle aus einem 1,7-Milliarden-Backbone, 256K Kontext, 1 GB bei 4-Bit, API ab 0,08 US-Dollar pro 1-Million-Token.
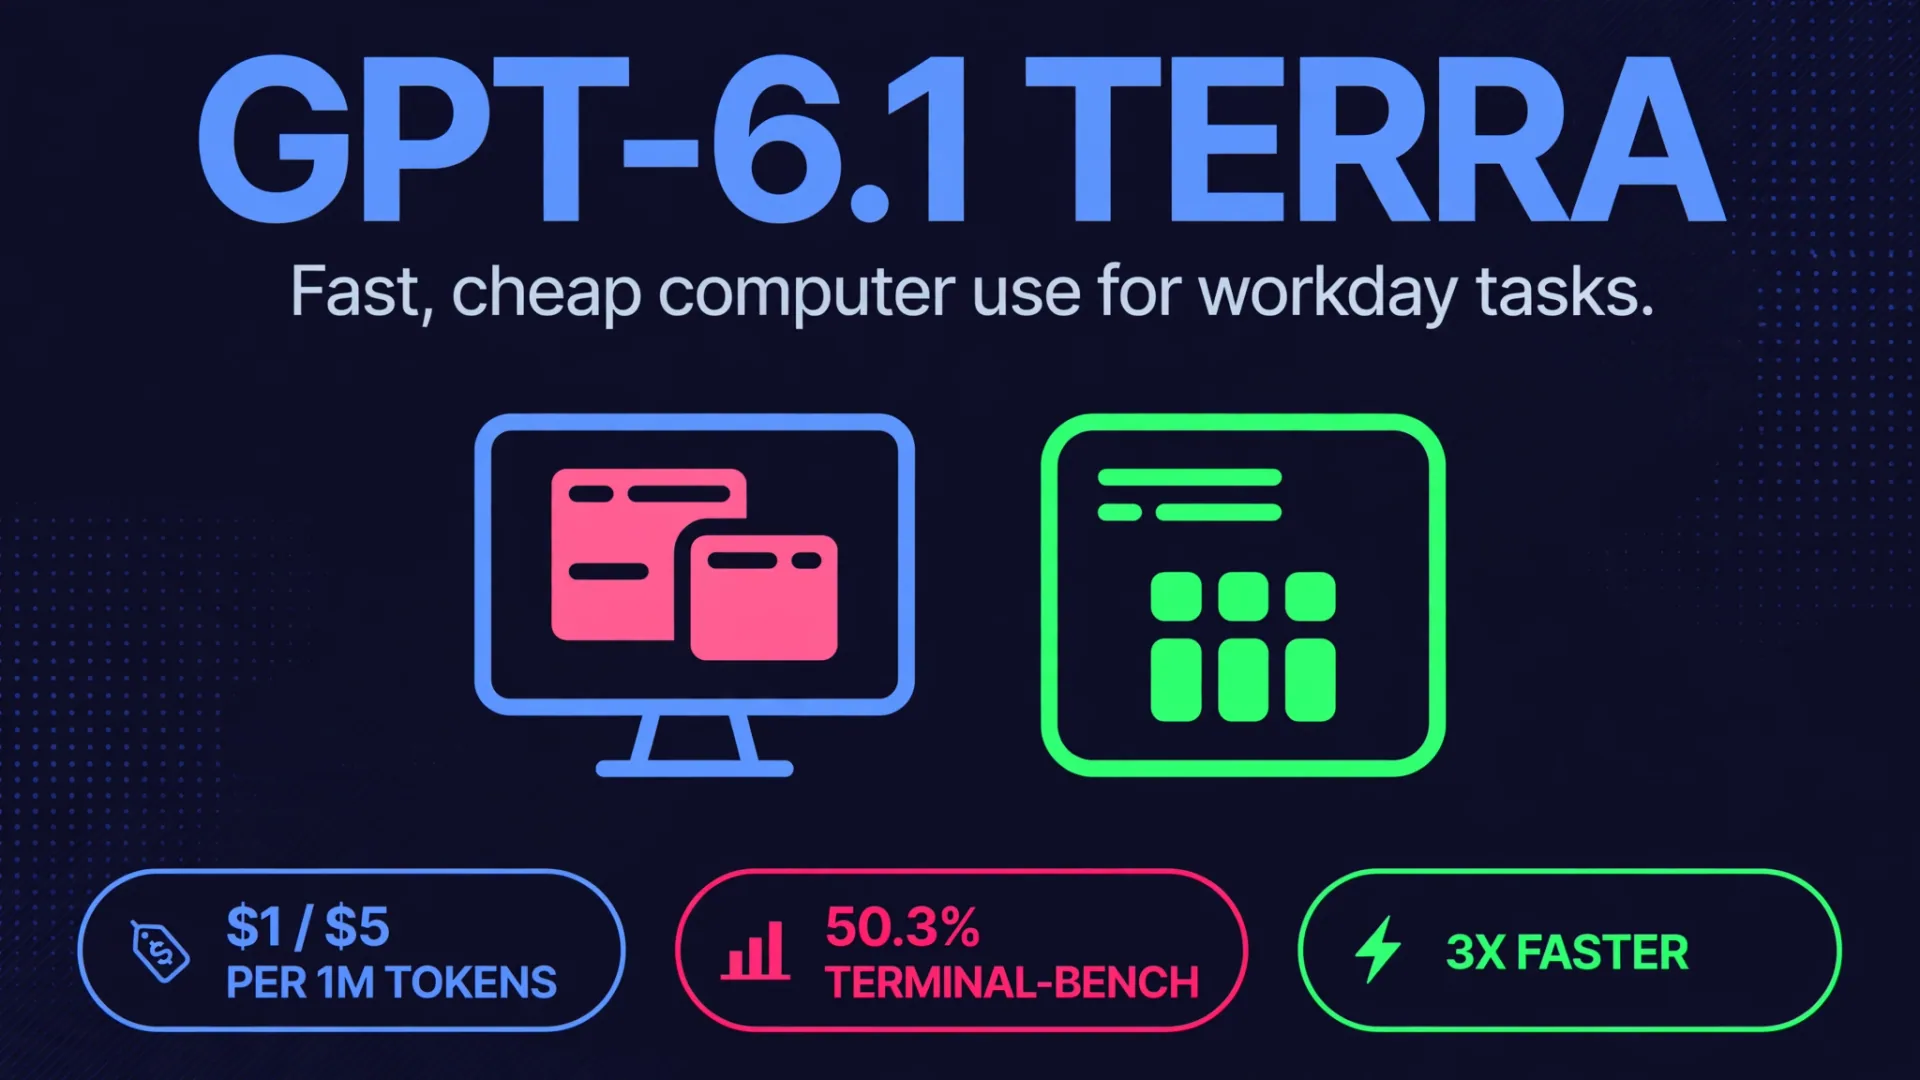
OpenAI brachte GPT-6.1 Terra am 26. Oktober 2026 auf den Markt: 1 $/5 $ pro 1-Million Tokens, 50,3 % auf Terminal-Bench 4.0, 3-mal schnellere Computernutzung für Arbeitstagesaufgaben.
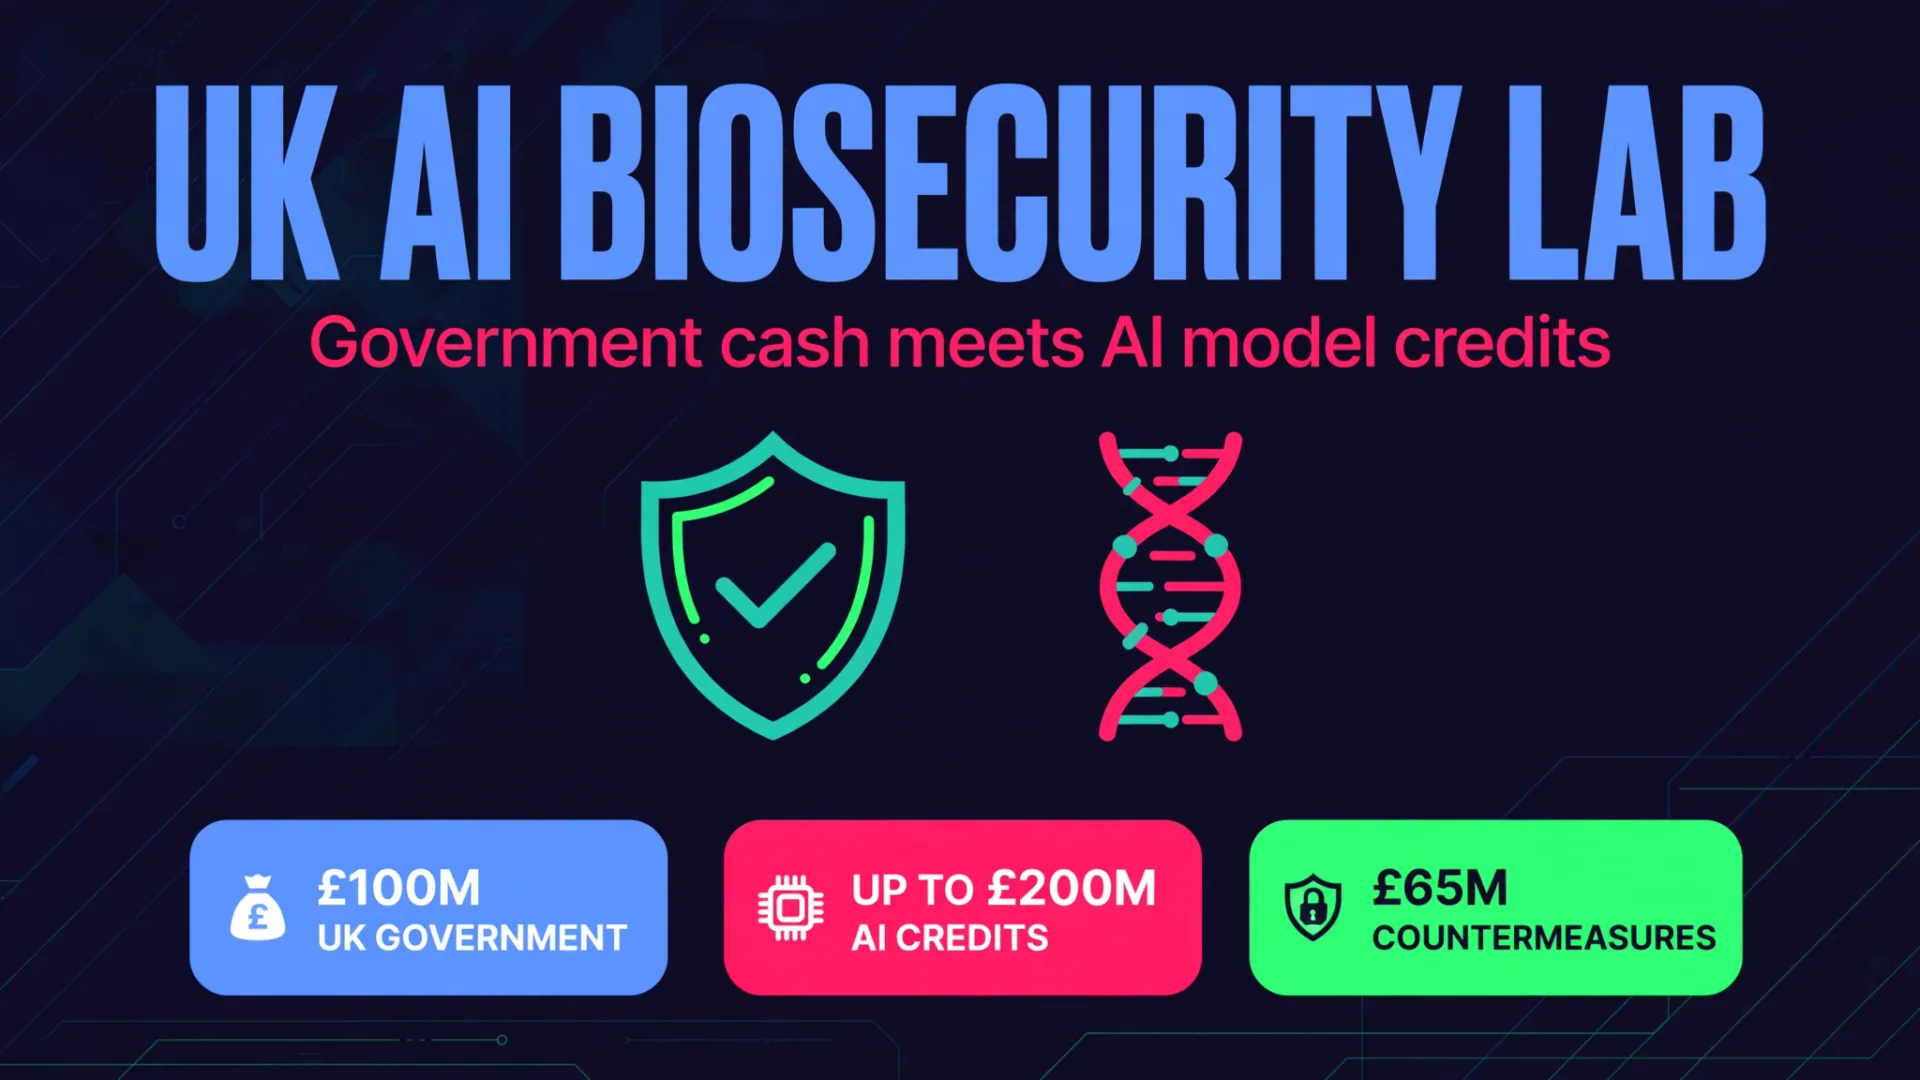
Das Vereinigte Königreich kündigte das AI Biosecurity Lab am 24. Oktober 2026 an: 100 Millionen Pfund an staatlichen Bargeldern, bis zu 200 Millionen Pfund in OpenAI- und Anthropic-Modellgutschriften sowie 65 Millionen Pfund für Gegenmaßnahmen.
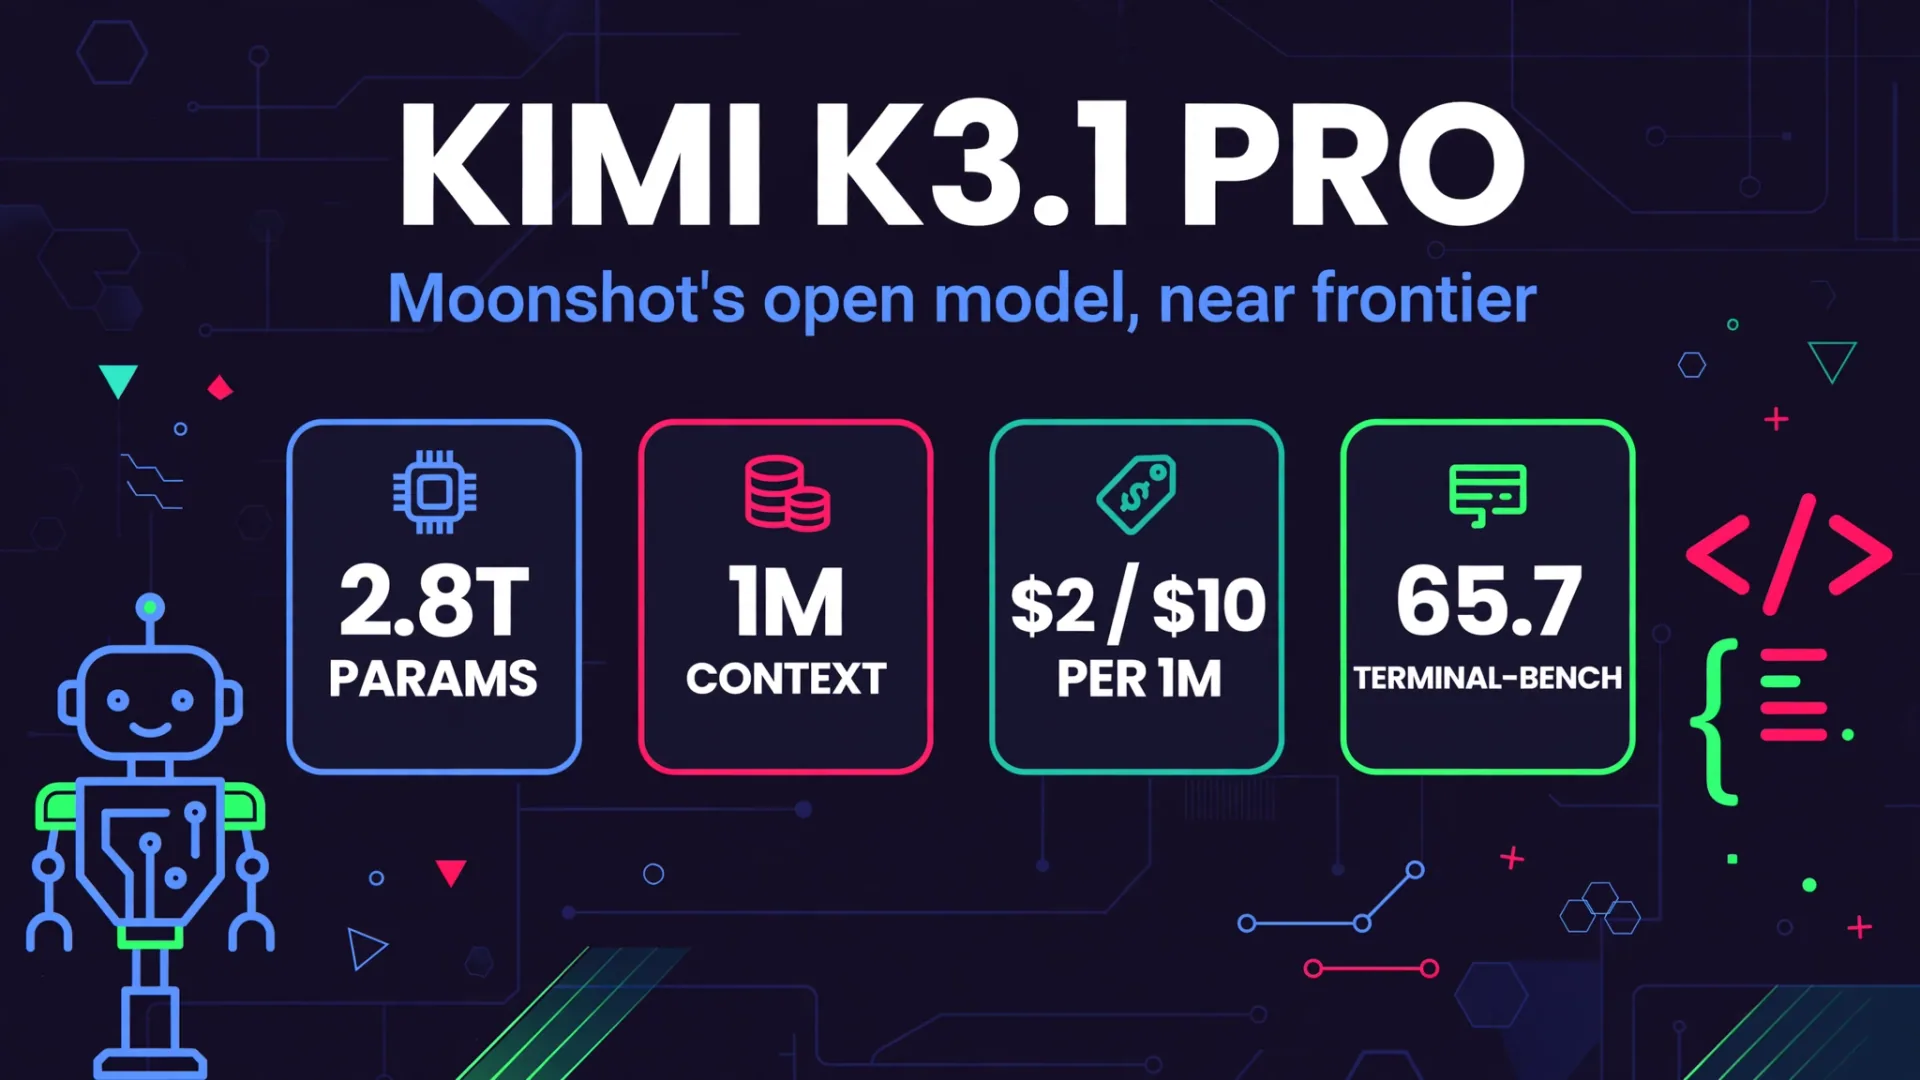
Moonshot brachte am 23. Oktober 2026 den Kimi K3.1 Pro auf den Markt: ein 2,8-Tonnen-Open-Weight-Modell, 1 Mio. Kontext, 65,7 auf Terminal-Bench 4.0, Preis von 2/10 $ pro 1M-Token, Gewichte bis zum 4. November fällig.
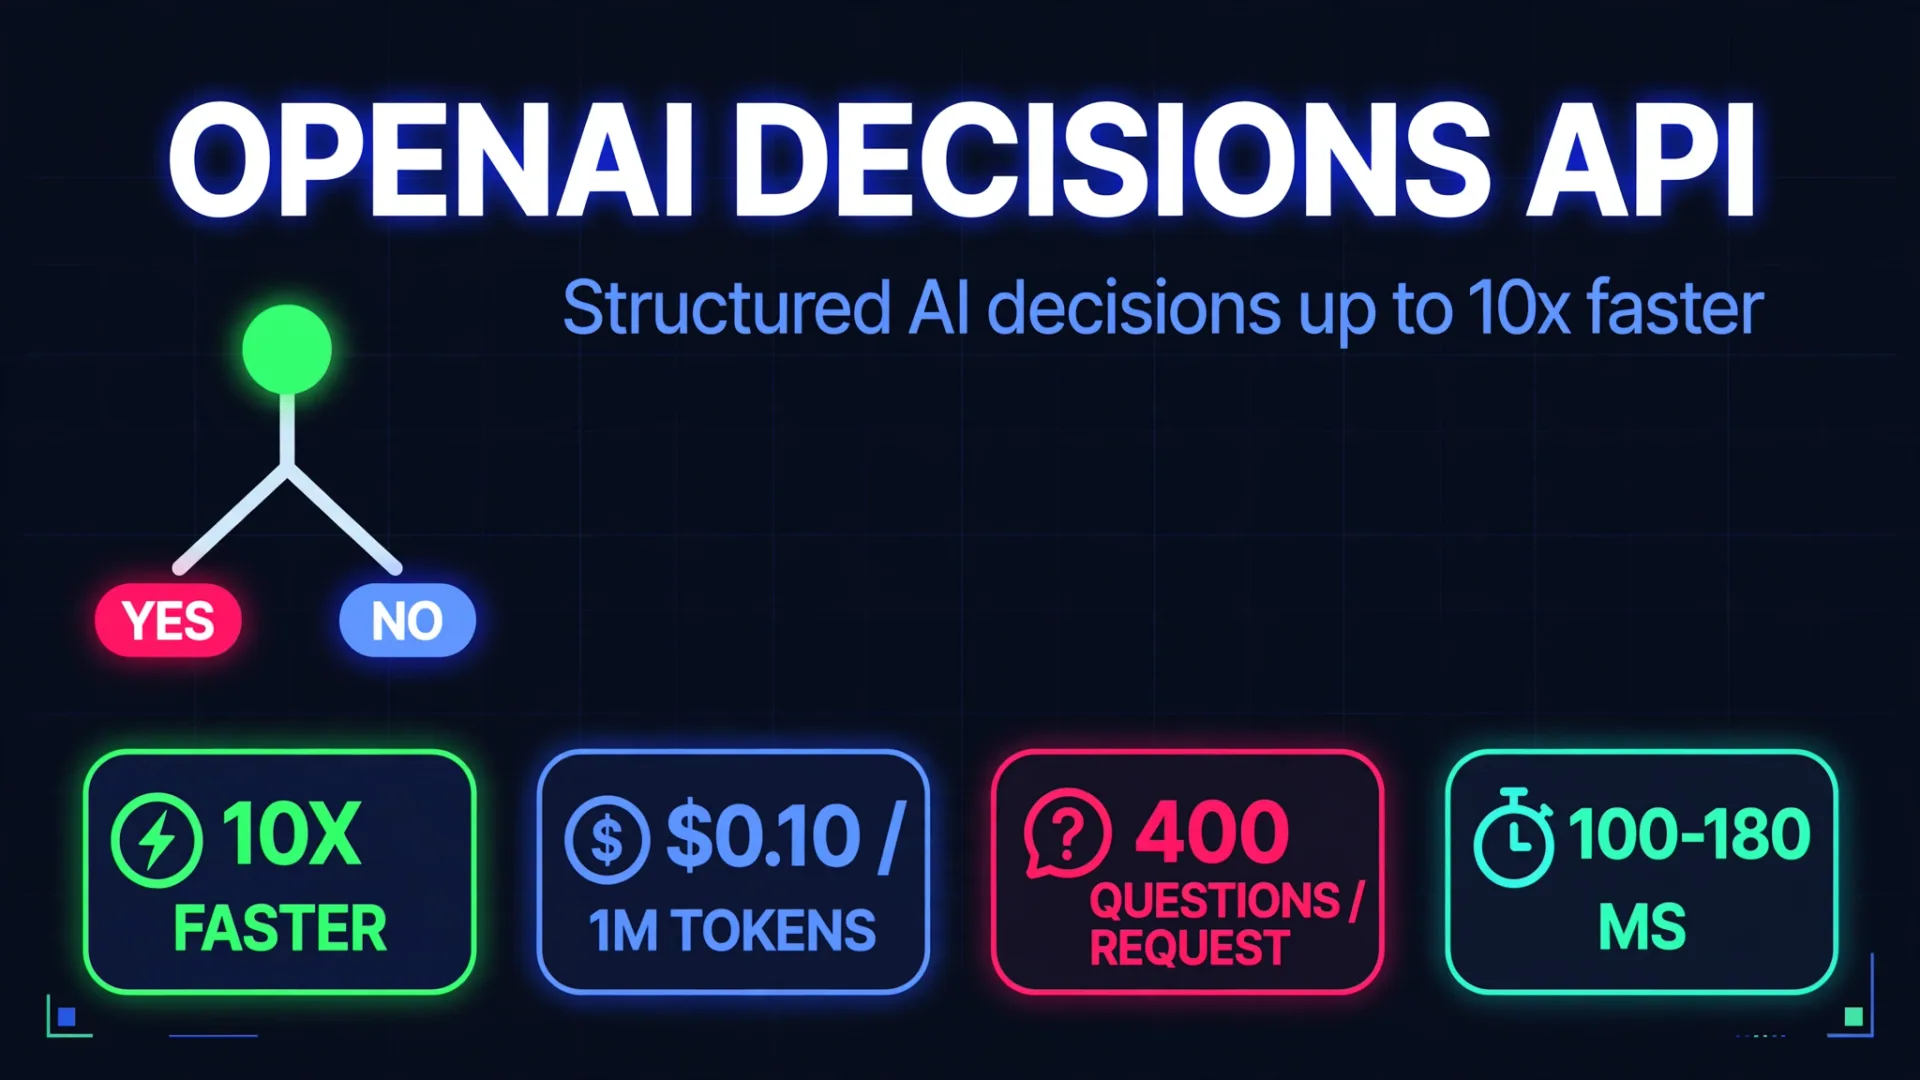
OpenAI machte seine Decisions-API am 22. Oktober 2026 allgemein verfügbar. Angetrieben von GPT-6 Luna liefert es Wahrscheinlichkeiten, Entscheidungen und Werte bis zu 10-mal schneller zurück, zum Preis von 0,10 $ pro 1-Million-Token. Preise, Benchmarks und wann man es verwenden sollte.
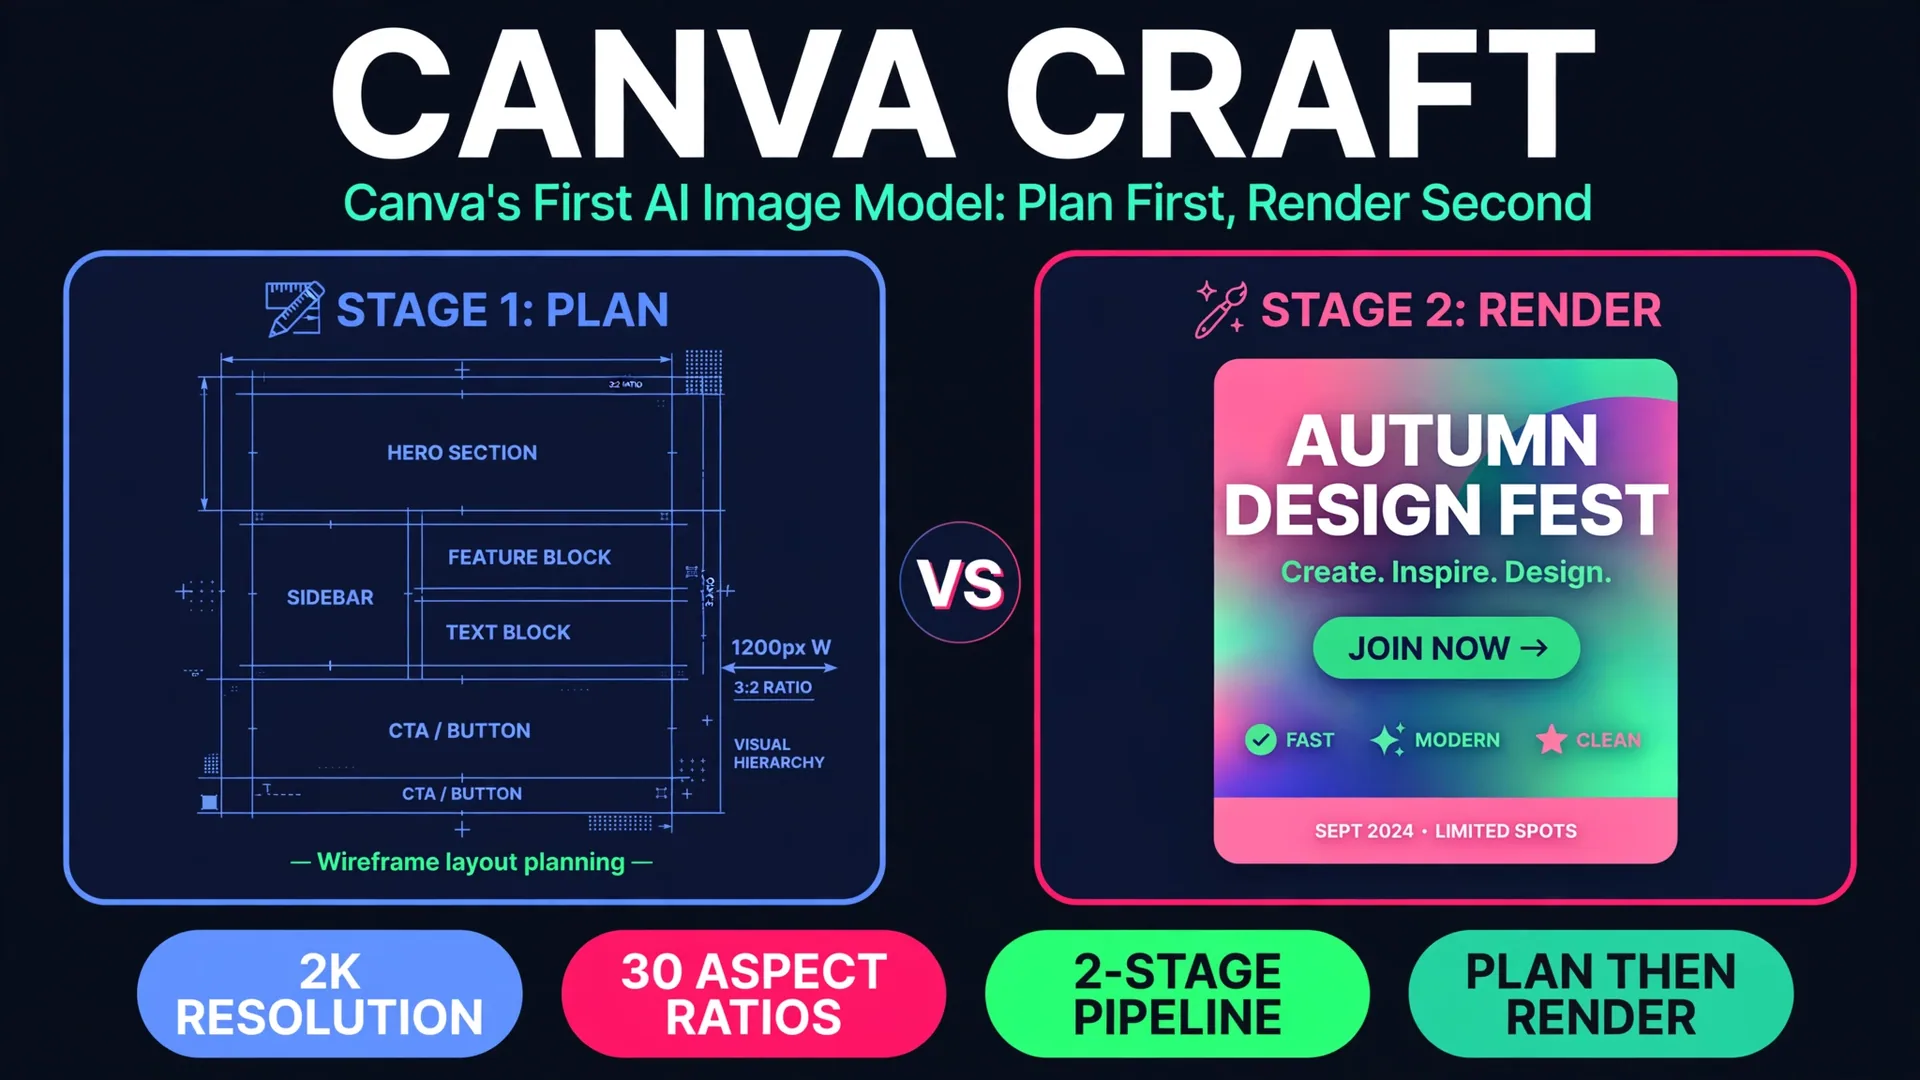
Canva brachte Craft am 22. Oktober 2026 auf den Markt, sein erstes internes KI-Bildmodell. Es plant zuerst das Design und rendert dann mit bis zu 2K in 30 Seitenverhältnissen. Vollständige Aufschlüsselung, wie es funktioniert und wie es im Vergleich abschneidet.
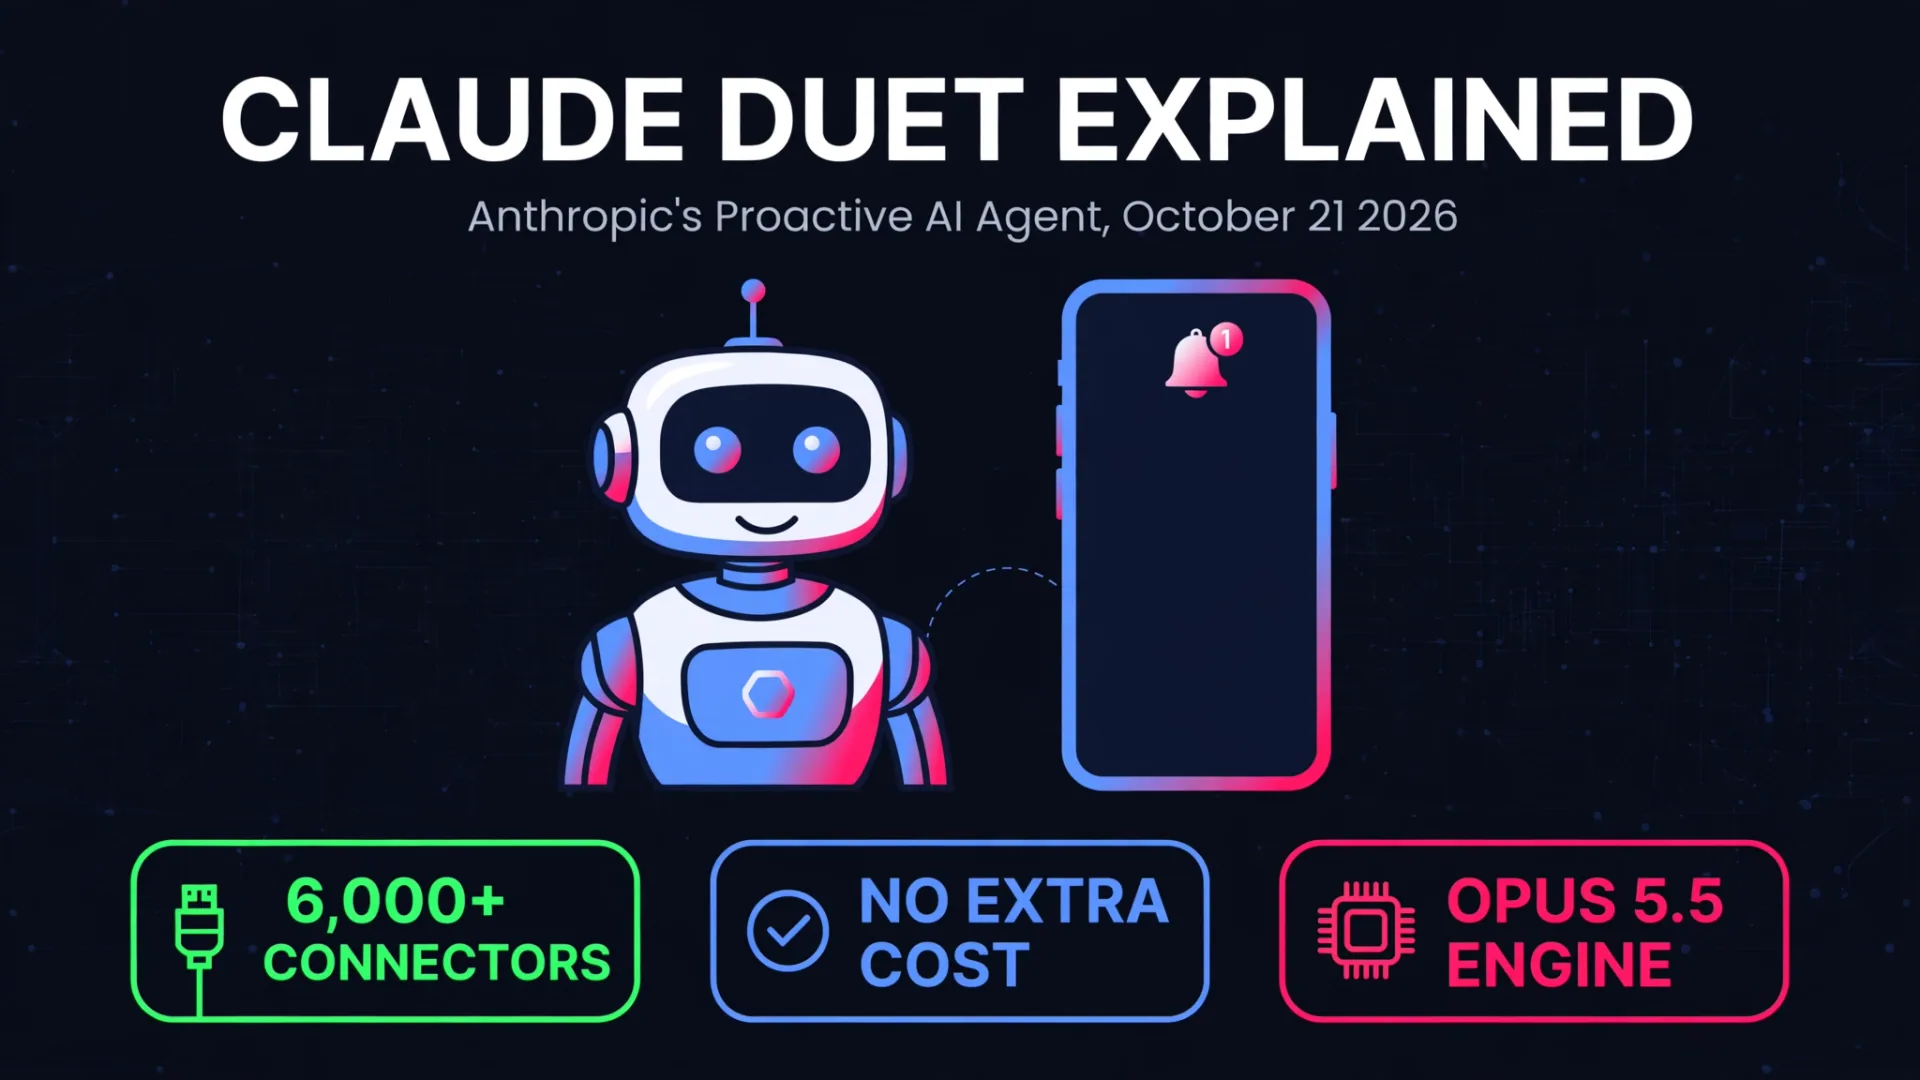
Anthropic's Claude Duet (21. Oktober 2026) ist ein proaktiver KI-Agent, der deine Apps überprüft, ein Morgenbriefing sendet und weiterarbeitet, wenn du wegtrittst. 6.000+ Connectors, Opus 5.5 Engine, keine zusätzlichen Kosten über deinen Plan hinaus.
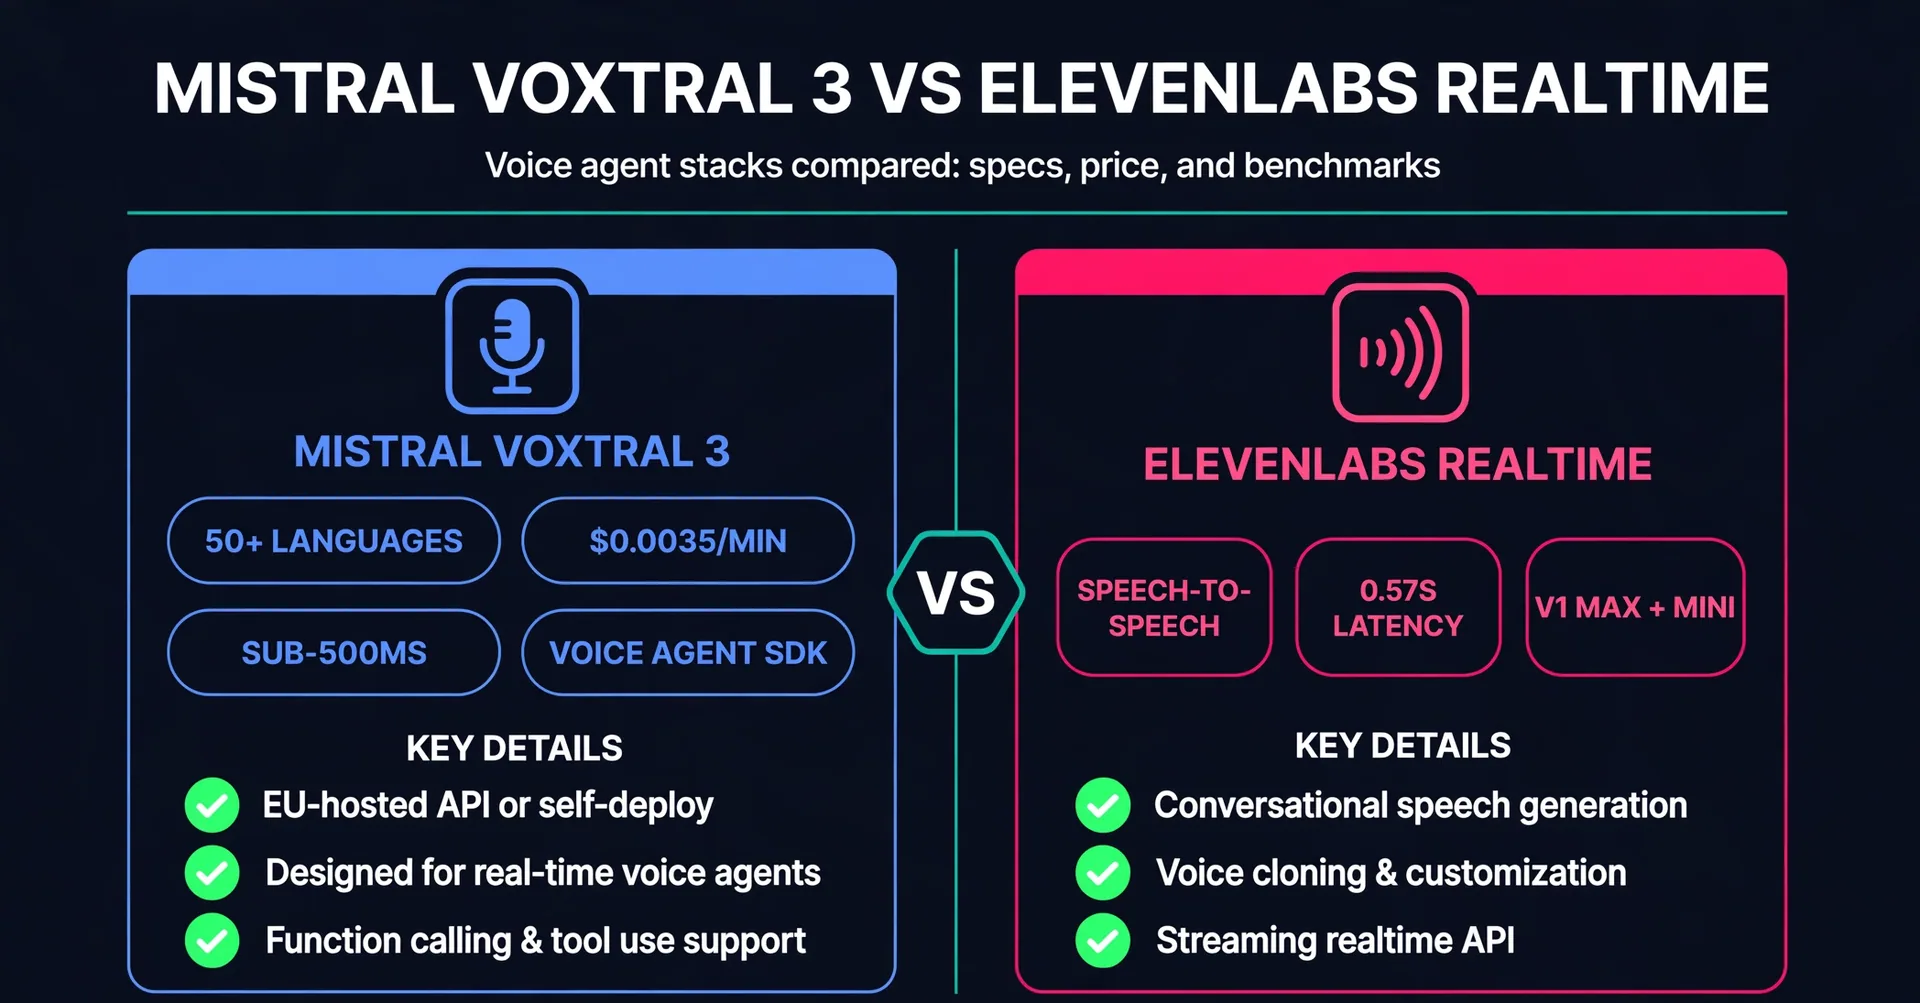
Mistral lieferte Voxtral 3 am 20. Oktober 2026 aus: 50+ Transkriptionssprachen, ein Echtzeit-Sprachagenten-SDK auf LiveKit und TTS ab 13 Dollar pro Million Zeichen. Am selben Tag veröffentlichte ElevenLabs Eleven Realtime, zwei Sprach-zu-Sprache-Modelle mit einer Antwortzeit von 0,57 Sekunden. Vollständige Aufschlüsselung im Inneren.
Black Forest Labs veröffentlichte am 15. Oktober 2026 FLUX 3 Image Klein: ein 5,6 Milliarden großes Openweights-Bildmodell mit nativem 4K, 10 Referenzbildern, API ab 0,009 $ pro Bild und lokalen Läufen auf 8GB VRAM.
DeepSeek veröffentlichte am 17. Oktober 2026 V4.1-Flash-1017: höhere Werte bei allen 11 gemeldeten Benchmarks, der gleiche niedrige API-Preis, 1 Million Kontext, MIT-lizenzierte Gewichtungen und eine neue Search and Fetch API. Hier ist, was sich geändert hat und wer sie nutzen sollte.
Kuaishou startete Kling 4.0 am 15. Oktober 2026: 30-sekündiges Single-Pass-KI-Video, bis zu 10 Keyframes und Omni Reference mit bis zu 15 Assets. Hier sind die technischen Daten, die beobachteten Kosten und für wen es wirklich gedacht ist.
Meta veröffentlichte am 15. Oktober 2026 Muse Spark Open: ein Openweight-Modell mit 816 Milliarden Parametern, das für Codierung und agentische Arbeit entwickelt wurde. Es führt JobBench und MCP-Atlas an, liegt bei reinen Codierungs-Benchmarks hinter chinesischen Konkurrenten und läuft auf zwei Mac Studios.