KI4 Min. LesezeitVon JH Akash
OpenAI Decisions API erklärt: Was GA für KI-Agenten bedeutet
OpenAI machte seine Decisions-API am 22. Oktober 2026 allgemein verfügbar. Angetrieben von GPT-6 Luna liefert es Wahrscheinlichkeiten, Entscheidungen und Werte bis zu 10-mal schneller zurück, zum Preis von 0,10 $ pro 1-Million-Token. Preise, Benchmarks und wann man es verwenden sollte.
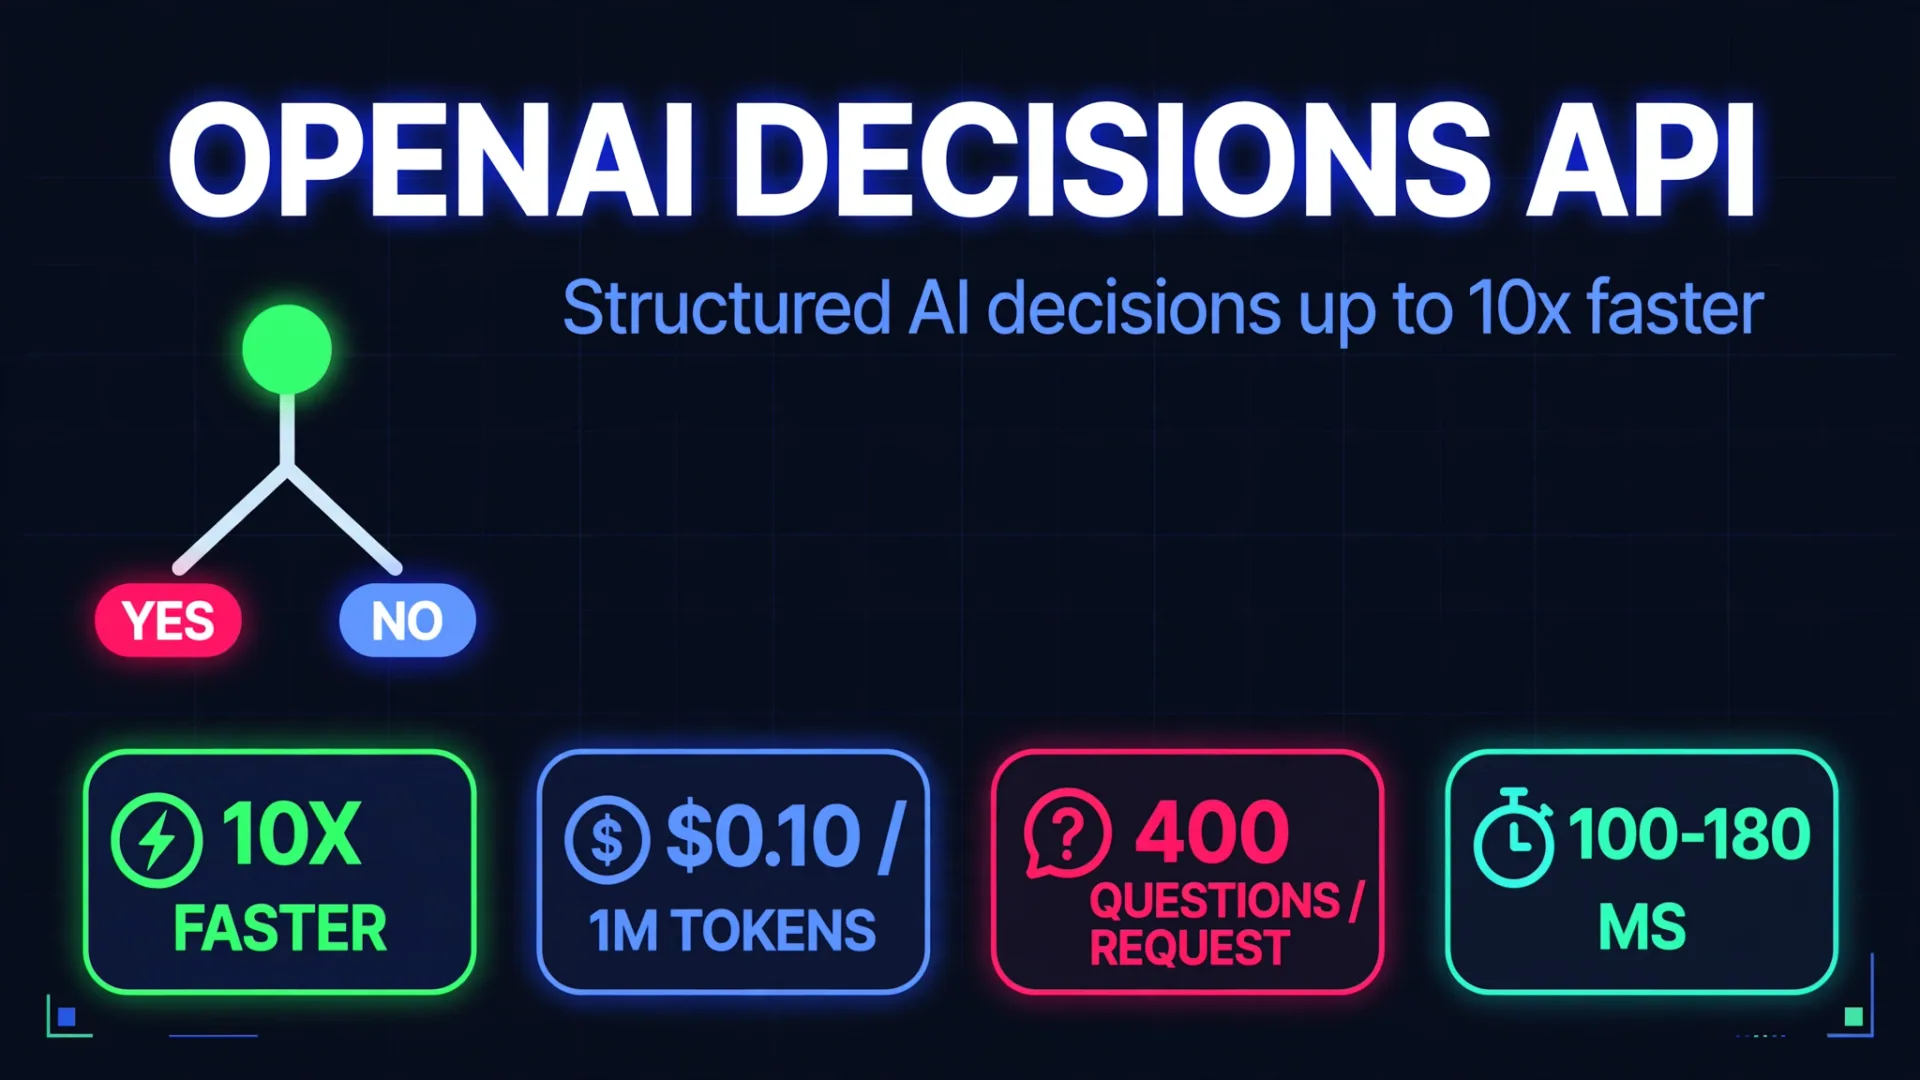
OpenAI hat seine Decisions-API allgemein verfügbar gemacht, eine Entwickleroberfläche, die von GPT-6 Luna angetrieben wird und Wahrscheinlichkeiten, Entscheidungen und Punktzahlen statt Textabsätzen zurückgibt. OpenAI sagt, dass es diese Entscheidungen bis zu zehnmal schneller als GPT-6 Luna über die Responses-API liefern kann, mit Eingabepreisen ab 0,10 $ pro 1 Million Token. Hier ist, was sich in der GA-Veröffentlichung vom 22. Oktober 2026 geändert hat, was es kostet und ob Ihre App es nutzen sollte.
Das kurze Urteil: Responses API vs Decisions API
| Aspekt | Responses API | Entscheidungs-API |
|---|---|---|
| Ausgabe | Offener Text | Wahrscheinlichkeit, Wahl oder Punktzahl |
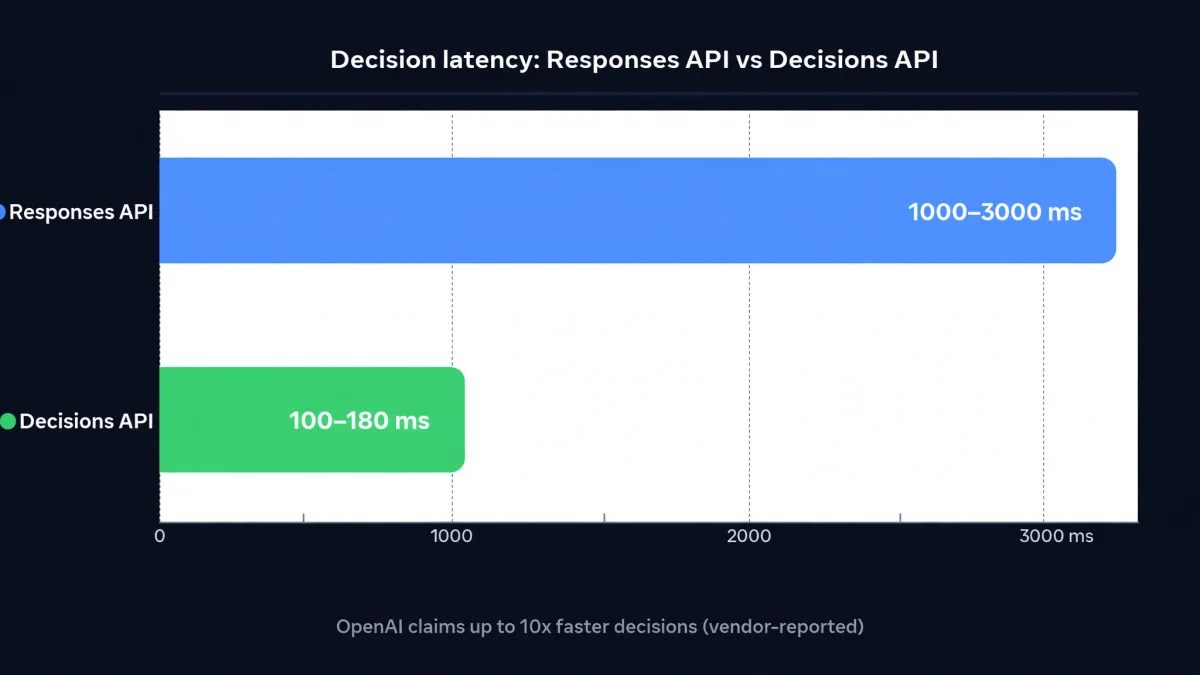
| Typische Entscheidungslatenz | 1 bis 3 Sekunden | 100 bis 180 ms (vom Anbieter gemeldet) |
| Input-Preisgestaltung | Standard-GPT-6-Luna-Raten | 0,10 $ pro 1 Million Eingabetoken |
| Am besten für | Argumentation, Erklärung, Werkzeugnutzung | Hochvolumenklassifikation, Routing, Scoring |
Was hat sich bei der GA-Veröffentlichung (22. Oktober 2026) geändert?
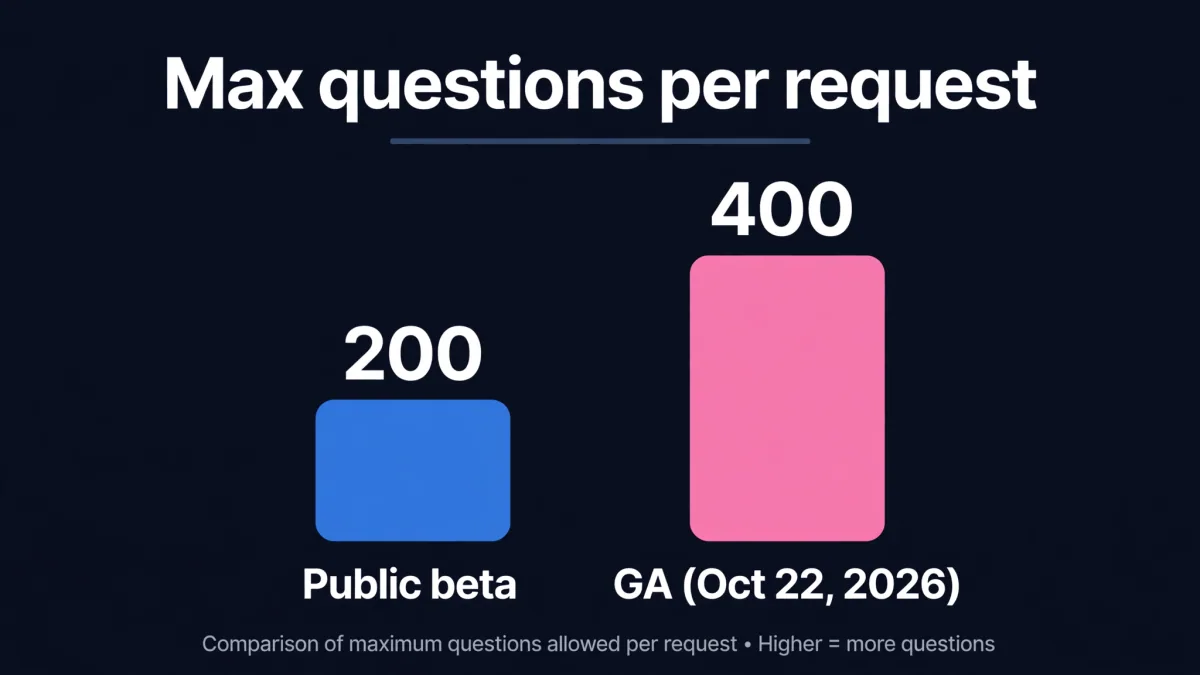
Die Decisions-API hatte vor der GA-Ankündigung eine öffentliche Beta, und die allgemein verfügbare Version verdoppelt das Key-Limit und fügt Produktionsfunktionen hinzu:
- 400 Fragen pro Anfrage, gegenüber 200 in der öffentlichen Beta
- Prompt-Caching, mit zwischengespeicherten Eingaben zu einem Preis von 0,01 $ pro 1 Million Tokens
- Native GPT-Live-Integration, sodass Live-Sprach-Apps Entscheidungen auslösen können, sobald Transkripte eintreffen.
- Strukturierte JSON-Eingabe sowie Bilder in Textanweisungen oder individuelle Frageanweisungen
- Inferenzwohnsitz in den USA und der EU, wobei für berechtigte Kunden keine Datenaufbewahrung verfügbar ist
- Ein dedizierter
/v1/decisions-Endpunkt und ein Entscheidungsspielplatz zum Experimentieren vor der Integration
Wie es funktioniert: Die drei Entscheidungstypen
Entwickler liefern drei Dinge: die zu bewertenden Informationen, die zu beantwortenden Fragen und das erlaubte Ausgabeformat. Die API unterstützt drei Entscheidungstypen.
| Entscheidungsart | Was es zurückgibt | Beispiel |
|---|---|---|
| Prädikat | Wahrscheinlichkeit, dass eine Bedingung wahr ist | Schätzen Sie, ob ein Paket beschädigt aussieht |
| Auswahl | Eine Auswahl aus vordefinierten Optionen | Leiten Sie ein Support-Ticket an die Abrechnung oder den technischen Support weiter. |
| Partitur | Punkte gegen geordnete Stufen | Bewerten Sie ein Problem als geringfügig, mittlere oder schwerwiegende |
Für Wahl- und Punktefragen liefert die API außerdem Wahrscheinlichkeitsinformationen und eine Konfidenzmaßnahme, sodass Teams sichere Fälle automatisieren und unsichere an einen menschlichen Prüfer weiterleiten können. Eine strukturierte Antwort garantiert keine korrekte Entscheidung: OpenAI und seine Kunden betonen, dass Entwickler ihre Fragen testen, die Genauigkeit messen und sinnvolle Schwellenwerte setzen müssen.
Preisgestaltung
| Komponente | Preis |
|---|---|
| Ungecachte Eingabe | 0,10 $ pro 1-Million-Token |
| Zwischengespeicherte Eingabe | 0,01 $ pro 1Million Token |
| Ausgabetoken | Keine separate Ausgabe-Token-Gebühr |
Cache-Schreibvorgänge, regionale Verarbeitungsprämien und Long-Context-Preisregeln können die Endrechnung beeinflussen, daher sollten Sie vor der Schätzung der Produktionskosten den offiziellen Preisleitfaden prüfen.
Die Geschwindigkeitsgeschichte, in Zahlen
Nikunj Handa, API-Produktleiter von OpenAI, sagte TechCrunch, das Unternehmen habe die Entscheidungsreaktionszeiten von ein auf drei Sekunden auf etwa 100 bis 180 Millisekunden reduziert. OpenAI behauptet, die API könne über die Responses-API bis zu zehnmal schneller sein als GPT-6 Luna und glaubt, dass weitere Optimierungen etwa 60 Millisekunden erreichen könnten.
Frühe Kunden haben ihre eigenen Ergebnisse veröffentlicht. Behandeln Sie diese als kundengemeldete, nicht als unabhängige Benchmarks:
| Gesellschaft | Gemeldetes Ergebnis |
|---|---|
| Box | Etwa fünfmal schnellere Routenauswahl über 30 Versicherungszertifikate, wobei die Genauigkeit dem Responses API-Ansatz entspricht |
| Datadog | 40-mal schnellere 95. Perzentil-Latenz für einen Command-Risk-Scoring-Workflow im Vergleich zu verfügbaren Frontier-Modellen |
| Sprich | Die Zeit zwischen den KI-Aktionen sank von 1,4 Sekunden auf 0,13 Sekunden, eine Verbesserung von mehr als 90 Prozent |
Auch der Wettbewerb bewegt sich
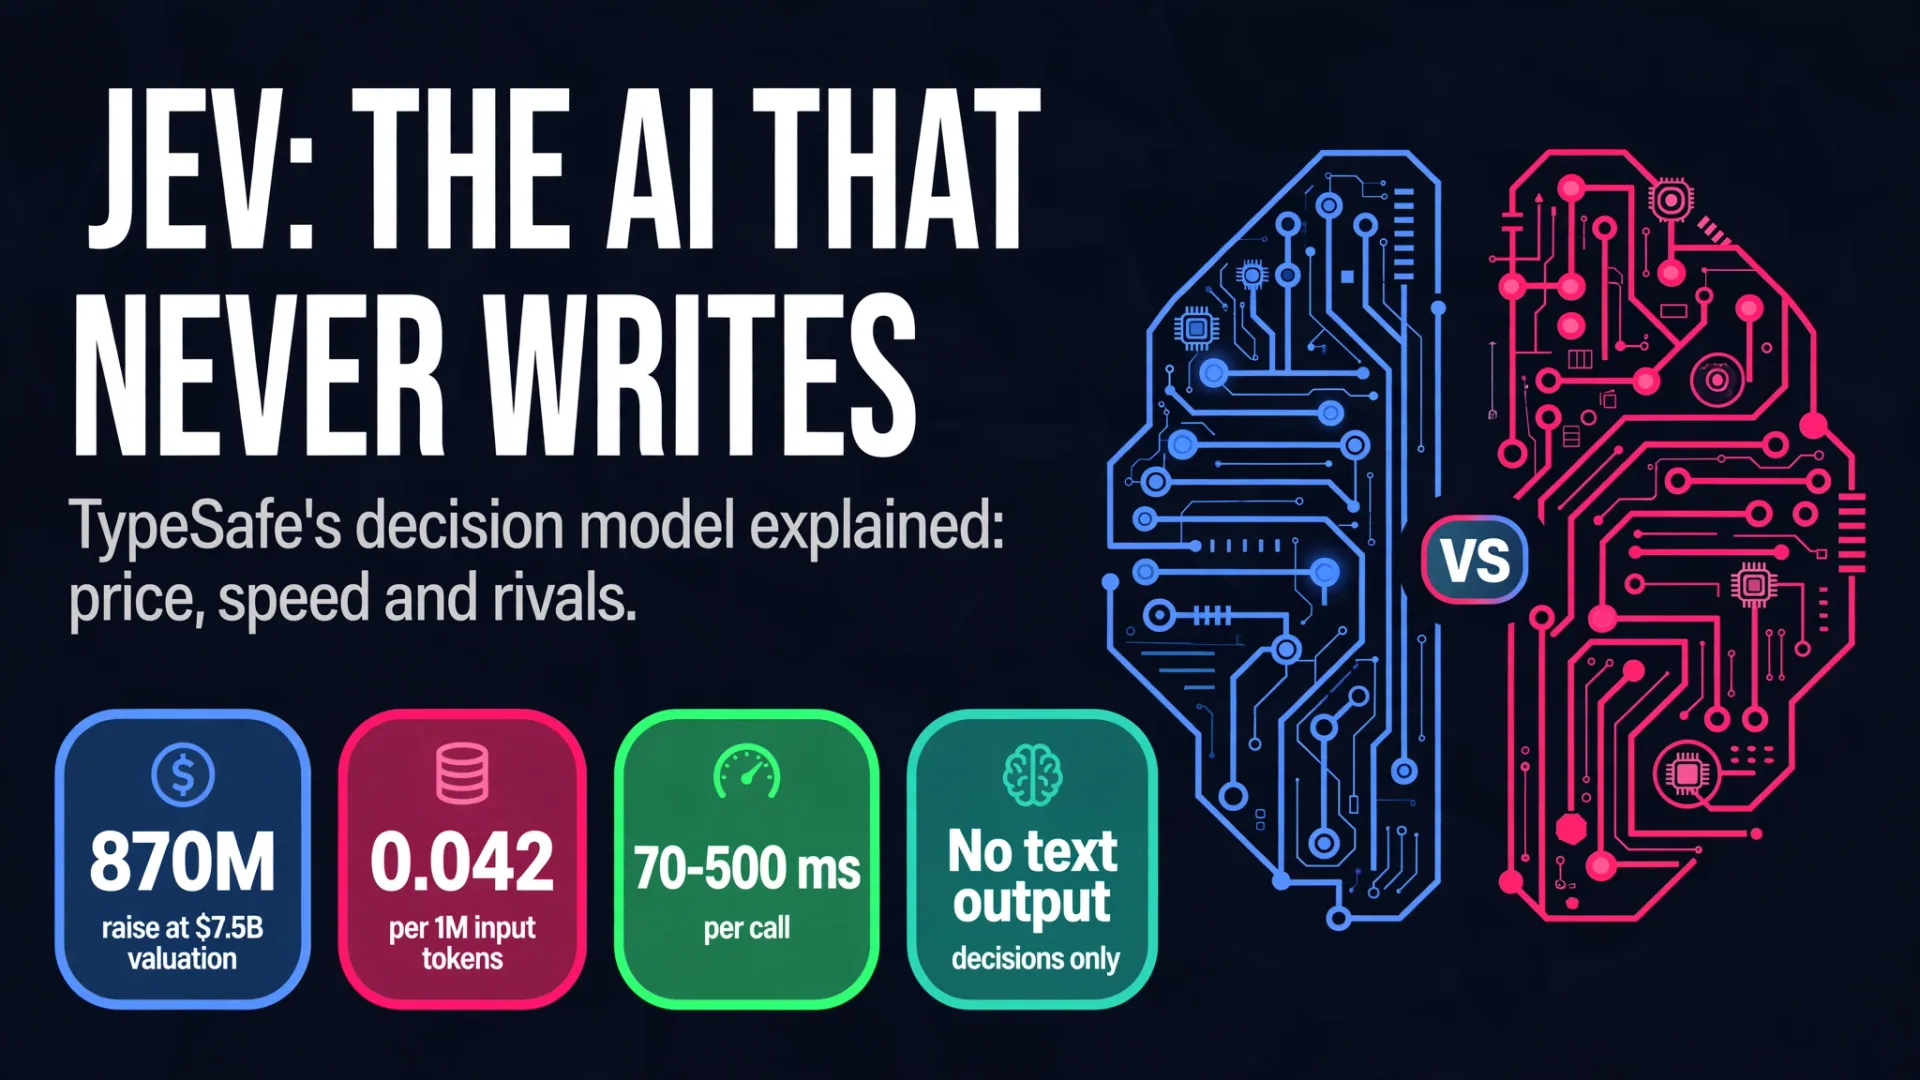
OpenAI ist im Rennen um Entscheidungsmodelle nicht allein. TypeSafe, das Startup hinter dem Jev-Entscheidungsmodell, hat kürzlich eine Bewertung von etwa 7,6 Milliarden US-Dollar erreicht und Jev mit Bildunterstützung und bedingten Entscheidungen erweitert. Liquid (D1 Ultra) und Base Lab (Elephant-1) liefern ebenfalls konkurrierende Modelle aus. Bei zwei öffentlichen Entscheidungsbenchmarks, die in der Launch-Berichterstattung berichtet wurden, belegte TypeSafe Jev den 7. und 3. Platz, während das Entscheidungsmodell von OpenAI den 8. und 14. Platz belegte. Die Rankings verschieben sich, wenn sich die Benchmarks aktualisieren, also behandeln Sie sie als Momentaufnahme, nicht als endgültiges Urteil.
Welches solltest du verwenden?
Nutzen Sie die Decisions-API, wenn Ihre Arbeitsbelastung hoch, wiederholbar und latenzempfindlich ist: Klassifizieren Sie Transaktionen, routingen Sie Support-Tickets, bewerten Sie Risiken oder entscheiden Sie über die nächste Maßnahme eines KI-Agenten. Bleiben Sie bei der Responses-API, wenn Sie Erklärungen, offene Generierung, Denkketten oder flexible Werkzeugnutzung benötigen. Viele Produktionssysteme nutzen beides, wobei Entscheidungen von der Decisions-API und allem anderen auf der Responses-API getroffen werden.
Wenn Sie Agenten-Workflows erstellen, ist genau diese Art von Rohrleitung entscheidend. CodeMyPixel entwickelt maßgeschneiderte KI-Agentenentwicklungslösungen und vollständige KI-Automatisierungssysteme für Teams, die Modelle brauchen, die echte Arbeit leisten und nicht nur Text generieren. Für den Modellkontext sehen Sie sich unsere Aufschlüsselungen von GPT-6 Astra und Claude Opus 5.5 an.
FAQ
Was ist die Entscheidungs-API von OpenAI?
Eine Entwickleroberfläche, die GPT-6 Luna nutzt, um Text, Bilder und strukturierte Daten auszuwerten und Wahrscheinlichkeiten, vordefinierte Entscheidungen oder Scores zurückzugeben, auf die Anwendungen direkt reagieren können.
Ist die Decisions-API wirklich zehnmal schneller?
OpenAI sagt, dass es über die Responses API bis zu 10-mal schneller als GPT-6 Luna sein kann. Das ist ein vom Hersteller gemeldetes Maximum, keine Garantie. Die tatsächliche Latenz hängt von der Eingabegröße, der Fragekomplexität, den Netzwerkbedingungen und der Arbeitsbelastung ab. Kundenberichtete Ergebnisse (Box bei 5x, Datadog bei 40x p95, Speak schnitt 1,4s auf 0,13s) sind spezifisch für ihre Bewertungen.
Wie viel kostet die Decisions-API?
Der veröffentlichte Grundpreis beträgt 0,10 $ pro 1 Million ungecachte Eingabetoken und 0,01 $ pro 1 Million zwischengespeicherte Eingabetokens, ohne separate Ausgabe-Token-Gebühr. Cache-Schreibungen und regionale Prämien können zusätzliche Kosten verursachen.
Kann die Decisions-API die Responses-API ersetzen?
Nicht für jede Aufgabe. Sie ist für gezielte Klassifizierung, Auswahl und Bewertung konzipiert. Die Responses-API bleibt die richtige Wahl für offene Textgenerierung, Argumentation und werkzeuggesteuerte Workflows.
Wann wurde die Decisions-API allgemein verfügbar?
- Oktober 2026, nach einer öffentlichen Beta. Die GA-Version hat das Limit pro Anfrage von 200 auf 400 verdoppelt und Prompt-Caching, native GPT-Live-Integration und strukturierte JSON-Eingaben hinzugefügt.
- openai decisions api
- gpt-6 luna
- ai agents
- openai api pricing
- llm latency