KI-Tools & Updates6 Min. LesezeitVon JH Akash
Reflexions-KI-Strahl: Das Open-Weight-Modell, das mit einem Viertel der Rechenleistung zu China übereinstimmt
Der Beam von Reflection AI ist ein 501B-Openweight-Modell, das GLM-5.2-Level-Argumentation bei 3- bis 4-mal weniger Rechenleistung beansprucht. Die Spezifikationen, die vom Unternehmen veröffentlichten Benchmarks und die KI-Fabrikstrategie wurden erklärt.
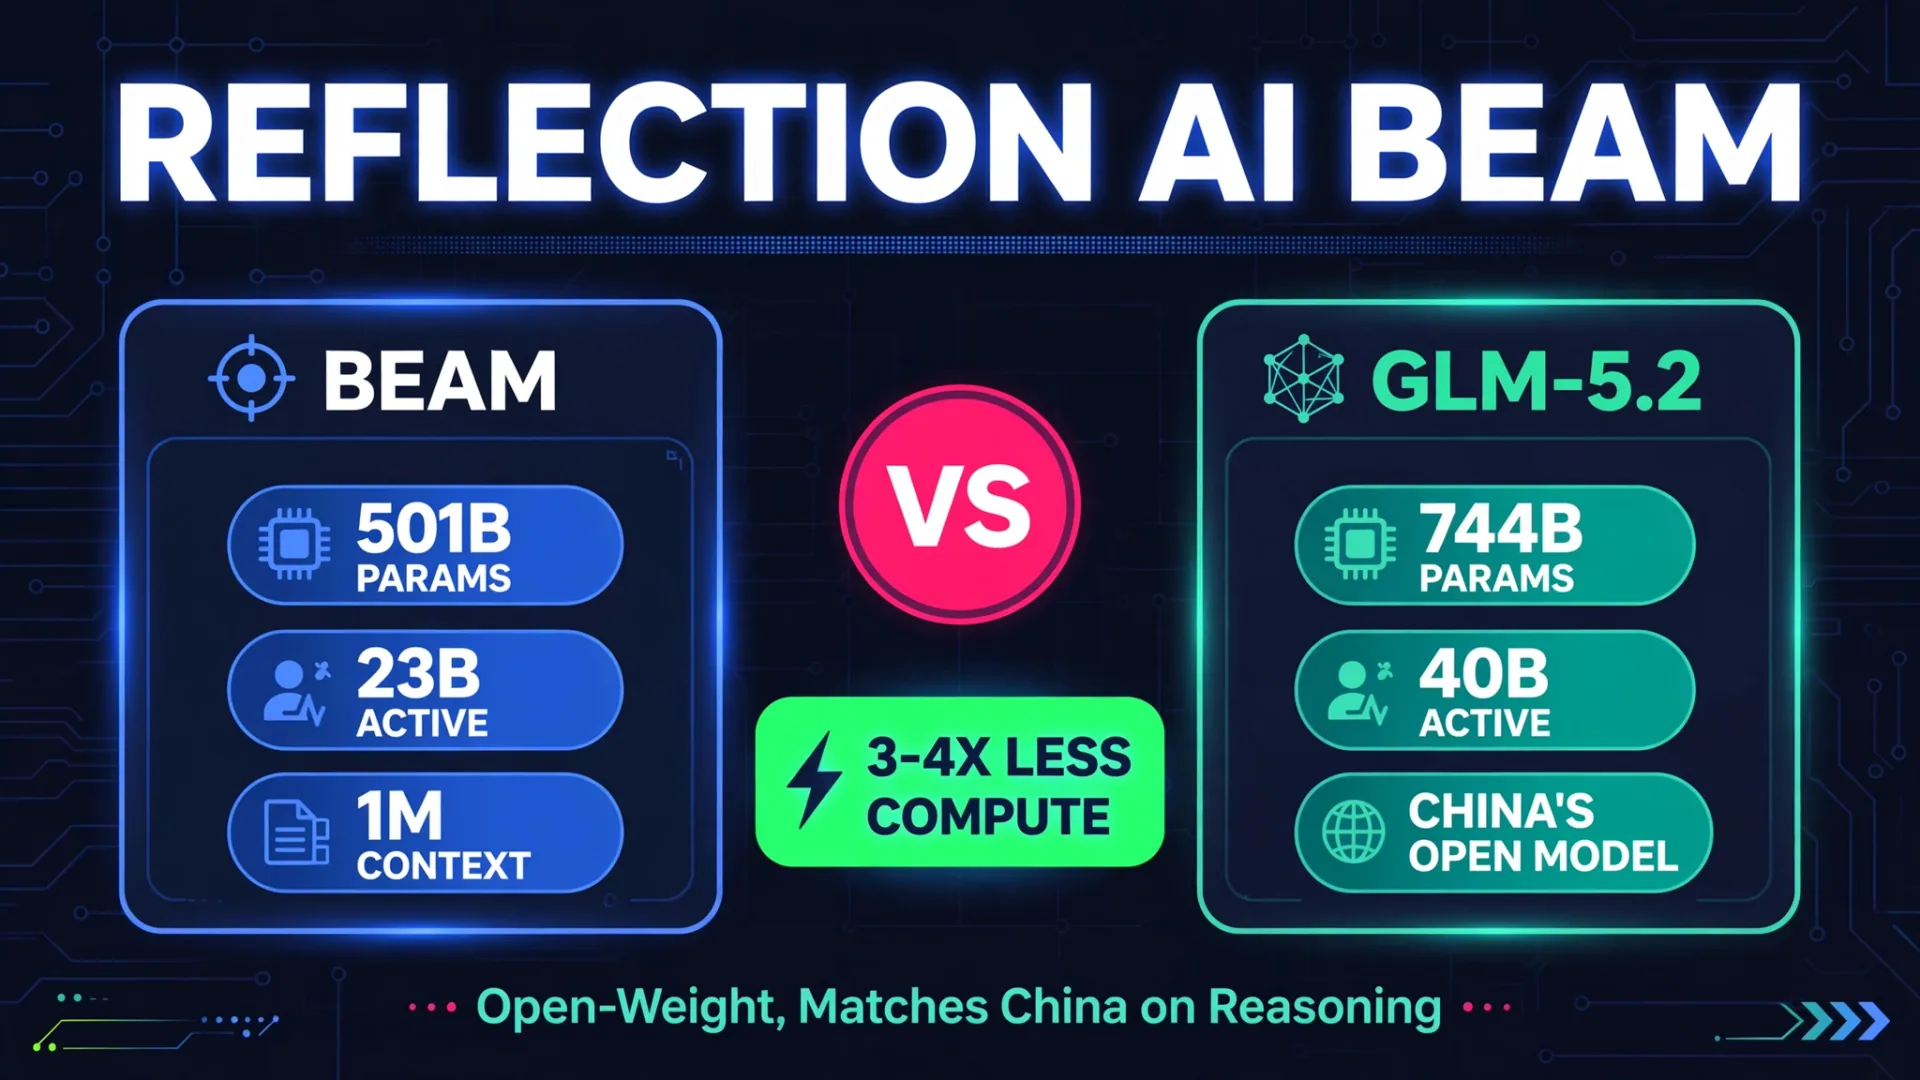
Ein neuer Herausforderer ist gerade in die Open-Weight-Arena eingetreten, und das brachte ein anderes Argument hervor als alle anderen. Am 5. Oktober 2026 stellte Reflection AI, ein zwei Jahre altes Startup aus Brooklyn, das von Nvidia unterstützt wird, Beam vor: ein Openweight-Modell mit 501 Milliarden Parametern, dessen Hauptbehauptung nicht auf roher Überlegenheit, sondern auf Effizienz basiert. Reflection sagt, Beam erreicht bei Advanced Reasoning-Benchmarks Z.ais GLM-5.2, einem der stärksten offenen Modelle Chinas, und verwendet dabei drei- bis viermal weniger Inferenzrechenleistung.
Wenn diese Behauptung Bestand hat, sobald die Gewichte öffentlich sind, ist sie wichtiger als eine weitere Bestenliste. Berechnung ist die Kosten jedes bedienten Tokens, daher ist ein Modell, das ebenfalls für ein Viertel der Berechnung argumentiert, ein Modell, das im großen Maßstab deutlich günstiger zu betreiben ist.
Kurzes Urteil
| Modell | Beam, von Reflection AI |
| Typ | Text-only-Mix-of-Experten (MoE), Open-Weight |
| Maßstab | Insgesamt 501 Milliarden Parameter, 23 Milliarden pro Token aktiv |
| Trainingsdaten | 23,8 Billionen Token |
| Kontextfenster | 1 Million Token |
| Schlagzeilenbehauptung | GLM-5.2-Klassen-Argumentation bei 3-4-facher Inferenzberechnung (Firmenbehauptung, noch nicht verifiziert) |
| Lizenz | Apache 2.0, Gewichte spät im Oktober 2026 fällig |
| Status | Angekündigt am 5. Oktober; früher Zugang durch Anmeldung; Gewichte noch nicht öffentlich |
Strahl vs. GLM-5.2: Die technischen Daten nebeneinander
| Spezifikation | Reflexionsstrahl | Z.ai GLM-5.2 |
|---|---|---|
| Gesamtparameter | 501B | ~744B |
| Aktive Parameter pro Token | 23B | 40B |
| Trainingsmarken | 23,8T | Nicht bestätigt von unseren Quellen |
| Kontextfenster | 1M Token | Nicht bestätigt von unseren Quellen |
| Modalität | Nur Text | Multimodal |
| Veröffentlichungsmodell | Apache 2.0 Gewichte, erwartet später im Oktober | Verfügbare Gewichte |
Benchmarks: Was Reflection veröffentlicht hat und was noch nicht verifiziert ist
Lesen Sie diesen Abschnitt mit einer Einschränkung: Jede untenstehende Punktzahl wird von Reflection vom Unternehmen veröffentlicht. Die Gewichte sind noch nicht öffentlich, daher hat kein unabhängiges Labor diese Zahlen überprüft. Betrachten Sie sie als Eröffnungsgebot von Reflection, nicht als feste Tatsache.
| Benchmark | Reflexionsstrahl | Z.ai GLM-5.2 |
|---|---|---|
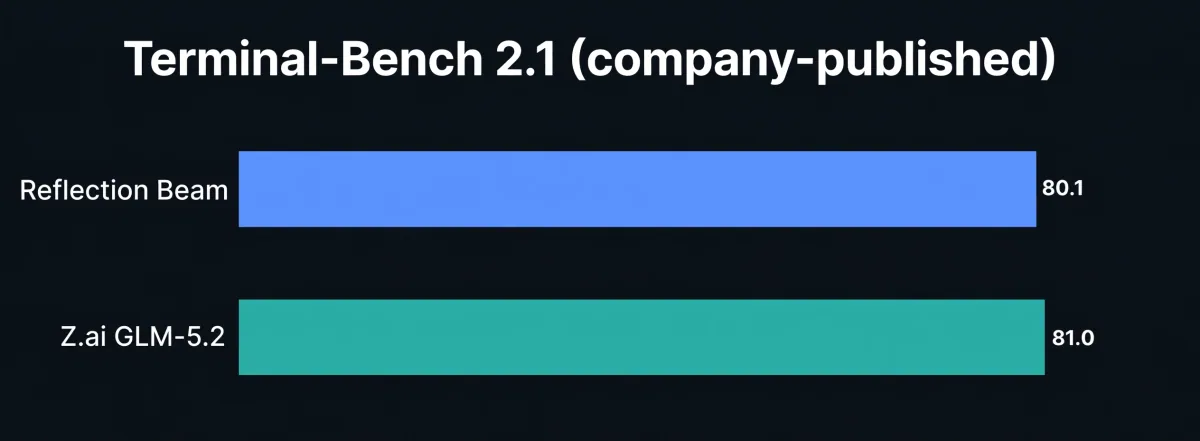
| Terminal-Bench 2.1 | 80.1 | 81.0 |
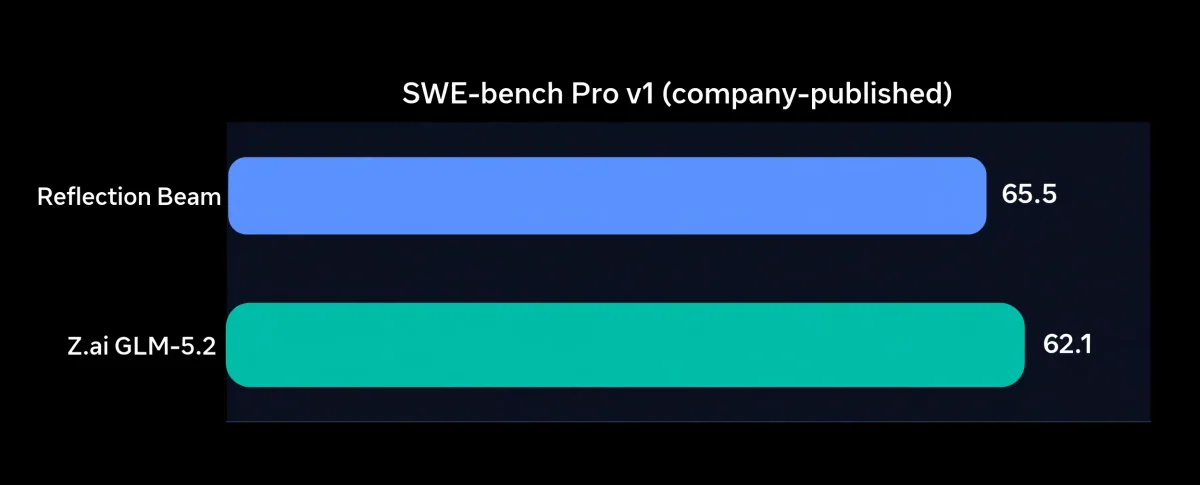
| SWE-Bench Pro v1 | 65.5 | 62.1 |
Auf Terminal-Bench 2.1, einem agentischen Benchmark für Terminalaufgaben, liegt Beam knapp hinter GLM-5.2 (80,1 vs. 81,0), und Reflections eigene Scorecard zeigt, dass er auch bei diesem Test hinter Kimi K3 und Qwen 3.8-Max zurückliegt. Bei SWE-bench Pro v1, einem Software-Engineering-Benchmark, liegt Beam knapp vor GLM-5.2 (65,5 vs 62.1).
Reflection behauptet außerdem, dass Beam bei vier Codierungstests, bei denen beide Labore Zahlen angeben, besser bewertet als Inkling, das offene Modell aus Mira Muratis Thinking Machines Lab veröffentlicht wurde. Beachten Sie die Asymmetrie: Inkling ist multimodal und Beam nur textbasiert, daher handelt es sich um einen reinen Code-Vergleich.
Und die Effizienz-Überschrift: Reflection sagt, diese Schlusswertewerte haben drei- bis viermal weniger Inferenzberechnung als konkurrierende westliche offene Modelle. Eine wichtige Fußnote aus der unabhängigen Berichterstattung: Die Schätzung von Reflection ist ein Modell-Compute-Vergleich, der auf Benchmark-Daten von Artificial Analysis und DataCurve basiert und Prompt-Prefill, Aufmerksamkeitsaufwand und Service-Kosten ausschließt. Lesen Sie also "3-4x weniger Compute" nicht als "3-4-mal günstiger für Sie", bis echte Liefer-Benchmarks verfügbar sind.
Wie Beam effizient wurde: Die Trainingsgeschichte
Reflection schreibt hochrechenfähiges Reinforcement Learning zu: Anstatt nur Parameter hinzuzufügen, wurde das Training so gestaltet, dass das Modell in weniger Schritten rationalisiert wird. Der berichtete Umfang ist beeindruckend: 10.500 Nvidia GB300 GPUs für einen vierwöchigen Reinforcement Learning Run, der laut der technischen Ankündigung von Reflection mehr als 100 Millionen Rollouts generierte.
Das Unternehmen sperrt außerdem die Hardware, um das Training fortzusetzen. Diesen Sommer unterzeichnete Reflection Rechenverträge im Wert von mehr als 7 Milliarden Dollar mit SpaceX und Nebius, wodurch der Zugang zu Nvidia GB300-Chips bis 2029 sichert wird.
Das Unternehmen hinter Beam
Reflection AI wurde 2024 von zwei ehemaligen Google DeepMind-Forschern gegründet und hat laut PitchBook etwa 4,7 Milliarden US-Dollar von Unterstützern wie Nvidia, Sequoia Capital und Lightspeed Venture Partners gesammelt. Die letzte Runde bewertete das Unternehmen mit einer Vor-Money-Bewertung von 25 Milliarden US-Dollar. Das ist eine enorme Kriegskasse für ein zwei Jahre altes Labor und zeigt, wie ernst Investoren die These der "westlichen Antwort auf DeepSeek und Qwen" nehmen.
Das Geschäftsmodell: KI-Fabriken, keine Chatbots
Reflection jagt nicht einem Verbraucher-Chatbot hinterher. Der Pitch lautet "KI-Fabriken": Unternehmen und souveränen Staaten die Möglichkeit zu verkaufen, eigene maßgeschneiderte, lokale KI-Systeme zu bauen, indem sie Reflections Modelle auf ihren eigenen proprietären Daten trainieren. Nvidia-CEO Jensen Huang, dessen Unternehmen Reflection unterstützt, setzt sich seit langem für die KI-Fabrik-Idee ein. Reflection hat bereits begonnen, eine Partnerschaft mit einer souveränen KI-Fabrik mit der Shinsegae Group in Südkorea zu testen, und Axios berichtet, dass Hedgefonds und Handelsfirmen zu den eifrigen frühen Kandidaten gehören.
Das ist eine kluge Lane. Reflection weiß, dass es Anthropic oder OpenAI nicht mehr als die Reichweite der Verbraucher verteilen kann, also verkauft es dort, wo offene Gewichte ein Merkmal und kein Kompromiss sind: regulierte Branchen und Regierungen, die das Modell innerhalb ihrer eigenen Mauern haben wollen.
Preis und Verfügbarkeit: Was es kosten wird
Es gibt noch keine öffentliche API-Preisgestaltung für Beam und keinen Token-Preis, den man in eine Tabelle eingeben kann. Hier ist, was wir wissen:
- Die Gewichte werden unter der Apache 2.0-Lizenz später im Oktober versprochen, was bedeutet, dass Sie selbst hosten können: Ihre Kosten sind Ihre eigenen Rechenleistungen, und die 3-4-fache Effizienzbehauptung ist die Preisgeschichte.
- Reflection beschreibt die Tokenkosten von Beam als "einen Bruchteil" der konkurrierenden Modelle, hat jedoch keine Dollar pro Million Token veröffentlicht.
- Die Distribution erfolgt über Hyperscaler und Neoclouds, mit Open-Source-Bibliotheksintegrationen zum Start, und der Early Access erfolgt derzeit per Anmeldung.
Wenn du heute budgetierst, bewerte es mit den Modellen, die du tatsächlich kaufen kannst: Googles Gemini 4 Argon nennt 2 Dollar pro Million Eingabetoken und 10 Dollar pro Million Ausgabe-Tokens, und Anthropic's Claude Sonnet 5.5 hält bei 2/10 Dollar. Beams Vorschlag ist, diese Preisklasse zu unterbieten, sobald sie verfügbar ist. Wir haben beide Modelle ausführlich behandelt: Gemini 4 Argon: Googles Comeback-Flaggschiff und Claude Opus 5.5, das leistungsstärkste KI-Modell.
Wen sollte sich kümmern und was jetzt zu tun ist
Unternehmen, die offene Gewichte wollen, ohne auf chinesische Labore angewiesen zu sein. Beam ist der erste ernsthafte westliche Versuch, die GLM-5.2-Klasse mit besserer Effizienz zu vergleichen. Warte auf den Gewichtsrückgang im Oktober und unabhängige Verifikation, bevor du darum herum planst.
Entwickler und Teams betreiben Agenten in großem Maßstab. Wenn der Anspruch auf 3-4x Compute unabhängige Tests übersteht, könnte Beam die Bereitstellungskosten für Coding- und agentische Workloads erheblich senken. Bis dahin sollten Sie Ihren aktuellen Stack behalten.
Jeder, der KI-Agenten für das Geschäft baut. Open Weights plus starke agentische Benchmark-Scores sind genau die Kombination, die selbstgehostete Agenten wirtschaftlich macht. Wenn Sie diesen Weg erkunden, sehen Sie sich unsere AI-Agentenentwicklungsdienste an und wie Sie eine KI-Automatisierungsagentur engagieren.
FAQ
Was ist ein Reflection AI Beam?
Beam ist das erste Frontier-Openweight-KI-Modell von Reflection AI, einem von Nvidia unterstützten Startup, das 2024 von zwei ehemaligen Google DeepMind-Forschern gegründet wurde. Es handelt sich um ein reines Text-Mix-of-Experten-Modell mit insgesamt 501 Milliarden Parametern und 23 Milliarden aktiven Token pro Token.
Wann werden die Gewichte von Bam veröffentlicht?
Reflection sagt, dass die Gewichte, vollständige technische Details, ein technischer Bericht und die Entwicklertools später im Oktober 2026 unter der Apache 2.0-Lizenz veröffentlicht werden. Mit der Ankündigung vom 5. Oktober sind sie noch nicht öffentlich.
Ist Beam besser als Z.ais GLM-5.2?
Auf Reflections selbst veröffentlichter Scorecard liegt Beam bei Terminal-Bench 2.1 leicht hinter GLM-5.2 zurück (80,1 vs 81,0) und bei SWE-Bench Pro v1 leicht (65,5 vs 62,1). Reflections eigentliche Behauptung ist Effizienz: Ähnliche Argumentation bei 3-4-mal weniger Inferenzberechnung. Nichts davon ist bisher unabhängig verifiziert.
Wie viel kostet die Nutzung von Beam?
Es wurde keine öffentliche Preisgestaltung bekannt gegeben. Da die Gewichte Apache 2.0-Lizenz haben, können Organisationen selbst hosten und nur ihre eigenen Rechenkosten zahlen.
Unter welcher Lizenz wird Beam veröffentlicht?
Apache 2.0, laut Reflection. Das ist eine permissive offene Lizenz, die kommerzielle Nutzung und Änderung erlaubt.
Wer hat Reflection AI gegründet?
Zwei ehemalige Google DeepMind-Forscher gründeten das Unternehmen im Jahr 2024. Es hat laut PitchBook etwa 4,7 Milliarden US-Dollar gesammelt, wobei Nvidia, Sequoia Capital und Lightspeed unter den Unterstützern zählen.
Ist Beam multimodal?
Nein. Beam ist nur textbasiert. Das sollte man sich merken, wenn man es mit multimodalen offenen Modellen wie Inkling vergleicht.
Was ist die "KI-Fabrik"-Strategie von Reflection?
Anstelle eines Konsumprodukts plant Reflection, Unternehmen und Regierungen komplette lokalisierte KI-Systeme, sogenannte "KI-Fabriken", zu verkaufen, die auf seinen Modellen basieren und auf den proprietären Daten des Kunden trainiert sind. Ein Pilotprojekt mit der südkoreanischen Shinsegae Group ist bereits im Gange.
- Reflection AI
- Beam
- open-weight AI
- GLM-5.2
- AI benchmarks
- AI news