KI8 Min. LesezeitVon JH Akash
Eine robots.txt Regel zum Abmelden von KI-Training erklärt
Am 30. Oktober 2026 unterstützten OpenAI, Google, Microsoft und Anthropic ein robots.txt Token, um sich von KI-Training abzumelden. Daten, Limits und der genaue Code.
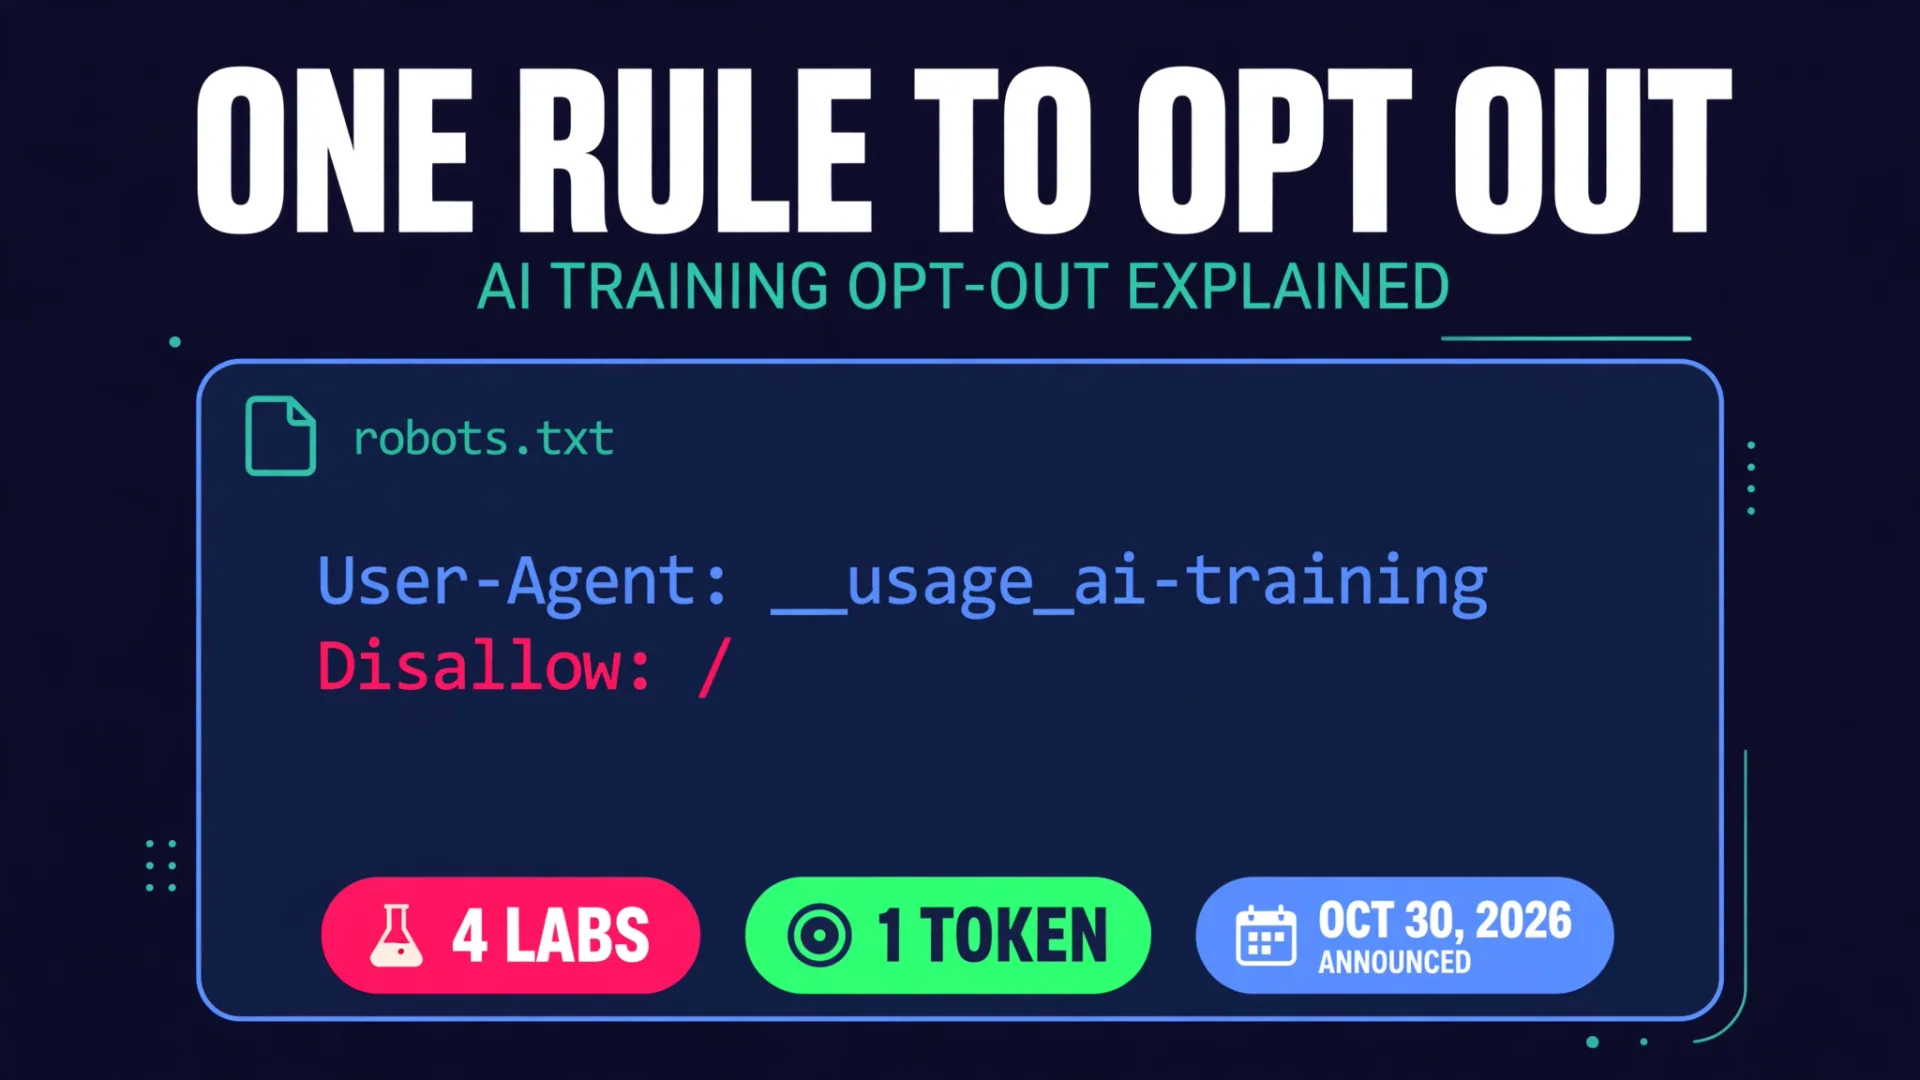
Am 30. Oktober 2026 taten vier der größten KI-Labore etwas Ungewöhnliches: Sie einigten sich auf dieselbe Regel. OpenAI, Google, Microsoft und Anthropic sagten alle, sie würden einen gemeinsamen robots.txt-Token, _usageai-training, akzeptieren, der es einer Website erlaubt, in einem einzigen Schritt auf KI-Training zu verzichten. Bis jetzt musste ein Publisher, der aussteigen wollte, den Crawler jedes Unternehmens nach Namen blockieren: GPTBot, Google-Extended, ClaudeBot und einer wachsenden Liste weiterer. Diese Ankündigung fasst diese Aufgabe in einen einzigen Eintrag zusammen.
Der Haken liegt im Timing und im Kleingedruckten. Nur Anthropic gibt an, bereits mit der Implementierung von Support begonnen zu haben. Microsoft startet am 1. Februar 2027. Google strebt 2027 an. OpenAI sagt "in den kommenden Monaten" ohne Datum. Und das Signal ist freiwillig, es umfasst nur Schulungen und tut nichts an Inhalten, die bereits gesammelt oder trainiert wurden. Das ist also ein echter Koordinationsschritt, kein sofortiger Ausschalter.
Das schnelle Urteil
| Frage | Antwort |
|---|---|
| Was wurde angekündigt? | Ein gemeinsamer robots.txt Policy-Token, _usageai-training, um sich von KI-Training abzumelden. |
| Angekündigt | 30. Oktober 2026 |
| Unterstützt von | OpenAI, Google, Microsoft und Anthropic |
| Der Code | User-Agent: _usageai-training, dann Disallow: / |
| Entwurf dahinter | IETF Internet-Entwurf "Maschinenlesbares Trainingspräferenzsignal" von Kevin Kelley von Anthropic, datiert auf 30. Oktober 2026 |
| Status des Drafts | Ein einzelner Entwurf, nicht vom IETF gebilligt, ohne formalen Status, der am 3. Mai 2027 abläuft, sofern er nicht aktualisiert wird |
| Was es abdeckt | Nur KI-Training, nicht Crawling, Suche oder KI-Antworten |
| Was es nicht tut | Entfernen Sie bereits gesammelte oder bereits in ein Modell trainierte Inhalte |
| Wer kann es benutzen | Jeder Website-Besitzer, indem er das Token zu robots.txt |
| Was man vorerst behalten sollte | Ihre bestehenden unternehmensspezifischen Regeln, wie Google-Extended, weil der gemeinsame Token größtenteils noch nicht live ist |
Der genaue Code
Füge diesen Block zu deinem robots.txt hinzu, wenn du auf deiner gesamten Seite auf die Schulung verzichten möchtest:
User-Agent: __usage_ai-training
Disallow: /
Um alles außer einem Ordner abzuwählen, fügt das Entwurfsbeispiel eine Erlaubniszeile hinzu:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Zwei Details sind wichtig. Erstens muss das Token exakt übereinstimmen, abgesehen vom Buchstabenfall. Eine generische User-Agent: * Gruppe zählt nicht, und wenn keine Gruppe das Token nennt, hat die Seite keine Präferenz angegeben. Zweitens können Sie sich auf nur einige Ordner und nicht auf die gesamte Seite entscheiden, indem Sie auf den Pfaden, die Sie schützen möchten, auf Disallow verwenden.
Wer es ehrt und wann
| Gesellschaft | Was es sagt | Timing |
|---|---|---|
| Anthropic | Hat begonnen, Unterstützung für das geteilte Token zusammen mit den bestehenden Kontrollen zu implementieren | Bereits begonnen, die Ausrollung über alle Dienste hinweg benötigt Zeit |
| OpenAI | Wird ein gemeinsames robots.txt-Signal für grundlegendes generatives KI-Training respektieren, bestehende Crawler-Steuerungen funktionieren weiterhin | In den kommenden Monaten wird kein Datum genannt |
| Microsoft | Wird die Trainingspräferenz respektieren, dazu eine separate KI-Erdungspräferenz und Seitenebene-Steuerungen | 1. Februar 2027, während Seiten neu gecrawlt werden |
| Plant, ein Opt-out so zu behandeln, als hätte der Publisher Google-Extended nicht zugelassen, es sei denn, Google-Extended wird direkt eingestellt | Ziele für 2027 |
Microsoft geht am weitesten. Es fügt eine Trainingseinstellung auf Seitenebene und eine separate Erdungseinstellung hinzu, die entscheidet, ob eine Seite Live-KI-Antworten in Bing, Copilot und Microsoft 365 liefern kann. Eine dritte Option, DisallowExtended, erlaubt Erdung in Microsofts eigenen Produkten, aber nicht in den Erdungsservices, die es an andere Unternehmen verkauft. Microsoft sagt außerdem, dass eine Seite einen Bingbot-Metatag, ai-training:disallow oder einen X-Robots-Tag-Header tragen kann, der robots.txt überschreibt. Seiten, die auf Bings alten NoArchive- und NoCache-Tags angewiesen sind, sollten bis zum 1. März 2027 auf die neuen Präferenzen umsteigen, danach werden die alten Tags nicht mehr als Trainings- oder Erdungspräferenz gelesen.
Googles Details lohnen sich sorgfältig zu lesen. Wenn Sie das geteilte Token zum Abmelden verwenden und Google-Extended nicht erwähnen, plant Google, dies als Blockierung von Google-Extended zu behandeln. Wenn Sie jedoch ausdrücklich Google-Extended erlauben, sagt Google, dass diese Seite weiterhin berechtigt bleibt, durch die Verankerung in Gemini-App-Antworten angezeigt und Klicks zu erhalten. Mit anderen Worten: Die Option für das Opt-out und die Sichtbarkeit sind verknüpft, also setzen Sie beide bewusst.
Wichtige Daten, gezählt aus der Ankündigung
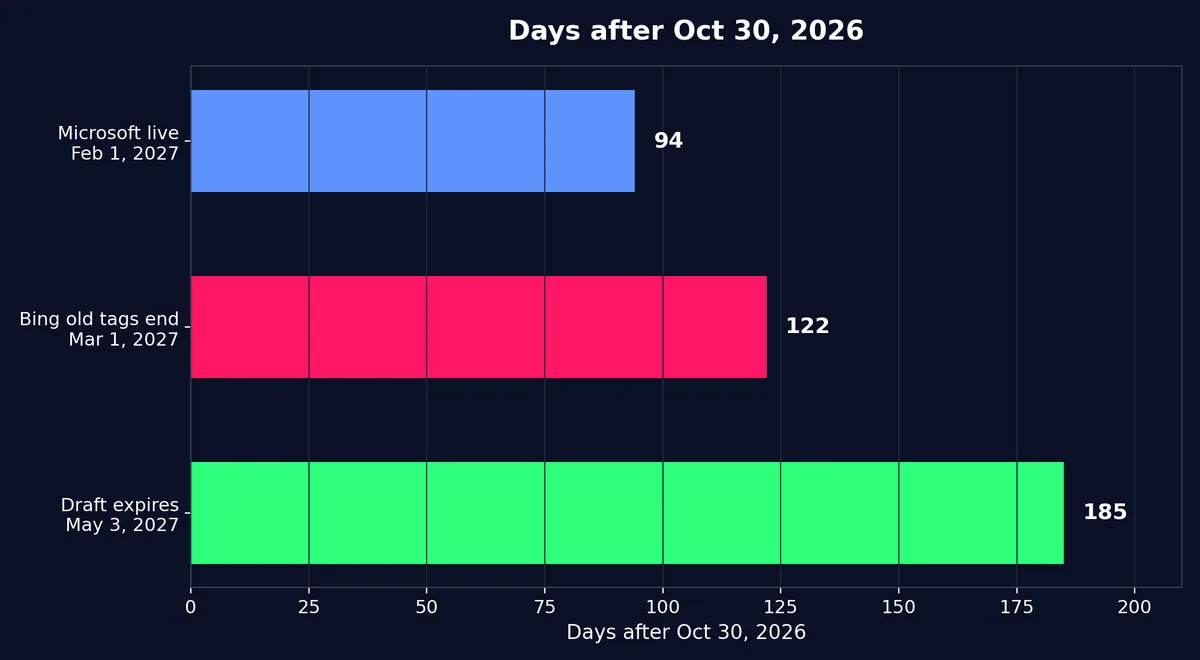
| Datum | Was passiert | Tage nach dem 30. Oktober 2026 |
|---|---|---|
| 30. Oktober 2026 | Gemeinsamer Token von allen vier Laboren angekündigt | 0 |
| 1. Februar 2027 | Microsoft beginnt, die neuen Präferenzen zu respektieren | 94 |
| 1. März 2027 | Bing hört auf, alte NoArchive- und NoCache-Tags als Trainings- oder Erdungseinstellungen zu lesen | 122 |
| 3. Mai 2027 | Der IETF-Entwurf läuft ab, sofern er nicht aktualisiert wird | 185 |
| 2027, kein Monat angegeben | Google will den Token unterstützen | Noch nicht veraltet |
| Kommende Monate, kein Datum genannt | OpenAI hat das Ziel, das Signal zu implementieren | Noch nicht veraltet |
Die Tageszählungen sind einfache Kalenderarithmetik vom 30. Oktober 2026, nicht die Angaben der Anbieter. Die beiden undatierten Einträge, Google und OpenAI, sind der Grund, warum Verlage die Ankündigung heute nicht als Live-Berichterstattung behandeln sollten.
Was es kontrolliert und was es nicht kontrolliert
| Frage | Antwort |
|---|---|
| Stoppt das KI-Training auf meinen Inhalten? | Das ist sein Zweck, sobald jedes Labor es umgesetzt hat |
| Hört es auf zu kriechen? | Nein. Der Entwurf besagt, dass der Token keine Direktive für das Crawling-Verhalten ist, sodass Bots trotzdem eine Seite abrufen können |
| Stoppt das die Suchindexierung? | Nein. Microsoft sagt, dass das Abmelden von Schulungen die Berechtigung für reguläre Bing-Ergebnisse nicht beeinträchtigt |
| Verhindert das, dass KI-Antworten meine Seiten zitieren? | Nein, außer über Microsofts separate Erdungskontrolle. Training und Erdung sind unterschiedliche Anwendungsbereiche |
| Löscht es vergangene Trainingsdaten? | Nein. Es umfasst nur zukünftige Trainingsläufe, nicht bereits gesammelte oder bereits in Modellgewichten gesammelte Inhalte |
| Bindet es Schaber, die es ignorieren? | Nein. Sie ist freiwillig, ohne Durchsetzungsbefugnis, sodass nicht konforme Scraper sie ignorieren können |
Diese letzte Einschränkung ist die, auf die Publisher immer wieder stoßen. Der Token ist ein Koordinationsmechanismus, keine Sicherheitskontrolle. Er funktioniert nur mit Unternehmen, die sich entscheiden, ihm zu folgen, und der Entwurf selbst hat keine formale IETF-Status. Das macht ihn nicht nutzlos, aber es bedeutet, dass du Compliance-Crawler für Crawler überwachen solltest und deine bestehenden Kontrollen beibehalten solltest, bis das gemeinsame Token tatsächlich eingehalten wird.
Was jetzt zu tun ist
Fügen Sie das Token jetzt hinzu, es kostet nichts. Der zweizeilige Block ist bereits veröffentlicht, und wenn Sie ihn frühzeitig hinzufügen, sind Sie beim Eintreffen des Supports abgedeckt, ohne auf das Rollout-Datum jedes Labors warten zu müssen.
Behalten Sie Ihre bestehenden Regeln bei. Google-Extended, GPTBot, ClaudeBot und Ihre anderen firmenspezifischen Regeln bleiben heute wirksam. Löschen Sie sie nicht zugunsten eines Tokens, das größtenteils noch nicht aktiv ist.
Entscheide Training und Grounding getrennt. Wenn du Microsofts Produkte nutzt, setze die Trainingspräferenz und die Erdungspräferenz als zwei Optionen, nicht als eine. Wenn dir die Sichtbarkeit der Gemini-App wichtig ist, entscheide dich explizit für Google-Extendated, anstatt das geteilte Token standardmäßig entscheiden zu lassen.
Überprüfen Sie die Bing-Tags vor dem 1. März 2027. Wenn Ihre Seite auf NoArchive oder NoCache angewiesen ist, wechseln Sie vor dieser Frist zu den neuen Microsoft-Einstellungen.
Erwarten Sie einen Folgeentwurf. Der aktuelle Entwurf läuft am 3. Mai 2027 aus, sofern er nicht aktualisiert wird, und zur Arbeitsgruppe gehören Meta, Cloudflare, die Common Crawl Foundation, News Corp, die Financial Times, die BBC, die Electronic Frontier Foundation und Creative Commons. Der Standard kann sich ändern, wenn sich diese Teilnehmer äußern, daher sollten Sie die heutige Formulierung als Ausgangspunkt und nicht als endgültiges Gesetz betrachten.
Für Teams, die KI-Produkte entwickeln, ist die Lehre breiter als nur eine robots.txt Datei. Trainingspräferenzen, Erdungspräferenzen und Suchtransparenz sind nun drei getrennte Hebel, und sie werden entweder für Datenkontrolle oder Datenverkehr vermischt. CodeMyPixel baut KI-Agentenentwicklungsdienste und hilft Unternehmen, eine KI-Automatisierungsagentur einzustellen, um KI in echte Arbeitsabläufe mit den Leitplanken und Bewertungen umzusetzen, die ein Rohmodell oder eine einzelne robots.txt Zeile nicht bieten. Wenn Sie offene Modelle gegen geschlossene abwägen, zeigen unsere Mistral Large 4 Open-Weights-Aufschlüsselung und unser Gemini 4 Carbon Erklärungsbericht, wie Zugang, Lizenzierung und Kontrolle sich in der Praxis unterscheiden.
Welche soll ich wählen
Wähle den geteilten Token plus deine alten Regeln , wenn du heute maximale Abdeckung möchtest. Der Token bereitet dich auf 2027 vor, die alten Regeln schützen dich jetzt.
Wählen Sie Trainings-Opt-out nur , wenn Sie möchten, dass Ihre Inhalte aus dem zukünftigen Modelltraining genommen werden, aber dennoch Suchverkehr und KI-Antworten sichtbar werden. Denken Sie daran, dass dieses Token allein keine KI-Antworten blockiert.
Wählen Sie Training plus Grounding Opt-out bei Microsoft , wenn Sie Ihre Seiten auch aus Live-KI-Antworten in Bing, Copilot und Microsoft 365 entfernen möchten. Das ist eine separate Microsoft-Einstellung, nicht Teil des gemeinsamen Tokens selbst.
Wählen Sie kein Opt-out , wenn Ihr Unternehmen von KI-Trainingserfahrung profitiert, oder wenn Sie weiterhin berechtigt bleiben möchten, Gemini-App zu Grounding und Klicks zu erhalten und Sie sich damit wohlfühlen, dass Ihre Inhalte für Schulungen verwendet werden. Das ist eine geschäftliche Entscheidung, kein Standard, also treffen Sie sie bewusst.
Was ist das gemeinsame KI-Trainings-Opt-out-Token?
Es handelt sich um ein robots.txt Policy-Token, _usageai-training, das am 30. Oktober 2026 angekündigt wurde und das OpenAI, Google, Microsoft und Anthropic angeben, dass sie einhalten werden. Ein Website-Besitzer fügt User-Agent: _usageai-training gefolgt von Disallow: / ein, um sich von KI-Training abzumelden, anstatt den Crawler jedes Unternehmens namensgemäß zu blockieren.
Verhindert das Abmelden Google oder Bing daran, meine Seite zu indexieren?
Nein. Der Token deckt nur KI-Training ab, nicht Crawling oder Suche. Microsoft sagt, dass das Abmelden von Training die Berechtigung für reguläre Bing-Ergebnisse nicht beeinträchtigt, und der Entwurf besagt, dass der Token keine Richtlinie für Crawling-Verhalten ist.
Wann tritt das geteilte Token tatsächlich in Kraft?
Anthropic hat bereits mit der Implementierung begonnen. Microsoft startet am 1. Februar 2027. Google strebt 2027 an, ohne dass ein Monat festgelegt ist. OpenAI sagt, das Signal in den kommenden Monaten ohne Termin einzuführen. Bis dahin gelten heute die bestehenden Firmenregeln.
Entfernt der Token meine Inhalte von Modellen, die bereits darauf trainiert sind?
Nein. Das Aktualisieren robots.txt entfernt keine bereits in Datensätzen gesammelten oder in Modellgewichte trainierten Inhalte. Das Token deckt nur zukünftige Trainingsläufe ab.
Ist das ein formaler Webstandard?
Nein, noch nicht. Es handelt sich um einen individuellen IETF Internet-Entwurf, "Machine-Readable Training Preference Signal", von Kevin Kelley von Anthropic, eingereicht bei der IETF AI Preferences Arbeitsgruppe. Der IETF Datatracker weist darauf hin, dass ein einzelner Entwurf nicht von der IETF unterstützt wird und keine formelle Gültigkeit hat, und der Entwurf läuft am 3. Mai 2027 ab, sofern er nicht aktualisiert wird.
Sollte mein Unternehmen auf KI-Schulungen verzichten?
Melden Sie sich ab, wenn Ihnen die Kontrolle der zukünftigen Trainingsnutzung wichtiger ist als die mögliche Erfahrung, die das Training bringen könnte, und behalten Sie Ihre alten Crawler-Regeln bei, bis der gemeinsame Token aktiv ist. Bleiben Sie eingespielt oder setzen Sie eine explizite Google-Extendated-Erlaubnis, wenn Sie weiterhin für Gemini-App-Grounding und Klicks berechtigt bleiben möchten. Entscheiden Sie sich getrennt über Training und Grounding und überdenken Sie die Option, wenn Microsofts Termin am 1. Februar 2027 ansteht.
- robots.txt
- ai training opt-out
- openai
- microsoft
- anthropic
- ai policy