KI-News5 Min. LesezeitVon JH Akash
Claude Fable 5.2: #1 mit 65, 20 % günstiger, 30 % schneller
Anthropic brachte Claude Fable 5.2 am 9. November 2026 auf den Markt. Er führt den Artificial Analysis Intelligence Index mit 65 an, kostet 20 % weniger als Fable 5.1 bei 8/40 $ pro 1-Million Token und läuft bis zu 30 % schneller. Hier sind die Benchmarks, der Preis und der Haken.
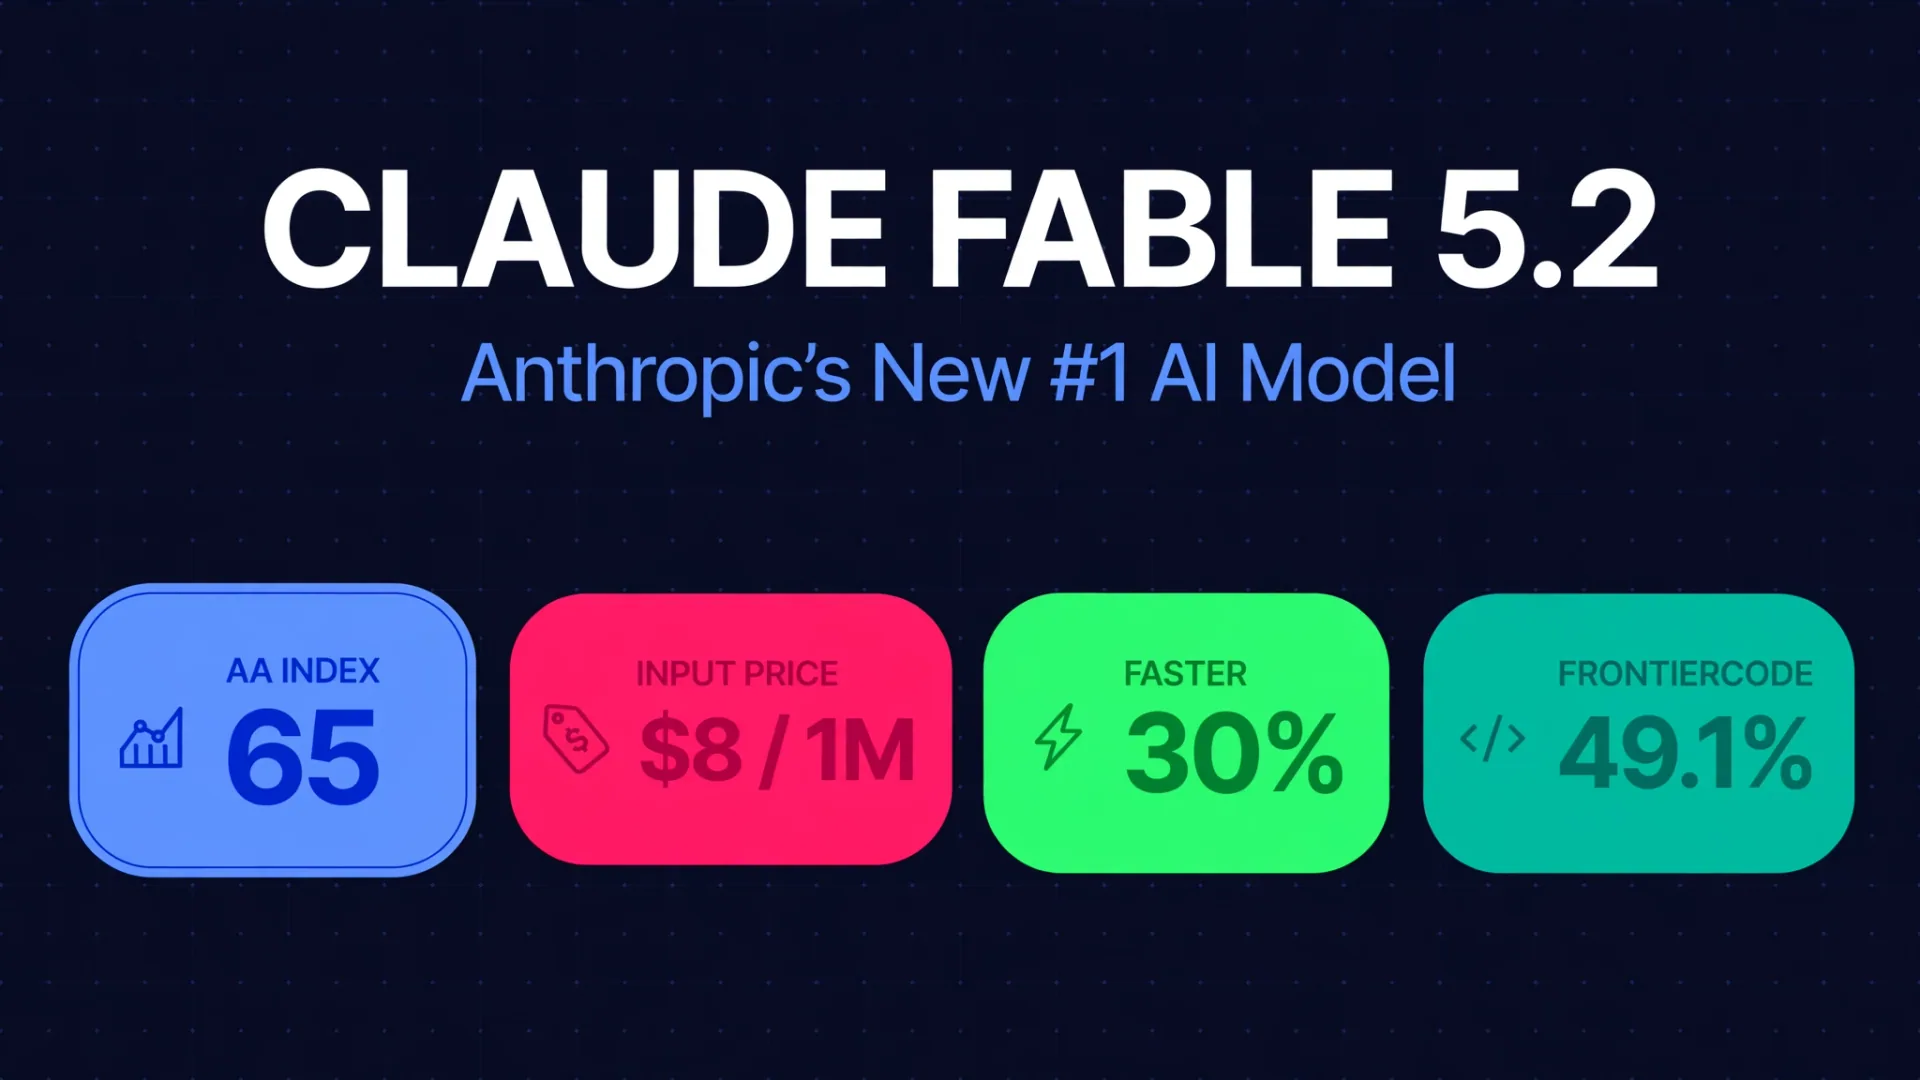
Anthropic brachte Claude Fable 5.2 am 9. November 2026 auf den Markt und erreichte etwas, das kein Claude-Modell zuvor geschafft hat: Es belegte den ersten Platz im Artificial Analysis Intelligence Index. Das neue Modell erreicht 65 Punkte, vor Gemini 4 Carbon mit 60, Claude Opus 5.5 mit 59 und GPT-6 Astra mit 57. Es kostet außerdem 20 % weniger als das Modell, das es ersetzt, und läuft bis zu 30 % schneller.
Diese Kombination mit besseren Bewertungen und niedrigerem Preis ist bei KI-Starts selten. Aber die Schlagzeilenzahlen verbergen einen Haken: Bei maximalem Einsatz ist Fable 5.2 eines der langsamsten und teuersten Modelle pro Aufgabe. Hier ist, was sich geändert hat, was es kostet und wer es tatsächlich nutzen sollte.
Fable 5.2 auf einen Blick
| Claude Fable 5.2 | |
|---|---|
| Stapellauf | 9. November 2026 |
| Künstlicher Analyse-Intelligenzindex (unabhängig) | 65, Platz 1 |
| Eingangspreis | 8 $ pro 1Million Token |
| Produktionspreis | 40 $ pro 1M-Token |
| Geschwindigkeit | Bis zu 30 % schneller als Fable 5.1 |
| Kontextfenster | 1M Token |
| Wissensgrenze | Juni 2026 |
| Modell-ID | claude-fable-5-2 |
| Verfügbar auf | Claude paid plans, Claude Code, Claude Platform, AWS, Google Cloud, Azure |
Was hat sich von Fable 5.1 geändert
Das Upgrade besteht aus drei Dingen gleichzeitig: günstiger, schneller und stärker. Der Eingabepreis sank von 10 auf 8 Dollar pro Million Token und der Output von 50 auf 40 Dollar, eine 20%ige Kürzung bei beiden. Die Ausgabegenerierung ist bis zu 30 % schneller, und die Tester stellten fest, dass das Modell klarer kommuniziert als die 5.1-Version.
Ein neuer optionaler Schnellmodus generiert Token bis zu 2,5-mal schneller zum doppelten Preis, 16 US-Dollar Eingabe und 80 US-Dollar Ausgabe pro Million Token. Fable 5.1 ist nun ein Legacy-Modell.
Anthropic brachte am selben Tag auch ein eingeschränktes Geschwistersystem auf den Markt, Claude Mythos 5.2. Es handelt sich um dasselbe zugrundeliegende Modell ohne einige Cyber- und Biologieschutzmaßnahmen und gilt nur für geprüfte Organisationen. Fable 5.2 ist die Version, die alle anderen bekommen.
Preis: was Fable 5.2 kostet
| Modell | Eingabe pro 1M Token | Ausgabe pro 1M Token | Cache-Lesen pro 1M Token |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 |
| Claude Fable 5.2, Schnellmodus | $16 | $80 | - |
| Claude Fable 5.1 (Vermächtnis) | $10 | $50 | $0.25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Astra | $10 | $50 | - |
Fable 5.2 unterbietet GPT-6 Astra nun zum Listenpreis um 20 %. Aber es kostet immer noch doppelt so viel wie Claude Opus 5.5, weshalb Anthropic Opus 5.5 weiterhin für alltägliches Programmieren und Wissensarbeit empfiehlt. Fable steht für die ehrgeizigsten, offensten technischen Arbeiten.
Bei den Claude-Plänen gibt es keine kostenlose Stufe für Fable. Pro zahlt mit Nutzungscredits, und Max und Ultra enthalten bis zur Hälfte des wöchentlichen Limits während der Startwoche.
Benchmarks: wohin Fable 5.2 führt
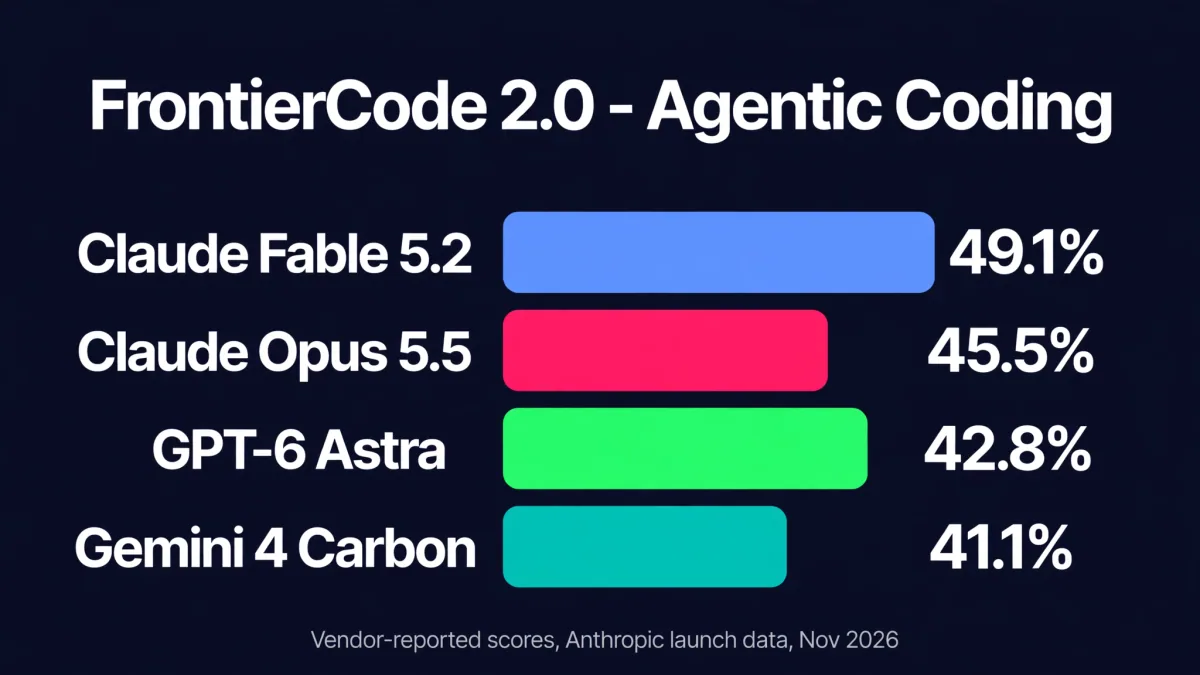
Die untenstehenden Bewertungen stammen aus Anthropic' eigener Starttabelle, also behandeln Sie sie als von Anbietern berichtet. Fable 5.2 führt jeden gelisteten Konkurrenten beim Agentic Coding an und führt Fable 5.1 bei jedem von Anthropic veröffentlichten Benchmark an.
| Benchmark (vom Anbieter berichtet) | Fable 5.2 | Fabel 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (agentische Codierung) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentische Codierung) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (Geschäfts-Workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| WANDR (agentische Suche) | 82.1% | - | 72.3% | - | - |
Fable 5.2 gewinnt nicht alles. Gemini 4 Carbon führt bei AutomationBench mit 53,9 % gegen 51,4 %, und Opus 5.5 behält die höhere AA-Briefcase Elo-Bewertung, 1800 gegenüber 1785. Auf Terminal-Bench 4.0 erzielte Fable 5.2 60 %, gleichauf mit Opus 5.5 und hinter Kimi K3.1 Pro, Gemini 4 Carbon und Claude Sonnet 5.5.
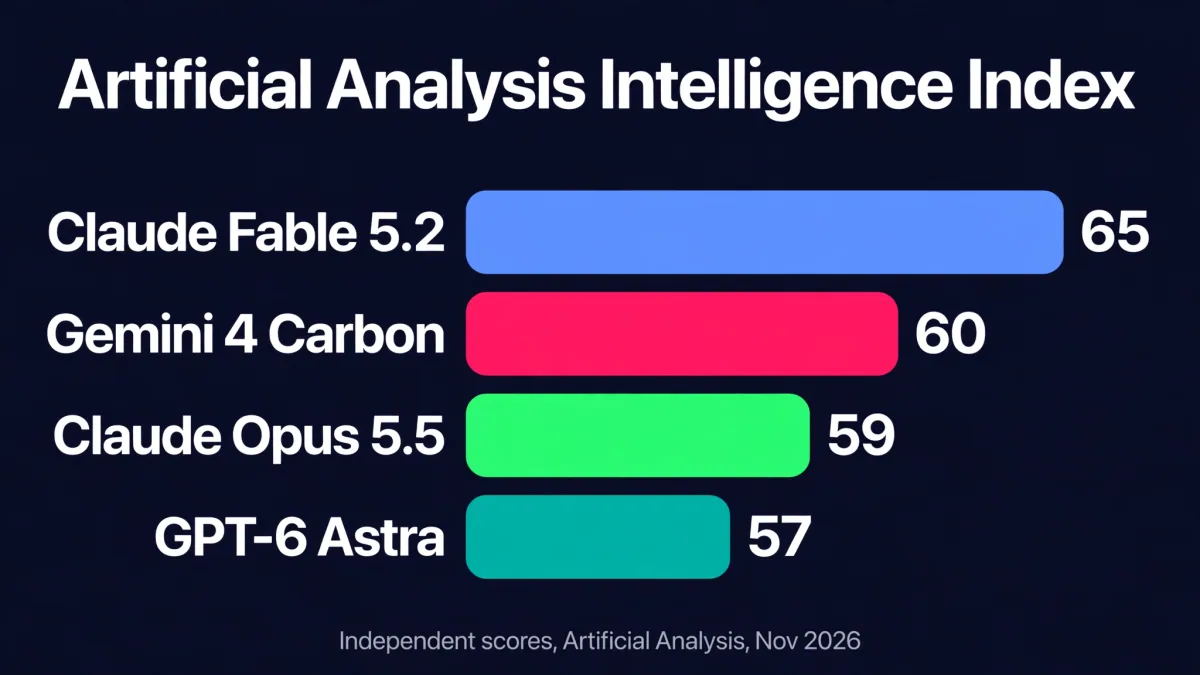
Unabhängige Ergebnisse stützen die Rangliste
Zwei externe Tester veröffentlichten am Starttag die Ergebnisse. Artificial Analysis, das seine Bewertungen unabhängig durchführt, platziert Fable 5.2 auf Platz 65 mit maximalem Aufwand auf Platz 65 im Intelligence Index. Vals AI belegt mit 71,31 % den ersten Platz von 36 Modellen im Vals Index.
Aber die unabhängigen Daten zeigen auch die Kosten des Höchstwerts. Bei maximalem Aufwand kostete der Betrieb des Künstlichen Analyse-Index durchschnittlich 26,54 Dollar pro Aufgabe, etwa 2,6-mal so viel wie Opus 5.5, und mit etwa 45 Minuten pro Aufgabe zählt Künstliche Analyse Fable 5.2 zu den langsamsten Modellen, die getestet werden. Der gleiche Bericht vermerkt, dass Fable 5.2 bei High Effort etwa auf Niveau mit Opus 5.5 bei maximalem Aufwand auf FrontierCode 2.0 bewertet wurde, 45,3 % gegenüber 45,5 %, was etwa die Hälfte der Kosten pro Aufgabe entspricht. Das Aufwandsniveau ist genauso wichtig wie der Modellname.
Der Haken: 30-tägige Datenspeicherung
Sofern Anthropic keine Ausnahme genehmigt, verlangt Fable 5.2 eine 30-tägige Aufbewahrung von Prompts und Abschlüssen. Es ist bei null Datenspeicherung nicht verfügbar. Teams mit strengen Datenrichtlinien sollten dies überprüfen, bevor sie Produktionsworkloads zu Fable übertragen, auch wenn die Benchmarks verlockend wirken.
Welches Modell solltest du wählen?
Wähle Claude Fable 5.2 für die härteste Arbeit: lange autonome Codierungsaufgaben, mehrstufige Agentenläufe und Forschungsprobleme, bei denen Genauigkeit die Kosten schlägt. Führe es zuerst mit hohem Aufwand aus, da es ungefähr mit Opus 5.5 bei maximalem Aufwand entspricht, was etwa die Hälfte der Kosten pro Aufgabe entspricht.
Wähle Claude Opus 5.5 für alltägliches Programmieren und Wissensarbeit. Es kostet nur halb so viel pro Token, ist in der Praxis schneller und führt immer noch Fable 5.2 auf dem AA-Briefcase Knowledge-Work Elo an. Das ist der Standard, den Anthropic selbst empfiehlt.
Wählen Sie GPT-6 Astra, wenn Ihr Stack bereits auf OpenAI basiert, und Gemini 4 Carbon, wenn die Automatisierung von Geschäftsablaufen Ihr Hauptanwendungsfall ist, da es AutomationBench anführt. Lesen Sie unsere GPT-6 Astra-Aufschlüsselung und unsere Gemini 4 Carbon-Abdeckung, bevor Sie sich entscheiden.
Wenn Sie möchten, dass ein Team das richtige Modell in Ihre Geschäftsabläufe einbaut, anstatt zu raten, besuchen Sie unsere KI-Agentenentwicklungsdienste.
Quellen
Anthropic's Startankündigung und Preisseite, Artificial Analysis Intelligence Index v5, Vals AI Vals Index v2.2 und Claude Platform Dokumentation, alle überprüft vom 9. bis 10. November 2026. Die vom Anbieter gemeldeten Benchmarks sind oben so gekennzeichnet.
Wie viel kostet Claude Fable 5.2?
8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token auf der API, gegenüber 10 und 50 US-Dollar bei Fable 5.1. Ein optionaler Schnellmodus verdoppelt das auf 16 und 80 US-Dollar und generiert Token bis zu 2,5-mal schneller. Cache-Lesungen kosten 0,20 US-Dollar pro Million Token.
Ist Claude Fable 5.2 besser als GPT-6 Astra?
Bei den veröffentlichten Benchmarks gilt das für agentisches Codieren ja: Fable 5.2 erreicht 49,1 % bei FrontierCode 2.0 gegenüber 42,8 % bei GPT-6 Astra und 65 % gegenüber 57 im unabhängigen Artificial Analysis Intelligence Index. Es kostet außerdem 20 % weniger. Beide Coding-Sets werden von Anthropic vom Anbieter berichtet.
Ist Claude Fable 5.2 kostenlos verfügbar?
Nein. Es gibt keine kostenlose Stufe für Fable. Es ist auf Claude Pro (Nutzungsgutschriften), Max und Ultra, in Claude Code, auf der Claude Platform API sowie über AWS, Google Cloud und Azure verfügbar.
Was ist Claude Mythos 5.2?
Mythos 5.2 ist das gleiche zugrundeliegende Modell wie Fable 5.2, ohne einige Cyber- und Biologieschutzmaßnahmen. Es steht nur geprüften Organisationen zur Verfügung, einschließlich Mitgliedern der Cyber- und Life Sciences Verification Programs von Anthropic. Alle anderen erhalten Fable 5.2.
Sollte ich von Claude Opus 5.5 zu Fable 5.2 wechseln?
Nur für deine schwierigsten Aufgaben. Fable 5.2 schlägt Opus 5.5 bei agentischen Coding-Benchmarks, kostet aber doppelt so viel pro Token und ist bei maximalem Aufwand langsamer. Anthropic empfiehlt weiterhin Opus 5.5 als Alltagsmodell. Nutze Fable, wo die zusätzliche Fähigkeit den Preis wert ist, und Opus überall sonst.
- Claude Fable 5.2
- Anthropic
- AI benchmarks
- GPT-6 Astra
- Gemini 4 Carbon