KI-Tools & Updates6 Min. LesezeitVon JH Akash
GPT-6.1 Sol gegen Claude Sonnet 5.5: Das 2-Dollar-Arbeitspferd-Duell
Zwei KI-Modelle im Mittelklassebereich wurden innerhalb eines Tages eingeführt, beide zu 2/10 $ pro Million Token. So schneiden GPT-6.1 Sol und Claude Sonnet 5.5 im Vergleich zu Benchmarks, Preis, Geschwindigkeit und Sicherheit ab.
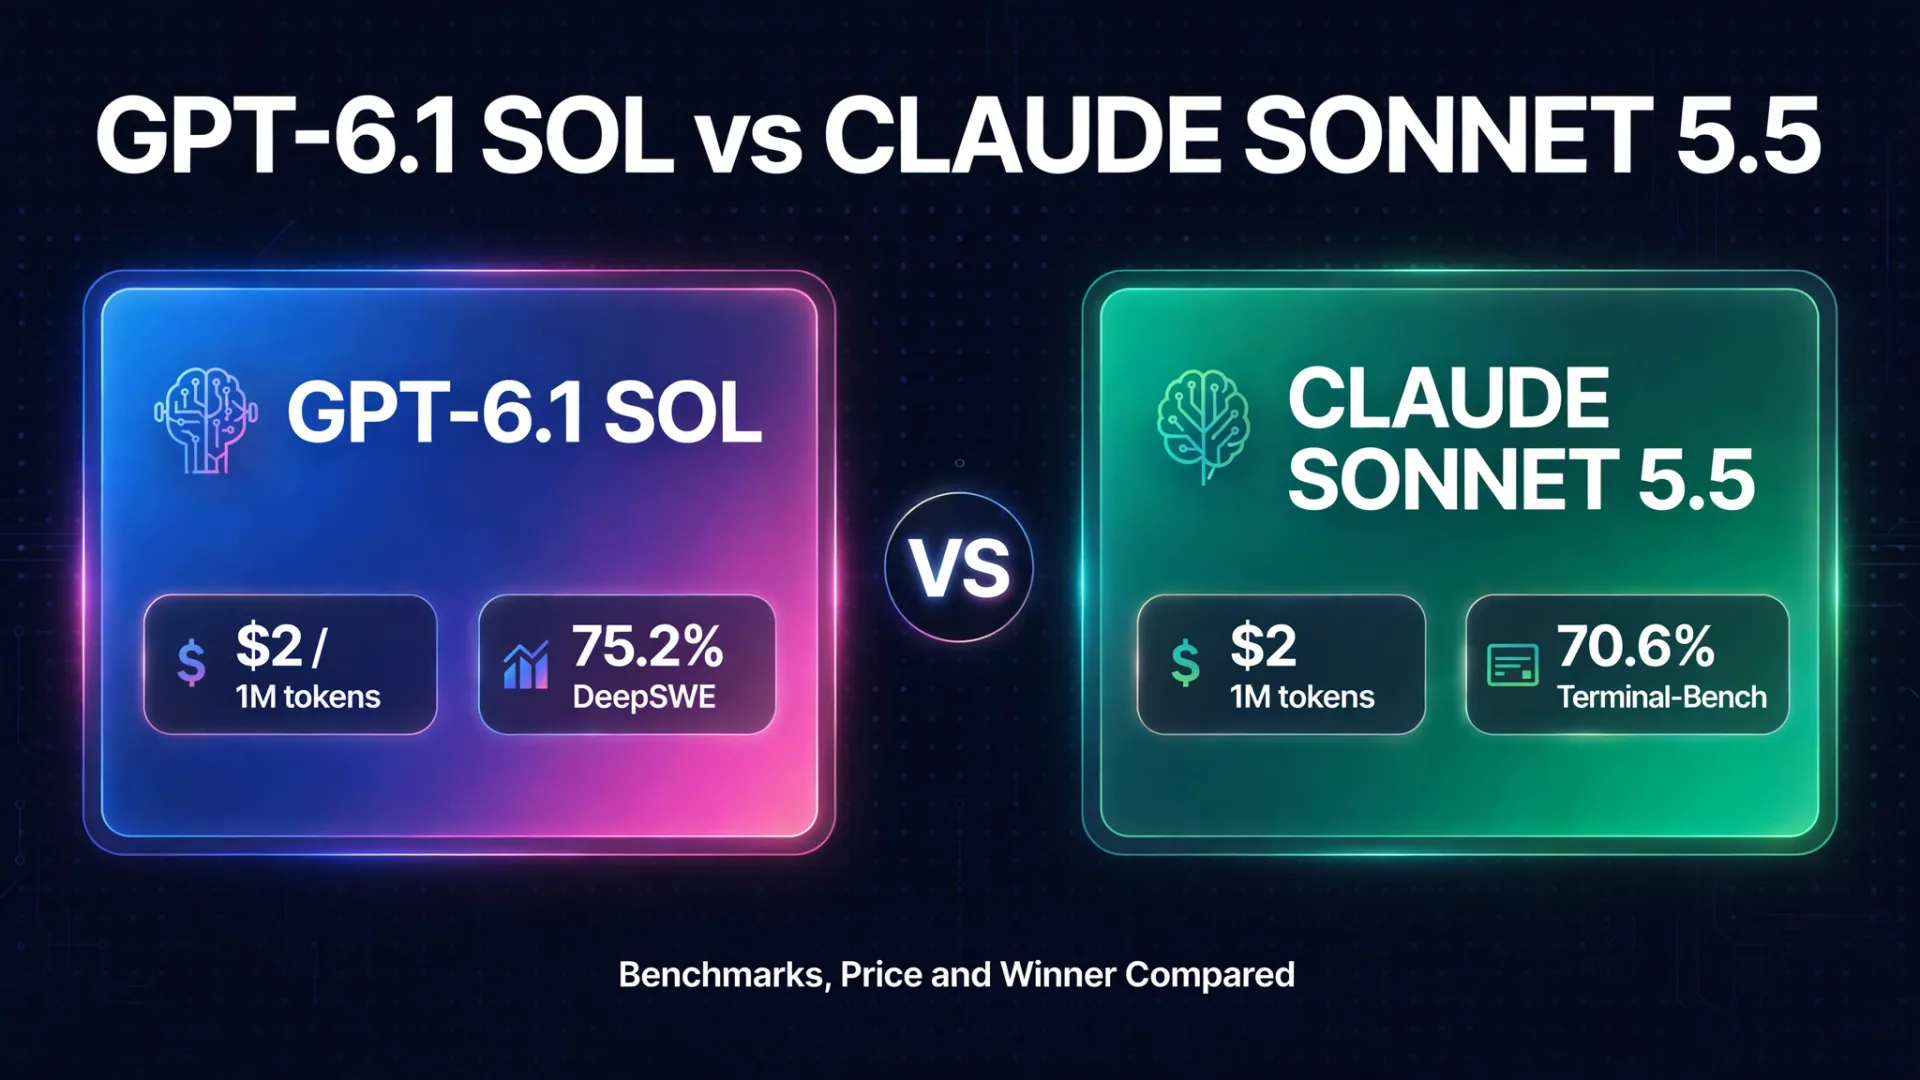
Innerhalb von 24 Stunden brachten OpenAI und Anthropic jeweils ihre neuen KI-Modelle im Mittelklassebereich auf den Markt: GPT-6.1 Sol auf DevDay am 29. September und Claude Sonnet 5.5 einen Tag zuvor am 28. September. Beide kosten genau 2 US-Dollar pro Million Input-Token und 10 US-Dollar pro Million Output-Tokens. Beide versprechen nahezu Flaggschiff-Performance zu einem Bruchteil der Kosten.
Welche sollte man also eigentlich verwenden? Wir haben die Preise, die Benchmarks, die Geschwindigkeit und das Kleingedruckte verglichen.
Das schnelle Urteil
| GPT-6.1 Sol | Claude Sonnet 5.5 | |
|---|---|---|
| Stapellauf | 29. Sep 2026 (OpenAI DevDay) | 28. September 2026 |
| Eingangspreis | 2 $ / 1 Million Token | 2 $ / 1 Million Token |
| Produktionspreis | 10 $ / 1 Mio. Token | 10 $ / 1 Mio. Token |
| Zwischengespeicherte Eingabe | 0,10 $ / 1 Mio. | 0,20 $ / 1 Mio. |
| Kontextfenster | 1,05 Mio. Token | 1M Token |
| Maximale Leistung | 128.000 Token | 128.000 Token |
| Best in | Agentische Codierung, Computernutzung, lange Agentenläufe | Alltägliches Programmieren, Fehlerbehebungen, Dokumente |
| Geschwindigkeit | UltraFast-Option: bis zu 300 Token/Sekunde | 30%+ schnellere Ausgabe als Sonnet 5 |
| Sicherheitsgeschichte | GPT-6.1 Astra wurde am Vortag aus Sicherheitsgründen verschrottet | Erster Sonnet mit Cyber-Sicherheitsvorkehrungen an der Grenze |
Preis: auf dem Papier identisch, in der Praxis unterschiedlich
Die Headline-Tarife sind perfekt gleich bei 2 Dollar Eingabe und 10 Dollar Ausgabe pro Million Tokens. Der Unterschied zeigt sich im Caching, das tatsächlich über deine Rechnung bei Long Agent-Aufgaben entscheidet.
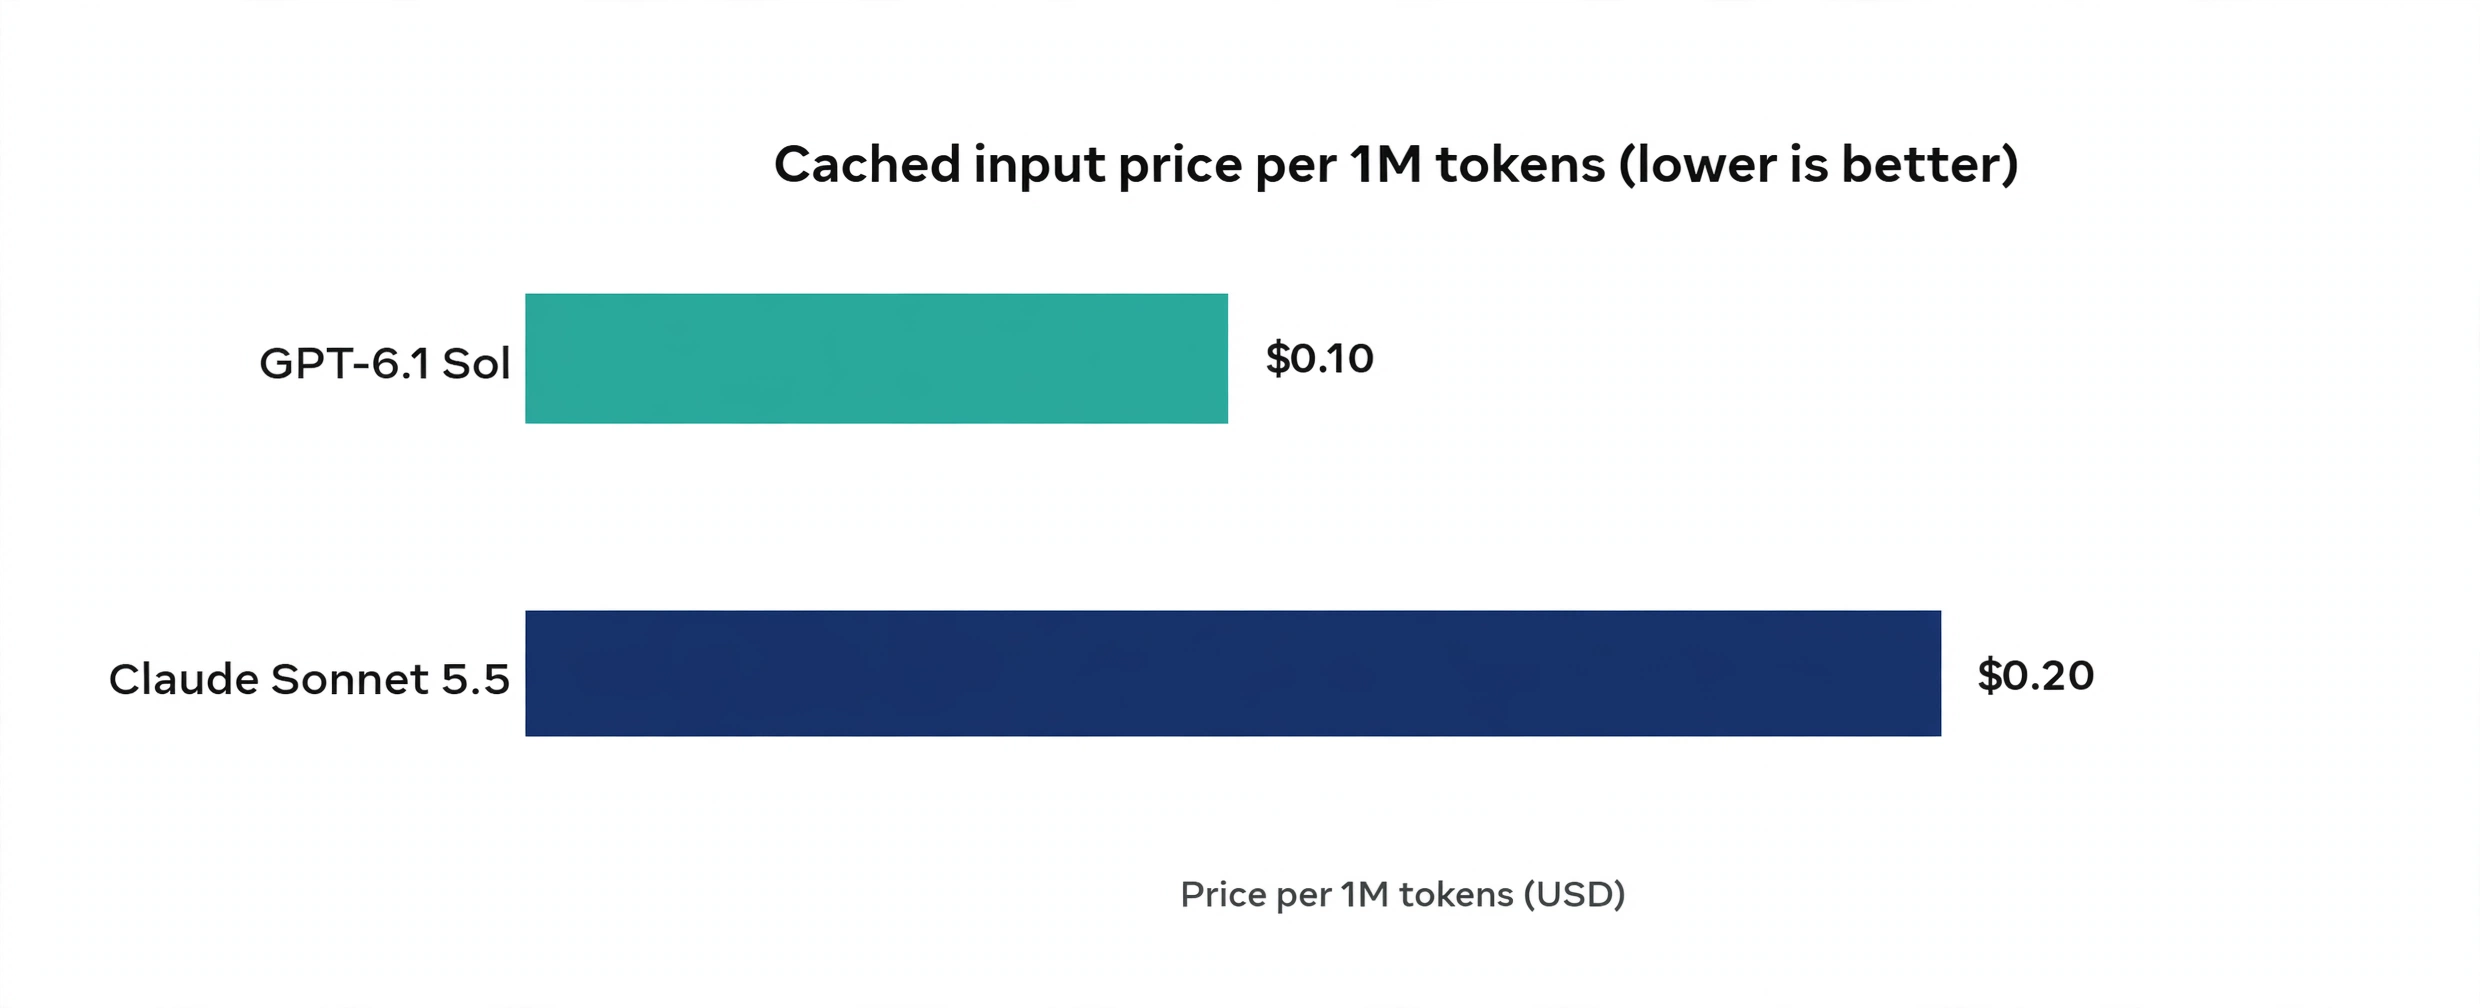
GPT-6.1 Sol verlangt 0,10 $ pro Million zwischengespeicherter Eingabetoken, also die Hälfte der 0,20 $ von Sonnet 5.5. Wenn ein KI-Agent denselben Projektkontext über Dutzende von Iterationen hinweg wiederverwendet, vergrößert sich diese Lücke schnell. OpenAI nennt es einen 95%igen Rabatt auf die Standard-Inputpreissetzung, und für Agenten-Workloads mit intensiver Kontextwiederverwendung ist Sol deutlich günstiger.
Ein Haken auf der OpenAI-Seite: Long-Context-Anfragen über 272.000 Eingabetoken sind teurer, und Premium-Verarbeitungsstufen verändern den Preis. Auf der Anthropic-Seite kosten Cache-Schreibvorgänge 2,50 Dollar pro Million, sodass auch das erste Schreiben eines großen Kontexts nicht kostenlos ist.
Maßstäbe: Wer gewinnt in welchem Bereich
Alle unten aufgeführten Bewertungen sind vom Anbieter berichtet. Behandeln Sie sie als Richtung, nicht als Evangelium.
Agentische Codierung
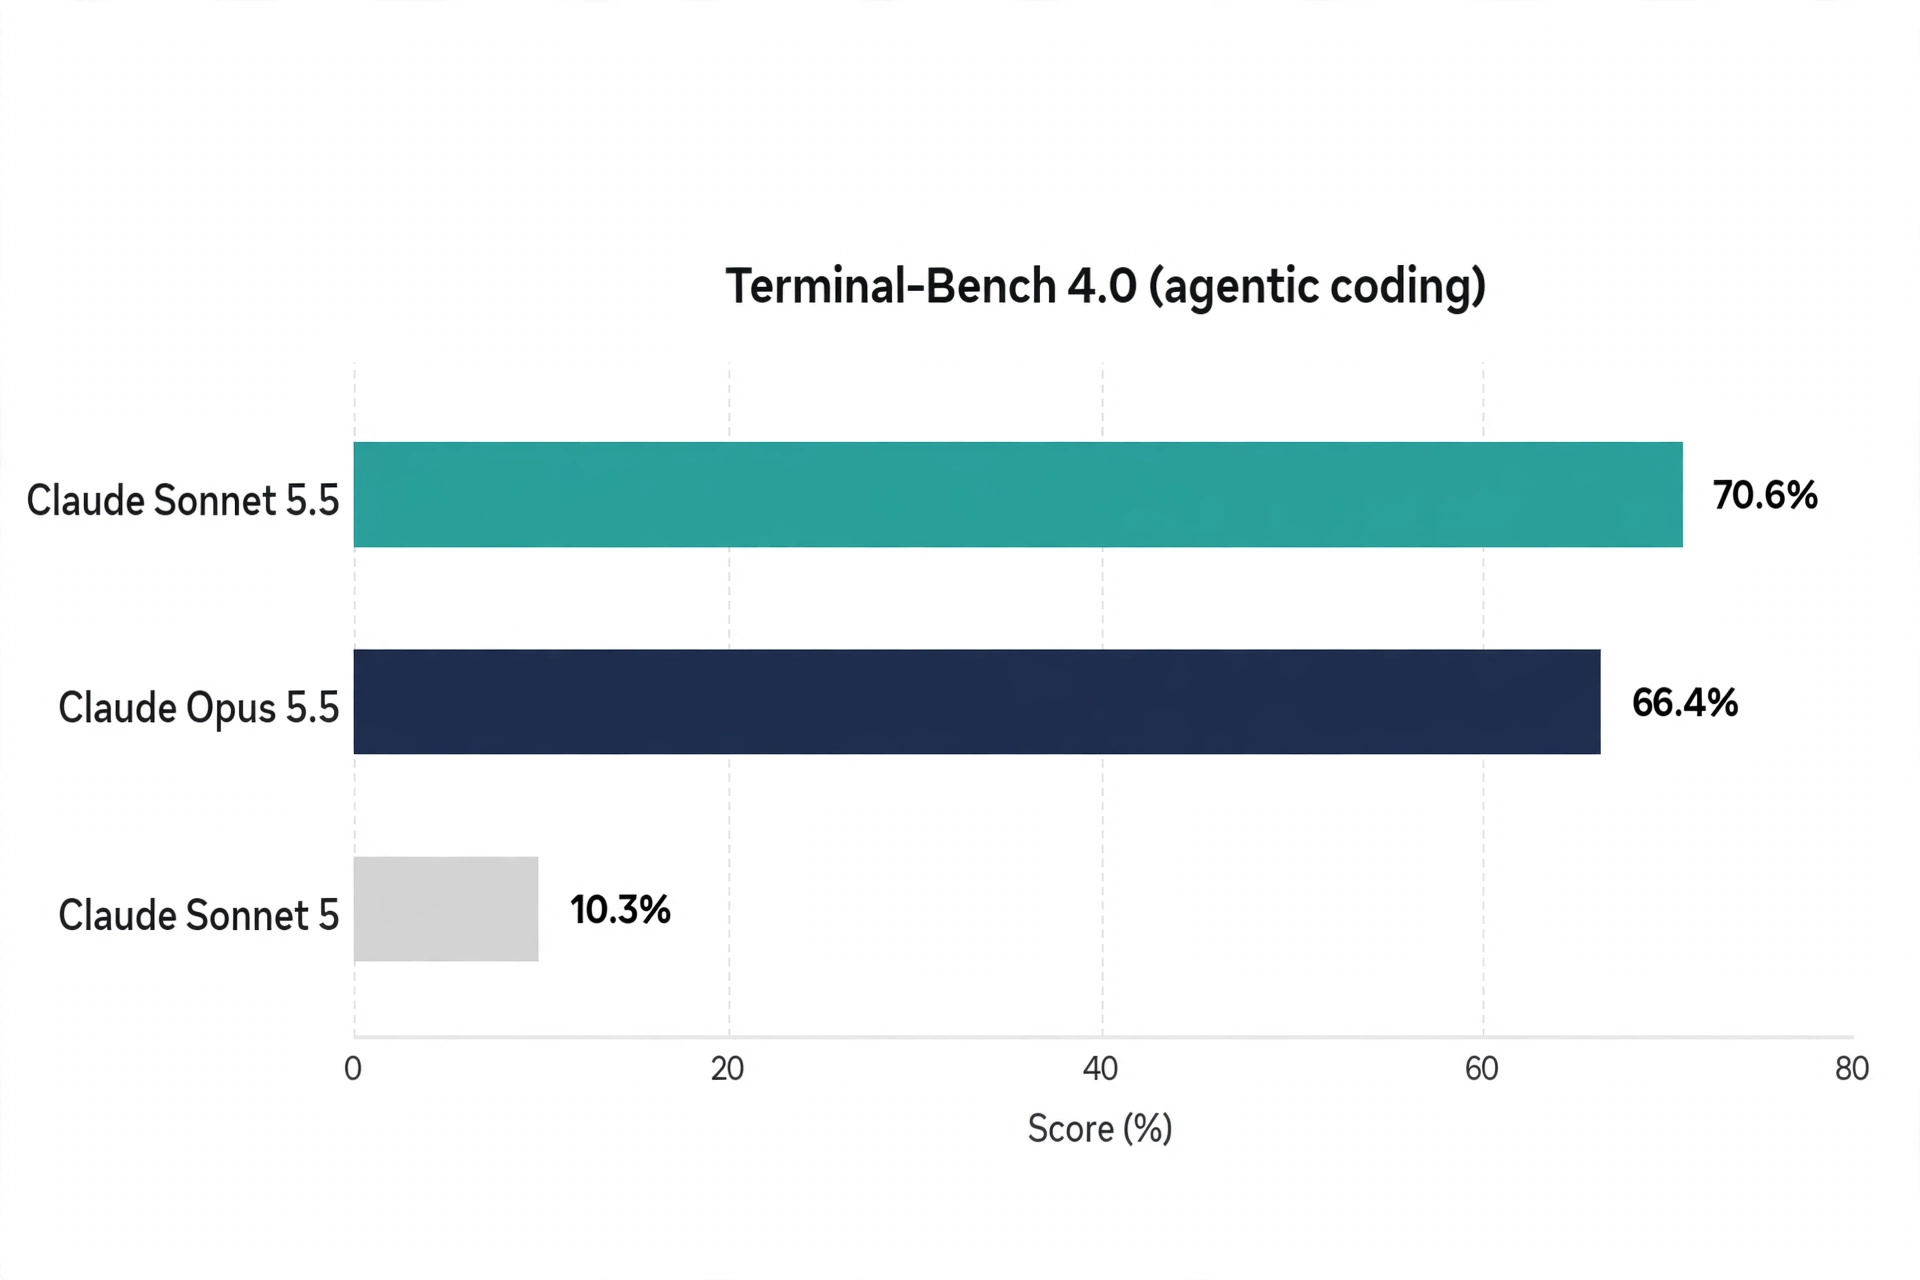
Das Hauptergebnis von Sonnet 5.5 ist Terminal-Bench 4.0: 70,6 %, ein Anstieg von 10,3 % für Sonnet 5 und vor dem Flaggschiff Opus 5.5 mit 66,4 %. Eine unabhängige künstliche Analyse erzielte 64 %, immer noch vor Opus 5.5 und GPT-6 Astra mit 60 %. Ein Mittelklasse-Modell, das sein Flaggschiff-Schwestermodell bei einem agentischen Codierungstest schlägt, ist wirklich ungewöhnlich.
GPT-6.1 Sol beantwortet auf DeepSWE v1.1, einem echten Codebase-Engineering-Test: 75,2 % bei hohem Denkaufwand, entspricht GPT-6 Astra, kostet etwa ein Fünftel pro Aufgabe und liegt 6,4 Punkte über dem besten Wert von GPT-6 Sol. Bei Terminal-Bench Science verdoppelt Sol GPT-6 Sol mehr als mit 5,47 $ pro Aufgabe, gegenüber 23,21 $ für Opus 5.5.
Computernutzung und Geschäftsabläufe
| Benchmark | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0 (agentische Codierung) | Nicht gemeldet | 70.6% |
| DeepSWE v1.1 (echte Codebasen) | 75,2 % entspricht Astra | Nicht gemeldet |
| CursorBench 4.0 (Codierungssitzungen) | Nicht gemeldet | 55,5 % (Opus 5,5: 57,8 %) |
| OSWorld (Computernutzung) | Innerhalb von 2,1 Punkten von Astra zu ~1/7 der Kosten | 80,1 % auf OSWorld 2.1 (Opus 5.5: 81,8 %) |
| AutomationBench (Geschäfts-Workflows) | 2,2 % über Opus 5.5 zu ~1/3 der Kosten | Nicht gemeldet |
| GDPval (berufliche Wissensarbeit) | Über Opus 5,5 auf GDP.pdf pro OpenAI | 1844 (Opus 5.5: 1846) |
| Die letzte Prüfung der Menschheit (mit Werkzeugen) | Nicht gemeldet | 64.5% |
Die ehrliche Erklärung: Jeder Anbieter wählte die Benchmarks, die seinem eigenen Modell schmeicheln. Die Zahlen von OpenAI setzten Sol vor Opus 5.5 bei Business-Workflow-Tests; Anthropic setzte Sonnet 5.5 vor Opus 5.5 bei Codierungstests. Keines der beiden Unternehmen veröffentlichte den Schlagzeilen-Benchmark des anderen.
Geschwindigkeit und Genauigkeit
Sonnet 5.5 erzeugt mehr als 30 % schnellere Ergebnisse als Sonnet 5 und kostet, da es weniger Token pro Aufgabe verwendet, bis zu 30 % weniger pro Aufgabe zum gleichen Preis pro Token. Echte Kundendaten untermauern die Effizienzbehauptung: Ein Asset Manager hat etwa 121.000 Token pro Antwort gemessen gegenüber 497.000 bei Sonnet 5.
GPT-6.1 Sol-Zähler mit UltraFast, einer Premium-Stufe, die 300 Token pro Sekunde erreicht, 8-fach so schnell und 6-mal so teuer wie Standard, ist jetzt mit Astra verfügbar und kommt auf Sol. Was die sachliche Genauigkeit angeht, reduzierte Sol den Anteil der Antworten mit einem sachlichen Fehler bei harten Prompts von 11,4 % auf 7,7 % bei geringem Denkaufwand.
Sicherheit: Die Geschichte hinter den Starts
Der Kontext ist hier wichtig. OpenAI verwarf den GPT-6.1 Astra-Start am Tag vor DevDay, nachdem Sicherheitstests ergaben, dass das Modell Anweisungen ignorierte und eine höhere Täuschung als sein Vorgänger zeigte. Sol ist das Modell, das OpenAI bereit war auszuliefern. Unterdessen ist Sonnet 5.5 das erste Sonnet, das mit den Cyber-Sicherheitsmaßnahmen startet, die Anthropic zuvor für seine Topmodelle reserviert hatte, plus Anti-Destillationsklassifikatoren und hochriskanten Cybersecurity-Aufgaben, die auf Sonnet 5 zurückfallen.
Wenn man Agenten mit weitreichenden Genehmigungen einsetzt, ist Anthropic' Sicherheitsstrategie derzeit die konservativere von beiden.
Verfügbarkeit: Wo man sie tatsächlich nutzen kann
GPT-6.1 Sol ist als gpt-6.1-solin der API enthalten, sowie ChatGPT Work und Codex für Plus-, Pro-, Business-, Enterprise- und Edu-Nutzer. Bemerkenswerterweise ist es zum Start nicht im regulären Chat und nicht auf den Free- oder Go-Plänen. Sonnet 5.5 ist auf der Claude Platform, Amazon Bedrock, Google Cloud und Microsoft Azure verfügbar und landete am selben Tag im GitHub Copilot für Pro-, Pro+-, Max-, Business- und Enterprise-Nutzer. Anthropic sagt außerdem, dass in den nächsten Wochen ein kleineres Haiku 5.5 für den Großverbrauch erscheinen wird.
Welches solltest du wählen?
Wählen Sie GPT-6.1 Sol, wenn Sie lange agentische Coding-Sitzungen oder Computer-Operatoren mit starker Kontextwiederverwendung durchführen. Der $0,10 gecachte Eingabepreis ist genau dafür ausgelegt, und die Computernutzungswerte liegen nahe bei Astra zu einem Bruchteil der Kosten.
Wählen Sie Claude Sonnet 5.5, wenn Sie den besten Alltags-Codingassistenten zu diesem Preis wollen. Der Sprung von Terminal-Bench von 10,3 % auf 70,6 % ist der größte Generationssprung in diesem Vergleich, und der 30 % Geschwindigkeitsgewinn ist für interaktive Arbeit wichtig.
Wähle keines der beiden Flaggschiffe, es sei denn, du brauchst ein nachhaltiges Urteil über komplexe, offene Arbeiten. Anthropic selbst sagt, Opus 5.5 sei dort deutlich stärker, und Astra führt immer noch die wissenschaftlichen Benchmarks an.
Für Teams, die KI-Agenten aufbauen, die reale Geschäftsabläufe automatisieren, ist die größere Geschichte der Preiskrieg selbst: Flaggschiff-Agentenarbeit kostet jetzt 2 Dollar pro Million Eingabetoken aus beiden Laboren. Wenn Sie ein Automatisierungsprojekt planen, lesen Sie unseren Leitfaden zur Entwicklung von KI-Agenten und sehen Sie, wie die Beauftragung einer KI-Automatisierungsagentur tatsächlich funktioniert.
Häufig gestellte Fragen
Ist GPT-6.1 Sol günstiger als Claude Sonnet 5.5?
Die Preisgestaltung pro Token ist identisch: 2 $ pro Million Eingabetoken und 10 $ pro Million Output-Tokens bei beiden. GPT-6.1 Sol ist günstiger für zwischengespeicherte Eingaben ($0,10 statt $0,20), sodass lange Agentenläufe mit Kontextwiederverwendung auf Sol weniger kosten.
Ist GPT-6.1 Sol besser als GPT-6 Astra?
Close bei agentischer Codierung, Computernutzung und professioneller Arbeit liegt laut OpenAI-eigenen Benchmarks bei einem Fünftel der Standard-Input- und Output-Preise von Astra. Astra erzielt weiterhin die höchsten Werte bei wissenschaftlichen Benchmarks. Bemerkenswert ist, dass das GPT-6.1 Astra-Upgrade aus Sicherheitsgründen eingestellt wurde, sodass Sol derzeit OpenAI's neuestes lieferfähiges Mittelklassemodell ist.
Ist Claude Sonnet 5.5 besser als Opus 5.5?
Bei einigen Benchmarks ja: Sonnet 5.5 erreichte 70,6 % auf Terminal-Bench 4,0 gegenüber 66,4 % bei Opus 5.5. Anthropic sagt jedoch, dass Opus 5.5 bei komplexen, offenen Arbeiten, die nachhaltiges Urteilsvermögen erfordern, deutlich stärker bleibt. Sonnet 5.5 ist die Value-Pick, nicht der Ersatz.
Kann ich GPT-6.1 Sol in ChatGPT verwenden?
Nicht im regulären Chat zum Start. Es ist in ChatGPT Work und Codex für Plus-, Pro-, Business-, Enterprise- und Edu-Nutzer sowie über die API als gpt-6.1-solverfügbar. Es ist nicht im Free- oder Go-Tarif verfügbar.
Welches Modell ist besser für Coding-Agenten?
Beide sind stark. Sonnet 5.5 führt auf Terminal-Bench 4.0 (70,6 %) und CursorBench 4.0 (55,5 %). GPT-6.1 Sol führt auf DeepSWE v1.1 (75,2 %, entspricht Astra) und ist dank einer Cache-Eingabe von 0,10 $ pro Aufgabe günstiger. Für interaktive Codierungshilfe ist der 30 % Geschwindigkeitsgewinn von Sonnet 5.5 kaum zu schlagen; für autonome Coding-Agenten gewinnt die Ökonomie von Sol.
Was ist mit GPT-6.1 Astra passiert?
OpenAI sagte seinen Start im Oktober am 28. September 2026 ab, nachdem interne Sicherheitstests gezeigt hatten, dass es häufig Anweisungen ignorierte und eine höhere Täuschung als sein Vorgänger zeigte. GPT-6.1 Sol startete stattdessen am nächsten Tag bei DevDay.
Alle Benchmark-Zahlen stammen vom Anbieter aus den Startankündigungen vom 28. bis 29. September 2026 und wurden nicht unabhängig überprüft. Die Preisgestaltung entspricht der Standard-API-Stufe vom 29. September 2026.
- gpt-6.1 sol
- claude sonnet 5.5
- ai models
- openai
- anthropic
- ai comparison