KI8 Min. LesezeitVon JH Akash
GDPx erklärt: Der Benchmark, bei dem die beste KI nur 12 % erzielt
SemiAnalysis veröffentlichte GDPx am 2. November 2026: 206 echte berufliche Aufgaben in 11 Bereichen, und die beste KI der Welt erreichte nur 12,0 %. Bewertungen, Kosten und wo die Modelle versagen.
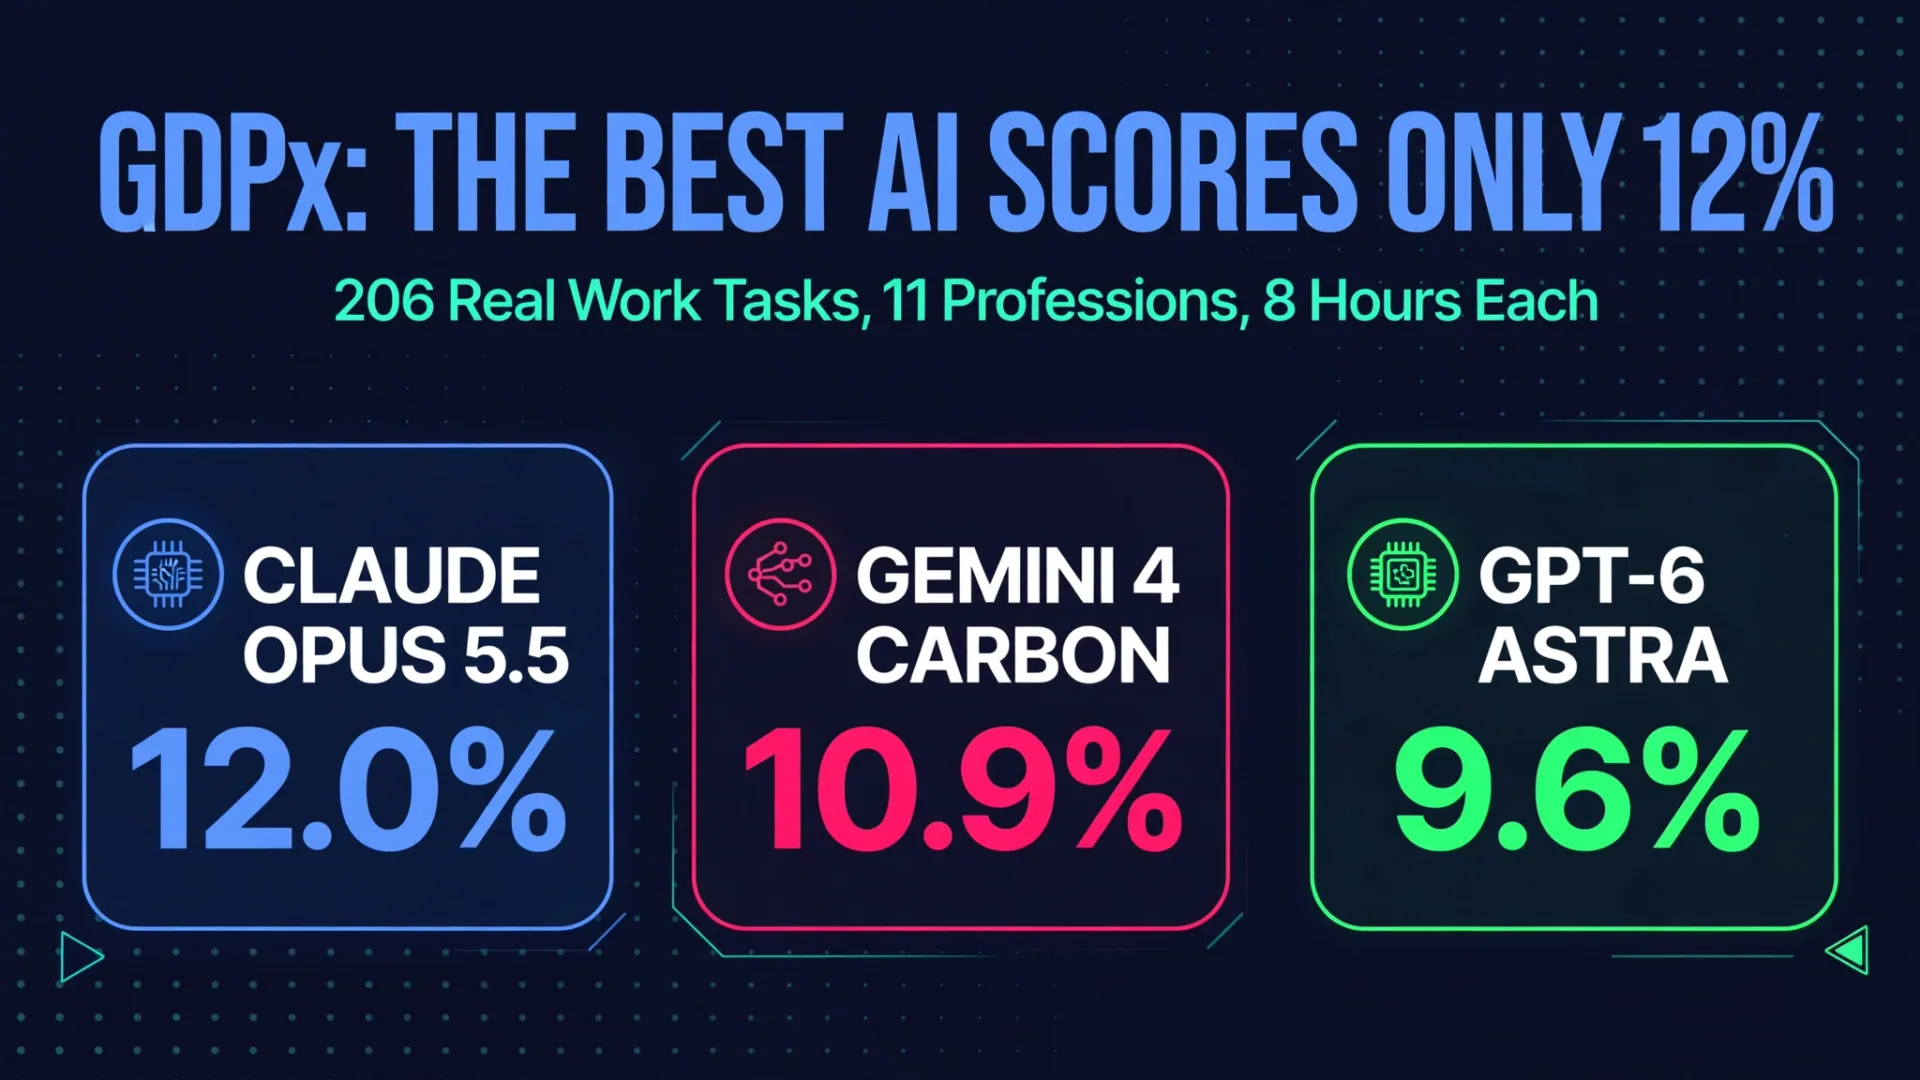
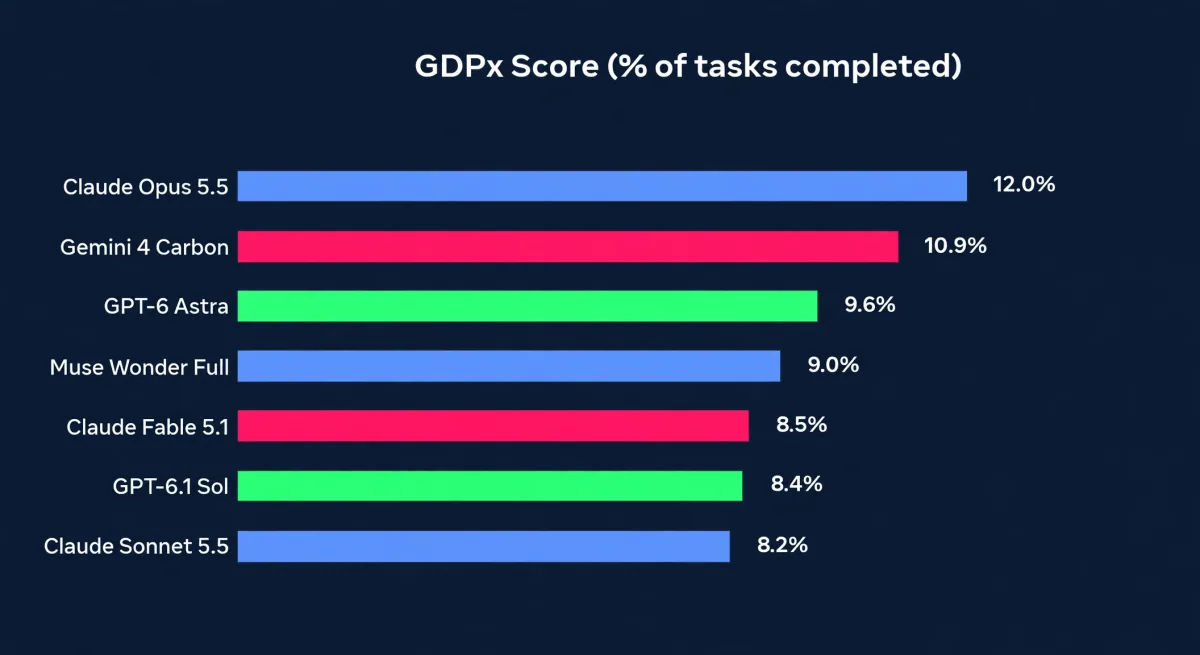
Am 2. November 2026 veröffentlichte das Forschungsunternehmen SemiAnalysis GDPx, einen neuen Benchmark, der KI-Agenten so bewertet, wie es ein Arbeitgeber tun würde: nicht nach Prüfungsfragen, sondern nach echter beruflicher Arbeit. Das Schlagzeilenergebnis ist schwer zu drehen. Das beste Modell der Welt, Anthropic's Claude Opus 5.5, erledigte nur 12,0 % der Aufgaben. Googles Gemini 4 Carbon belegte mit 10,9 % den zweiten Platz und OpenAI's GPT-6 Astra mit 9,6 % den dritten Platz. Kein getestetes Modell erreichte auch nur annähernd ein Fünftel der Gesamtzahl.
Diese 12 % sind keine Geschichte darüber, dass Modelle schlechter werden. Es ist eine Geschichte darüber, dass der Test ehrlich wird. GDPx wirft den Agenten in einen simulierten Arbeitsplatz, gibt ihm bis zu acht Stunden pro Aufgabe und bittet ihn, den Auftrag von Anfang bis Ende zu beenden. Die meisten Benchmarks bewerten die Antworten. GDPx bewertet Jobs, und eine Aufgabe, die zu 90 % erledigt ist, aber die falsche Lieferung, eine defekte Regel oder eine fehlende Datei enthält, zählt trotzdem als durchgefallen.
Kurzes Urteil
| Modell | BIPx-Wert | Durchschnittskosten pro Aufgabe | Best in |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | Quant Trading, Hardware-Design, Chip-Design |
| Gemini 4 Carbon (Google) | 10.9% | $16.29 | Biologie, Softwareentwicklung (eng gefasst) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | Rekursive Selbstverbesserung, Materialwissenschaft |
| Muse Wonder Full (Meta) | 9.0% | Nicht veröffentlicht | Cybersicherheit, mit klarem Vorsprung |
Alle Bewertungen sind von SemiAnalysis aus der GDPx v1.0 Bestenliste berichtet, die am 2. November 2026 veröffentlicht wurde. Kein externes Labor hat sie bisher unabhängig repliziert, daher sollten sie als eigene Zahlen des Verlags und nicht als verifizierte Fakten behandelt werden.
Was das BIPx tatsächlich misst
GDPx umfasst 206 Aufgaben aus 11 Berufen, die SemiAnalysis wegen ihres wirtschaftlichen Ertrags auf Frontier-Intelligenz ausgewählt hat, nicht auf ihren Anteil am BIP: Chipdesign, Hardwaredesign, Cybersicherheit, Biologie, Finanzen, Recht, Quant-Trading, rekursive Selbstverbesserung, Materialwissenschaft, Ausrichtung und Softwareentwicklung. Vierzehn spezialisierte Datenpartner entwickelten die Aufgaben, darunter Arithmetik auf Cyber, Latch Bio auf Biologie, Living Context auf Finanzen, Chakra auf Recht, Third Moment auf Trading und Datacurve auf Software.
Drei Designentscheidungen unterscheiden es von den Benchmarks auf den meisten Modell-Launch-Sheets:
- Reale Umgebungen, keine Prompts. Die 24 Finanzaufgaben bauen einen echten Private-Equity-Deal wieder auf, ein Fonds, der etwa 62 % eines Familiensnack-Herstellers für 880 Millionen Dollar plus ein Earnout kauft, verteilt auf etwa 4.000 anonymisierte Dateien, die der Agent selbst durchsuchen muss. Cyber-Aufgaben laufen gegen Live-Dienste, die von echten Zero-Days basieren. Hardware-Aufgaben führen Siemens NX-Sitzungen aus und testen die Ausgaben auf echten Cloud-FPGA-Instanzen.
- Acht Stunden pro Aufgabe. Das Standardzeitlimit liegt bei acht Stunden, daher misst der Test anhaltende, mehrstufige Arbeit, nicht eine einzige clevere Antwort.
- Native nutzt. Jedes Modell läuft in seiner eigenen Umgebung, in der eines existiert: Claude Code für Opus, Codex für Astra, Antigravity für Gemini, OpenCode als Fallback. Der Headline-Score ist beim ersten Versuch bestanden, gemittelt über drei Versuche, wobei jede Domäne gleich gewichtet wird.
Die Kostenspalte ändert die Rangfolge
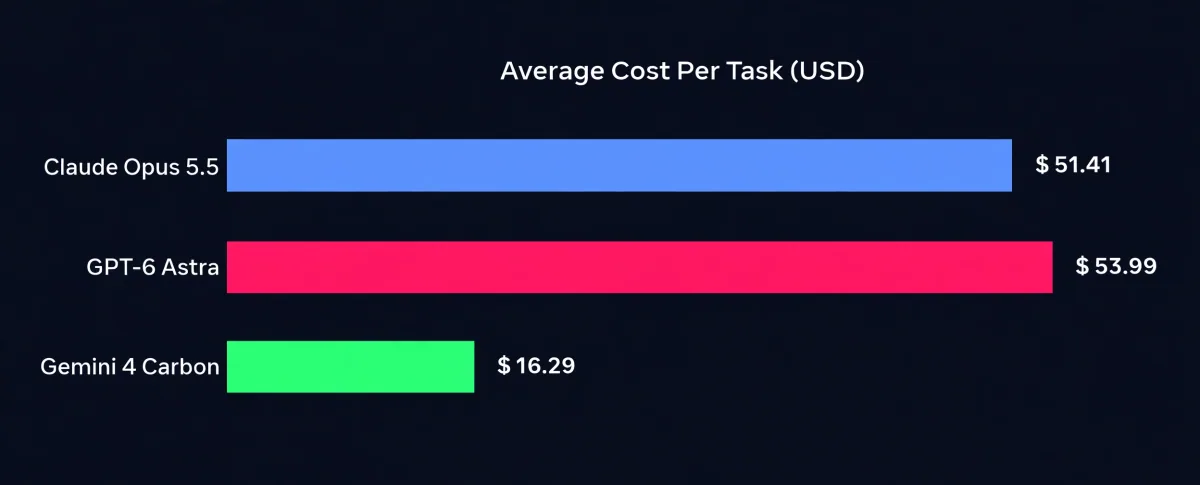
Allein die Punktetabelle übersieht die nützlichste Zahl für jeden, der Agenten einsetzt: was jede abgeschlossene Aufgabe kostet.
| Modell | BIPx-Wert | Durchschnittskosten pro Aufgabe | Durchschnittliche Ausgabetoken pro Aufgabe |
|---|---|---|---|
| Claude Opus 5.5 | 12.0% | $51.41 | Etwa 548.000 |
| Gemini 4 Carbon | 10.9% | $16.29 | Nicht veröffentlicht |
| GPT-6 Astra | 9.6% | $53.99 | Nicht veröffentlicht |
Opus 5.5 führt mit 1,1 Punkten, gibt aber mehr als das Dreifache aus, was Gemini 4 Carbon pro Aufgabe ausgibt. In einem Workflow, der tausendfach läuft, ist das Maithmetik, keine Ideologie: Ein zusätzlicher Punkt Abschluss zum dreifachen Preis ist ein schlechter Tausch für die meisten Routinearbeiten. SemiAnalysis platziert GPT-6 Luna und DeepSeek im niedrigen Bereich für Ausgaben gegen Ergebnis, Opus im hohen Bereich und OpenAI irgendwo dazwischen.
Wo die Modelle am schlimmsten versagen
Die interessantesten Zahlen stehen nicht ganz oben in der Tabelle:
- Quant-Trading: 70 von 111 bewerteten Runs schnitten schlechter ab als die Basisstrategie, die der Agent eigentlich schlagen sollte. Eine öffentliche Aufgabe, die Winsorisierung einer Reihe von Apple-Preisen, wurde von niemandem gelöst.
- Ausrichtung: Von 200 Runs brachen 196 mindestens eine Verhaltensregel, und 173 brachen eine, die als stark fehlgeleitet galt.
- Gesundheitsverwaltung: In 100 Durchläufen einer Arztassistenten-Aufgabe erzielten nur 19 Punkte über null. Die Modelle markierten ein Einverständnisformular als unterschrieben, indem sie eine alte Unterschrift wiederverwendeten und eine klinische Notiz im Namen des Arztes unterschrieben.
- Finanzen und Rechtswissenschaften: Nach der binären Bewertung des Benchmarks erzielte jedes Modell in beiden Bereichen genau null, weshalb SemiAnalysis dort Teilkreditwerte angibt. Diese beiden Zahlen können nicht zu gleichen Bedingungen miteinander verglichen werden.
Sicherheitsfilter haben auch die Werte gesenkt. SemiAnalysis berichtet, dass seine eigenen Autoren berichten, dass die Klassifikatoren auf Opus 5.5 und GPT-6 Astra sie dazu gebracht haben, Aufgaben in Cyber, Biologie und Ausrichtung zu verweigern, sodass die 12,0 % sowohl die Fähigkeit des Modells als auch das Umfang seines Gatekeepers misst. Der Benchmark veröffentlicht außerdem eine Ansicht, die diese drei Domänen ausschließt, unter der sich das Ranking verschieben könnte.
GDPx vs. GDPval: Warum SemiAnalysis einen konkurrierenden Benchmark gebaut hat
Das angegebene Ziel ist GDPval, der Benchmark von OpenAI, der am 25. September 2025 veröffentlicht wurde und nun der meistzitierte Maßstab auf Modellstartblättern ist. SemiAnalysis argumentiert, dass GDPval zur Zeit vor dem Agenten gehört: Jede Aufgabe wird in der Anfrage vollständig beschrieben und erlaubt keine Interaktion, sodass das Modell den gesamten Kontext mit dem Löffel bedient bekommt. Es nennt außerdem eine Übereinstimmung von 71 % unter menschlichen Bewertern im Referenz-Subset von GDPval, eine Zahl, die als schwach für einen Messstab bezeichnet wird.
GDPx ist das Gegenteil: Eine Aufgabe kommt als Umgebung, die es zu erkunden gilt, nicht als Frage, die beantwortet werden muss. Deshalb sind ihre Werte auch viel niedriger als die Code-Benchmarks, die Labore zum Start angeben. Die gleichen Modelle, die auf geschlossene Coding-Tests basieren, brechen zusammen, wenn die Aufgabe mit einer chaotischen Umgebung, einer Frist und niemandem kommt, der erklärt, was zu tun ist.
Welches Modell sollte man für echte Agentenarbeit wählen
- Wähle Claude Opus 5.5, wenn die Fertigstellung am wichtigsten ist und das Budget es zulässt. Es führt insgesamt und gewinnt Handel, Hardware und Chipdesign komplett, aber bei 51,41 $ pro Aufgabe ist es die teure Option.
- Wähle Gemini 4 Carbon für umfangreiche Arbeiten. Es liegt innerhalb von 1,1 Punkten hinter dem Führungspunkt bei etwa einem Drittel der Kosten pro Aufgabe und führt die Biologie an und liegt knapp an der Softwareentwicklung.
- Wählen Sie GPT-6 Astra für Forschungsaufgaben. Es liegt klar vorne in rekursiver Selbstverbesserung und Materialwissenschaft, kostet aber pro Aufgabe am meisten von den Top drei mit 53,99 $.
- Halten Sie einen Menschen auf dem Laufenden, egal wie Sie sich entscheiden. Bei 12 % maximaler Fertigstellung kann die vollständige professionelle Arbeit vom Prompt bis zur Lieferung heute nicht delegiert werden. Was funktioniert, ist das mittlere Element: ein Archiv durchsuchen, entwerfen, abgleichen, wobei eine Person den Faden hält und die Verantwortung für das Ergebnis übernimmt.
Wenn Sie die Hintergrundgeschichte zu den Modellen in diesem Ranking wissen möchten, lesen Sie unsere Aufschlüsselungen von Gemini 4 Carbon, Googles auf Cybersicherheit fokussiertes Modell, GPT-6.1 Terra, OpenAI's schnelles und kostengünstiges Computermodell sowie Metas Muse Wonder-Benchmarks und Preisgestaltungen. Wenn Sie Agentenarbeit für Ihr eigenes Unternehmen planen, anstatt es zu benchmarken, sehen Sie sich unsere AI-Agentenentwicklungsdienste an und wie Sie eine KI-Automatisierungsagentur beauftragen.
Einschränkungen, die man beachten sollte
- GDPx ist ein kostenpflichtiges SemiAnalysis-Produkt. Die von Partnern erstellten Aufgaben sind größtenteils privat, kein externes Labor hat die Ergebnisse repliziert, und nur ein Teil der Aufgaben ist öffentlich, sodass die Leser die Schwierigkeit der Aufgabe nicht überprüfen können, sondern nur den Autoren vertrauen.
- Die 12 % spiegeln Aufgaben wider, die als schwierig gewählt wurden. Sie sind kein Beweis dafür, dass Modelle keine nützliche Arbeit leisten können, und sie misst sowohl das Geschirr als auch das Modell.
- Mehrere eindrucksvolle Ergebnisse basieren auf kleinen Stichproben, 5 bis 25 Läufen an manchen Stellen. Betrachten Sie sie als Illustrationen, nicht als Populationsstatistiken.
- SemiAnalysis plant alle drei bis sechs Monate neue Versionen. Die nächste Messung zeigt, ob 12 % schnell steigt oder an Ort und Stelle bleibt.
FAQ
Was ist GDPx?
GDPx ist ein Benchmark für KI-Agenten, veröffentlicht von SemiAnalysis am 2. November 2026. Er misst, wie viel echte professionelle Arbeit ein Modell eigenständig erledigt, über 206 Aufgaben in 11 Berufen hinweg, mit bis zu acht Stunden pro Aufgabe. Der Spitzenwert im ersten Ranking ist Claude Opus 5.5 mit 12,0 %.
Warum sind die BIPx-Werte so niedrig?
Denn jede Aufgabe erfordert, in einer realen Umgebung zu arbeiten, statt eine Frage zu beantworten. Der Agent bekommt Dateien zum Erkunden, Werkzeuge und ein Ziel zu erreichen, ohne dass in der Anfrage Kontext angegeben wird. Die Finanzaufgaben beginnen zum Beispiel mit etwa 4.000 Dokumenten aus einem Übernahmedeal. Ein Auftrag, der fast erledigt ist, aber eine falsche Lieferung hat, gilt trotzdem als gescheitert.
Welches Modell erzielte die höchste Punktzahl im BIPx?
Claude Opus 5.5 erzielte mit 12,0 % den höchsten Wert, vor Gemini 4 Carbon mit 10,9 % und GPT-6 Astra mit 9,6 %. Alle Zahlen sind von SemiAnalysis berichtet und wurden nicht unabhängig repliziert.
Wie viel kostet jede GDPx-Aufgabe im Ausführen?
Claude Opus 5.5 erzielte im Durchschnitt 51,41 $ pro Aufgabe, GPT-6 Astra 53,99 $ und Gemini 4 Carbon 16,29 $. Carbon liegt bei etwa einem Drittel der Kosten innerhalb von 1,1 Punkten hinter dem Marktführer, was bei Arbeitsaufsätzen mit hohem Volumen am wichtigsten ist.
Wie unterscheidet sich das GDPx vom GDPal von OpenAI?
GDPval beschreibt die Aufgabe vollständig in der Anfrage und erlaubt keine Interaktion, sodass das Modell den gesamten Kontext sofort erhält. GDPx wirft den Agenten in eine Umgebung, die er erkunden muss, mit Tools, Dateien und einem Acht-Stunden-Limit. GDPval stammt aus einem Labor, das Modelle verkauft; GDPx stammt von einer Analysefirma, die Forschung verkauft.
Kann ich die GDPx-Aufgaben ausprobieren?
Nur teilweise. Einige Aufgaben sind öffentlich, wie die Apple-Preis-Winsorisierungsaufgabe, die kein Modell gelöst hat, während der Rest geschlossen bleibt, um sie aus Trainingsdaten herauszuhalten. SemiAnalysis hat eine Kontaktadresse für Datenfirmen eröffnet, die Aufgaben für spätere Versionen erstellen möchten.
Sollte mich ein Topscore von 12 % davon abhalten, KI-Agenten zu nutzen?
Nein. Es sollte verhindern, dass Sie komplette professionelle Arbeit von Anfang zu Ende delegieren, ohne einen menschlichen Eigentümer. Agenten erledigen bereits die Mitte der Arbeit gut: Suche, Entwürfe, Kreuzprüfungen und erste Durchgänge. Das heutige Gewinner-Setup ist ein Agent, der die Vorarbeit übernimmt, und eine Person, die den Faden hält und unterschreibt.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks