أخبار الذكاء الاصطناعي6 دقيقة قراءةبقلم JH Akash
إمبر ميوز: نتيجة هايكو 36 بثلث التكلفة
تتطابق Muse Ember من Meta مع Claude Haiku 5.5 عند 36 في مؤشر التحليل الاصطناعي، حيث يعادل حوالي ثلث تكلفة كل مهمة. إليكم المعايير المرجعية، والسعر، والشرط الأساسي.
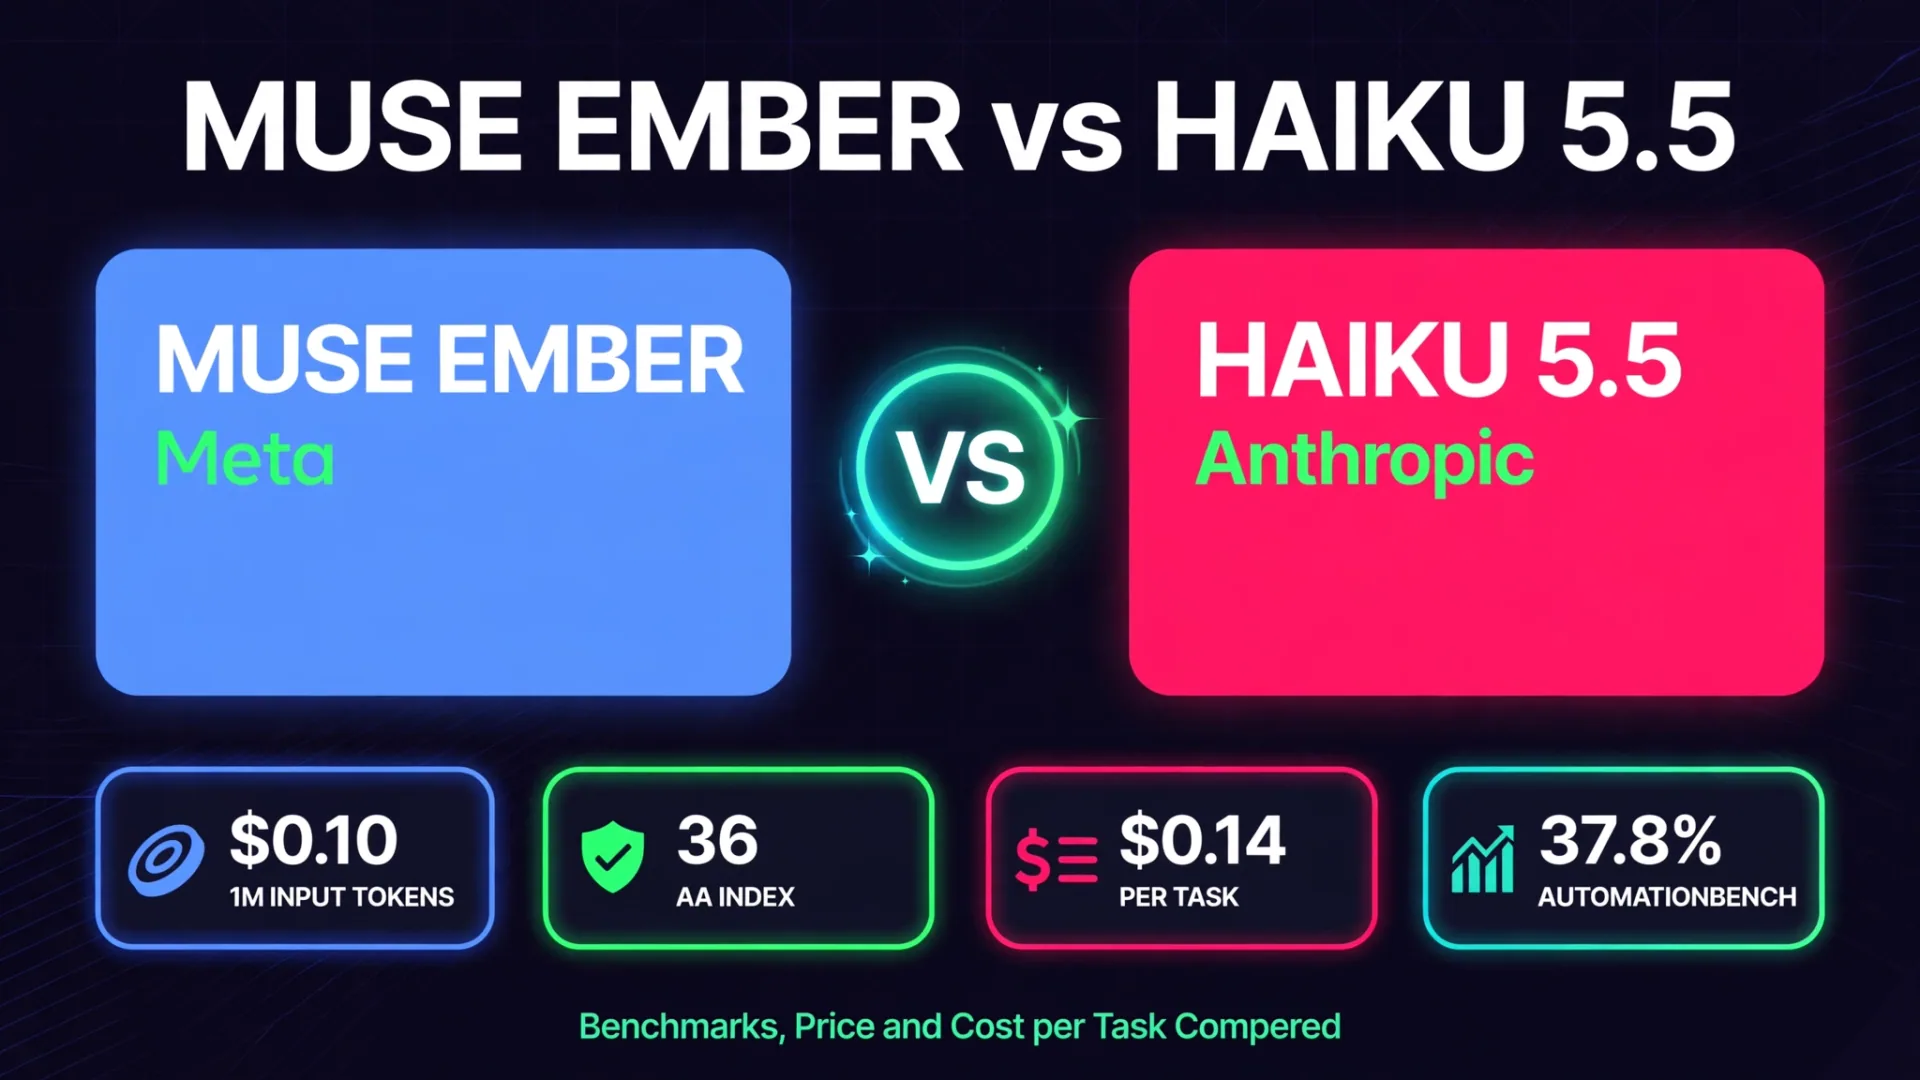
أطلقت ميتا Muse Ember في 9 نوفمبر 2026، ورقم العنوان يصعب تجاهله: فهو يطابق Claude Haiku 5.5 في المركز 36 في مؤشر الذكاء التحليلي الاصطناعي، بينما يكلف حوالي ثلث التكلفة لكل مهمة. Ember هو أصغر وأرخص نموذج Muse من ميتا، مصمم للعمل المتكرر الذي يقوم به وكلاء الذكاء الاصطناعي طوال اليوم: استدعاءات الأدوات، وترميز المهام الفرعية، والتوجيه، والاستخراج، وتحليل المستندات الطويلة.
المشكلة تكمن في التفاصيل الدقيقة. أسعار الرموز مطابقة لأسعار هايكو 5.5 و GPT-6 لونا. تفوز إمبر في تكلفة كل مهمة لأنها تستخدم عددا أقل بكثير من رموز الإخراج للوصول إلى نفس الدرجة. وفي معيار معيار، وهو الأقرب إلى الكود الحقيقي القابل للاندماج، لا تزال هايكو تفوز بوضوح. يقارن هذا المنشور النماذج الثلاثة من حيث السعر، والمعايير المعيارية، وأعباء العمل التي تم بناء كل منها من أجلها.
حكم سريع
| النموذج | مؤشر الذكاء المجهولين | تكلفة المهمة | الأفضل ل |
|---|---|---|---|
| ميوز إمبر | 36 | $0.136 | العمل الكبير على الوكلاء، وسير العمل |
| Claude Haiku 5.5 | 36 | $0.411 | كود قابل للدمج، أعمال مكتبية |
| GPT-6 لونا | 28 | $0.152 | مهام عامة رخيصة، أقل تكلفة لكل مهمة بعد إمبر |
جميع الدرجات تكون عند أقصى جهد منطقي، كما أوردت ميتا من بيانات التحليل الاصطناعي بتاريخ 9 نوفمبر 2026. المعايير التي ينشرها البائع تبلغ عنها البائع حتى يتم إعادة اختبارها بشكل مستقل.
ما هي ميوز إمبر
إمبر هو الطراز الرابع في عائلة ميتا ميوز. وصل Muse Spark في أبريل 2026 كموديل متوسط الوزن، وتبعه غليمر في أغسطس كطراز مزدوج مفتوح الوزن، وطراز الحدود Muse Wonder أطلق في أكتوبر. إمبر هو الصغير، وميتا تصفه بأنه الأكثر كفاءة في العائلة.
إنه نموذج متعدد الوسائط: يأخذ نصوصا وصورا وصوتيا وفيديو في مكالمة واحدة، بحيث يمكن للوكيل قراءة لقطات الشاشة، والمخططات، والمستندات الممسوحة ضوئيا، والمذكرات الصوتية، والفيديو دون الحاجة إلى نموذج منفصل. نافذة السياق هي 1,048,576 رمزا (1M)، مع ما يصل إلى 524,288 رمز إخراج (512K) لكل طلب. هذا يكفي لتغذية قاعدة شيفرة كاملة أو مجموعة مستندات كبيرة في مكالمة واحدة.
وهو متوفر الآن كنموذج muse-ember-1.0 على واجهة برمجة تطبيقات Meta Model وفي Muse Code، وكذلك على Google Cloud وOracle Cloud. الأوزان مغلقة، لذا هذا نموذج يعتمد فقط على واجهة برمجة التطبيقات وليس تنزيلا مفتوحا. تقول ميتا أيضا إن إمبر هو أول نموذج يتم تدريبه باستخدام Muse Wonder Full، وهو نموذجها الفريفريد، وأن حتى النماذج الأرخص قيد التدريب بالفعل. في نفس اليوم، وضعت ميتا أيضا Muse على Apple Watch وWear OS.
التسعير: نفس سعر الملصق، فاتورة مختلفة تماما
إليك الجزء الذي تخطئ فيه معظم العناوين. أسعار كل رمز في Ember هي نفسها تماما أسعار Haiku 5.5 و GPT-6 Luna. التوفير يأتي من الكفاءة، وليس من بطاقة أرخص.
| السعر لكل مليون رمز | حتى 200 ألف رمز | أكثر من 200 ألف رمز |
|---|---|---|
| المدخلات | $0.10 | $0.30 |
| الإدخال المخزن مؤقتا | $0.004 | $0.012 |
| الإنتاج | $0.50 | $1.50 |
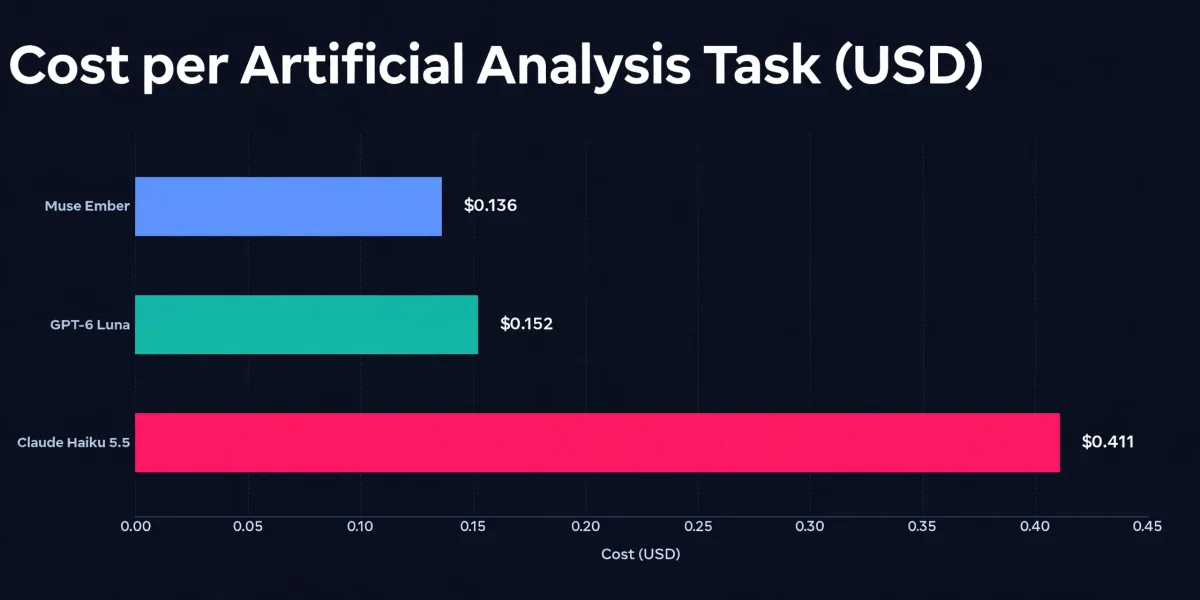
المستوى الأعلى ينطبق على الطلب بالكامل بمجرد تجاوز 200,000 رمز، لذا فإن المكالمات ذات السياق الطويل تكلف ثلاثة أضعاف تكلفة كل رمز. الرقم الحقيقي الذي يجب مراقبته هو تكلفة كل مهمة منتهية. في معايير التحليل الاصطناعي، يبلغ متوسط تكلفة إمبر حوالي 0.14 دولار لكل مهمة، وهايكو 5.5 حوالي 0.41 دولار، و GPT-6 لونا حوالي 0.15 دولار. تصل إمبر إلى نفس درجة هايكو مع استخدام حوالي ثلث رموز الإخراج، وهنا تنخفض قيمة الفاتورة.
للمقياس، يحصل نموذج ميتا الأكبر Muse Spark 1.3 على 37 نقطة في نفس المؤشر، أي نقطة واحدة فوق إمبر، لكنه يكلف 2.39 دولارا لكل مهمة، أي حوالي 17 ضعف تكلفة إمبر. الصفقة واضحة: نقطة مؤشر إضافية مقابل 17 ضعف تكلفة المهمة.
الاختبارات: حيث تفوز إمبر، وأين تخسر
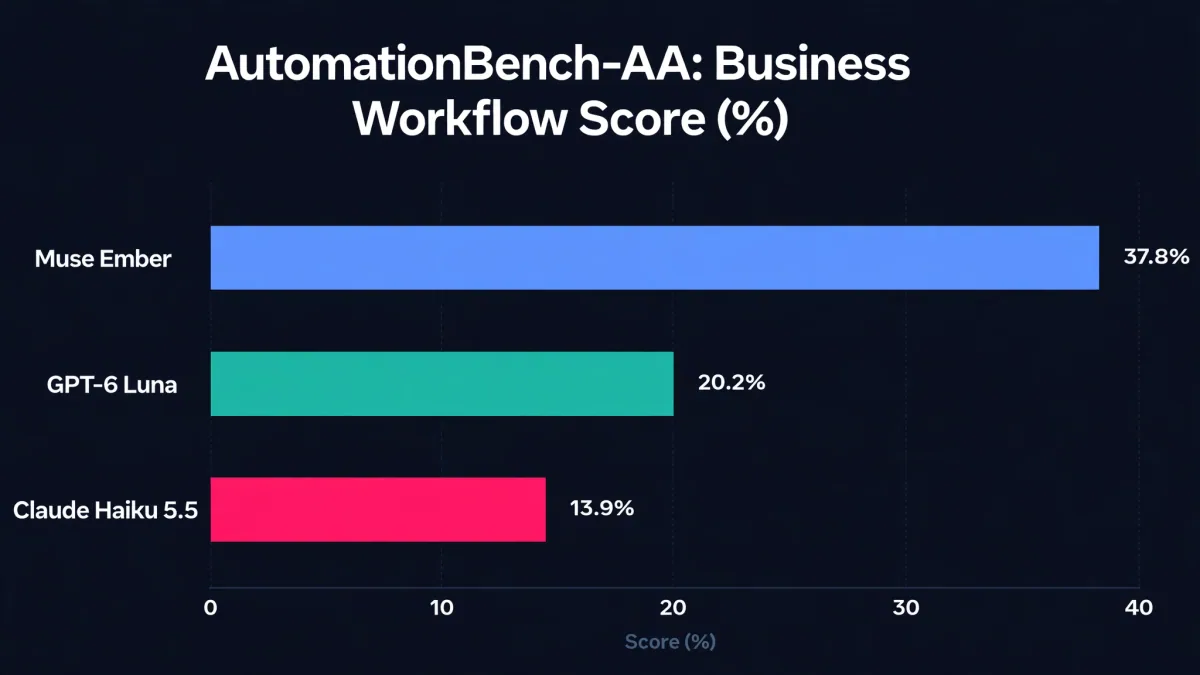
نشرت ميتا عشرة مقارنات وجها لوجه بأقصى جهد تفكير. أكبر فجوة تكمن في سير العمل التجاري، وأصغرها في الكود القابل للدمج.
| المعيار | ميوز إمبر | Claude Haiku 5.5 | GPT-6 لونا |
|---|---|---|---|
| مؤشر التحليل الاصطناعي | 36 | 36 | 28 |
| تكلفة كل مهمة AA | $0.136 | $0.411 | $0.152 |
| AutomationBench-AA (سير العمل التجاري) | 37.8% | 13.9% | 20.2% |
| آخر اختبار للعملاء | 61.6% | 57.0% | 57.1% |
| Terminal-Bench 4.0 (الترميز الوكيل) | 40.9% | 39.2% | 16.4% |
| مؤشر وكيل الترميز-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA (رمز قابل للدمج) | 27.2% | 34.9% | 25.2% |
| OSWorld 2.1 (استخدام الكمبيوتر، ثنائي) | 33.8% | 27.8% | 17.0% |
| GDP.pdf-AA (وثائق طويلة) | 22.8% | 20.8% | 22.8% |
| PerceptionBench (بصري، مع أدوات) | 80.6% | 78.6% | 62.8% |
اقرأ الجدول بعناية. النتيجة البارزة ل Ember هي AutomationBench-AA، التي تشغل 657 سير عمل أعمال حقيقي: 37.8٪ مقابل 13.9٪ ل Haiku٪، أي ما يقرب من ثلاثة أضعاف الأمر. كما يتصدر الترميز الوكيلي في Terminal-Bench وفي مؤشر وكيل الترميز، الذي يقيس النموذج ضمن سلسلة الترميز الحقيقية.
لكن FrontierCode 2.0-AA، الاختبار الأقرب للكود الذي يمكنك دمجها دون تعديلات، يسير في الاتجاه المعاكس: هايكو 5.5 يحصل على 34.9٪ مقابل 27.2٪ لإمبر. وعلى مؤشر العناوين نفسه، التعادل مقرب: غير مستقر، هايكو 36.2 وإمبر 35.8. نفس الدرجة في الرسم البياني، مع فجوة صغيرة حقيقية تحتها. كما أجرت ميتا أربع من عشرة مقارنات بنفسها واعتبرت المنافس أفضل جهد، لذا اعتبر الأرقام كأنها مبلغ من البائع.
أي موديل أختار
اختر Muse Ember إذا كنت تستخدم الوكلاء بحجم كبير: دعم الفرز، استخراج المستندات، التوجيه، استدعاءات الأدوات، وتكرار المهام الفرعية في البرمجة. نافذة السياق التي تبلغ 1 مليون دولار وتكلفة 0.14 دولار لكل مهمة تجعلها أرخص طريقة لتشغيل الذكاء على مستوى Haiku طوال اليوم. راقب مستوى الرمز البالغ 200 ألف، حيث تتضاعف الأسعار ثلاث مرات.
اختر Claude Haiku 5.5 إذا كتب وكيلك كودا يجب أن يندمج بشكل نظيف، أو إذا كنت بحاجة إلى اتفاقية ونظام معالجة بيانات مثبت. تكلف حوالي ثلاثة أضعاف المهمة لنفس درجة المؤشر، لكنها تفوز بمعيار الشفرة القابلة للدمج بفارق كبير.
اختر GPT-6 Luna إذا كنت تريد الخيار الأقل مخاطرة ورخيصا داخل نظام OpenAI البيئي. يتخلف عن كلا المنافسين في المؤشر عند 28 نقطة، لكن تكلفة المهمة لكل مهمة تكاد تكون منخفضة مثل تكلفة Ember، وهذا يعادل Ember في العمل على المستندات الطويلة.
بالنسبة للفرق التي تبني وكلاء، الخطوة العملية هي تقسيم الوكلاء: إمبر للخطوات المتكررة ذات الحجم العالي، ونموذج أقوى للكود النهائي أو القرار الذي يجب أن يكون صحيحا. هذا بالضبط هو عبء العمل الذي تم بناء إمبر من أجله. إذا كنت تخطط لهذا النوع من الإعداد، فإن دليلنا لخدمات تطوير وكلاء الذكاء الاصطناعي يوضح تكلفة نظام الوكلاء لبناءه، ويمكنك أيضا توظيف وكالة أتمتة ذكاء اصطناعي لبنائه لك.
Anthropic أيضا لا تقف ساكنة. حصل طراز الحدود الجديد Claude Fable 5.2 على المركز الأول في نفس المؤشر عند 65، ونموذج GPT-6 Astra الرائد من OpenAI هو النموذج الذي تقاس معه أشقاء Ember الأكبر. سباق النماذج الصغيرة الآن يتعلق بالتكلفة لكل مهمة مكتملة، وليس تكلفة الرمز الواحد، وEmber ضبطت الرقم للتو ليكون 0.14 دولارا.
الأسئلة الشائعة
ما هو ميتا ميوز إمبر؟
Muse Ember هو أصغر وأكفأ نموذج ذكاء اصطناعي من Meta، أطلق في 9 نوفمبر 2026. تم تصميمه للعمل المتكرر الذي يقوم به وكلاء الذكاء الاصطناعي طوال اليوم: استدعاءات الأدوات، مهام البرمجة الفرعية، التوجيه، الاستخراج، وتحليل المستندات الطويلة. يتوفر ك muse-ember-1.0 على واجهة برمجة تطبيقات Meta Model وMuse Code.
كم يكلف Muse Ember؟
تكلفة Muse Ember تكلف 0.10 دولار لكل مليون رمز إدخال و0.50 دولار لكل مليون رمز إخراج للأوامر التي تصل إلى 200,000 رمز، مع الإدخال المخزن بسعر 0.004 دولار. عند 200,000 رمز ترتفع الأسعار إلى $0.30 للإدخال، $0.012 مخبأ، و$1.50 للمخرجات. في اختبارات التحليل الاصطناعي، يبلغ متوسط السعر حوالي $0.14 لكل مهمة.
هل Muse Ember أفضل من Claude Haiku 5.5؟
في مؤشر الذكاء التحليلي الاصطناعي، يحصل كل منهما على 36 عند الحد الأقصى من المنطق، ويكلف Ember حوالي ثلث التكلفة لكل مهمة. كما تحقق Ember فوزا كبيرا في سير العمل التجاري (37.8٪ مقابل 13.9٪ في AutomationBench-AA). Haiku 5.5 أقوى في الكود القابل للاندماج، حيث حصل على 34.9٪ مقابل 27.2٪ لإمبر في FrontierCode 2.0-AA.
هل Muse Ember مفتوح المصدر؟
لا. لم تصدر ميتا الأوزان. Muse Ember هو نموذج يعتمد فقط على واجهة برمجة التطبيقات، متوفر عبر واجهة برمجة تطبيقات Meta Model وMuse Code وGoogle Cloud وOracle Cloud.
ما هي نافذة السياق في Muse Ember؟
يحتوي Muse Ember على نافذة سياق بسعة 1,048,576 رمز (1M) ويدعم حتى 524,288 رمز إخراج (512K) لكل طلب. يقبل النصوص، والصور، والصوت، والفيديو كمدخل.
المصادر: أبحاث Meta AI، "تقديم أصغر وأكثر نماذج كفاءة لدينا: Muse Ember"، 9 نوفمبر 2026؛ مؤشر الذكاء الاصطناعي للتحليل الصناعي v5، 9 نوفمبر 2026. أرقام المعيار كما نشرتها Meta ويتم الإبلاغ عنها من قبل البائعين.
- Muse Ember
- Meta Muse
- Claude Haiku 5.5
- GPT-6 Luna
- AI benchmarks