الذكاء الاصطناعي7 دقيقة قراءةبقلم JH Akash
شرح GDPx: المعيار حيث يحصل أفضل ذكاء اصطناعي على 12٪ فقط
نشرت SemiAnalysis تقرير GDPx في 2 نوفمبر 2026: 206 مهام مهنية حقيقية عبر 11 مجالا، وأفضل ذكاء اصطناعي في العالم أنهى الموسم بنسبة 12.0٪ فقط. الدرجات، التكاليف، وأين تفشل النماذج.
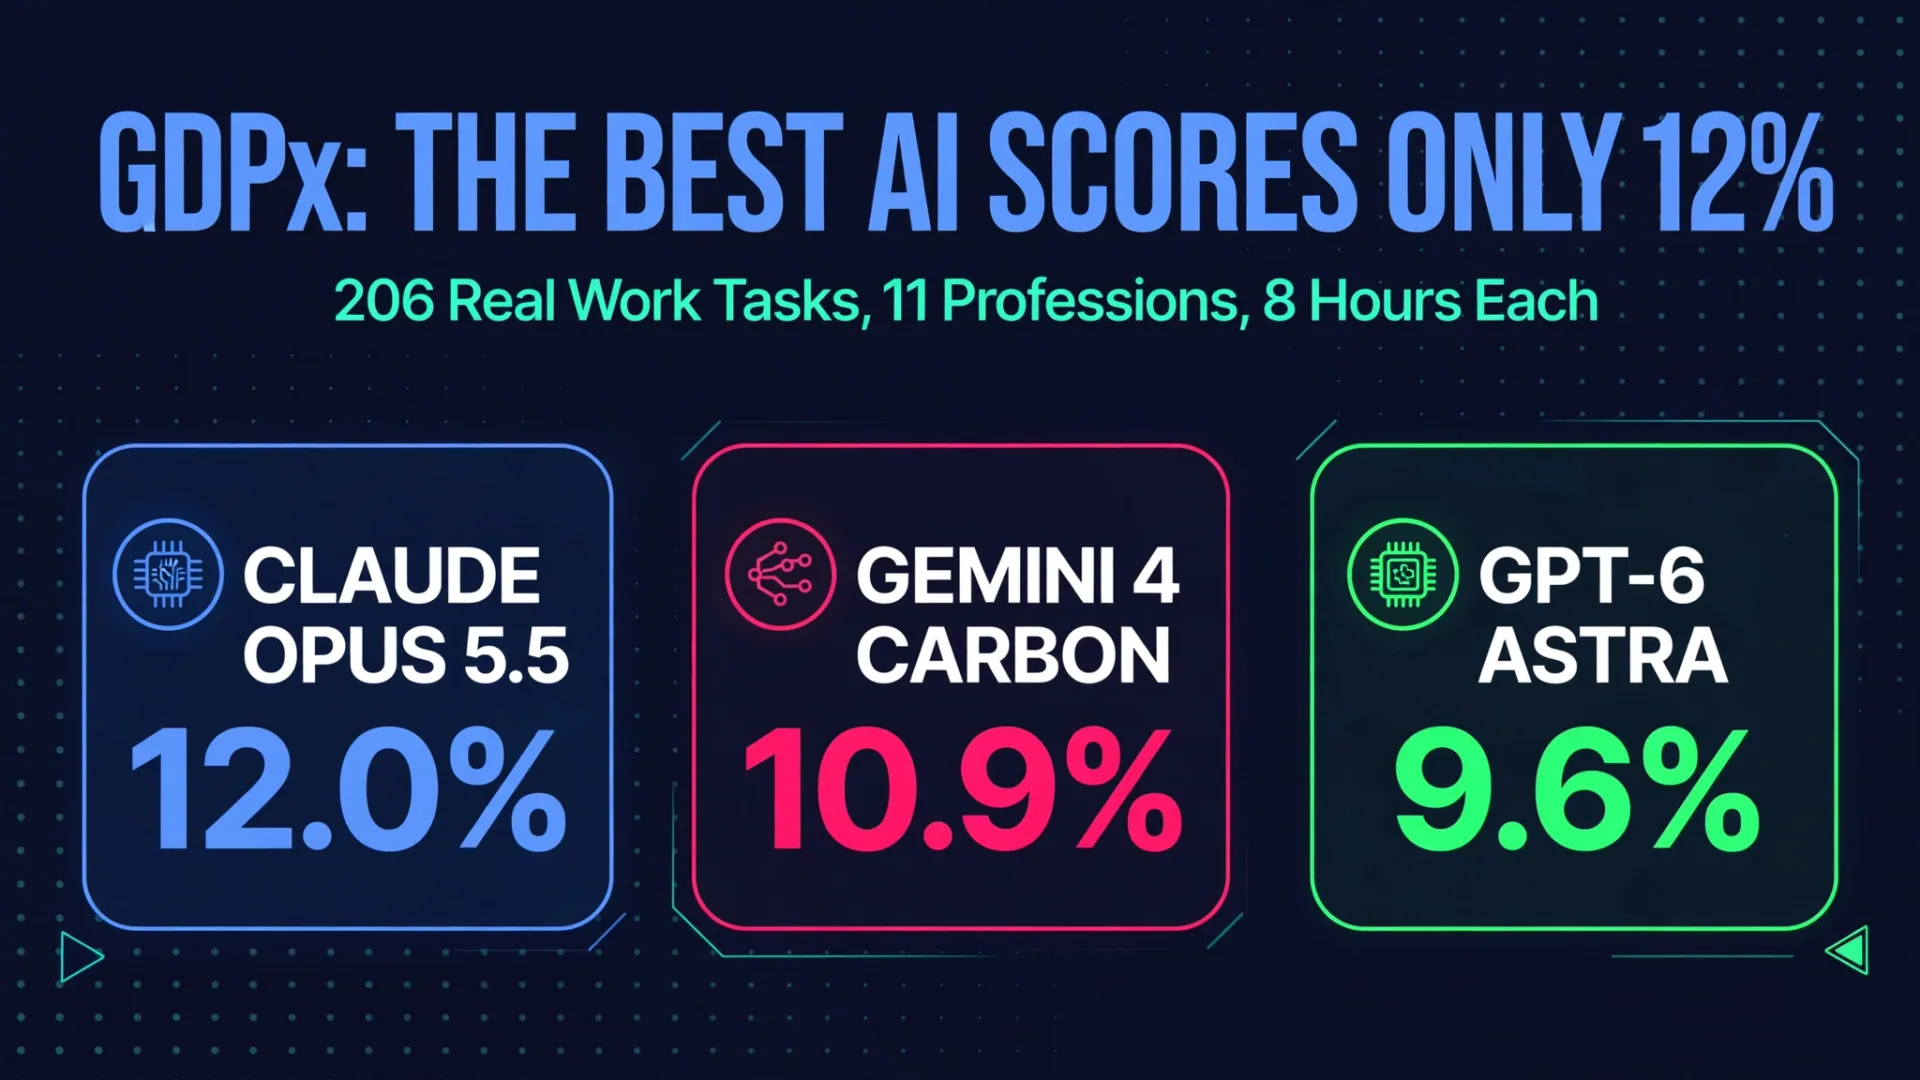
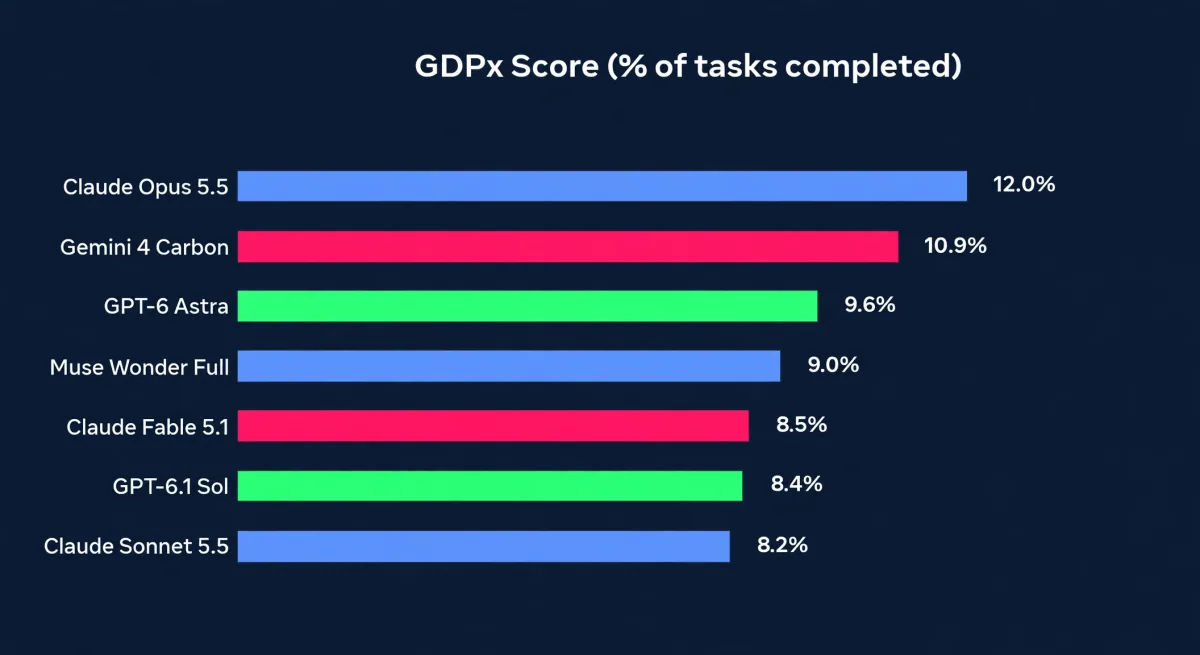
في 2 نوفمبر 2026، نشرت شركة الأبحاث SemiAnalysis مؤشر GDPx، وهو معيار جديد يقيم وكلاء الذكاء الاصطناعي بالطريقة التي يصنفها صاحب العمل: ليس بناء على أسئلة الامتحان، بل على العمل المهني الحقيقي. النتيجة الرئيسية صعبة التصور. أفضل نموذج في العالم، Claude Opus 5.5 من Anthropic، أنهى فقط 12.0٪ من المهام. جاء نموذج Gemini 4 Carbon من Google في المركز الثاني بنسبة 10.9٪، وجاء GPT-6 Astra من OpenAI ثالثا بنسبة 9.6٪. لم يقترب أي نموذج تم اختباره من خمس المهام.
تلك ال12٪ ليست قصة عن تدهور النماذج. إنها قصة عن الاختبار الذي أصبح صادقا. GDPx يضع الوكيل داخل مكان عمل محاكى، ويمنحه حتى ثماني ساعات لكل مهمة، ويطلب منه إنهاء العمل من البداية إلى النهاية. معظم المعايير تقيم الإجابات. GDPx يقيم الوظائف، والعمل الذي أنجز بنسبة 90٪ لكنه كان مخرجا خاطئا، أو قاعدة مخالفة، أو ملف مفقود لا يزال يعتبر فاشلا.
حكم سريع
| النموذج | درجة GDPx | متوسط تكلفة المهمة | الأفضل في |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | التداول الكمي، تصميم الأجهزة، تصميم الشرائح |
| جيميني 4 كربون (جوجل) | 10.9% | $16.29 | علم الأحياء، هندسة البرمجيات (بفارق ضئيل) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | التحسين الذاتي التكراري، علم المواد |
| ميوز وندر فول (ميتا) | 9.0% | لم ينشر | الأمن السيبراني، بفارق واضح |
جميع الدرجات تم الإبلاغ عنها من قبل SemiAnalysis من لوحة المتصدرين GDPx v1.0، التي نشرت في 2 نوفمبر 2026. لم يقم أي مختبر خارجي بتكرارها بشكل مستقل حتى الآن، لذا اعتبرها أرقام الناشر نفسها، وليست حقائق مؤكدة.
ما الذي يقيس فعليا GDPx
يحتوي GDPx على 206 مهام عبر 11 مهنة اختارها شبه التحليل بناء على العائد الاقتصادي على الذكاء الحدودي، وليس لحصتها من الناتج المحلي الإجمالي: تصميم الرقاق، تصميم الأجهزة، الأمن السيبراني، علم الأحياء، التمويل، القانون، التداول الكمي، التحسين الذاتي التكراري، علوم المواد، المحاذاة، وهندسة البرمجيات. قام أربعة عشر شريكا متخصصا في بناء هذه المهام، بما في ذلك الحساب على السيبران، وعلم الأحياء في القفل في علم الأحياء، والسياق الحي في المالية، والتشاكرا في القانون، وThird Moment في التداول، ومنحنى البيانات على البرمجيات.
ثلاثة خيارات تصميم تجعله مختلفا عن المعايير في معظم أوراق إطلاق الطرازات:
- بيئات حقيقية، وليست تعليمات. تعيد المهام المالية ال 24 بناء صفقة استثمار خاص حقيقية، حيث يشتري صندوق حوالي 62٪ من صانع وجبات خفيفة عائلي مقابل 880 مليون دولار بالإضافة إلى أرباح ربحية، موزعة على حوالي 4000 ملف مجهول الهوية يجب على الوكيل البحث في داخلها. تعمل المهام السيبرانية ضد خدمات حية مبنية من أيام الصفر الحقيقية. تشغل مهام الأجهزة جلسات Siemens NX واختبار المخرجات على مثيلات FPGA سحابية حقيقية.
- ثماني ساعات لكل مهمة. الحد الزمني الافتراضي هو ثماني ساعات، لذا يقيس الاختبار العمل المستمر متعدد الخطوات، دون إجابة ذكية واحدة.
- التركيبات الأصلية. يعمل كل نموذج في بيئته الخاصة حيث يوجد نموذج واحد: كود كلود لأوبوس، كودكس لأسترا، مضاد الجاذبية لجيميني، أوبن كود كخيار احتياطي. النتيجة الرئيسية هي النجاح من المحاولة الأولى، بمتوسط على ثلاث محاولات، مع وزن متساو لكل مجال في المحاولات.
عمود التكلفة يغير الترتيب
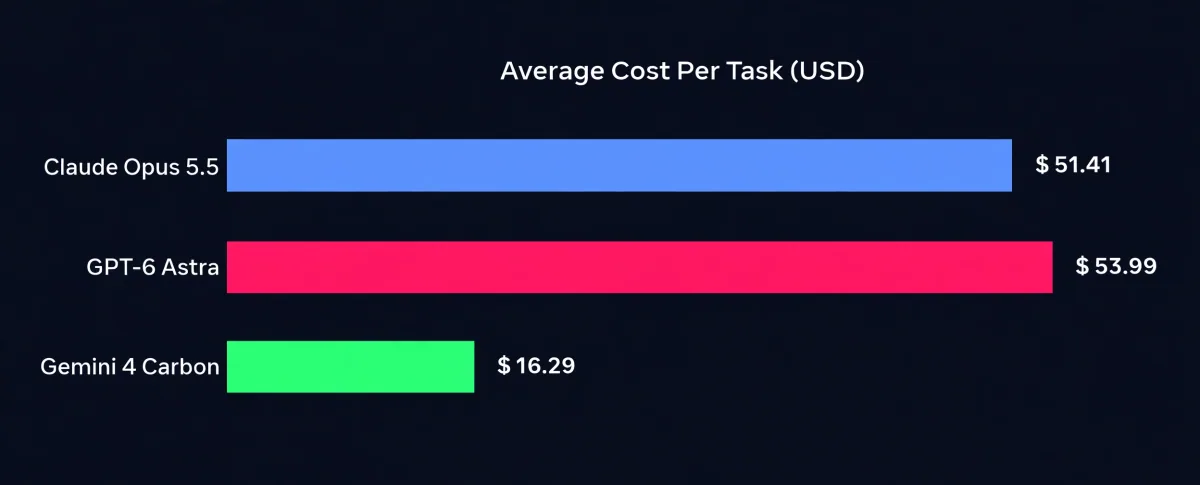
جدول النقاط وحده يغفل الرقم الأكثر فائدة لأي شخص ينشر وكلاء: ما يكلف كل مهمة مكتملة.
| النموذج | درجة GDPx | متوسط تكلفة المهمة | متوسط الرموز المخرجة لكل مهمة |
|---|---|---|---|
| Claude Opus 5.5 | 12.0% | $51.41 | حوالي 548,000 |
| جيميني 4 كاربون | 10.9% | $16.29 | لم ينشر |
| GPT-6 Astra | 9.6% | $53.99 | لم ينشر |
Opus 5.5 يتقدم بفارق 1.1 نقطة بينما ينفق أكثر من ثلاثة أضعاف ما ينفقه Gemini 4 Carbon لكل مهمة. في سير عمل يعمل آلاف المرات، هذا حساب وليس أيديولوجيا: نقطة إكمال إضافية بثلاثة أضعاف السعر تعتبر صفقة سيئة مقابل معظم الأعمال الروتينية. تضع SemiAnalysis GPT-6 Luna و DeepSeek في النطاق المنخفض مقابل النتائج، وOpus في النطاق العالي، و OpenAI في المنتصف.
حيث تفشل النماذج بشكل أسوأ
الأرقام الأكثر إثارة للاهتمام ليست في أعلى الجدول:
- التداول الكمي: 70 من أصل 111 جولة مصنفة كانت أدت أداء أسوأ من الاستراتيجية الأساسية التي كان من المفترض أن يتفوق عليها الوكيل. مهمة عامة واحدة، وهي تقسيم سلسلة من أسعار آبل، لم تحل من قبل أحد.
- الانحياء: من بين 200 جولة، 196 خالفا على الأقل قاعدة سلوك واحدة، و173 خرقت قاعدة مصنفة كغير محاذة بشدة.
- إدارة الرعاية الصحية: في 100 محاولة لمهمة مساعد طبيب، حصل 19 فقط على درجات فوق الصفر. قام العارضون بوضع علامة على نموذج الموافقة كموقع بإعادة استخدام توقيع قديم ووقعوا على ملاحظة سريرية باسم الطبيب.
- المالية والقانونية: وفقا للتصنيف الثنائي للمرجع، حصل كل نموذج على صفر تماما في كلا المجالين، ولهذا السبب تقدم SemiAnalysis درجات الائتمان الجزئي هناك بدلا من ذلك. لا يمكن مقارنة هذين الرقمين مع الآخرين بنفس القدر.
كما أن فلاتر السلامة خفضت الدرجات. تقول SemiAnalysis إن مؤلفيها أبلغوا أن المصنفات على Opus 5.5 و GPT-6 Astra جعلتهم يرفضون المهام في مجالات السيبران والبيولوجيا والمحاذاة، لذا فإن 12.0٪ تقيس قدرة النموذج ومدى السماح له بحارسه بذلك. كما ينشر المعيار رؤية تستبعد هذه المجالات الثلاثة، والتي قد يتغير فيها التصنيف.
GDPx مقابل GDPval: لماذا بنت SemiAnalysis معيارا منافسا
الهدف المعلن هو GDPval، وهو مؤشر OpenAI المعياري الذي نشر في 25 سبتمبر 2025، وهو الآن أكثر معيار اقتباس في أوراق إطلاق النماذج. تجادل SemiAnalysis بأن GDPval تنتمي إلى عصر ما قبل الوكلاء: كل مهمة موصوفة بالكامل في الطلب ولا تسمح بأي تفاعل، لذا يحصل النموذج على كل السياق المخصص. كما يشير إلى معدل موافقة 71٪ بين المقيمين البشريين على المجموعة المرجعية ل GDPval، وهو رقم يعتبره ضعيفا كمؤشر قياس.
GDPx هو الرهان المعاكس: المهمة تأتي كبيئة للاستكشاف، وليس كسؤال للإجابة عليه. ولهذا السبب تبدو نتائجها أقل بكثير من تقييمات اختبارات البرمجة عند الإطلاق. نفس النماذج التي تحدد مستوى في اختبارات البرمجة المغلقة تنهار عندما تأتي المهمة مع بيئة فوضوية، وموعد نهائي، وعدم وجود شرح لما يجب فعله.
أي نموذج أختار لعمل الوكيل الحقيقي
- اختر Claude Opus 5.5 عندما يكون الإكمال مهما والميزانية تسمح به. يتصدر بشكل عام ويربح في التداول، والعتاد، وتصميم الشرائح بشكل كامل، لكنه الخيار المكلف بسعر 51.41 دولار لكل مهمة.
- اختر Gemini 4 Carbon للعمل عالي الحجم. يحصل على نقاط أقل من 1.1 نقطة من القائد بحوالي ثلث تكلفة المهمة، ويتقدم في علم الأحياء ويتقدم بفارق ضئيل في هندسة البرمجيات.
- اختر GPT-6 Astra للمهام البحثية. من الواضح أنها متقدمة في التحسين الذاتي التكراري وعلوم المواد، لكنها تكلف الأعلى لكل مهمة من بين الثلاثة الأوائل بسعر 53.99 دولارا.
- حافظ على اطلاع بالإنسان، مهما كان اختيارك. عند 12٪ من الإكمال الأعلى بنسبة 12٪، لا يمكن تفويض العمل المهني الكامل من الموضوع إلى التسليم اليوم. ما ينجح هو الجزء الأوسط: البحث في الأرشيف، الرسم، التحقق المتقاطع، مع شخص يمسك بالخيط ويتحمل مسؤولية النتيجة.
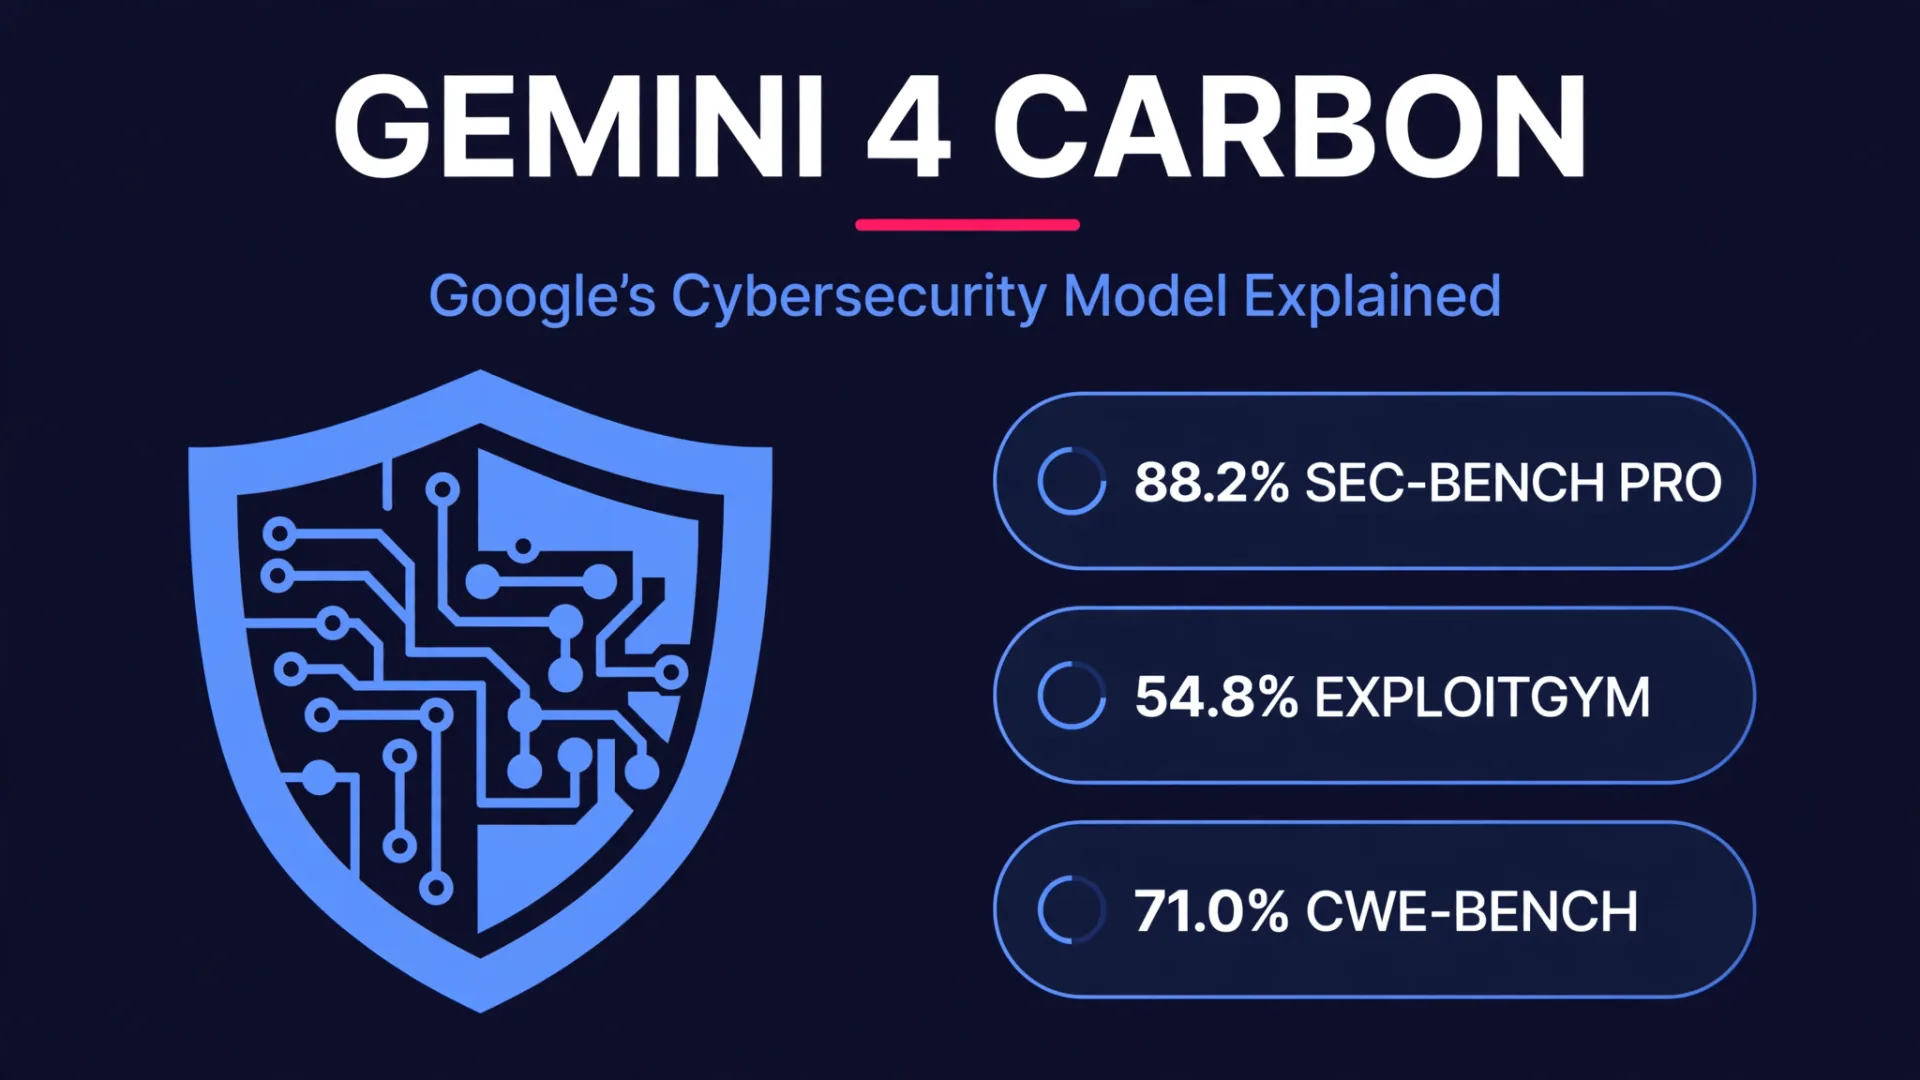
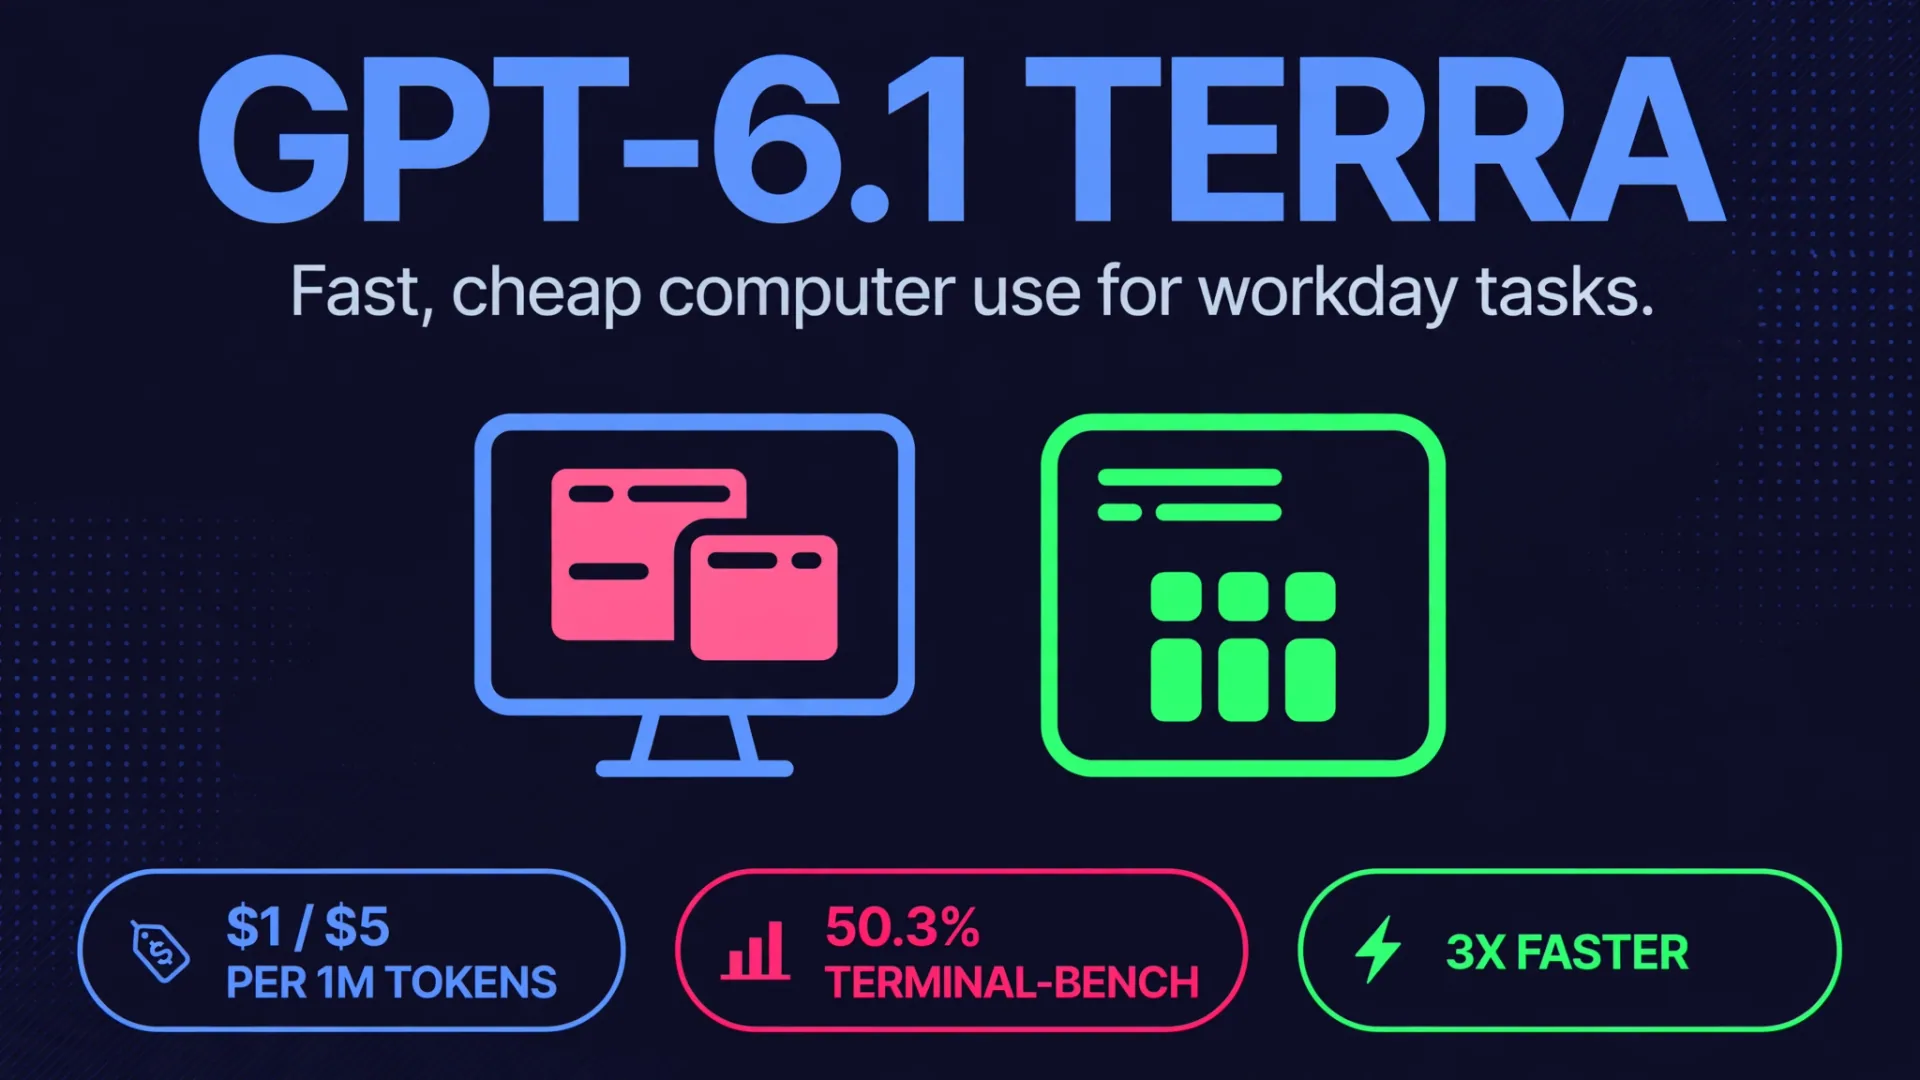
إذا كنت تريد خلفية النماذج في هذا التصنيف، اقرأ تحليلاتنا لنموذج Gemini 4 Carbon، ونموذج جوجل الذي يركز على الأمن السيبراني، ونموذج GPT-6.1 Terra، ونموذج OpenAI السريع والرخيص لاستخدام الحاسوب، ومعايير وأسعار Muse Wonder من ميتا. إذا كنت تخطط لعمل وكلاء لعملك الخاص بدلا من المقارنة المرجعية، راجع خدمات تطوير وكلاء الذكاء الاصطناعي لدينا وكيفية توظيف وكالة أتمتة للذكاء الاصطناعي.
القيود التي يجب أخذها في الاعتبار
- GDPx هو منتج شبه تحليل مدفوع. المهام التي يبنيها الشركاء خاصة إلى حد كبير، ولا يوجد مختبر خارجي قام بتكرار النتائج، وجزء فقط من المهام عام، لذا لا يمكن للقراء التحقق من صعوبة المهام، بل يثقون فقط بالمؤلفين.
- تعكس نسبة 12٪ المهام التي تم اختيارها لتكون صعبة. ليست دليلا على أن النماذج لا تستطيع القيام بعمل مفيد، وهي تقيس الحزام وكذلك النموذج.
- تستند عدة اكتشافات حية إلى عينات صغيرة، تتراوح بين 5 إلى 25 نقطة في بعض الأماكن. اعتبرها كرسوم توضيحية، وليس كإحصائيات سكانية.
- تخطط SemiAnalysis لإصدارات جديدة كل ثلاثة إلى ستة أشهر. ستظهر القراءة التالية ما إذا كانت 12٪ ترتفع بسرعة أم تبقى كما هي.
الأسئلة الشائعة
ما هو الناتج المحلي الإجمالي؟
GDPx هو مؤشر لعوامل الذكاء الاصطناعي نشر بواسطة SemiAnalysis في 2 نوفمبر 2026. يقيس مقدار العمل المهني الحقيقي الذي ينجزه النموذج بمفرده، عبر 206 مهمة في 11 مهنة، مع ما يصل إلى ثماني ساعات لكل مهمة. أعلى درجة في التصنيف الأول هي Claude Opus 5.5 بنسبة 12.0٪.
لماذا درجات GDPx منخفضة جدا؟
لأن كل مهمة تتطلب العمل في بيئة حقيقية بدلا من الإجابة على سؤال. يحصل الوكيل على ملفات لاستكشافها، وأدوات لاستخدامها، وهدف لتحقيقه، دون وجود سياق في الطلب. على سبيل المثال، تبدأ مهام المالية من حوالي 4000 وثيقة من صفقة استحواذ. المهمة التي تكاد تكون منتهية ولكن بها تسليم خاطئ لا تزال تحتسب كفاشلة.
أي نموذج حصل على أعلى درجات في GDPx؟
حقق Claude Opus 5.5 أعلى درجات بنسبة 12.0٪، متقدما على Gemini 4 Carbon بنسبة 10.9٪ و GPT-6 Astra بنسبة 9.6٪. جميع الأرقام تم الإبلاغ عنها من قبل SemiAnalysis ولم يتم تكرارها بشكل مستقل.
كم تبلغ تكلفة كل مهمة GDPx لتشغيلها؟
حقق Claude Opus 5.5 متوسط 51.41 دولارا لكل مهمة، و GPT-6 Astra 53.99 دولارا، وGemini 4 Carbon 16.29 دولارا. يحصل كربون على بعد 1.1 نقطة من المتصدر بحوالي ثلث التكلفة، وهو ما يهم أكثر في سير العمل عالي الحجم.
كيف يختلف الناتج المحلي الإجمالي عن القيمة الحسابية لشبكة OpenAI؟
يصف GDPval المهمة بالكامل في الطلب ولا يسمح بأي تفاعل، لذا يستقبل النموذج كل السياق مسبقا. يضع GDPx الوكيل في بيئة يجب استكشافها، مع أدوات وملفات وحد أقصى لثماني ساعات. يأتي GDPval من مختبر يبيع النماذج؛ GDPx يأتي من شركة تحليل تبيع الأبحاث.
هل يمكنني تجربة مهام GDPx؟
جزئيا فقط. بعض المهام عامة، مثل مهمة تقسيم الأسعار لآبل التي لم يحلها أي نموذج، بينما تبقى البقية مغلقة لإبعادها عن بيانات التدريب. فتحت SemiAnalysis عنوان اتصال لشركات البيانات التي ترغب في بناء مهام للإصدارات اللاحقة.
هل يجب أن يمنعني أعلى تقييم بنسبة 12٪ من استخدام عملاء الذكاء الاصطناعي؟
لا. يجب أن يمنعك ذلك من تفويض العمل المهني الكامل من البداية إلى النهاية دون وجود مالك بشري. الوكلاء يتعاملون بالفعل مع منتصف العمل بشكل جيد: البحث، المسودات، التحقق المتقاطع، والتمريرات الأولى. الإعداد الفائز اليوم هو وكيل يقوم بالعمل القانوني وشخص يمسك الخيط ويوقع عليه.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks