Outils IA et mises à jour8 min de lecturePar JH Akash
Faisceau IA de réflexion : le modèle à poids ouvert qui correspond à la Chine à un quart du calcul
Le Beam de Reflection AI est un modèle à poids ouvert 501B qui affirme un raisonnement de niveau GLM-5.2 avec 3 à 4 fois moins de calcul. Les spécifications, les benchmarks publiés par l’entreprise et la stratégie d’usine IA sont expliqués.
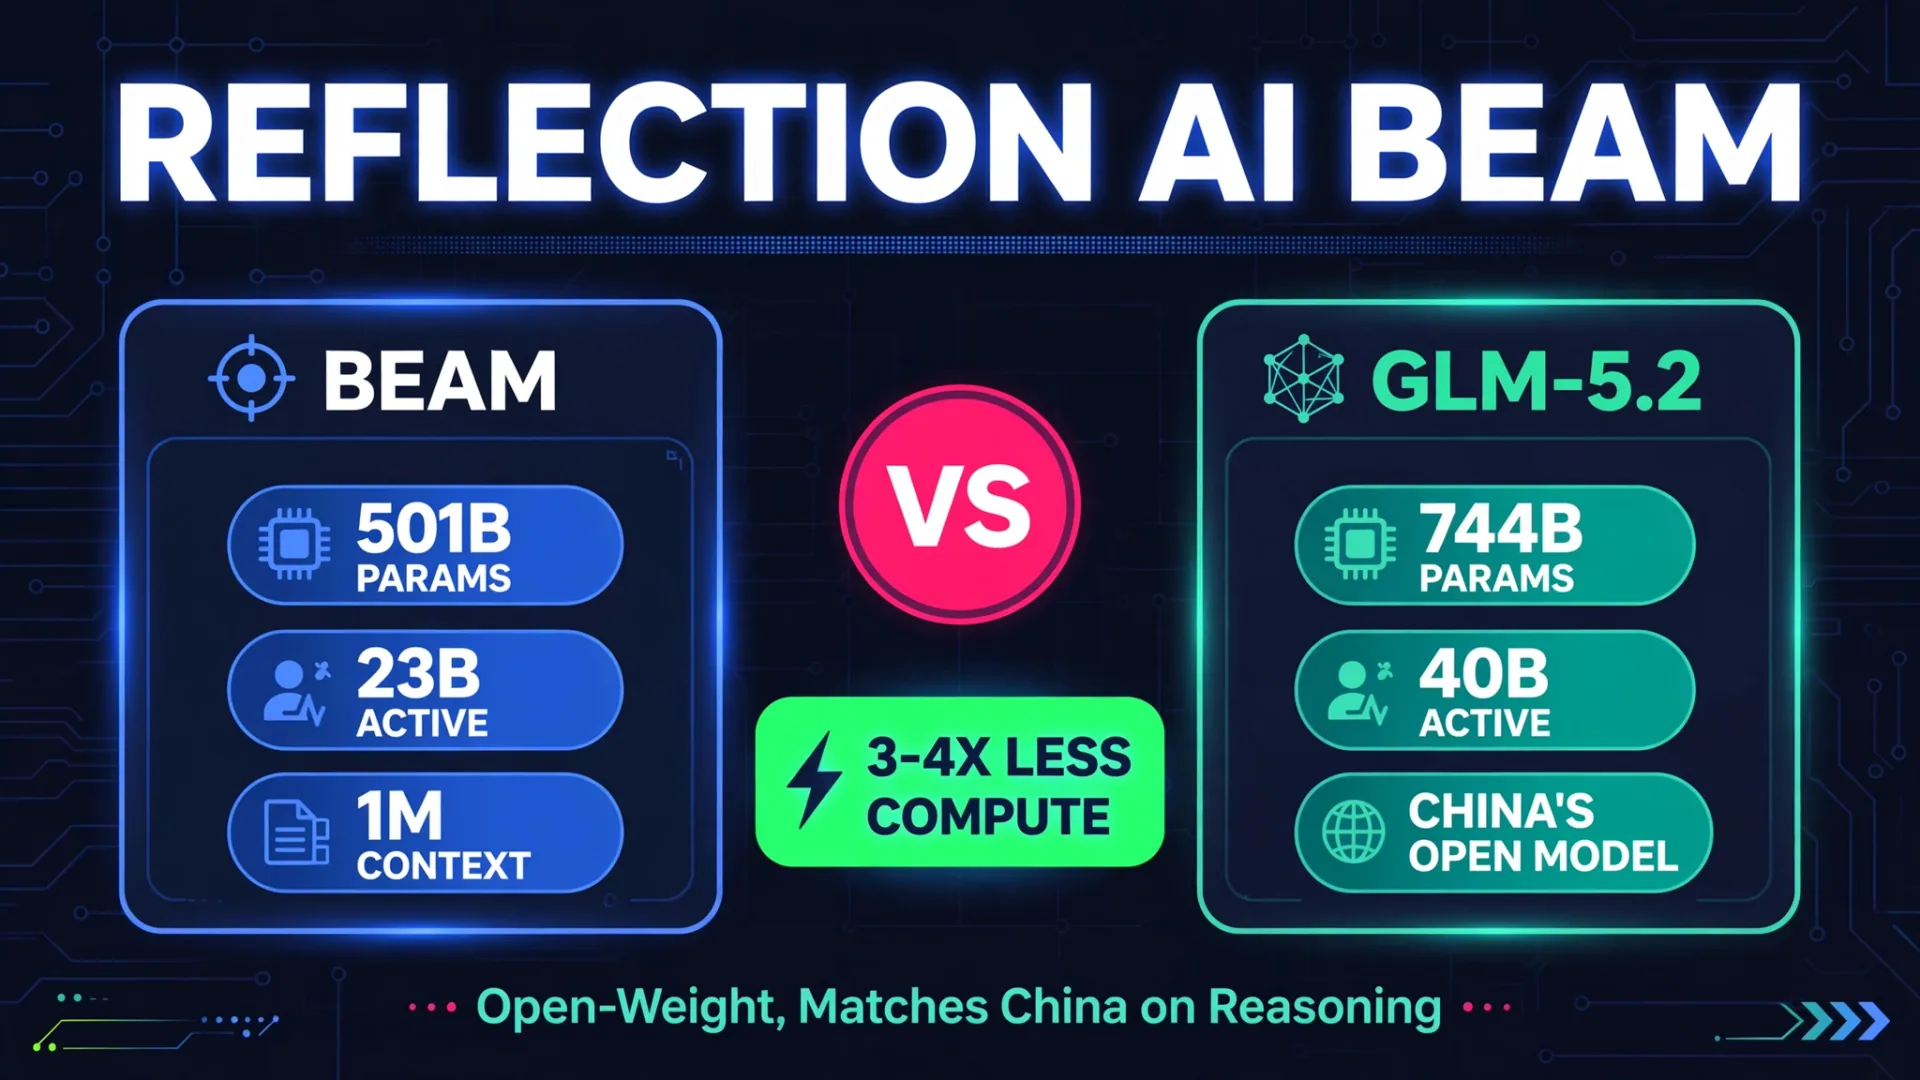
Un nouveau concurrent vient d’entrer dans l’arène des poids ouverts, et cela a suscité un argument différent de celui des autres. Le 5 octobre 2026, Reflection AI, une startup de Brooklyn vieille de deux ans soutenue par Nvidia, a dévoilé Beam : un modèle à poids ouvert de 501 milliards de paramètres dont la principale affirmation n’est pas la suprématie brute, mais l’efficacité. Reflection affirme que Beam égale le GLM-5.2 de Z.ai, l’un des modèles ouverts les plus solides de Chine, sur des benchmarks avancés de raisonnement tout en utilisant trois à quatre fois moins de calcul d’inférence.
Si cette affirmation tient une fois les poids rendus publics, cela compte plus que de reprendre une autre couronne au classement. Le calcul est le coût de chaque jeton servi, donc un modèle qui raisonne aussi pour un quart du calcul est un modèle qui est beaucoup moins cher à faire fonctionner à grande échelle.
Verdict rapide
| Modèle | Beam, par Reflection AI |
| Type | Mélange d’experts (MoE) uniquement en texte, poids ouvert |
| Échelle | 501B paramètres totaux, 23B actifs par jeton |
| Données d’entraînement | 23,8 trillions de jetons |
| Fenêtre de contexte | 1 million de jetons |
| Déclaration principale | Raisonnement de classe GLM-5.2 avec un calcul d’inférence 3-4 fois moins élevé (affirmation de l’entreprise, pas encore vérifiée) |
| Licence | Apache 2.0, poids prévus pour la fin d’octobre 2026 |
| Statut | Annoncé le 5 octobre ; accès anticipé par inscription ; poids non encore publics |
Faisceau vs GLM-5.2 : les spécifications côte à côte
| Spec | Faisceau de réflexion | Z.ai GLM-5.2 |
|---|---|---|
| Paramètres totaux | 501B | ~744B |
| Paramètres actifs par jeton | 23B | 40B |
| Jetons d’entraînement | 23.8T | Non confirmé par nos sources |
| Fenêtre de contexte | 1M de jetons | Non confirmé par nos sources |
| Modalité | Texte seulement | Multimodal |
| Modèle de dégagement | Poids Apache 2.0, prévu plus tard en octobre | Poids disponibles |
Benchmarks : ce que Reflection a publié, et ce qui n’est pas encore vérifié
Lisez cette section avec une mise en garde : chaque score ci-dessous est publié par une entreprise par Reflection. Les pondérations ne sont pas encore publiques, donc aucun laboratoire indépendant n’a vérifié ces chiffres. Considérez-les comme une offre d’ouverture de Reflection, et non comme un fait établi.
| Référence | Faisceau de réflexion | Z.ai GLM-5.2 |
|---|---|---|
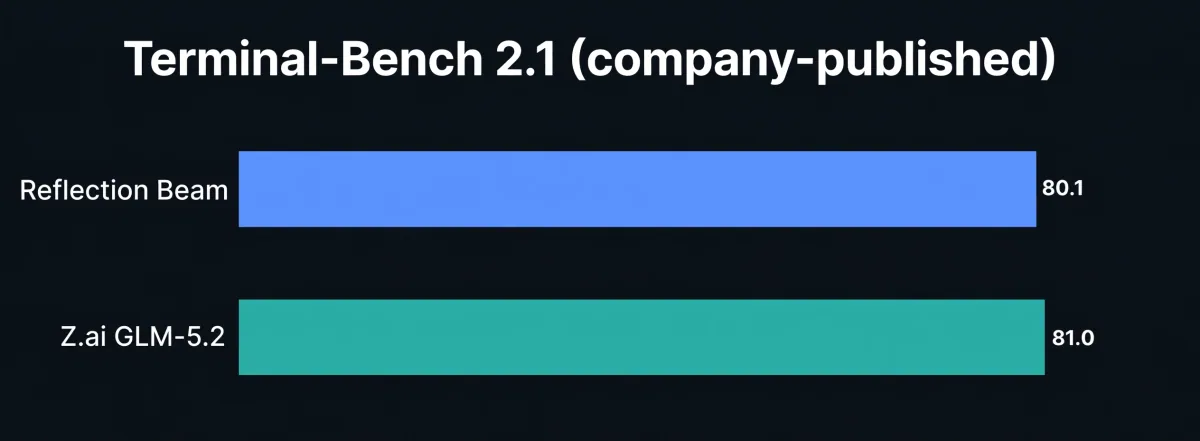
| Terminal Bench 2.1 | 80.1 | 81.0 |
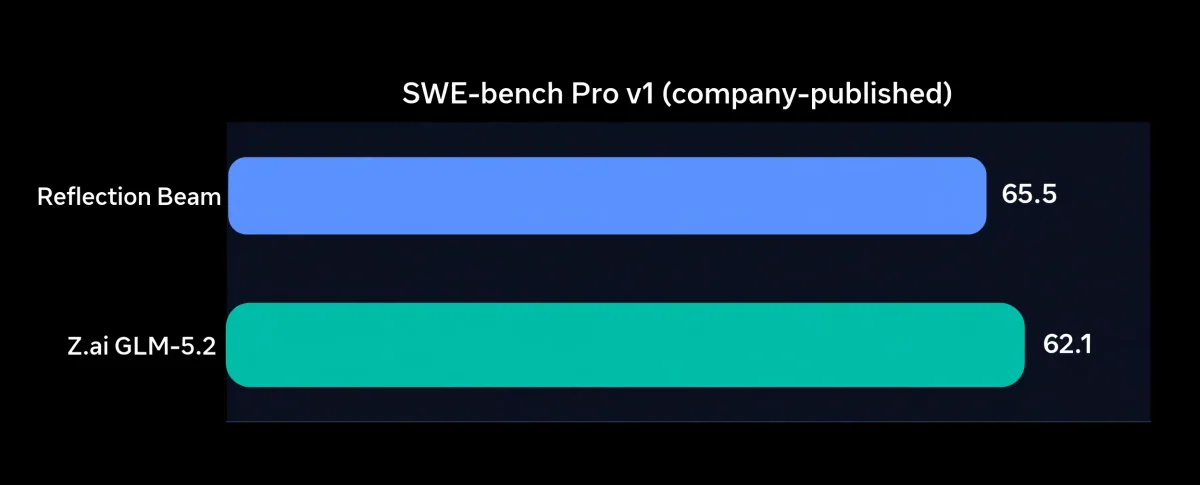
| SWE-bench Pro v1 | 65.5 | 62.1 |
Sur Terminal-Bench 2.1, un benchmark agentic terminal-task, Beam se situe juste derrière GLM-5.2 (80,1 contre 81,0), et le tableau de score de Reflection le montre également derrière Kimi K3 et Qwen 3.8-Max sur ce test. Sur SWE-bench Pro v1, un benchmark d’ingénierie logicielle, Beam devance GLM-5.2 (65,5 contre 62,1).
Reflection affirme également que Beam dépasse Inkling, le modèle ouvert du Thinking Machines Lab de Mira Murati publié en juillet, sur quatre tests de codage où les deux laboratoires rapportent des chiffres. Notez l’asymétrie : Inkling est multimodal et Beam est uniquement textuel, donc il s’agit d’une comparaison uniquement en codage.
Et le titre d’efficacité : Reflection indique que ces scores de raisonnement sont trois à quatre fois moins nombreux que les modèles ouverts occidentaux rivaux. Une note importante issue de la couverture indépendante : l’estimation de Reflection est une comparaison modèle-calcul basée sur des données de benchmark d’Artificial Analysis et DataCurve, et elle exclut le préremplissage prompt, les charges générales d’attention et les coûts de service. Donc ne lisez pas « 3-4 fois moins de calcul » comme « 3-4 fois moins cher à exécuter » tant que les benchmarks de service réels n’ont pas été établis.
Comment Beam est devenu efficace : l’histoire de la formation
Reflection attribue l’apprentissage par renforcement à haute intensité de calcul : au lieu d’ajouter simplement des paramètres, l’entraînement a été conçu pour que le modèle soit raisonné en moins d’étapes. L’échelle rapportée est frappante : 10 500 GPU Nvidia GB300 pour une série d’apprentissage par renforcement de quatre semaines générant plus de 100 millions de déploiements, selon l’annonce technique de Reflection.
L’entreprise a également verrouillé le matériel pour poursuivre la formation. Cet été, Reflection a signé des accords de calcul collectifs de plus de 7 milliards de dollars avec SpaceX et Nebius, assurant ainsi l’accès aux puces Nvidia GB300 jusqu’en 2029.
L’entreprise derrière Beam
Reflection AI a été fondée en 2024 par deux anciens chercheurs de Google DeepMind et a levé environ 4,7 milliards de dollars auprès de financeurs tels que Nvidia, Sequoia Capital et Lightspeed Venture Partners, selon PitchBook. Son dernier tour de financement a évalué l’entreprise à une valorisation pré-paiement de 25 milliards de dollars. C’est un fonds de guerre énorme pour un laboratoire vieux de deux ans, et cela montre à quel point les investisseurs prennent au sérieux la thèse de la « réponse occidentale à DeepSeek et Qwen ».
Le modèle économique : des usines d’IA, pas des chatbots
Reflection ne poursuit pas un chatbot consommateur. Le pitch est « usines d’IA » : vendre aux entreprises et aux nations souveraines la possibilité de construire leurs propres systèmes d’IA locaux et personnalisés en entraînant les modèles de Reflection sur leurs propres données propriétaires. Le PDG de Nvidia, Jensen Huang, dont l’entreprise soutient Reflection, défend depuis longtemps l’idée de l’usine d’IA. Reflection a déjà commencé à tester un partenariat d’usine d’IA souveraine avec le groupe Shinsegae en Corée du Sud, et Axios rapporte que les fonds spéculatifs et les sociétés de trading comptent parmi les prospects précoces enthousiastes.
C’est une voie intelligente. Reflection sait qu’elle ne peut pas surpasser Anthropic ou OpenAI sur la portée des consommateurs, donc elle vend là où les poids ouverts sont une caractéristique, et non un compromis : des industries réglementées et des gouvernements qui veulent le modèle à l’intérieur de leurs propres murs.
Prix et disponibilité : quel sera le coût
Il n’y a pas encore de prix public pour l’API pour Beam, ni de prix de token à inscrire dans un tableau. Voici ce que nous savons :
- Les poids sont promis sous licence Apache 2.0 plus tard en octobre, ce qui signifie que vous pouvez vous auto-héberger : votre coût est votre propre calcul, et la revendication d’efficacité 3-4x est l’histoire des prix.
- Reflection décrit le coût des jetons de Beam comme « une fraction » de celui des modèles concurrents, mais n’a pas publié de dollars par million de jetons.
- La distribution est prévue via des hyperscalers et des neoclouds, avec des intégrations de bibliothèques open source au lancement, et l’accès anticipé se fait actuellement par inscription.
Si vous budgétisez aujourd’hui, comparez-le aux modèles que vous pouvez réellement acheter : Gemini 4 Argon de Google est affiché à 2 $ par million de jetons d’entrée et 10 $ par million de tokens de sortie, et Claude Sonnet 5.5 d’Anthropic est à 2 $/10 $. Le pitch de Beam est de réduire cette catégorie de prix une fois qu’elle sera utilisable. Nous avons abordé ces deux modèles en détail : Gemini 4 Argon : le modèle phare de retour de Google et Claude Opus 5.5, le modèle d’IA le plus puissant.
Qui devrait s’en soucier, et que faire maintenant
Des entreprises qui veulent des poids ouverts sans dépendre des laboratoires chinois. Beam est la première tentative occidentale sérieuse d’adapter le raisonnement de classe GLM-5.2 avec une meilleure efficacité. Attendez la baisse des poids d’octobre et la vérification indépendante avant de planifier autour de cela.
Les développeurs et équipes exécutent des agents à grande échelle. Si la revendication de calcul 3-4x survit aux tests indépendants, Beam pourrait réduire considérablement les coûts de service pour le codage et les charges de travail agentiques. D’ici là, conservez votre stack actuel.
Toute personne créant des agents IA pour le business. Des poids ouverts et de solides scores de benchmark agents sont exactement la combinaison qui rend les agents auto-hébergés économiques. Si vous envisagez cette voie, consultez nos services de développement d’agents IA et comment engager une agence d’automatisation IA.
FAQ
Qu’est-ce que le Rayon IA de réflexion ?
Beam est le premier modèle d’IA à poids ouvert de pointe développé par Reflection AI, une startup soutenue par Nvidia fondée en 2024 par deux anciens chercheurs de Google DeepMind. C’est un modèle mixte d’experts uniquement textuel, avec 501 milliards de paramètres au total et 23 milliards d’actifs par jeton.
Quand les poids de Beam seront-ils libérés ?
Reflection indique que les poids, les détails techniques complets, un rapport technique et les outils de développement seront publiés plus tard en octobre 2026 sous la licence Apache 2.0. Au moment de l’annonce du 5 octobre, ils ne sont pas encore rendus publics.
Beam est-il meilleur que le GLM-5.2 de Z.ai ?
Sur le tableau de bord publié par Reflection, Beam accuse un léger retard sur GLM-5.2 sur Terminal-Bench 2.1 (80,1 contre 81,0) et mène légèrement sur SWE-bench Pro v1 (65,5 contre 62,1). La véritable revendication de Reflection est l’efficacité : un raisonnement similaire avec un calcul d’inférence 3 à 4 fois moins. Rien de tout cela n’est encore vérifié de manière indépendante.
Combien coûte l’utilisation de la Beam ?
Aucun prix public n’a été annoncé. Comme les poids seront sous licence Apache 2.0, les organisations pourront s’auto-héberger et ne payer que leurs propres coûts de calcul.
Sous quelle licence Beam est-il libéré ?
Apache 2.0, selon Reflection. C’est une licence ouverte permissive qui permet une utilisation commerciale et une modification.
Qui a fondé Reflection AI ?
Deux anciens chercheurs de Google DeepMind ont fondé l’entreprise en 2024. Elle a levé environ 4,7 milliards de dollars, avec Nvidia, Sequoia Capital et Lightspeed parmi ses soutiens, selon PitchBook.
Beam est-il multimodal ?
Non. Beam est uniquement textuel. C’est important à garder à l’esprit lorsqu’on le compare à des modèles ouverts multimodaux comme Inkling.
Quelle est la stratégie « usine d’IA » de Reflection ?
Au lieu d’un produit grand public, Reflection prévoit de vendre aux entreprises et aux gouvernements des systèmes d’IA localisés complets, appelés « usines d’IA », construits sur ses modèles et entraînés sur les données propriétaires du client. Un projet pilote avec le groupe sud-coréen Shinsegae est déjà en cours.
- Reflection AI
- Beam
- open-weight AI
- GLM-5.2
- AI benchmarks
- AI news