IA10 min de lecturaPor JH Akash
Explicación de LongCat 2.5: Modelo de codificación multimodal 1.6T de Meituan
El LongCat 2.5 de Meituan salió en funcionamiento el 2 de noviembre de 2026: parámetros de 1,6T, contexto de 1 millón, entrada nativa de imagen y vídeo, a 0,30 $/1,20 $ por millón de tokens. Benchmarks, precio y las ventajas que hay que conocer antes de cambiar.
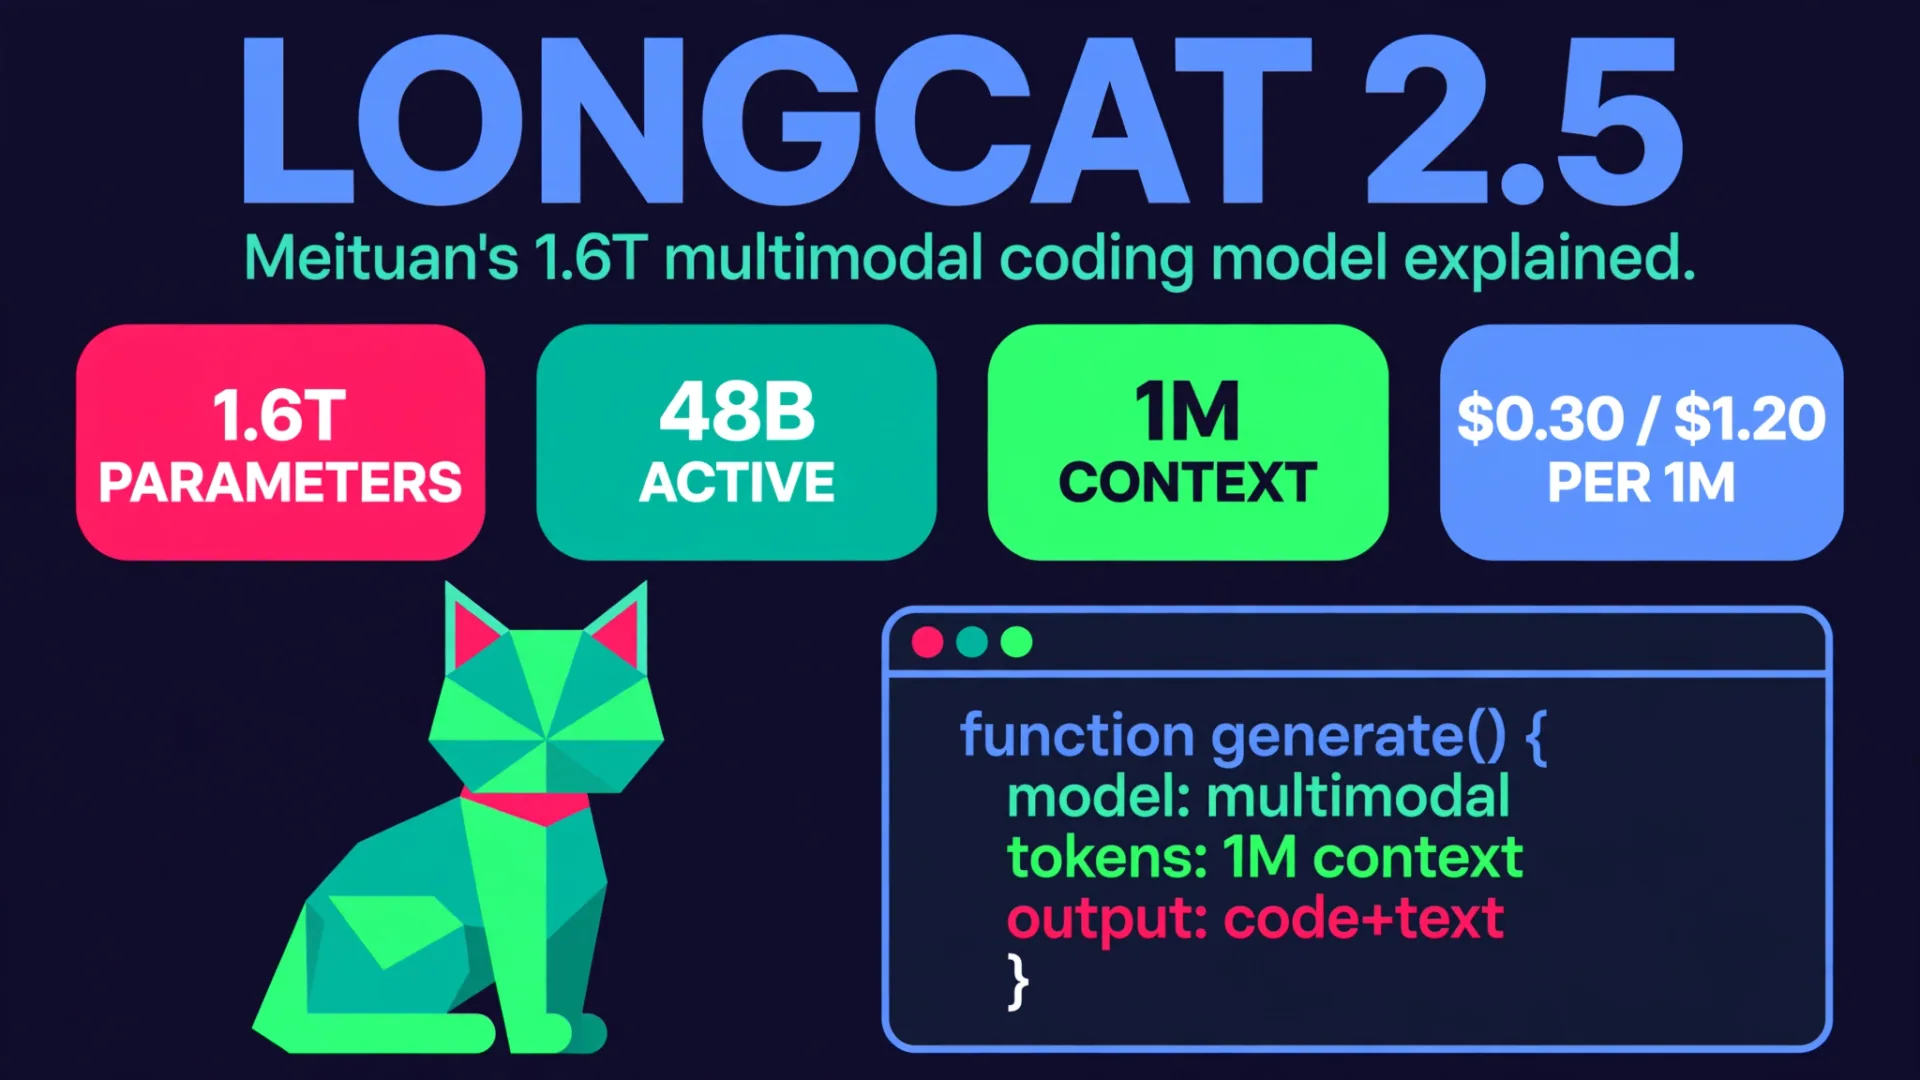
El equipo de LongCat de Meituan lanzó LongCat 2.5 el 2 de noviembre de 2026, y la propuesta es fácil de entender: un modelo que puede leer texto, imágenes y vídeo, ejecutar trabajos largos de agente de codificación y hacerlo a 0,30 dólares por millón de tokens de entrada y 1,20 dólares por millón de tokens de salida. Los números que hay debajo de esa propuesta son más interesantes que el titular. LongCat 2.5 supone un gran salto respecto a LongCat 2.0, iguala a DeepSeek V4.1 Flash en precio, y su propia tabla de referencia muestra dónde un rival más barato sigue liderando en programación pura.
Este no es un modelo nuevo ni más grande. LongCat 2.5 se basa en LongCat 2.0, un modelo de mezcla de expertos con 1,6 billones de parámetros y unos 48 mil millones de parámetros activos por token. El cambio es lo que el modelo puede ver y cuánto entrenamiento de agente ha tenido. Todas las puntuaciones de benchmark en esta publicación son reportadas por Meituan por proveedores salvo que se indique lo contrario, y ninguna clasificación independiente había puntuado LongCat 2,5 en el momento de escribir esto.
Veredicto rápido
| Punto | LongCat 2.5 |
|---|---|
| Lanzamiento | 2 de noviembre de 2026, disponibilidad general en la plataforma API de LongCat |
| Tamaño | 1,6 billones de parámetros totales, unos 48 mil millones activos por token |
| Entrada | Texto, imágenes y vídeo. La salida es solo texto |
| Contexto | 1 millón de tokens. Planifica alrededor de 128.000 tokens de producción máxima |
| Precio | 0,30 $ por millón de tokens de entrada sin caché, 0,006 $ por millón de tokens de entrada almacenados en caché, 1,20 $ por millón de tokens de salida, todos etiquetados como descuento por tiempo limitado |
| Pesos | No publicado. GitHub y Hugging Face están marcados como "próximamente" |
| Mejor para | Agentes de codificación de presupuesto que necesitan leer capturas de pantalla o grabaciones de pantalla |
| Cuidado con | Sin precio de lista, sin política publicada de retención de datos, y aún sin puntuaciones independientes |
Qué cambió respecto a LongCat 2.0
LongCat 2.0 era solo texto y de peso abierto, lanzado bajo licencia MIT con pesos en Hugging Face. LongCat 2.5 mantiene el mismo esqueleto 1.6T / 48B y añade visión nativa además de entrenamiento de agentes a largo plazo. La vista previa llegó el 25 de septiembre de 2026 y la disponibilidad general siguió el 2 de noviembre de 2026, añadiendo entrada de vídeo y soporte para códex.
La visión es la característica principal. LongCat 2.5 convierte imágenes en tokens discretos en el mismo flujo que las palabras, en lugar de añadir un codificador de imagen a un modelo de texto. En la práctica, eso significa resolución nativa: una captura de pantalla alta se convierte en más tokens que en una miniatura aplastada. La documentación permite hasta 50 imágenes por petición a un máximo de 10 MB cada una, y hasta 10 vídeos a hasta 100 MB cada uno y menos de 3.600 segundos. No hay una línea de precios separada para imágenes o vídeos. Pagas por los tokens en los que se convierten.
En el lado del agente, Meituan describe aprendizaje por refuerzo a larga escala en tareas construidas a partir de pull requests filtrados en GitHub, con penalizaciones por razonamiento repetitivo y llamadas repetidas a herramientas. Eso importa porque el bucle en tareas largas fue la queja más fuerte de los usuarios de vista previa. Si la disponibilidad general lo solucionó es lo primero que debes probar en tu propio repositorio.
LongCat 2.5 también funciona entre harnesses de agentes, con guías para Claude Code, Codex, OpenCode, Cline, Kilo Code y Hermes Agent, entre otros. Soporta endpoints compatibles con OpenAI y Anthropic, por lo que cambiar de harness es principalmente un cambio de URL base y nombre de modelo: LongCat-2.5.
Benchmarks: un salto real, con un catch
La propia tabla de Meituan muestra un gran salto respecto a LongCat 2.0 en tareas de agentes. Estas son puntuaciones reportadas por proveedores, ejecutadas con el pensamiento activado.
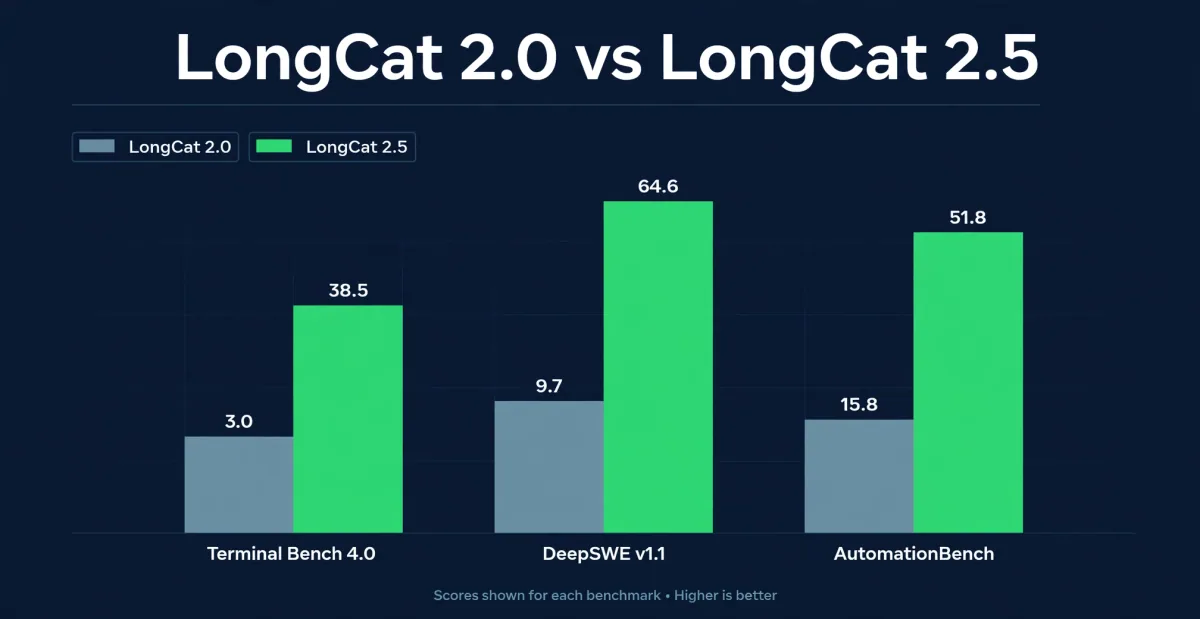
| Índice de referencia | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| 3DCodeBench Texto a 3D | 55.4 | No reportado | 53.4 | 49.3 | 54.3 |
| Vision2Web | 78.6 | No reportado | No reportado | 79.0 | 80.2 |
Fuente: tabla de evaluación del blog tecnológico Meituan LongCat 2.5. Las puntuaciones de otros modelos son una mezcla de las propias tiradas de Meituan y cifras de informes públicos, que según Meituan son solo indicativas. Diferentes benchmarks usan diferentes arneses, así que no compares puntuaciones entre benchmarks como si fueran un solo ranking.
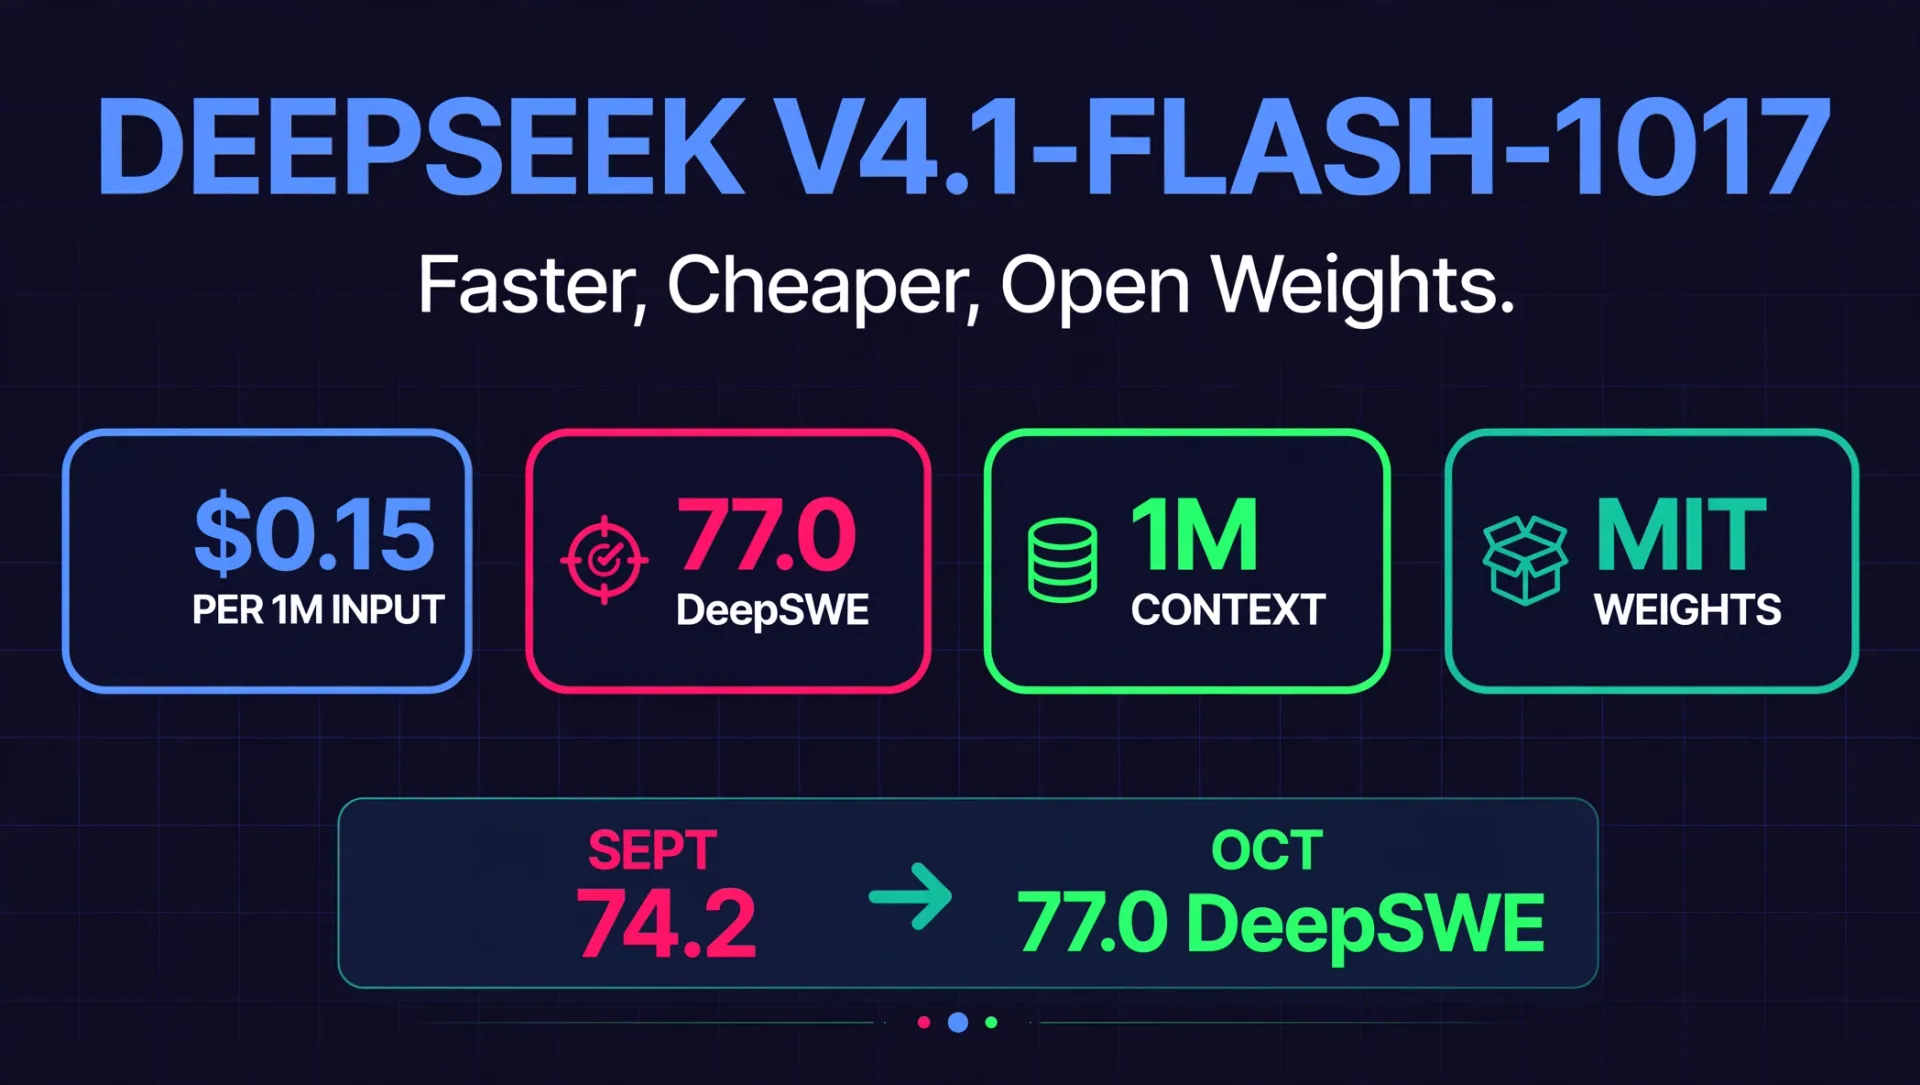
Dicho claramente, LongCat 2.5 lidera a su rival de precios en Terminal Bench 4.0 (38,5 frente a 31,2), BrowseComp (91,9 frente a 91,5) y 3DCodeBench Text to 3D (55,4 frente a 53,4). DeepSeek V4.1 Flash lidera en Terminal Bench v2.1, DeepSWE v1.1, NL2Repo, MCP Atlas y AutomationBench (54,8 frente a 51,8). LongCat 2.5 es uno de los dos con puntuaciones en vídeo publicadas, y sus resultados en BrowseComp y 3D encajan con su propuesta de visión prioritaria.
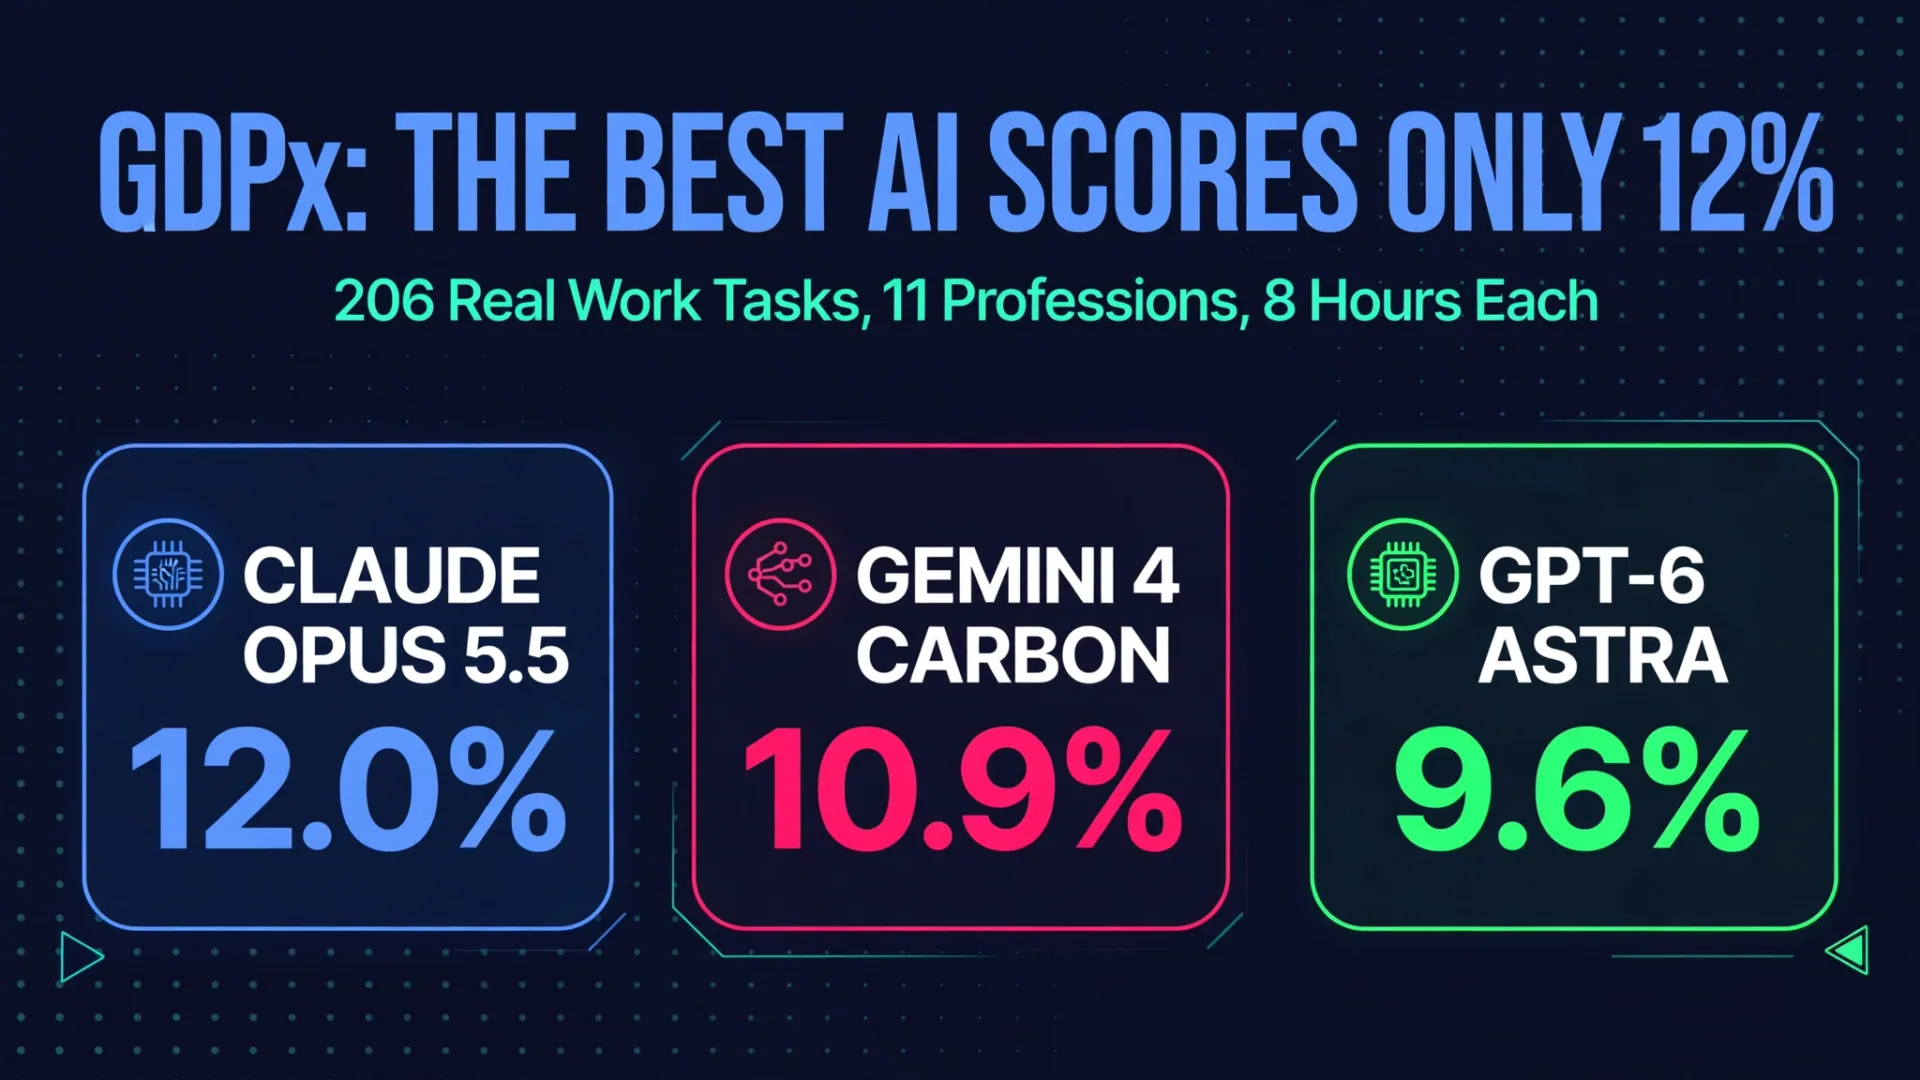
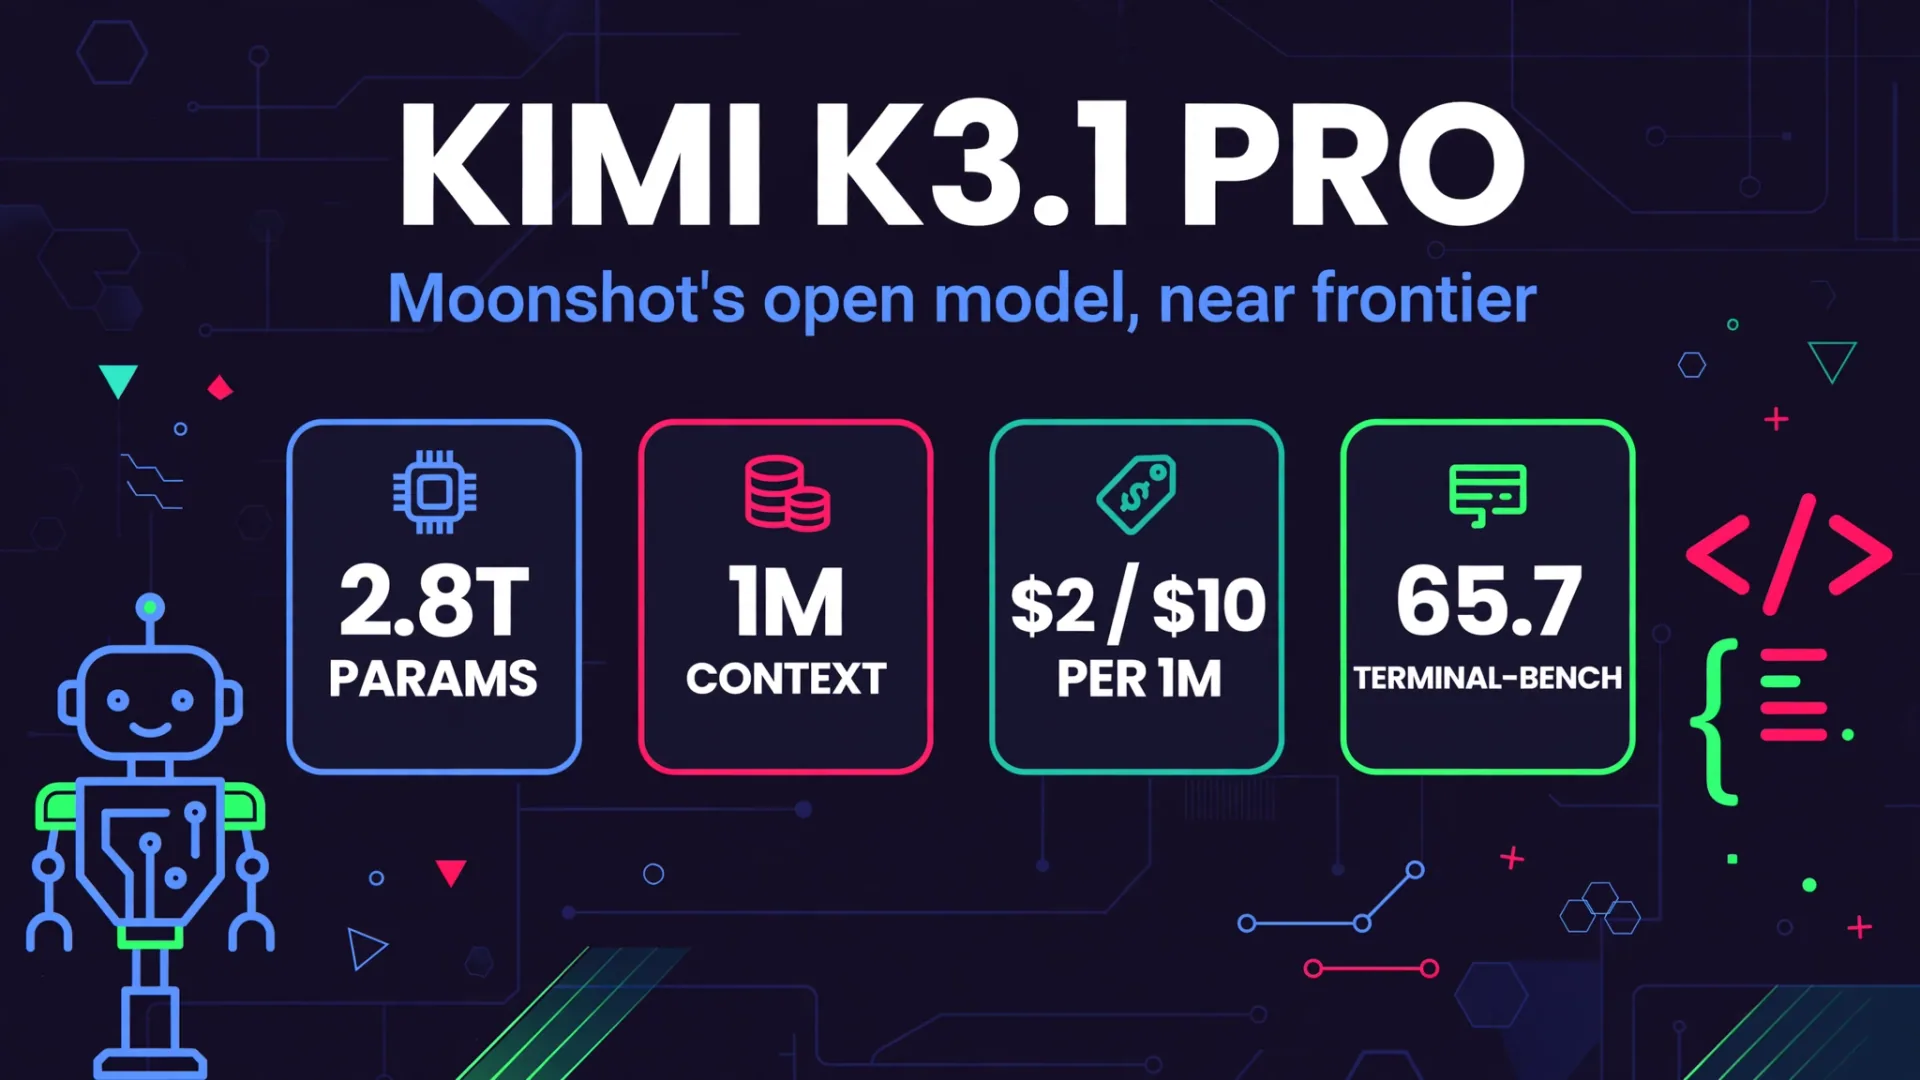
También merece la pena destacar el conjunto de comparación. Los gráficos principales de Meituan comparan con Claude Opus 5, GPT-5.6-Sol, Claude Opus 4.8 y GPT-5.5. No incluyen Claude Opus 5.5, GPT-6.1 Sol ni Kimi K3.1 Pro. Para ver la imagen más reciente de la frontera, consulta nuestras publicaciones anteriores sobre Claude Opus 5.5 y GPT-6 Astra, así como nuestro desglose de referencia del PIB de la X, donde el Opus 5.5 lidera con un 12,0%.
Precios: barato, pero con descuento y temporal
| Modelo | Entrada por 1M de tokens | Entrada en caché por cada 1M de tokens | Salida por 1M de tokens |
|---|---|---|---|
| LongCat 2.5, descuento por tiempo limitado | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, pico | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, fuera de horas pico | $0.15 | $0.003 | $0.60 |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 |
| Kimi K3.1 Pro | $2.00 | $0.20 | $10.00 |
| Kimi K3 | $3.00 | $0.30 | $15.00 |
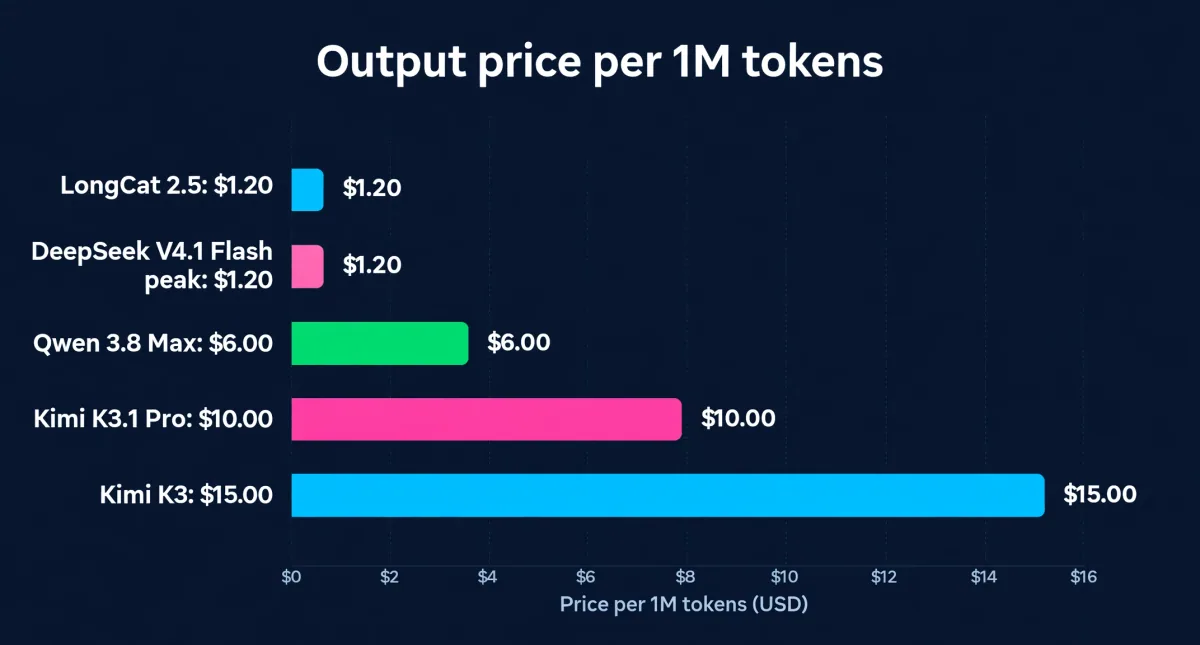
Dos detalles hacen que el precio sea más útil que el titular. La entrada en caché cuesta solo el 2% de la entrada sin caché, lo cual importa para los agentes de codificación que reenvían los mismos archivos cada turno. Y no hay recargo por longitud de contexto, así que una petición larga cuesta lo mismo por token que una corta.
Una simple factura ayuda. Una tarea con 800.000 tokens de entrada sin caché y 200.000 tokens de salida cuesta 0,48 $ en LongCat 2.5: 0,8 veces 0,30 $ más 0,2 veces 1,20 $. El ejemplo retenido de Meituan, 600.000 tokens de entrada sin caché, 400.000 tokens de entrada almacenados en caché y 500.000 tokens de salida, cuesta 0,7824 $.
El riesgo es la etiqueta de descuento. Cada precio de LongCat 2.5 lleva las palabras "descuento por tiempo limitado", sin precio de lista ni fecha de finalización publicada. Una página antigua de LongCat 2.0 mostraba un precio de lista de 0,75 $ de entrada, 0,015 $ en caché y 2,95 $ de salida junto al mismo descuento. Meituan no ha dicho que LongCat 2.5 se moverá a ese precio de lista, pero presupuesta el precio con descuento solo si puedes absorber un aumento.
Cuál elegir
Prueba LongCat 2.5 si ejecutas agentes de programación con presupuesto limitado y quieres uno que pueda leer capturas de pantalla o grabaciones de pantalla. A 0,30 $ / 1,20 $ con un 2% de entrada en caché, una tarde de pruebas en tu propio repositorio cuesta unos cuantos euros. Compáralo directamente con DeepSeek V4.1 Flash al mismo precio, pero en tus propias tareas, no en gráficos de lanzamiento.
Elige DeepSeek V4.1 Flash si la programación a largo plazo es toda la tarea. En la propia tabla de Meituan lidera en más filas de codificación y reduce a la mitad su precio fuera de pico. También tiene una producción máxima más larga en comparaciones de terceros, con 384.000 tokens frente a los 128.000 previstos de LongCat 2.5.
Espera si necesitas pesos abiertos, licencia o autoalojamiento. LongCat 2.5 es solo API por ahora, y aunque lleguen los pesos, un modelo 1.6T necesita una configuración multi-GPU. LongCat 2.0 sigue siendo la opción descargable.
Sáltalo por ahora si tus prompts contienen datos de clientes o regulados. Las páginas de FAQ y facturación de LongCat no dicen nada sobre cuánto tiempo se mantienen los prompts ni si el tráfico de la API se usa para entrenamiento. Ese silencio es la decisión, sea cual sea el precio.
Si estás creando agentes para clientes en lugar de probar modelos por ti mismo, el modelo es solo una parte del sistema. Nuestros servicios de desarrollo de agentes de IA y puestos en agencias de automatización de IA cubren el trabajo que lo rodea: herramientas, comprobaciones, reglas de escalada y despliegue.
Capturas que debes saber antes de tu primera partida
- Confusión de límites de salida. La página de parámetros del modelo permite hasta 262.144 tokens máximos, pero el inicio rápido, las preguntas frecuentes y la configuración de Claude Code de Meituan apuntan todos a 128.000. Planifica alrededor de 128.000 y considera cualquier valor por encima de eso como un extra para probar.
- La temperatura es fija. Es 1,0 con pensar activado y 0,7 con pensar fuera, y otros valores se anulan silenciosamente en lugar de rechazarlos. Si tu arnés de evaluación barrió la temperatura, no está haciendo lo que piensas.
- Los límites de velocidad no están publicados. Los límites son por clave API y devolven un 429 con una pista de reintento de 60 segundos, pero no se publican cifras de solicitudes por minuto ni de tokens por minuto.
- Los IDs de modelos antiguos pueden desaparecer. LongCat 2.0 y 2.5-Preview han desaparecido de las tablas de modelos soportados sin aviso de retirada fechado. Si has fijado un ID antiguo, pruébalo hoy.
- Aún no hay puntuaciones independientes. Análisis Artificial solo lista LongCat 2.0, y OpenRouter solo devuelve LongCat 2.0. Una prueba previa independiente reportó un resultado muy diferente en Terminal Bench 2.1 respecto al 88.4 de Meituan, pero en un arnés diferente. Haz tu propia prueba antes de comprometerte.
Preguntas frecuentes
¿Qué es LongCat 2.5?
LongCat 2.5 es el modelo de lenguaje grande más reciente de Meituan, disponible en general en la plataforma API LongCat desde el 2 de noviembre de 2026. Recibe texto, imágenes y vídeo como entrada, está ajustado para agentes de codificación de larga duración y sucede al LongCat 2.0 de peso abierto.
¿Cuánto cuesta el LongCat 2.5?
LongCat 2.5 cuesta 0,30 $ por millón de tokens de entrada sin caché, 0,006 $ por millón de tokens de entrada almacenados en caché y 1,20 $ por millón de tokens de salida. Meituan etiqueta los tres como un descuento por tiempo limitado y no publica precio de lista ni fecha de finalización, por lo que el precio podría subir. Esa es la misma tasa que DeepSeek V4.1 Flash en horas punta.
¿Es LongCat 2.5 de código abierto?
Todavía no. El blog de lanzamiento de Meituan marca los enlaces de GitHub y Hugging Face como "próximamente", y a fecha del 3 de noviembre de 2026 no había aparecido ningún repositorio o licencia de LongCat 2.5, por lo que por ahora solo es API. LongCat 2.0 sigue siendo el modelo más reciente de LongCat con pesos abiertos del MIT.
¿Puedo usar LongCat 2.5 en Claude Code o Codex?
Sí. La documentación de Meituan muestra cómo apuntar Claude Code al endpoint en formato Anthropic con el modelo configurado en LongCat-2.5, y hay una guía de coincidencia para Codex usando la API Responses. Espera peculiaridades: la temperatura está fijada por la plataforma y la salida está limitada a 128.000 tokens en la documentación.
¿Cómo se compara LongCat 2.5 con DeepSeek V4.1 Flash?
En cuanto al precio, coinciden en el pico: 0,30 $ de entrada y 1,20 $ de salida por millón de tokens. En la propia tabla de benchmark de Meituan, LongCat 2.5 lidera en Terminal Bench 4.0, BrowseComp y 3DCodeBench Text a 3D, mientras que DeepSeek V4.1 Flash lidera en más filas de codificación de largo horizonte y es más barato fuera de punta. LongCat 2.5 añade entrada de vídeo, que DeepSeek V4.1 Flash no iguala en esta comparación.
¿Es útil LongCat 2.5 para atención al cliente?
Hoy no como primera opción. La documentación de LongCat no dice nada sobre la retención de datos o el entrenamiento en datos de API, que importa cuando los prompts contienen detalles del cliente. Para el trabajo de soporte, un agente de soporte técnico probado con un manejo claro de datos es la ruta más segura que conectar un modelo en bruto a una cola.
En resumen
LongCat 2.5 es una verdadera mejora respecto a la 2.0, con una visión integrada en lugar de atornillada, a un precio que no ha cambiado. Simplemente no es la opción obvia a su precio para programación pura, y su propia tabla de referencia es donde puedes verlo. Pruébalo en trabajos de agentes con mucho enfoque, compáralo con DeepSeek V4.1 Flash en tu propio repositorio y mantén los datos de clientes fuera hasta que Meituan publique una política clara de datos.
- LongCat 2.5
- Meituan
- AI coding agents
- multimodal AI
- DeepSeek
- AI benchmarks